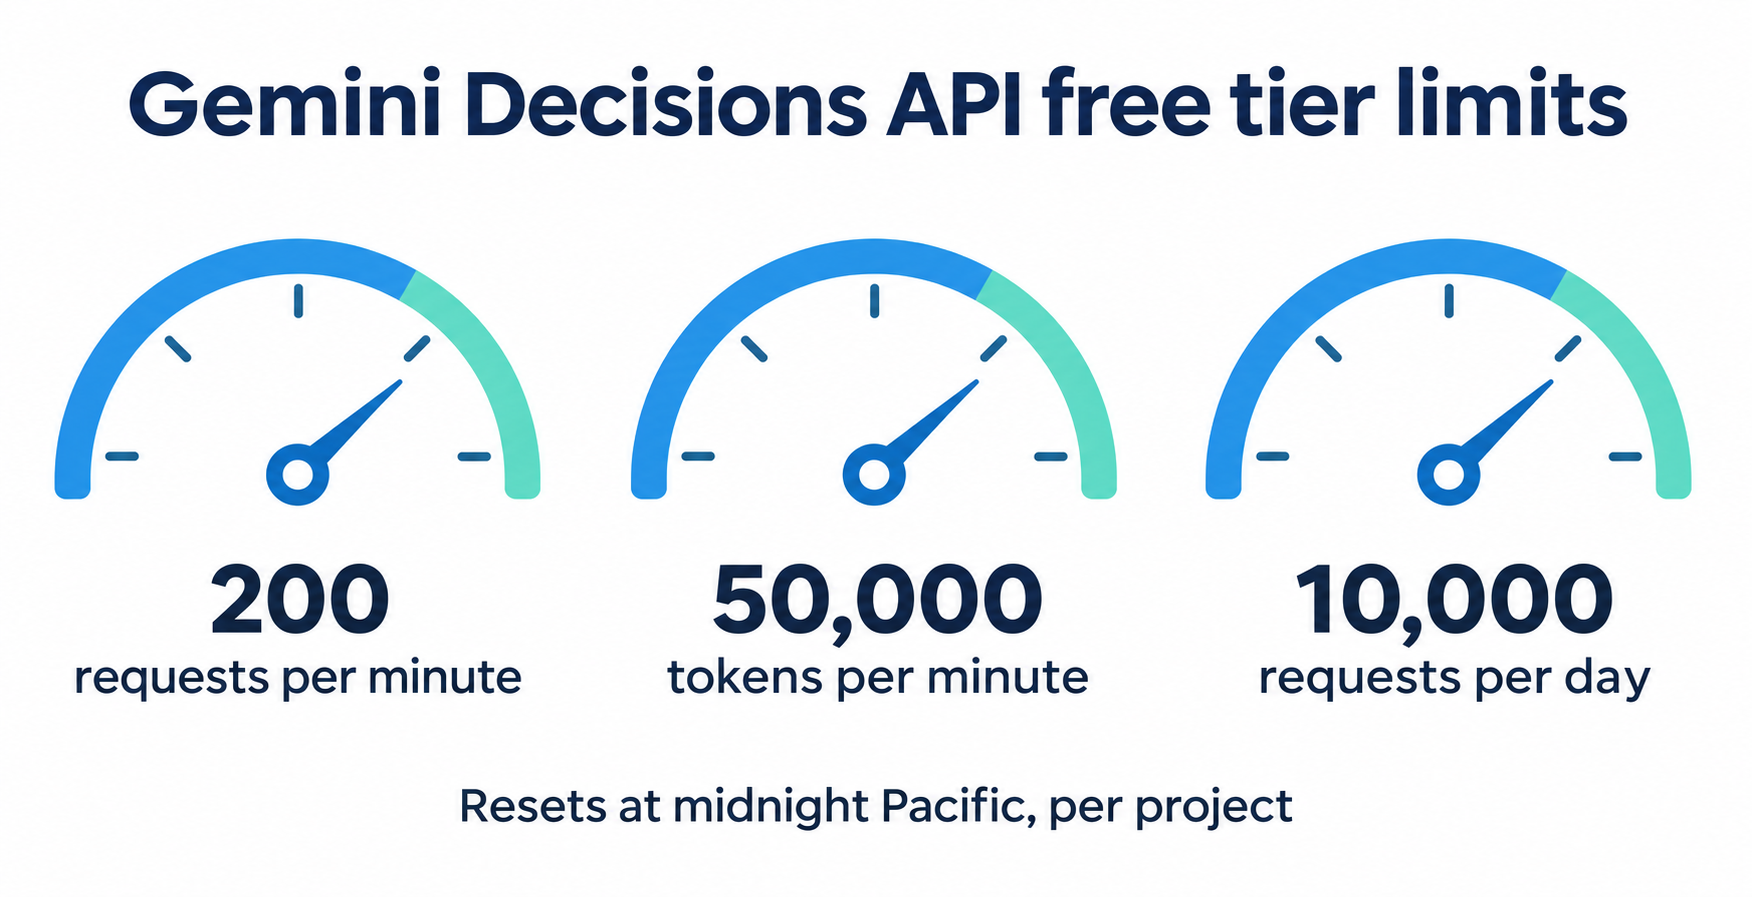
Vous pouvez utiliser l'API Gemini Decisions gratuitement dès aujourd'hui. Le palier gratuit de Google pour gemini-decision-1 ne facture rien en entrée, ne compte aucun token de sortie et autorise 200 requêtes par minute, 50 000 tokens par minute et 10 000 requêtes par jour et par projet. Vous avez besoin d'une clé API AI Studio, sans compte de facturation. Le bémol : sur le palier gratuit, Google peut utiliser votre contenu pour améliorer ses produits.
Ci-dessous : ce que signifient ces limites en termes de charges de travail réelles, le calcul des tokens derrière le prix de 0,10 $ par million en version payante, les autres moyens d'y accéder gratuitement, et comment éviter que vos tests et votre CI n'épuisent votre quota quotidien. Chaque quota et prix a été relevé sur les pages officielles de Google le 12 novembre 2026. L'API est livrée en v1beta, donc revérifiez avant d'établir un budget. Pour les types de questions eux-mêmes (noul, choice, score), consultez le guide de l'API Decisions de Google.
Ce que comprend le palier gratuit de l'API Gemini Decisions
Le palier gratuit de l'API Gemini Decisions est le palier d'utilisation sans coût de l'API Gemini Developer de Google, appliqué au modèle gemini-decision-1. Il offre à chaque projet Google Cloud un traitement des entrées gratuit, zéro frais de sortie, et des limites de débit fixes de 200 RPM, 50 000 TPM et 10 000 RPD, sans aucune configuration de facturation.
Voici ce que dit la page des tarifs et la page des limites de débit de Google, côte à côte :
| Élément | Palier gratuit | Payant (Tier 1) |
|---|---|---|
| Prix de l'entrée (texte, image, vidéo, audio, PDF) | Gratuit | 0,10 $ par 1M de tokens |
| Prix de la sortie | Sans objet (0 token de sortie) | Sans objet (0 token de sortie) |
| Requêtes par minute | 200 | 1 500 |
| Tokens par minute | 50 000 | 1 000 000 |
| Requêtes par jour | 10 000 | 50 000 |
| Contenu utilisé pour améliorer les produits Google | Oui | Non |
| Mise en cache du contexte | Non disponible | Non disponible |
Trois détails comptent plus que les chiffres headline :
- Les limites sont par projet, pas par clé API. Créer cinq clés dans un même projet ne vous donne pas cinq quotas.
- Le plafond quotidien se réinitialise à minuit, heure du Pacifique. Un traitement par lots qui démarre à 23 h, heure du Pacifique, obtient une heure du quota d'un jour et un nouveau quota de 10 000 après minuit.
- Les données du palier gratuit peuvent être utilisées par Google. Le tableau des tarifs indique « Utilisé pour améliorer nos produits » comme Oui sur le palier gratuit et Non sur le payant. N'envoyez pas de données personnelles de clients, de contrats ou d'images médicales via une clé gratuite.
Comment obtenir une clé API Gemini Decisions gratuite
Vous pouvez effectuer vos premiers appels gratuits en environ cinq minutes :
- Connectez-vous à Google AI Studio et cliquez sur Create API key. Un nouveau projet démarre sur le palier gratuit.
- Installez le SDK 3.2 ou supérieur :
pip install -U google-genaiounpm install @google/genai@latest. - Exportez la clé sous le nom
GEMINI_API_KEYpour que le SDK la détecte. - Envoyez une requête avec
http_options={"api_version": "v1beta"}et lisez le blocusagedans la réponse.
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})

result = client.decisions.create(
    model="gemini-decision-1",
    input="Order 8821 arrived with a cracked screen.",
    questions={
        "is_damaged": {"type": "noul", "instructions": "Did the item arrive damaged?"},
    },
)

print(result.answers["is_damaged"].noul)
print(result.usage.total_input_tokens)
Ce chiffre usage.total_input_tokens est celui à consigner. Sur le palier gratuit, c'est ce qui consomme vos 50 000 TPM ; en version payante, c'est la seule chose qui vous est facturée.
Pour les autres offres gratuites de Google, consultez notre guide du palier gratuit de l'API Gemini et notre article sur comment utiliser Gemini gratuitement.
Comment fonctionne la tarification de l'API Gemini Decisions
Vous ne payez que les tokens d'entrée, et l'entrée partagée n'est comptée qu'une fois par requête, quel que soit le nombre de questions. Chaque question n'ajoute que ses propres tokens d'instructions et de critères. La sortie fait toujours 0 token, car le modèle renvoie des probabilités, pas du texte.
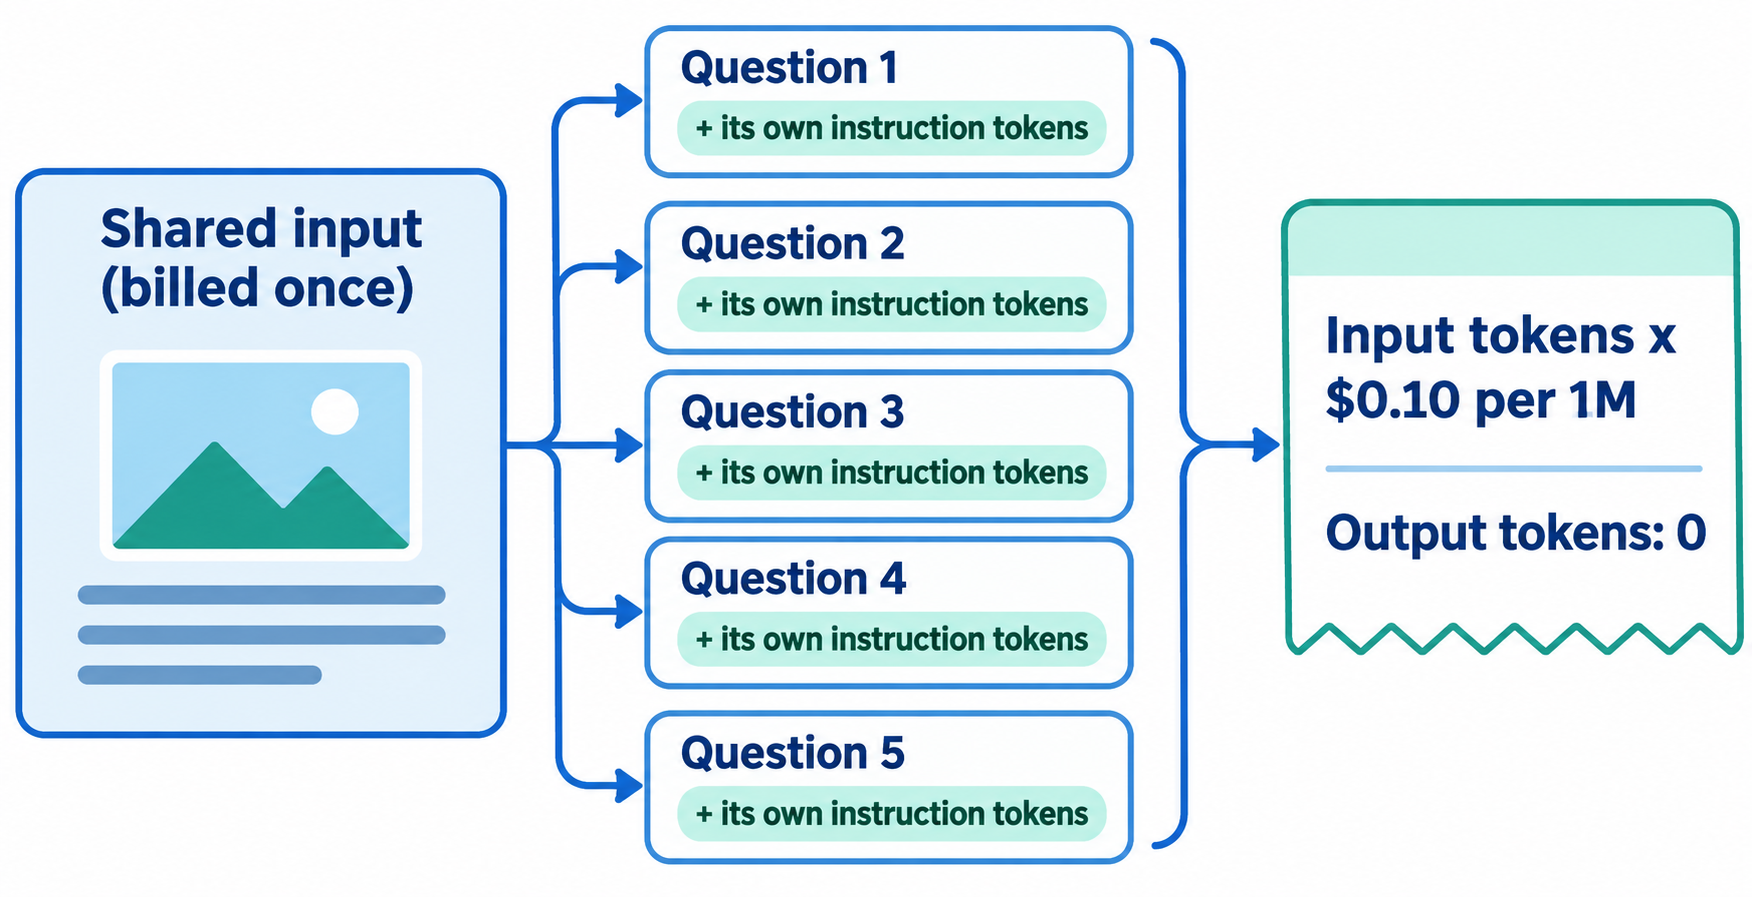
La formule pour une requête est donc simple :
input tokens = shared input + sum(each question's instructions + criteria)
paid cost    = input tokens / 1,000,000 x $0.10
Le plus intéressant, c'est l'effet sur le palier gratuit. Avec du texte, c'est généralement le nombre de requêtes (200 RPM, 10 000 RPD) qui limite en premier. Avec des images, de l'audio ou de longs documents, c'est la limite de 50 000 TPM.
Exemples de coûts concrets : palier gratuit vs payant
Les chiffres de tokens par question ci-dessous sont des estimations (environ 30 tokens par question courte). Les comptages d'images et d'audio proviennent du tableau de résolution des médias de Google, qui indique 280 tokens par image en low, 1 120 en high, et 25 tokens par seconde d'audio pour les modèles Gemini actuels. Lancez une requête réelle et remplacez mes chiffres par vos propres valeurs usage.
10 000 photos de produits x 16 questions
Imaginons que vous vérifiiez des photos de livraison pour détecter dommages, placement, lisibilité des étiquettes et 13 autres critères.
- Par requête en résolution
low: 280 (image) + 20 (contexte texte) + 16 x 30 (questions) = 780 tokens - 10 000 photos : 10 000 x 780 = 7,8M de tokens
- Coût payant : 7,8 x 0,10 $ = 0,78 $
- En résolution
high: 1 120 + 20 + 480 = 1 620 tokens par photo, 16,2M de tokens, 1,62 $
Sur le palier gratuit, c'est le TPM qui détermine votre vitesse : 50 000 / 780 = environ 64 photos par minute. Les 10 000 photos se terminent en environ 2 h 36 et consomment exactement le quota d'une journée de 10 000 requêtes. En high, c'est environ 30 par minute et 5,5 heures.
Voyons maintenant l'erreur à éviter. Si vous envoyez les 16 vérifications en 16 requêtes séparées, chacune renvoie l'image : 16 x 300 = 4 800 tokens image et contexte, plus les mêmes 480 tokens de questions, soit environ 5 280 par photo. Cela fait 52,8M de tokens (5,28 $ en payant) et 160 000 requêtes, soit 16 jours de quota du palier gratuit. Regroupez les questions.
10 000 tickets de support x 3 questions de routage
- Par requête : 250 (texte du ticket) + 3 x 40 (questions avec critères) = 370 tokens
- 10 000 tickets : 3,7M de tokens, 0,37 $ en payant
- Palier gratuit : 50 000 / 370 = 135 requêtes par minute, sous le plafond de 200 RPM. Le quota d'une journée de 10 000 requêtes couvre 10 000 tickets.
Longs PDF
La fenêtre de contexte est de 262 144 tokens, mais le TPM gratuit est de 50 000, donc un seul contrat de 120 000 tokens dépasse une minute complète du budget gratuit. La documentation de Google ne précise pas comment le palier gratuit gère une requête unique dépassant le plafond TPM, alors testez-en une d'abord. Les longs documents sont le cas où le Tier 1 (1M TPM) justifie son coût.
Autres façons d'utiliser Gemini Decision 1 à 0 $
| Voie d'accès | Coût | Carte ou facturation requise | Ce pour quoi c'est adapté |
|---|---|---|---|
| Palier gratuit de l'API Gemini (clé AI Studio) | 0 $, 200 RPM / 50 000 TPM / 10 000 RPD | Non | Prototypes, outils internes, traitements nocturnes de moins de 10 000 requêtes |
| Decisions Playground dans AI Studio | 0 $ (palier gratuit, selon l'annonce de lancement de Google) | Non | Tester la formulation des questions avant d'écrire du code |
OpenRouter (google/gemini-decision-1) |
0,10 $ par 1M d'entrée, sortie gratuite | Oui, des crédits | Une seule clé pour tous les fournisseurs ; pas gratuit |
La page du modèle sur OpenRouter, consultée le 12 novembre 2026, liste un seul fournisseur (Google AI Studio) à 0,10 $ par 1M de tokens d'entrée, sortie gratuite, et sans variante :free. Elle fonctionne via le point de terminaison Decisions d'OpenRouter, donc les SDK de chat completions ne peuvent pas l'appeler.
Comment rester dans le palier gratuit
Ces bonnes pratiques permettent de garder un prototype à 0 $ le plus longtemps possible :
- Posez toutes les questions en une seule requête. L'entrée partagée est facturée une fois, et jusqu'à 1 000 questions tiennent dans un seul appel.
- Réduisez la résolution des médias.
lowcoûte un quart dehighpar image. - N'envoyez que les champs nécessaires aux questions. Google indique que du contenu non pertinent baisse la précision, et cela consomme du TPM.
- Limitez le débit sur le TPM, pas le RPM. Rythmez les workers sur 50 000 divisé par vos tokens mesurés par requête.
- Mettez les réponses en cache vous-même. L'API n'a pas de cache de contexte et compte les entrées répétées en totalité, donc hachez l'entrée plus les questions et évitez les doublons.
- Lancez les gros traitements après minuit, heure du Pacifique, pour disposer d'une journée complète de quota.
- Gardez les tests et la CI à l'écart de la vraie API. Une suite qui l'appelle à chaque push peut épuiser 10 000 requêtes avant midi. Mockez-la à la place.
Faites mocker l'API Decisions par votre agent de codage avec Apidog CLI
Les tests unitaires n'ont pas besoin d'un modèle en production. Ils ont besoin de la bonne structure : une map answers, un noul entre 0,01 et 0,99, une confidence, et usage.total_output_tokens: 0. Votre agent de codage peut construire ce mock avec Apidog CLI, de sorte qu'un seul test de fumée touche Google.
Configuration en une fois :
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
Puis donnez à Claude Code, Codex ou Cursor une seule invite :
In Apidog project <id>, add the Gemini Decisions endpoint POST /v1beta/decisions
with a request body of model, input and questions. Create mock expectations that
return a damaged answer (noul 0.97) and an undamaged one (noul 0.04), each with
usage.total_output_tokens = 0. Add a test case that asserts the answers map,
confidence between 0 and 1 and zero output tokens. Run it against the mock
environment, then once against the real API with my free-tier key.
L'agent lit chaque schéma de payload, le valide, et seulement ensuite écrit :
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file decisions-endpoint.json
apidog endpoint create --project <id> --file decisions-endpoint.json

apidog cli-schema get mock-create
apidog cli-schema validate mock-create --file mock-damaged.json
apidog mock create --project <id> --file mock-damaged.json

apidog cli-schema get test-case-create
apidog test-case create --project <id> --file decisions-case.json
apidog run --test-case <caseId> --project <id> -e <mockEnvId> -r cli,json
apidog run --test-case <caseId> --project <id> -e <freeTierEnvId> -r cli
En CI, lancez uniquement l'environnement mock avec -r junit (fichier de pipeline dans notre guide CI/CD d'Apidog CLI) ; la configuration de l'agent est décrite dans Apidog CLI dans Claude Code. Le plan gratuit d'Apidog couvre jusqu'à 4 utilisateurs, donc une petite équipe partage les mocks sans frais. Vous hésitez aussi avec la version d'OpenAI ? Consultez notre présentation de l'API OpenAI Decisions.
FAQ
L'API Gemini Decisions est-elle gratuite ? Oui, dans certaines limites. Le palier gratuit ne facture rien en entrée et la sortie fait toujours 0 token. Vous disposez de 200 requêtes par minute, 50 000 tokens par minute et 10 000 requêtes par jour et par projet. Au-delà, configurez la facturation et payez 0,10 $ par 1M de tokens d'entrée.
Faut-il une carte bancaire pour le palier gratuit de l'API Gemini Decisions ? Non. Une clé API issue de Google AI Studio démarre sur le palier gratuit. La page des limites de débit de Google indique que vous ne passez à un palier payant qu'après avoir configuré la facturation dans AI Studio.
Google entraîne-t-il ses modèles sur mes données de l'API Decisions du palier gratuit ? La page des tarifs de Google marque « Utilisé pour améliorer nos produits » comme Oui pour le palier gratuit et Non pour le payant. Considérez les clés du palier gratuit comme inadaptées aux données sensibles.
Pourquoi est-ce que j'obtiens des erreurs 429 bien en dessous de 200 requêtes par minute ? Vous dépassez probablement 50 000 tokens par minute. Les entrées image, audio et PDF consomment beaucoup de tokens, donc le TPM limite généralement avant le RPM. Consignez usage.total_input_tokens et rythmez les requêtes sur 50 000 divisé par ce chiffre.
Existe-t-il un modèle Gemini Decision 1 gratuit sur OpenRouter ? Non, au 12 novembre 2026. OpenRouter liste google/gemini-decision-1 à 0,10 $ par 1M de tokens d'entrée et 0 $ en sortie, sans variante :free.
Puis-je utiliser l'API Batch ou le cache de contexte pour étirer le palier gratuit ? Non. La page du modèle indique que l'API Batch et le cache ne sont pris en charge sur aucun palier. Regroupez les questions en une seule requête et mettez les réponses en cache dans votre propre code.