Gemini 4 Neon vs GPT-6.2 Astra vs Claude Fable 5.2, en une ligne : Fable 5.2 obtient le meilleur score, Neon coûte le moins par token, et Astra termine une tâche de benchmark indépendante pour le moins cher. Neon est affiché à 3 $ / 15 $ par million de tokens en entrée/sortie, tandis qu'Astra et Fable sont tous deux à 8 $ / 40 $. Les trois offrent environ 1 M de tokens de contexte.
Trois modèles de pointe sortis en dix jours : Claude Fable 5.2 le 9 novembre 2026, GPT-6.2 Astra le 17 novembre et Gemini 4 Neon le 18 novembre. Ci-dessous : prix, caractéristiques, scores indépendants, coût par tâche et un moyen de tester les trois avec Apidog CLI.
Gemini 4 Neon vs GPT-6.2 Astra vs Claude Fable 5.2 : le verdict rapide
Choisissez en fonction de votre charge de travail, pas du classement :
- Gemini 4 Neon pour le codage et l'analyse complexes que vous enchaînez toute la journée. Il est 62,5 % moins cher par token que les deux autres et se classe deuxième sur le Vals Index.
- GPT-6.2 Astra si votre stack repose sur l'API OpenAI Responses. Il génère bien moins de tokens par tâche, ce qui en fait le moins cher des trois par tâche Artificial Analysis malgré son prix de 8 $ / 40 $.
- Claude Fable 5.2 pour les travaux les plus difficiles sur un long horizon, où une exécution ratée coûte plus cher que les tokens. Il domine les deux indexes indépendants, au coût par tâche le plus élevé.
Si vous venez du précédent d'octobre, notre comparatif Gemini 4 Argon vs GPT-6 Astra vs Claude Opus 5.5 couvre la génération précédente.
Comment les trois modèles se comparent-ils en prix et en caractéristiques ?
Neon fait figure d'exception sur le prix. Les chiffres proviennent du billet de lancement de Gemini 4 Neon et de sa page tarifaire de Google, de la page du modèle GPT-6.2 Astra et de la présentation de Claude Fable 5.2 d'Anthropic.
| Caractéristique | Gemini 4 Neon | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|---|
| ID du modèle API | gemini-4-neon |
gpt-6.2-astra |
claude-fable-5-2 |
| Date de sortie | 18 nov. 2026 | 17 nov. 2026 | 9 nov. 2026 |
| Entrée / sortie par 1 M | 3 $ / 15 $ | 8 $ / 40 $ | 8 $ / 40 $ |
| Entrée en cache par 1 M | 0,15 $ (implicite uniquement) | 0,40 $ | 0,20 $ |
| Fenêtre de contexte | 1 048 576 (partagée avec la sortie) | 1 050 000 (922 000 d'entrée max.) | 1 M |
| Sortie max. par requête | 65 536 | 128 000 | 128 K |
| Prompts longs | Tarif fixe sur 1 M | Au-delà de 272 K d'entrée : entrée x2, sortie x1,5 | Tarif fixe sur 1 M |
| Remise par lot | 50 % (Batch et Flex) | 50 % | 50 % |
| Contrôle du raisonnement | thinking_level : de low à xhigh, high par défaut |
reasoning.effort, none rejeté |
effort, high par défaut |
| Niveau d'API gratuit | Non | Non | Non |
Deux détails changent la facture réelle. La mise en cache de Neon est implicite : vous n'obtenez le tarif de 0,15 $ que lorsque Google identifie un préfixe de prompt répété. Et Neon ne renvoie au maximum que 65 536 tokens par requête, si bien que les sorties très longues nécessitent le décodage long de Google ou une boucle de continuation.
Pour les grilles tarifaires complètes, consultez nos analyses détaillées de la tarification de Gemini 4 Neon, de la tarification de GPT-6.2 Astra et de la tarification de Claude Fable 5.2.
Quel modèle l'emporte sur les benchmarks indépendants ?
Les tableaux de benchmarks des fournisseurs partagent rarement les mêmes tests. Deux classements indépendants évaluent les trois sur une même suite, et ils ne sont pas d'accord sur la deuxième place.
| Métrique | Gemini 4 Neon | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|---|
| Artificial Analysis Intelligence Index | 61 (xhigh) | 62 (max) | 65 (max) |
| Vals Index | 70,87 %, n° 2 | 67,66 %, n° 8 | 71,31 %, n° 1 |
| Coût AA par tâche de l'index | 6,44 $ | 4,00 $ | 26,54 $ |
| Temps AA par tâche de l'index | 21,5 min | 13,9 min | 41,8 min |
| Vitesse de sortie AA | 110 tok/s | 49 tok/s | 109 tok/s |
| Tokens de sortie sur l'index AA | 283 M | 65,8 M | 275 M |
Sources : les pages de modèle Artificial Analysis de chaque modèle, consultées le 19 novembre 2026, et le Vals Index au 18 novembre 2026.
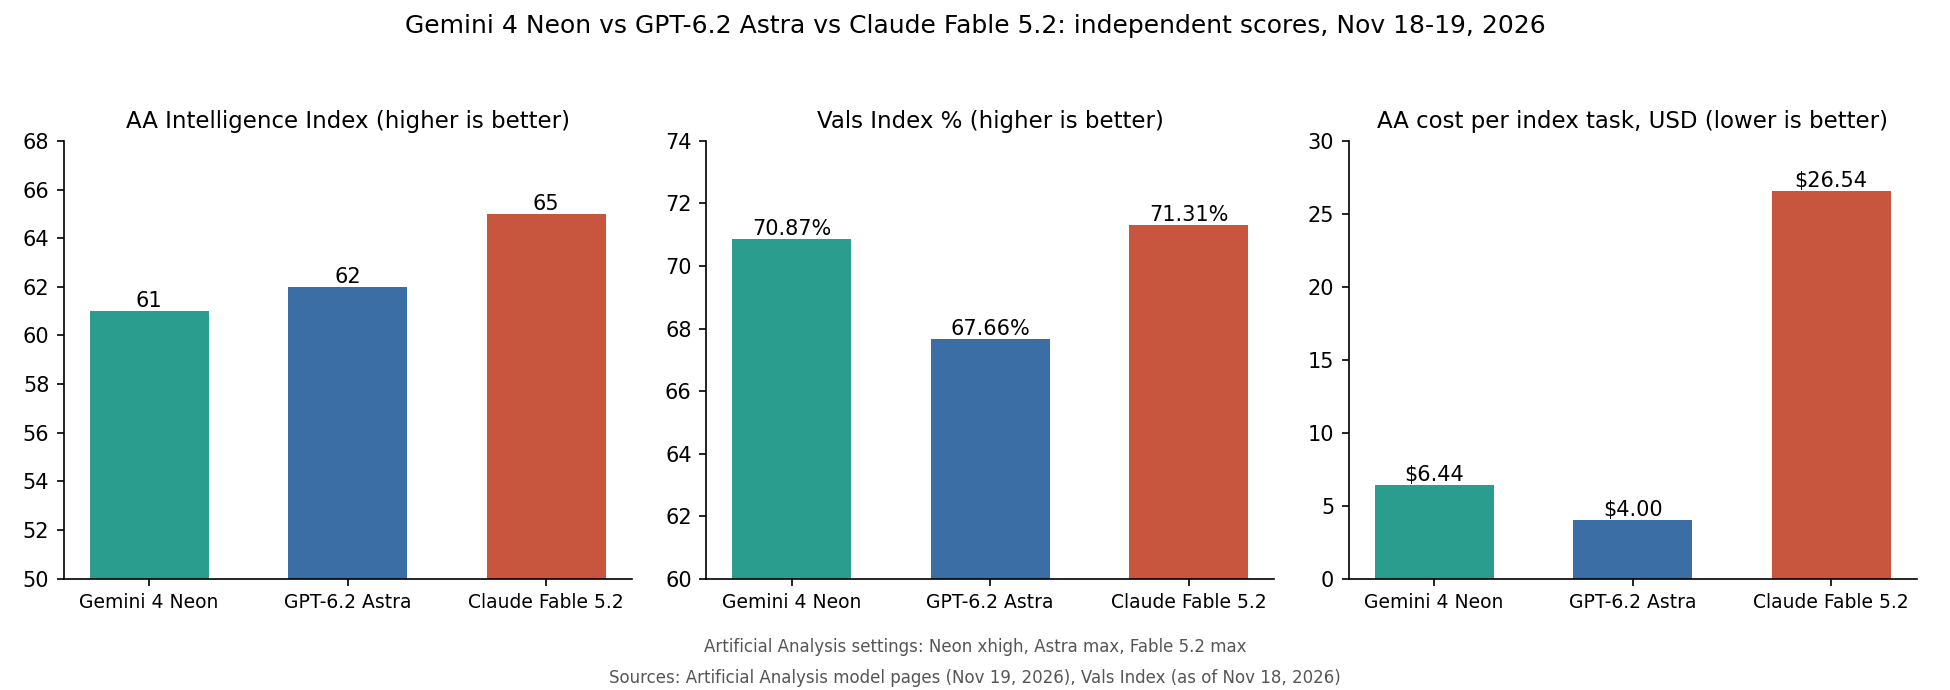
Fable 5.2 domine les deux classements, et sur Vals, Neon n'est qu'à 0,44 point derrière lui. Artificial Analysis place Astra un point devant Neon ; Vals place Neon plus de 3 points devant Astra.
Le billet de lancement de Google classait Neon n° 3 sur Artificial Analysis ; le 19 novembre, la même page le liste n° 6 sur 96. Les rangs du jour du lancement évoluent vite, et un écart d'un point relève du bruit. Les lignes de coût et de vitesse vous en disent davantage sur la sensation que chaque modèle procurera dans votre agent.
Pourquoi le plus cher par token coûte-t-il le moins par tâche ?
Le prix par token ne représente que la moitié de la facture ; l'autre moitié, c'est le nombre de tokens qu'un modèle écrit avant de répondre. Sur la suite Artificial Analysis, Astra a généré 65,8 M de tokens de sortie. Neon en a généré 283 M et Fable 275 M, soit plus de quatre fois plus. Le tarif de sortie de 40 $ d'Astra s'applique à un volume bien plus réduit, si bien que son coût par tâche s'établit à 4,00 $, en dessous des 6,44 $ de Neon, alors même que le tarif de sortie de Neon est 62,5 % inférieur.
Les réglages comptent. Artificial Analysis a exécuté Neon en xhigh ; en high, il obtient 60 avec 123 M de tokens de sortie au lieu de 283 M, soit un point pour moins de la moitié des tokens. Notre guide des niveaux de réflexion de Gemini 4 Neon montre la courbe complète.
Les 26,54 $ de Fable combinent un tarif de sortie élevé et une grande verbosité : le prix du meilleur score.
Combien coûte une charge de travail d'agent réelle sur chaque modèle ?
Deux charges de travail aux tarifs catalogue, en supposant des nombres de tokens identiques sur chaque modèle (ce qui ne sera pas le cas : lisez donc ceci comme une comparaison de prix, non comme une prévision).
| Charge de travail | Gemini 4 Neon | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|---|
| Session d'agent : 150 K d'entrée fraîche, 1,35 M de lectures de cache, 150 K de sortie | 0,45 $ + 0,20 $ + 2,25 $ = 2,90 $ | 1,50 $ + 0,54 $ + 6,00 $ = 8,04 $ | 1,50 $ + 0,27 $ + 6,00 $ = 7,77 $ |
| Une seule requête longue : 400 K d'entrée, 8 K de sortie, sans cache | 1,20 $ + 0,12 $ = 1,32 $ | 6,40 $ + 0,48 $ = 6,88 $ | 3,20 $ + 0,32 $ = 3,52 $ |
Astra et Fable facturent les 150 K premiers comme une écriture de cache à 10 $ par 1 M ; Neon n'a pas de frais d'écriture. La requête longue illustre la règle des 272 K d'Astra : au-delà de cette limite, OpenAI facture 16 $ en entrée et 60 $ en sortie par 1 M pour toute la requête.
Si Neon écrit 3 fois plus de tokens qu'Astra sur vos prompts, sa session à 2,90 $ peut coûter plus cher que celle d'Astra. Mesurez les tokens de sortie avant de choisir sur le prix.
Quelles différences d'API vont casser votre harnais d'agent ?
Chaque API rejette des réglages que les autres acceptent :
- Gemini 4 Neon : l'ancien paramètre
thinking_budgetrenvoie un HTTP 400, tout commefrequency_penaltyetpresence_penalty. Les valeurs personnalisées detemperature,top_kettop_psont ignorées, selon le guide développeur de Google Cloud. - GPT-6.2 Astra :
reasoning.effortréglé surnonerenvoie un 400, et la page du modèle indique que Realtime, Assistants et le fine-tuning ne sont pas pris en charge. - Claude Fable 5.2 : l'utilisation forcée d'outils (
tool_choiceavecanyoutool) et les paramètres d'échantillonnage tels quetemperaturerenvoient un 400, et la réflexion ne peut pas être désactivée.
Notre guide GPT-6.2 Astra vs Claude Fable 5.2 détaille les particularités d'Astra et de Fable, et le guide de l'API Gemini 4 Neon couvre le format de requête de Neon.
Où chaque modèle est-il le plus à son avantage ?
Gemini 4 Neon est conçu pour un travail fréquent et complexe. Google indique qu'il réduit les lectures de fichiers redondantes et peut planifier pendant que des sous-agents Gemini 4 Hydrogen moins chers exécutent les étapes ; dans Google Antigravity, /swarm exécute les agents en parallèle.
GPT-6.2 Astra apporte la boîte à outils OpenAI : apply_patch, shell hébergé, computer use, MCP et une bêta multi-agents dans l'API Responses. C'est le plus rapide des trois sur Artificial Analysis, à 13,9 minutes par tâche. Simon Willison notait le jour du lancement qu'il obtient des scores un peu inférieurs à Fable 5.2 sur plusieurs benchmarks.
Claude Fable 5.2 est le choix quand la qualité primait sur le coût : sessions d'agent longues, refactorisations difficiles, tâches de recherche. Ses lectures de cache à 0,20 $ et sa tarification fixe sur 1 M adoucissent son tarif de sortie de 40 $.
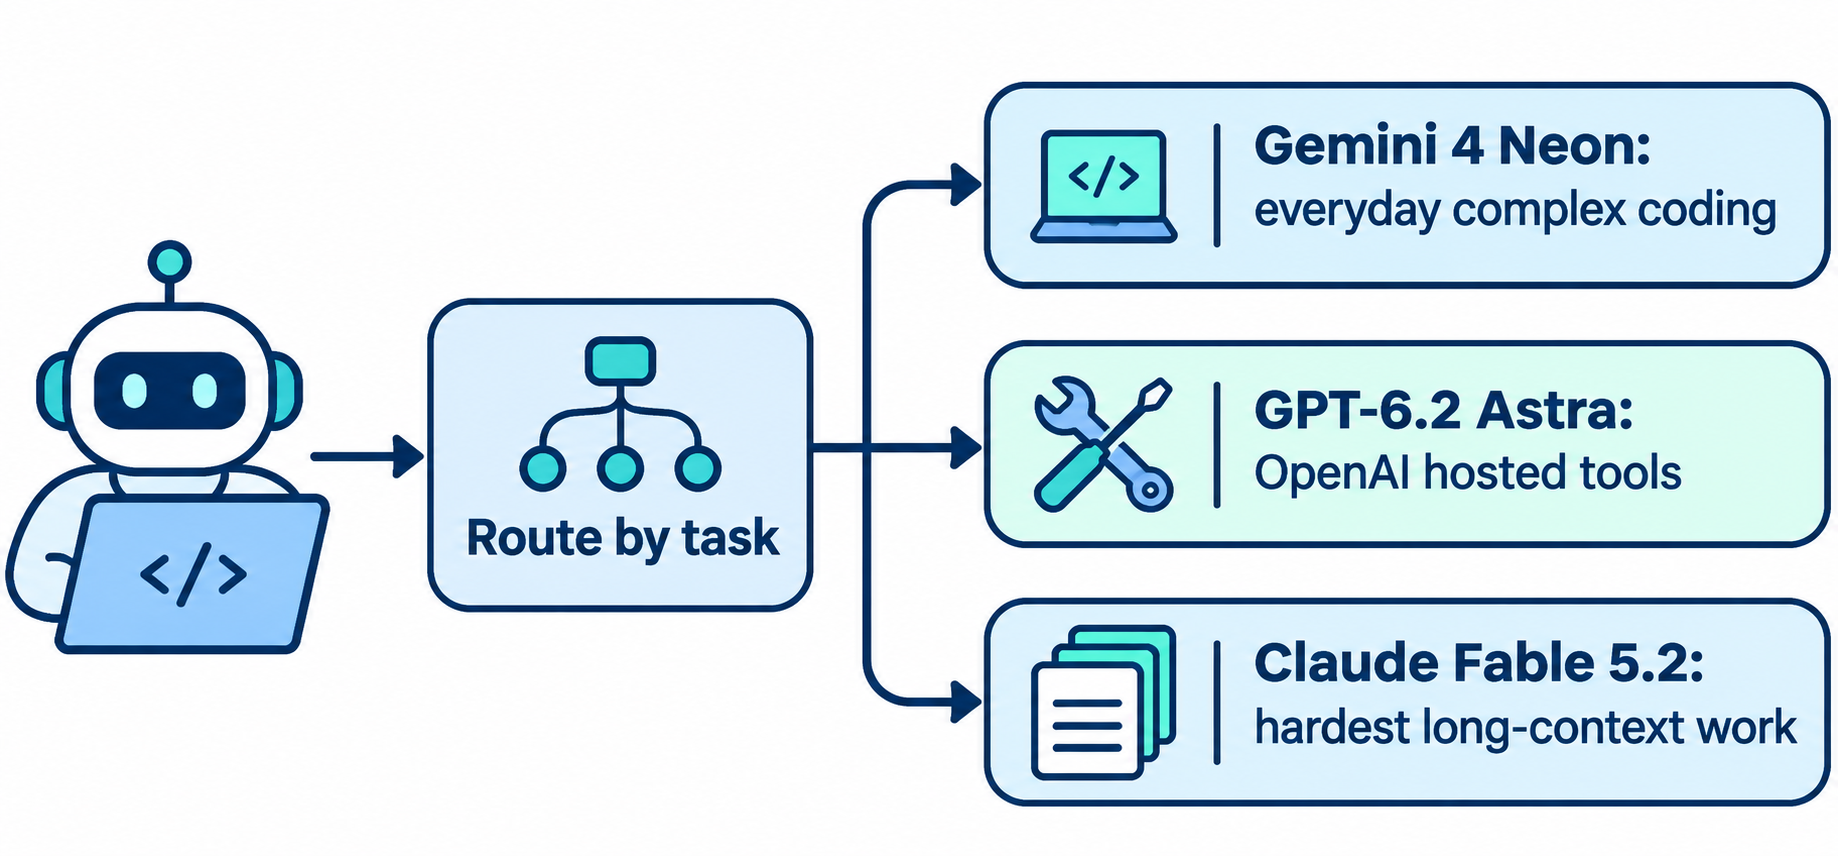
Vous n'êtes pas obligé de choisir un seul modèle. Envoyez le gros des étapes d'agent à Neon et les quelques tâches qui y échouent à Fable ou Astra ; votre coût moyen restera proche de celui de Neon.
Comment tester les trois modèles sur votre propre charge de travail ?
Les classements mesurent les tâches de quelqu'un d'autre. Envoyez 5 à 10 prompts réels issus de l'historique de votre agent aux trois API, et comparez le taux de réussite, les tokens et la latence. Exécuter ces requêtes à la main devient vite fastidieux : laissez donc Claude Code, Codex ou Cursor piloter Apidog CLI. L'installation tient en trois commandes :
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_APIDOG_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Donnez ensuite un seul prompt à votre agent :
In Apidog project <PROJECT_ID>, create three test cases that send the
same code-review prompt to gemini-4-neon (Gemini Interactions API,
thinking_level high), gpt-6.2-astra (OpenAI Responses API, effort high)
and claude-fable-5-2 (Claude Messages API, no temperature field).
Keep each API key in a private environment variable. Assert a 200
status and a non-empty answer, record token usage and response time,
run each case 5 times and summarize cost per run at list prices.
Validate every payload against its schema before you write it.
L'agent vérifie chaque schéma de payload, écrit les cas de test et les exécute. Ces options proviennent de apidog run --help dans la CLI 2.2.12 :
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file neon-case.json
apidog test-case create --project <PROJECT_ID> --file neon-case.json
apidog test-case create --project <PROJECT_ID> --file astra-case.json
apidog test-case create --project <PROJECT_ID> --file fable-case.json
apidog run --test-case <NEON_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir abc-results
Répétez la dernière commande avec les IDs de cas d'Astra et de Fable. -n 5 exécute chaque cas cinq fois, et --upload-report affiche les exécutions dans l'application Apidog. Il s'agit d'un modèle de flux de travail ; nous ne l'avons pas exécuté sur les trois API depuis cette machine.
Ajoutez des cas négatifs pour les 400 ci-dessus, afin qu'un changement de règle chez un fournisseur apparaisse d'abord dans votre suite. Le guide d'Apidog CLI dans Claude Code couvre la configuration de l'agent, et le plan Free d'Apidog prend en charge jusqu'à 4 utilisateurs.
FAQ
Gemini 4 Neon est-il meilleur que GPT-6.2 Astra ? Cela dépend du classement : Neon devance Astra sur le Vals Index (70,87 % contre 67,66 %), Astra devance Neon d'un point sur l'Artificial Analysis Intelligence Index (62 contre 61). Neon coûte 3 $ / 15 $ par 1 M de tokens contre 8 $ / 40 $ pour Astra.
Lequel des trois est le moins cher ? Par token, Gemini 4 Neon, à 3 $ en entrée et 15 $ en sortie par 1 M. Par tâche Artificial Analysis, GPT-6.2 Astra, à 4,00 $, car il écrit bien moins de tokens que Neon (6,44 $) ou Fable 5.2 (26,54 $).
Quel modèle obtient le meilleur score ? Claude Fable 5.2 domine à la fois l'Artificial Analysis Intelligence Index (65) et le Vals Index (71,31 %) au 18-19 novembre 2026.
L'un d'eux propose-t-il un niveau d'API gratuit ? Non. Google ne liste aucun niveau gratuit pour Neon, et Astra et Fable 5.2 sont des modèles API payants. Les abonnés Google AI Pro et Ultra peuvent utiliser Neon dans l'application Gemini et Antigravity. Voir notre guide gratuit de Gemini 4 Neon pour les options à 0 $.
Puis-je en utiliser plusieurs dans le même agent ? Oui. Routez les étapes de routine vers Neon et les tâches qui y échouent vers Fable 5.2 ou Astra. Testez chaque route d'abord : le nombre de tokens par tâche varie de plus de 4x d'un modèle à l'autre.