
Gemini 4 Neon face à Carbon est désormais un vrai choix pour toutes les équipes utilisant l’API Gemini. Google a ajouté Neon en novembre 2026 comme modèle intermédiaire, positionné entre Hydrogen et Carbon, et les trois partagent un même schéma de requête, une fenêtre de contexte de 1M de tokens et les mêmes outils intégrés. Ce qui les distingue, c’est la profondeur de leur raisonnement, leur vitesse d’exécution et le coût de chaque token.
Réponse rapide : choisissez Gemini 4 Hydrogen par défaut (1,50 $ en entrée / 7,50 $ en sortie par 1M de tokens, palier gratuit disponible) pour le codage quotidien et les agents workers. Passez une tâche à Gemini 4 Neon (3 $ / 15 $, palier payant uniquement) lorsqu’elle est complexe et exécutée fréquemment, comme des refontes multi-fichiers ou l’analyse de documents denses. Réservez Gemini 4 Carbon (2 $ / 10 $ jusqu’au 30 novembre 2026, puis 4 $ / 20 $) à vos problèmes les plus difficiles d’architecture, de débogage et de sécurité.
Gemini 4 Neon vs Carbon vs Hydrogen en un coup d’œil
Gemini 4 Neon est le modèle Gemini 4 intermédiaire de Google, conçu pour les tâches complexes d’ingénierie logicielle, de travail intellectuel et de science que vous exécutez à haute fréquence. Il raisonne plus profondément qu’Hydrogen, termine plus vite et avec moins de tokens de sortie que Carbon, et coûte 3 $ par 1M de tokens en entrée et 15 $ par 1M en sortie, sur le palier payant uniquement.
Voici la comparaison côte à côte, tirée du guide Choosing a model de Google et de la page des tarifs de l’API Gemini, tous deux consultés le 19 novembre 2026 :
| Gemini 4 Hydrogen | Gemini 4 Neon | Gemini 4 Carbon | |
|---|---|---|---|
| Identifiant du modèle | gemini-4-hydrogen |
gemini-4-neon |
gemini-4-carbon |
| Positionnement | Défaut rapide | Travail complexe à haute fréquence | Raisonnement le plus puissant |
| Vitesse (selon Google) | Rapide | Modérée | Méthodique |
| Entrée / sortie par 1M | 1,50 $ / 7,50 $ | 3,00 $ / 15,00 $ | 2,00 $ / 10,00 $ jusqu’au 30 nov., puis 4,00 $ / 20,00 $ |
| Entrée en cache par 1M | 0,075 $ | 0,15 $ | 0,10 $, puis 0,20 $ |
| Niveaux de réflexion | low, medium, high (défaut), xhigh | low, medium, high (défaut), xhigh | low, medium (défaut), high |
| Palier API gratuit | Oui | Non | Non |
| Fenêtre de contexte | 1 048 576 tokens, unifiée | 1 048 576 tokens, unifiée | 1 048 576 tokens, unifiée |
Les trois acceptent du texte, des images, des vidéos, de l’audio et des PDF en entrée, et prennent en charge l’appel de fonctions, les sorties structurées, l’exécution de code, l’usage d’ordinateur et le grounding avec Google Search. Chacun a un plafond de sortie synchrone de 65 536 tokens et peut le dépasser jusqu’à 1M de tokens avec le long decode.
Quel modèle Gemini 4 choisir ?
Les recommandations de Google sont brèves et méritent de servir de point de départ :
- Commencez par Hydrogen pour la plupart des nouveaux projets : codage quotidien, applications interactives, agents utilisant des outils et pipelines documentaires multimodaux. Google indique qu’il réduit les affirmations fabriquées de plus de 5x par rapport à Gemini 3.8 Flash.
- Passez à Neon quand Hydrogen ne suffit plus et que vous n’avez pas besoin de la vérification supplémentaire de Carbon : débogage au niveau du dépôt, refontes multi-fichiers, analyses juridiques, financières et scientifiques exécutées plusieurs fois par jour.
- Réservez Carbon à l’architecture système, au débogage multi-fichiers, aux preuves formelles, aux audits de sécurité ou à toute tâche où un modèle plus rapide se bloque.
- Descendez à Gemini 3.5 Flash-Lite (0,30 $ / 2,50 $) pour le traitement de texte à fort volume comme la traduction, l’extraction et la synthèse.
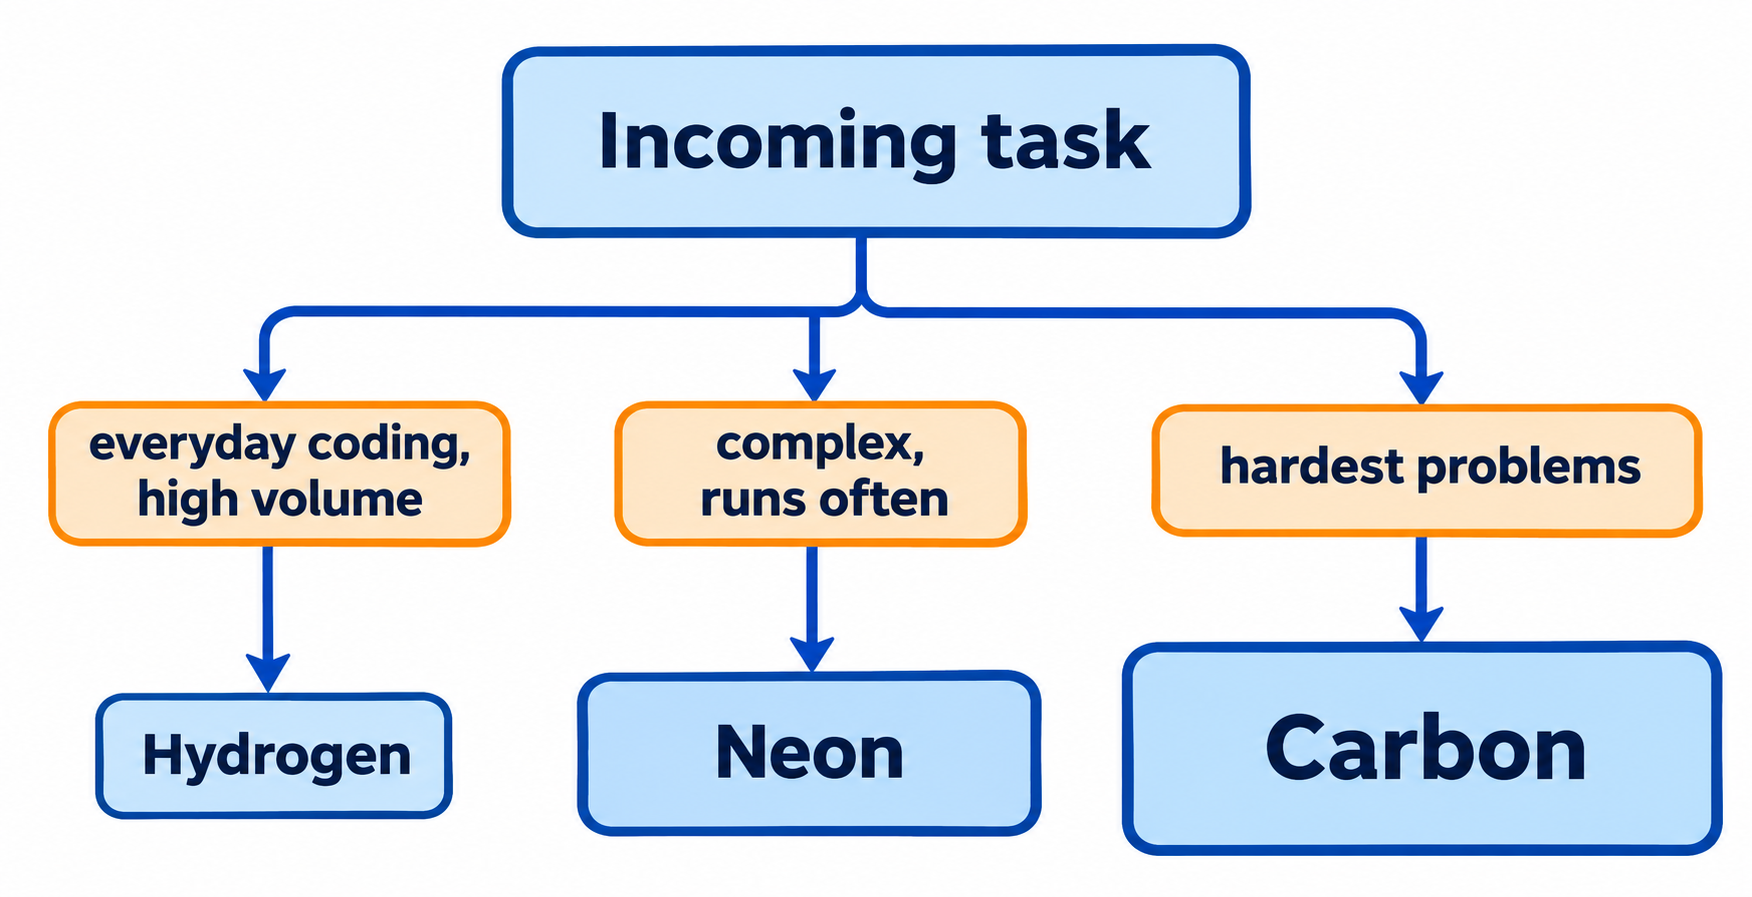
Le mot-clé pour Neon, c’est « souvent ». Un audit de sécurité trimestriel peut se permettre le raisonnement plus lent de Carbon. Un agent de refonte qui traite 200 pull requests par semaine a besoin de quelque chose qui se termine vite tout en réussissant les parties difficiles.
Gemini 4 Neon vs Carbon : prix et profondeur de raisonnement
C’est la comparaison qui intéresse le plus la plupart des équipes, car Neon et Carbon visent tous deux le travail exigeant.
Style de raisonnement. Carbon dépense plus de tokens de réflexion par tour pour tester des hypothèses, isoler les causes racines dans un dépôt et vérifier les corrections avec les tests. Neon vise une qualité de pointe avec une consommation de tokens plus sobre. Selon la page What’s new in Gemini 4 Neon de Google, il termine le débogage au niveau du dépôt en moins d’étapes, réduit les lectures de fichiers redondantes lors des longues sessions d’appels d’outils et gère de manière fiable la compaction du contexte.
Des valeurs par défaut différentes. Carbon utilise par défaut une réflexion medium et plafonne à high. Neon est par défaut à high et ajoute xhigh pour les problèmes multi-étapes les plus difficiles. Si vous remplacez Carbon par Neon sans définir thinking_level, vous modifiez aussi la profondeur de réflexion du modèle.
Le prix bascule le 1er décembre. Jusqu’au 30 novembre 2026, le tarif de lancement de Carbon (2 $ / 10 $) est en réalité moins cher par token que Neon (3 $ / 15 $). À partir du 1er décembre, Carbon double à 4 $ / 20 $, et Neon devient 25 % moins cher par token. Neon n’a pas de tarif de lancement, donc son prix ne bouge pas.
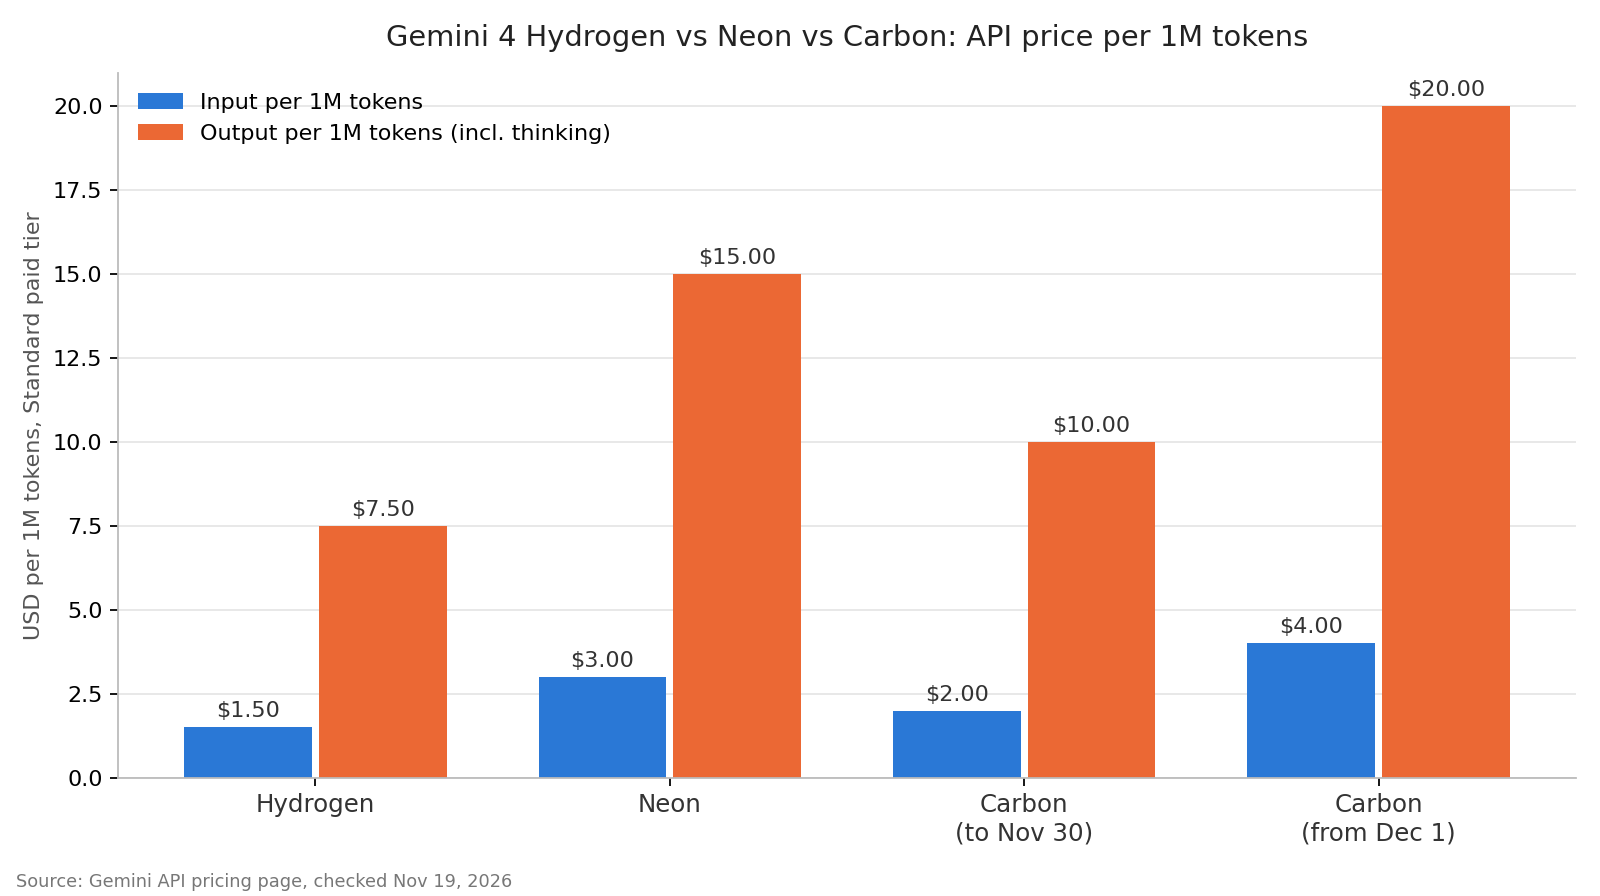
Le prix par token ne représente toutefois que la moitié de la facture : la tarification de sortie inclut les tokens de réflexion, et Carbon est conçu pour réfléchir davantage.
Gemini 4 Neon vs Hydrogen : quand la montée en gamme se justifie
Sur le papier, Hydrogen et Neon se ressemblent : mêmes niveaux de réflexion, même défaut, même fenêtre de contexte, mêmes outils. Neon coûte exactement deux fois plus cher par token.
La montée en gamme se justifie quand la réponse d’Hydrogen impose de réessayer. Si Hydrogen a besoin de trois tentatives pour réussir une refonte multi-fichiers que Neon réussit en une seule, le modèle le moins cher devient le plus coûteux.
Deux différences pratiques :
- Palier gratuit. Hydrogen dispose d’un palier API gratuit pour le prototypage. Pas Neon : il vous faut un projet sur le palier payant avant votre premier appel. Sur ce palier gratuit, Google peut utiliser vos données pour améliorer ses produits.
- Tarification Batch. Tous deux divisent leur prix par deux en mode Batch : Hydrogen descend à 0,75 $ / 3,75 $ et Neon à 1,50 $ / 7,50 $. Un traitement Batch nocturne sur Neon coûte le même prix par token qu’un appel Hydrogen en temps réel.
Si vous utilisez déjà Hydrogen comme exécutant rapide sous Carbon comme planificateur, consultez notre analyse du pattern d’orchestrateur Gemini 4 Hydrogen. Neon ajoute à cette configuration une troisième voie pour les étapes de difficulté intermédiaire.
Coût par tâche : un exemple chiffré
Prenons une tâche d’agent avec 40 000 tokens en entrée et 8 000 tokens en sortie (réflexion incluse), aux tarifs standards du palier payant :
| Modèle | Coût entrée | Coût sortie | Par tâche | Par 1 000 tâches |
|---|---|---|---|---|
| Hydrogen | 0,060 $ | 0,060 $ | 0,12 $ | 120 $ |
| Neon | 0,120 $ | 0,120 $ | 0,24 $ | 240 $ |
| Carbon (jusqu’au 30 nov.) | 0,080 $ | 0,080 $ | 0,16 $ | 160 $ |
| Carbon (à partir du 1er déc.) | 0,160 $ | 0,160 $ | 0,32 $ | 320 $ |
Ce tableau suppose que chaque modèle consomme le même nombre de tokens, ce qui ne sera pas le cas. Google indique que Carbon dépense plus de tokens de réflexion par tour et que Neon termine avec moins de tokens de sortie que Carbon. Si Carbon a besoin de 12 000 tokens de sortie pour cette même tâche, son coût en décembre monte à 0,40 $ par tâche, et l’écart avec Neon passe de 0,08 $ à 0,16 $. Ces chiffres de tokens sont illustratifs ; mesurez les vôtres avant d’établir un budget.
Trois leviers pour réduire la facture :
- Cache implicite. Actif par défaut sur les prompts d’au moins 4 096 tokens, il réduit de 95 % le coût de l’entrée en cache. Placez les prompts système stables et les définitions d’outils en tête pour qu’ils profitent du cache.
- Niveau de réflexion. Google recommande d’exécuter vos évaluations aux quatre niveaux et de choisir le plus bas qui atteint votre seuil de qualité.
xhighcoûte le plus de tokens et de latence. - Mode Batch. Le travail non urgent doit passer en mode Batch, à la moitié du tarif Standard.
Pour la chronologie complète des prix de Carbon, lisez notre guide des tarifs Gemini 4 Carbon.
Passer d’un modèle à l’autre : ce qui change dans votre code
Changer de modèle Gemini 4 ne nécessite aucune modification du schéma de requête. Vous changez la chaîne model et, généralement, le thinking_level :
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "gemini-4-neon",
    "input": "Find the race condition in this retry queue and propose a fix.",
    "generation_config": { "thinking_level": "high" }
  }'
Quand vous migrez une charge de travail :
- Épinglez explicitement
thinking_level. Le défaut de Carbon estmedium; ceux de Neon et Hydrogen sonthigh. Un changement sans épinglage modifie le coût et la latence. - Utilisez un projet sur palier payant pour Neon et Carbon. Les clés du palier gratuit n’accèdent qu’à Hydrogen et Flash-Lite.
- Supprimez les paramètres d’échantillonnage. Le guide de migration de Neon précise que
temperature,top_pettop_ksont ignorés dans la plage valide et renvoient une erreur400hors plage. - Chaînez les modèles avec
previous_interaction_id. Comme les trois partagent un même schéma, vous pouvez planifier avec Carbon, implémenter avec Hydrogen et confier à Neon les étapes intermédiaires délicates, le tout dans une seule conversation.
Faites comparer les trois modèles par votre agent de codage avec Apidog CLI
Le moyen le plus rapide de trancher entre Neon, Carbon et Hydrogen est d’envoyer le même prompt aux trois et de comparer statut, latence et consommation de tokens. Votre agent de codage peut construire et exécuter ce test avec Apidog CLI pendant que vous continuez à travailler.
Installez le CLI et donnez à votre agent la compétence Apidog :
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Puis donnez à Claude Code, Codex ou Cursor un seul prompt :
In Apidog project <id>, create a test scenario named "Gemini 4 model compare"
that POSTs to https://generativelanguage.googleapis.com/v1beta/interactions
with model {{model}}, thinking_level "high" and the prompt in {{prompt}}.
Assert status 200 and a non-empty output, and save the usage block to a variable.
Run it once each for gemini-4-hydrogen, gemini-4-neon and gemini-4-carbon,
then give me a table of latency and token usage per model.
L’agent lit le schéma du payload, valide son fichier, crée le scénario et l’exécute trois fois en ne changeant que le modèle :
apidog cli-schema get test-scenario-create
apidog cli-schema validate test-scenario-create --file scenario.json
apidog test-scenario create --project <id> --file scenario.json
apidog run -t <scenarioId> --project <id> -e <envId> --env-var "model=gemini-4-hydrogen" -r cli,json
apidog run -t <scenarioId> --project <id> -e <envId> --env-var "model=gemini-4-neon" -r cli,json
apidog run -t <scenarioId> --project <id> -e <envId> --env-var "model=gemini-4-carbon" -r cli,json
Conservez GEMINI_API_KEY dans l’environnement Apidog. Ajoutez --upload-report pour consulter chaque exécution dans l’application, et placez la même commande en CI avec -r junit pour détecter les régressions quand Google met à jour un modèle. Notre guide sur Apidog CLI dans Claude Code couvre la configuration de bout en bout. Le plan gratuit d’Apidog couvre les équipes jusqu’à 4 utilisateurs.
FAQ
Gemini 4 Neon est-il meilleur que Gemini 4 Carbon ? Pas sur tous les plans. Carbon est le modèle de raisonnement le plus puissant de Google. Neon échange un peu de profondeur contre une exécution plus rapide et moins de tokens de sortie, ce qui convient au travail complexe exécuté fréquemment.
Gemini 4 Neon est-il gratuit ? Non. Neon est disponible uniquement sur le palier payant de l’API Gemini, ainsi que dans Google AI Studio avec les forfaits Google AI Pro et Ultra. Hydrogen est le modèle Gemini 4 qui dispose d’un palier API gratuit.
Neon est-il moins cher que Carbon ? Par token, uniquement à partir du 1er décembre 2026. Jusqu’au 30 novembre, le tarif de lancement de Carbon (2 $ / 10 $) est inférieur aux 3 $ / 15 $ de Neon. Ensuite, Carbon coûte 4 $ / 20 $ et Neon est 25 % moins cher par token, sans même compter la réflexion plus gourmande de Carbon.
Gemini 4 Neon, Carbon et Hydrogen ont-ils la même fenêtre de contexte ? Oui. Les trois partagent une fenêtre unifiée de 1 048 576 tokens pour l’entrée, la réflexion et la sortie, avec un plafond de sortie synchrone de 65 536 tokens et un long decode jusqu’à 1M de tokens.
Puis-je utiliser Neon, Carbon et Hydrogen dans le même workflow ? Oui. Ils partagent un schéma de requête, vous pouvez donc transmettre previous_interaction_id du tour d’un modèle à celui d’un autre. Planifiez avec Carbon, implémentez avec Hydrogen et confiez à Neon les étapes intermédiaires.
Quel modèle Gemini 4 est le plus rapide ? Hydrogen. Google qualifie Hydrogen de rapide, Neon de modéré et Carbon de méthodique.