
Les niveaux de réflexion de Gemini 4 Neon offrent quatre réglages pour déterminer l'intensité du raisonnement du modèle avant qu'il ne réponde : low, medium, high et xhigh. Neon est réglé sur high par défaut. Google recommande de conserver high pour la plupart des tâches complexes et de passer à xhigh uniquement lorsque high échoue sur des problèmes difficiles à plusieurs étapes, car xhigh consomme plus de tokens et prend plus de temps.
Que sont les niveaux de réflexion de Gemini 4 Neon ?
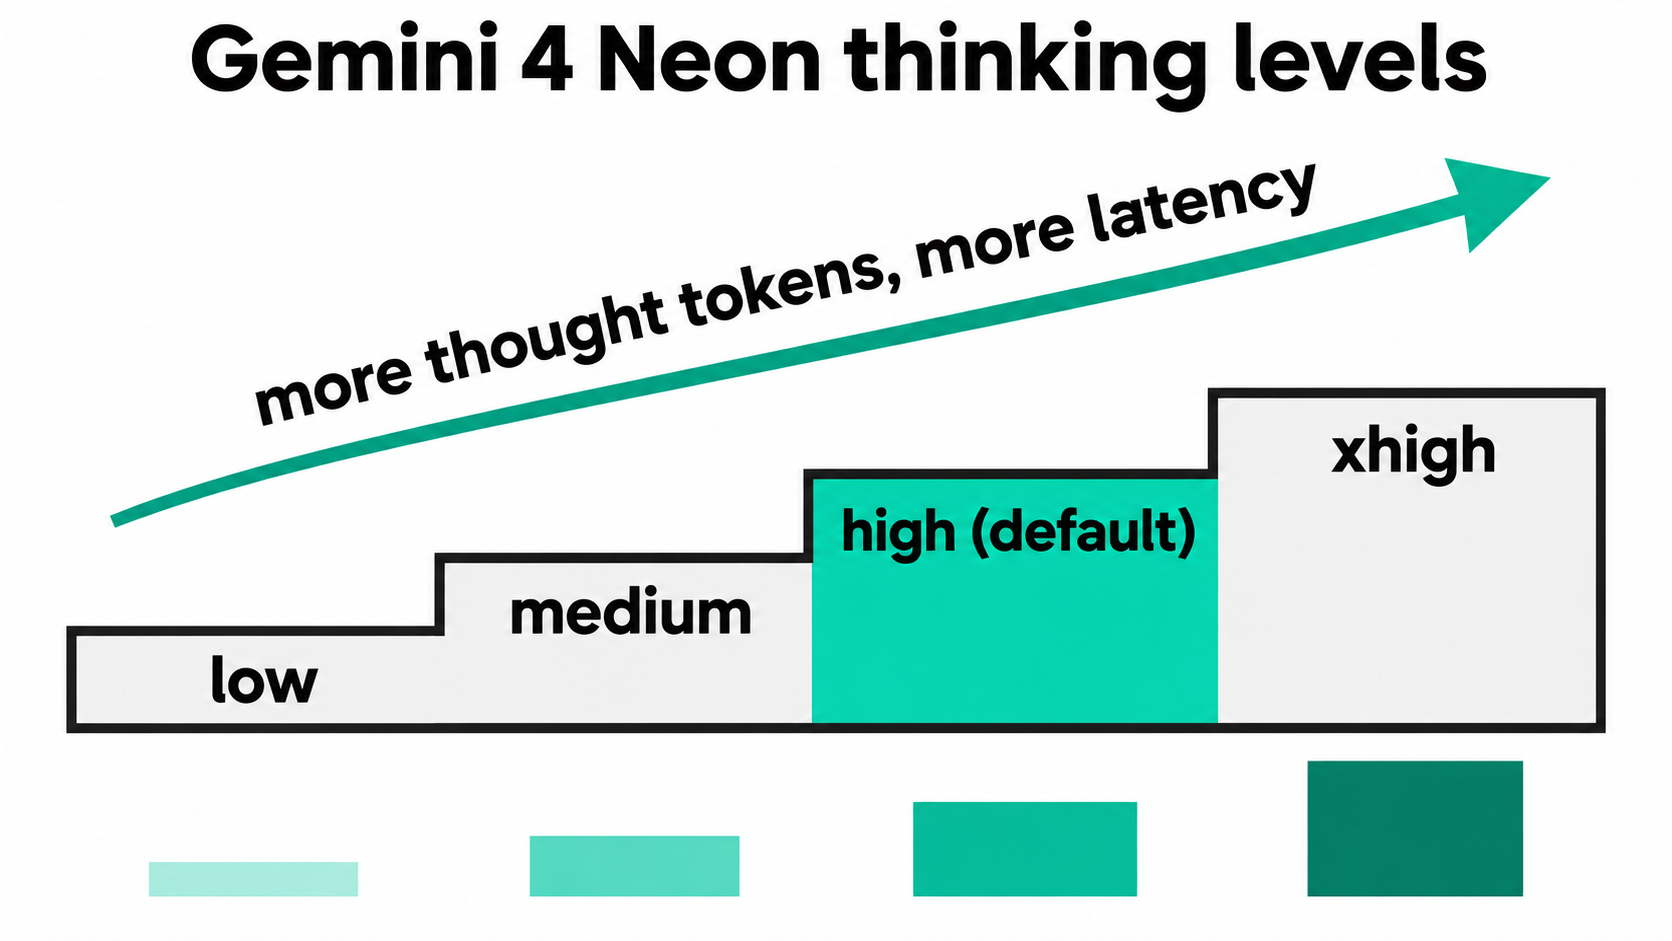
Les niveaux de réflexion sont les valeurs du paramètre thinking_level qui définissent l'ampleur du raisonnement interne effectué par gemini-4-neon avant de rédiger une réponse. Neon en prend en charge quatre : low, medium, high (par défaut) et xhigh. Les niveaux élevés utilisent davantage de tokens de réflexion et ajoutent de la latence ; les niveaux bas répondent plus vite et coûtent moins cher.
Voici comment le guide de réflexion de Google décrit chaque niveau pour Neon :
thinking_level |
Consommation de tokens | Usage suggéré par Google |
|---|---|---|
low |
Le moins de tokens, la latence la plus faible | Chat rapide, traitement à haut débit ; reste performant sur les tâches agentiques |
medium |
Consommation de tokens réduite, réponses plus rapides | Codage interactif, prototypage d'UI en direct, appels d'outils sensibles à la latence |
high (par défaut) |
Équilibre entre intelligence et rapidité | Codage complexe, exécution agentique, appels d'outils, travail de connaissance multimodale |
xhigh |
Le plus de tokens, raisonnement le plus approfondi | Ingénierie difficile à plusieurs étapes, problèmes analytiques et scientifiques où high ne suffit pas |
Deux valeurs que vous pourriez attendre sont absentes. Neon rejette minimal avec une erreur, donc du code copié depuis une application Gemini 3 Flash casse s'il envoie cette valeur. Et l'ancien comptage de tokens thinkingBudget est déprécié sur Gemini 4 : envoyé seul, il est rattaché au niveau le plus proche avec un avertissement ; envoyé en même temps que thinkingLevel, il renvoie un 400.
Comment le réglage par défaut de Neon se compare-t-il aux autres modèles Gemini 4 ?
Neon démarre un cran plus haut que ses grands frères. D'après les notes de version de Gemini 4 Neon, Neon et Hydrogen sont réglés sur high par défaut et prennent en charge xhigh, tandis que Carbon et Argon sont réglés sur medium par défaut et plafonnent à high.
| Modèle | Niveau par défaut | Niveaux pris en charge |
|---|---|---|
gemini-4-neon |
high |
low, medium, high, xhigh |
gemini-4-hydrogen |
high |
low, medium, high, xhigh |
gemini-4-carbon |
medium |
low, medium, high |
gemini-4-argon |
medium |
low, medium, high |
Cela compte lorsque vous changez de modèle. Déplacez une charge de travail Carbon vers Neon sans définir thinking_level et chaque requête passe d'un raisonnement medium à high, ce qui modifie votre nombre de tokens. Si vous comparez les modèles plus grands, notre comparatif Gemini 4 Carbon vs Argon couvre cette distinction.
Comment définir thinking_level dans l'API Gemini ?
Neon fonctionne sur le palier payant de l'Interactions API et de generateContent. Le nom du champ diffère entre les deux.
Interactions API : placez thinking_level dans generation_config.
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "gemini-4-neon",
    "input": "Audit this payment retry queue for race conditions.",
    "generation_config": {
      "thinking_level": "xhigh",
      "max_output_tokens": 65536
    }
  }'
generateContent : utilisez thinkingLevel dans generationConfig.thinkingConfig.
curl "https://generativelanguage.googleapis.com/v1beta/models/gemini-4-neon:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "contents": [{"parts": [{"text": "Audit this payment retry queue for race conditions."}]}],
    "generationConfig": {
      "thinkingConfig": {"thinkingLevel": "medium"}
    }
  }'
Dans le SDK Python, l'appel Interactions prend generation_config={"thinking_level": "high"}, et l'appel generateContent prend thinking_config=types.ThinkingConfig(thinking_level="low"). Laissez de côté temperature, top_p et top_k : Google indique que Neon ignore les valeurs dans les plages autorisées et rejette celles hors plage avec un 400. Pour un guide complet de première requête sur la même conception d'API, consultez notre guide de l'API Gemini 4 Hydrogen.
Quand utiliser high plutôt que xhigh ?
Utilisez high par défaut et ne passez une tâche à xhigh qu'après que high a échoué à votre niveau de qualité requis sur cette tâche. L'annonce de Google présente xhigh comme un « raisonnement approfondi à plusieurs étapes pour les charges de travail d'ingénierie, d'analyse et scientifiques les plus difficiles ».
Choisissez xhigh lorsque :
- La tâche comporte de nombreuses étapes dépendantes et qu'une erreur précoce ruine le résultat, comme un refactoring multi-fichiers ou un audit de concurrence.
higha donné une réponse confiante mais erronée sur votre jeu d'évaluation, et pas seulement plus lente.- La latence importe peu, comme pour les tâches en arrière-plan, les revues nocturnes ou l'analyse par lots.
- Une mauvaise réponse coûte plus cher que des tokens, comme pour les correctifs de sécurité ou les calculs financiers.
Restez sur high (ou descendez plus bas) lorsque :
- Le prompt est de l'extraction ou du formatage. Google avertit que
xhigh« peut provoquer une sur-réflexion ou épuisermax_output_tokenssur des prompts plus simples comme l'extraction de texte ou de JSON ». - Un utilisateur attend. Le chat, l'autocomplétion et les appels d'outils en direct conviennent à
mediumoulow. - Vous fonctionnez à volume élevé. Chaque token de réflexion supplémentaire est facturé, et la différence se multiplie à chaque requête.
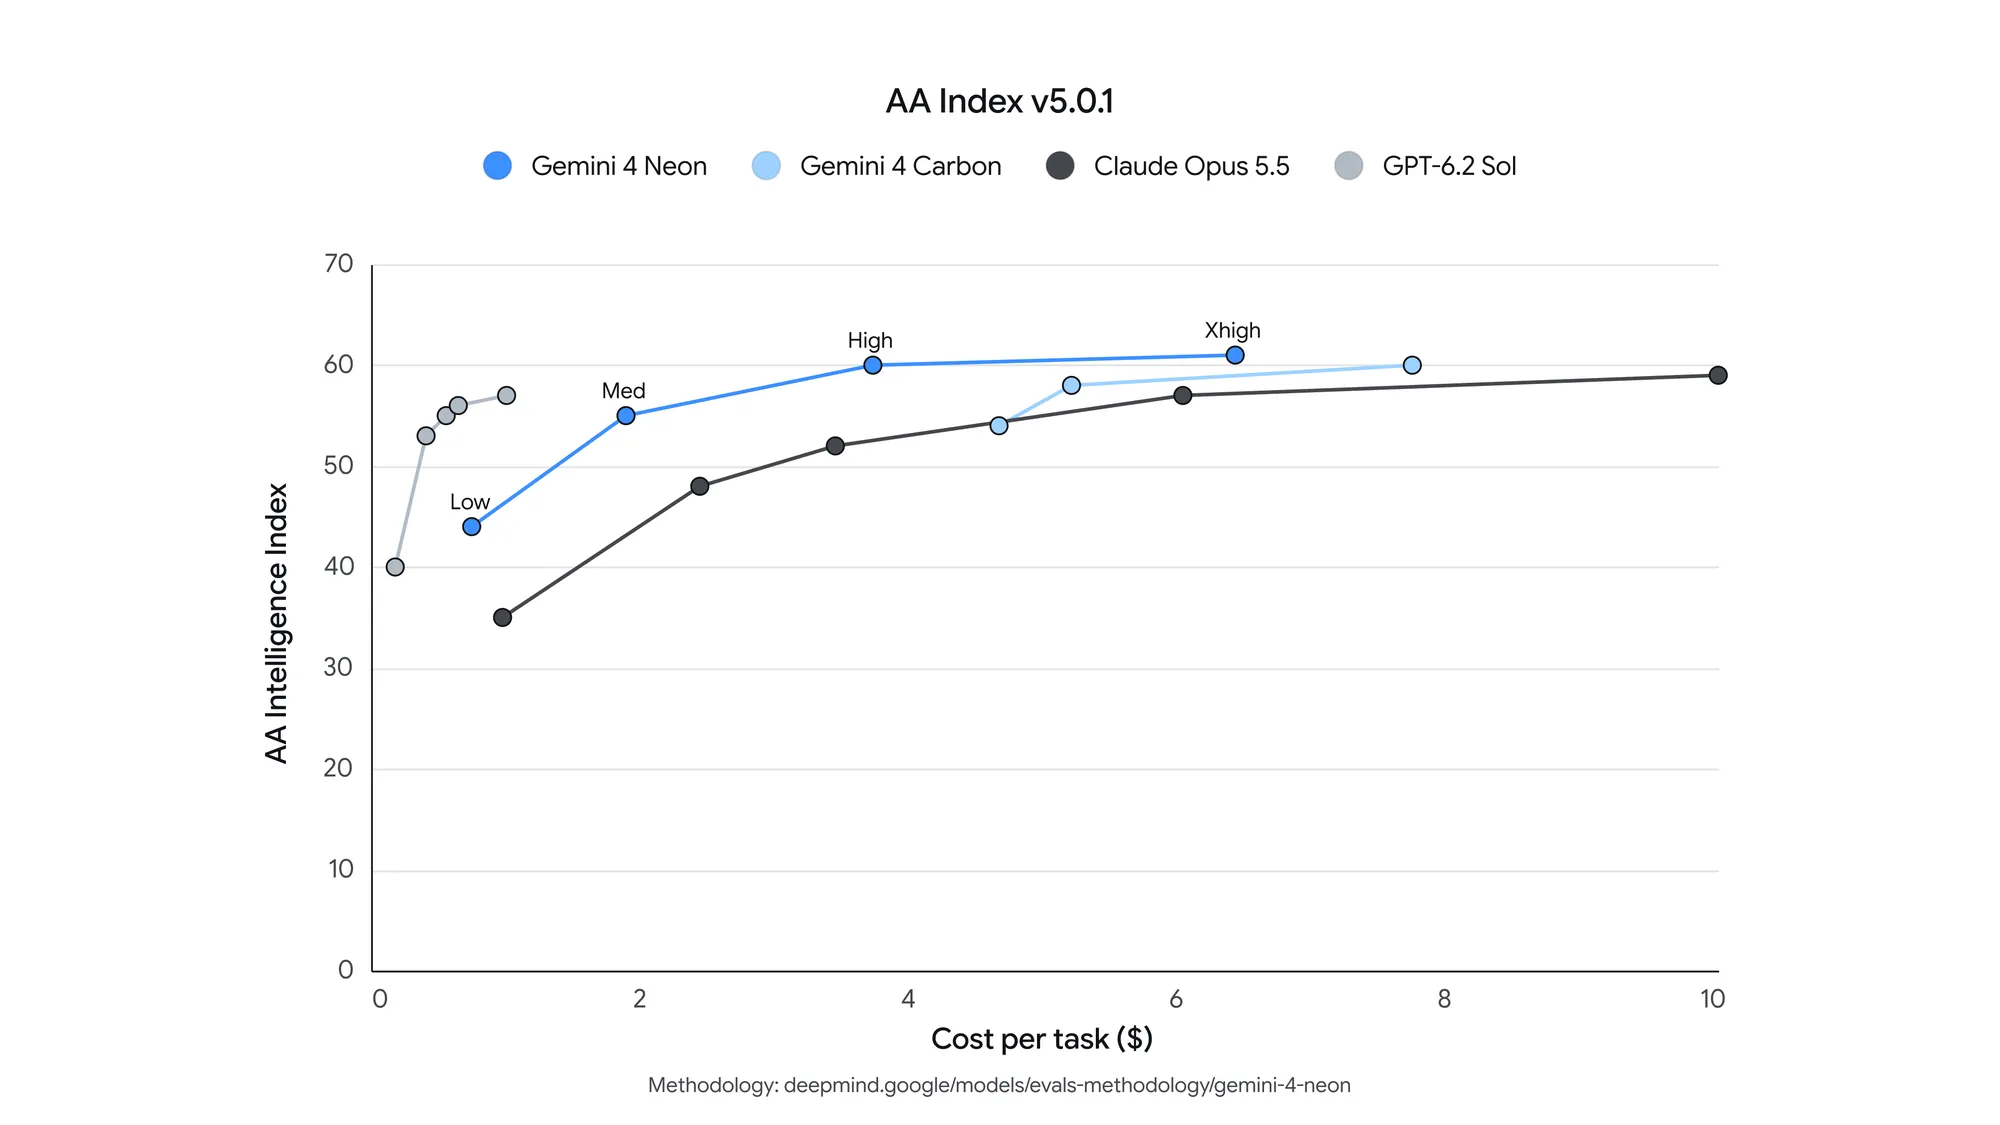
Les chiffres de benchmark de Google confirment cette séparation. Dans son annonce de lancement, Neon en xhigh obtient 61 à l'Artificial Analysis Intelligence Index, au troisième rang. Au niveau par défaut high, Google rapporte un coût par tâche inférieur de 32 % à celui de Carbon. Ce sont les chiffres de Google, pas nos tests, mais ils illustrent le compromis : xhigh offre le meilleur score de Neon, high offre l'efficacité.
Combien coûte chaque niveau de réflexion ?
Chaque niveau a le même prix par token ; ce qui change, c'est le nombre de tokens que vous payez. Neon coûte 3,00 $ par 1 M de tokens d'entrée et 15,00 $ par 1 M de tokens de sortie, et la page de tarification de Google précise que le tarif de sortie inclut les tokens de réflexion. L'entrée mise en cache tombe à 0,15 $ par 1 M via la mise en cache implicite (la mise en cache explicite n'est pas prise en charge sur Neon). Il n'existe pas de palier gratuit pour ce modèle.
Ainsi, le coût d'un niveau correspond aux tokens de réflexion qu'il ajoute, multipliés par 15 $ par million. Voici le calcul pour une requête de 2 000 tokens d'entrée et une réponse visible de 800 tokens. Les nombres de tokens de réflexion sont hypothétiques, choisis pour illustrer le calcul, et non mesurés :
| Tokens de réflexion (hypothétiques) | Coût d'entrée | Coût de sortie + réflexion | Total par requête | Pour 10 000 requêtes |
|---|---|---|---|---|
| 500 | 0,006 $ | 0,0195 $ | 0,0255 $ | 255 $ |
| 2 000 | 0,006 $ | 0,042 $ | 0,048 $ | 480 $ |
| 8 000 | 0,006 $ | 0,132 $ | 0,138 $ | 1 380 $ |
La réflexion domine vite la facture. À 8 000 tokens de réflexion, le raisonnement représente 87 % du coût de la requête. C'est pourquoi Google recommande lui-même de tester votre évaluation aux quatre niveaux et de « choisir le thinking_level le plus bas qui satisfait votre niveau de qualité requis ». Notre guide des niveaux de réflexion de Gemini 3.8 Flash couvre le même compromis sur un modèle moins cher si vous souhaitez comparer.
Comment mesurer les tokens et la latence par niveau ?
Exécutez le même prompt à chaque niveau et lisez le bloc d'utilisation. Dans l'Interactions API, l'objet usage de la réponse indique séparément total_input_tokens, total_output_tokens et total_thought_tokens. Dans generateContent, les tokens de réflexion apparaissent sous usageMetadata.thoughtsTokenCount.
Cette boucle envoie un prompt aux quatre niveaux et affiche les tokens de réflexion ainsi que le temps réel écoulé :
for level in low medium high xhigh; do
  start=$(date +%s)
  usage=$(curl -s "https://generativelanguage.googleapis.com/v1beta/interactions" \
    -H "x-goog-api-key: $GEMINI_API_KEY" \
    -H 'Content-Type: application/json' \
    -d "{\"model\":\"gemini-4-neon\",
         \"input\":\"Find the race condition in this retry loop: ...\",
         \"generation_config\":{\"thinking_level\":\"$level\",\"max_output_tokens\":65536}}" \
    | jq -c '{status, thought: .usage.total_thought_tokens, out: .usage.total_output_tokens}')
  echo "$level $(( $(date +%s) - start ))s $usage"
done
Exécutez-la sur 10 à 20 prompts issus de votre charge de travail réelle. Un seul prompt vous apprendra peu ; un ensemble montre où high et xhigh commencent à diverger en termes de qualité.
Réglez un timeout élevé sur votre client HTTP pendant vos tests. Les notes de migration de Google indiquent que les prompts difficiles peuvent prendre plusieurs minutes et suggèrent un timeout d'au moins 15 minutes, ou une exécution en arrière-plan.
Pourquoi xhigh renvoie-t-il parfois une réponse vide ?
max_output_tokens plafonne ensemble la réflexion et la sortie visible. Si Neon dépense tout le budget en raisonnement, l'interaction s'arrête avec le statut incomplete et renvoie une réponse tronquée ou vide, et vous payez quand même les tokens de réflexion générés.
Trois règles issues de la documentation de Google permettent d'éviter cela :
- Supprimez les anciens plafonds trop bas. Si votre application code en dur quelque chose comme 8 192, portez-le à 65 536, la limite synchrone par défaut.
- Baissez le niveau, pas le plafond. Pour réduire le coût ou la latence, passez à
mediumoulowplutôt que de réduiremax_output_tokens. - Passez en arrière-plan pour les travaux longs. Pour des réponses dépassant 65 536 tokens, mettez
backgroundàtrueetmax_output_tokensjusqu'à 1 048 576 moins votre entrée. L'entrée, la réflexion et la sortie partagent une seule fenêtre de 1 M de tokens. Notre guide des sorties longues de Gemini 4 Argon détaille le modèle de polling.
Laissez votre agent de codage benchmarker les quatre niveaux avec Apidog CLI
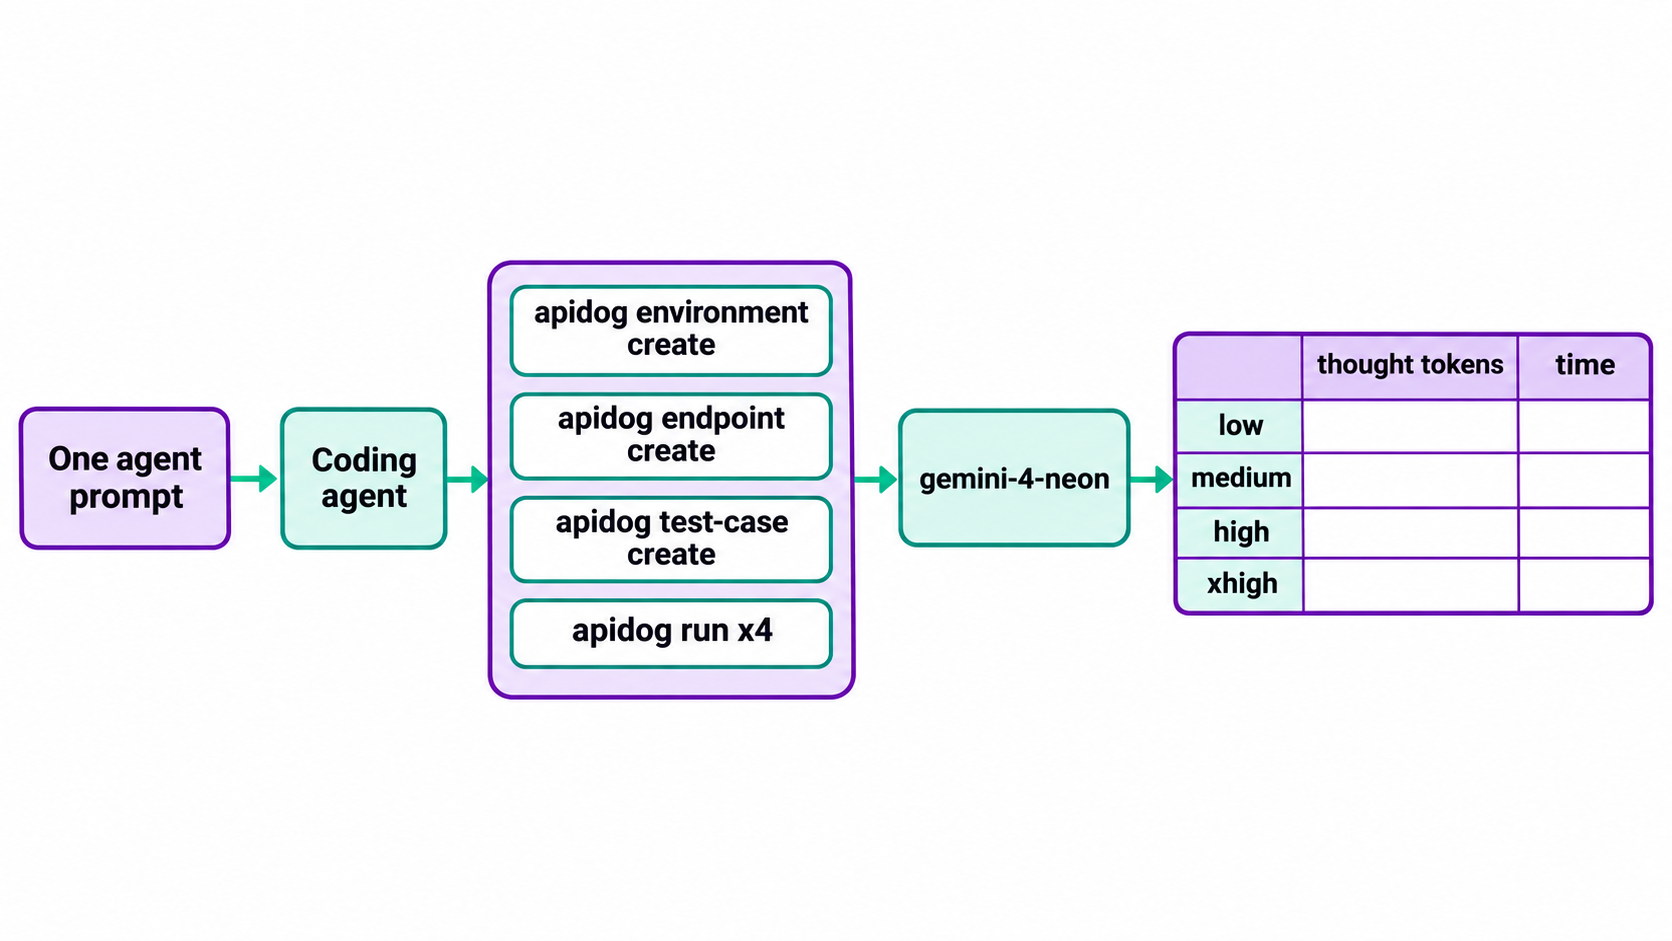
Relancer cette boucle à la main devient vite lassant. À la place, laissez votre agent de codage (Claude Code, Codex, Cursor) construire un test réutilisable avec Apidog CLI et le relancer à chaque niveau dès que vous voulez des chiffres frais.
Configurez-le une fois :
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Donnez ensuite un prompt à votre agent :
In Apidog project <projectId>, create an environment "gemini" with base URL
https://generativelanguage.googleapis.com and variables GEMINI_API_KEY and
THINKING. Add an endpoint for POST /v1beta/interactions that sends the
x-goog-api-key header from GEMINI_API_KEY. Create a test case that sends model
"gemini-4-neon", my audit prompt, generation_config.thinking_level {{THINKING}}
and max_output_tokens 65536, and asserts: HTTP 200, status is "completed",
and usage.total_thought_tokens exists. Run it once per level (low, medium,
high, xhigh) and give me a table of thought tokens and response time.
L'agent lit chaque schéma de payload, valide son JSON, écrit les ressources et boucle l'exécution :
apidog environment create gemini --project <projectId> --base-url https://generativelanguage.googleapis.com
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
for level in low medium high xhigh; do
  apidog run --test-case <caseId> --project <projectId> -e <envId> \
    --env-var "THINKING=$level" -r cli,json --out-file "neon-$level"
done
L'assertion status is "completed" intercepte le piège incomplete de la section précédente, de sorte qu'un niveau qui épuise son budget échoue bruyamment au lieu de renvoyer une chaîne vide. Remplacez -r cli,json par -r junit et la même exécution s'intègre à votre CI ; le guide CI/CD d'Apidog CLI montre le pipeline, et Apidog CLI dans Claude Code couvre la configuration de l'agent. Le forfait gratuit d'Apidog couvre jusqu'à 4 utilisateurs.
FAQ
Quel est le niveau de réflexion par défaut de Gemini 4 Neon ? high. Vous n'avez pas besoin d'envoyer thinking_level pour l'obtenir. Carbon et Argon sont réglés sur medium par défaut, donc définissez le niveau explicitement lorsque vous migrez depuis ceux-ci.
Gemini 4 Neon prend-il en charge la réflexion minimale ? Non. Neon prend en charge low, medium, high et xhigh, et rejette minimal avec une erreur. Utilisez low pour les réponses les plus rapides et les moins chères.
Les tokens de réflexion sont-ils facturés sur Gemini 4 Neon ? Oui. Les tokens de réflexion sont facturés au tarif de sortie de 15,00 $ par 1 M. Google compte chaque token traité par le modèle, y compris les tokens de réflexion.
Puis-je encore utiliser thinkingBudget avec Gemini 4 Neon ? C'est déprécié sur les modèles Gemini 4. Envoyé seul, il est rattaché au thinkingLevel le plus proche et renvoie un avertissement. Envoyé en même temps que thinkingLevel, la requête échoue avec un 400.
xhigh est-il toujours plus précis que high ? Pas toujours. Google indique que xhigh peut sur-réfléchir sur des prompts simples comme l'extraction de texte ou de JSON et peut épuiser max_output_tokens. Testez les deux sur vos propres prompts et conservez le niveau le plus bas qui passe.
Puis-je utiliser les niveaux de réflexion de Gemini 4 Neon gratuitement ? Non. Gemini 4 Neon n'est pas disponible sur le palier gratuit de l'API Gemini. Dans Google AI Studio et Google Antigravity, il est lié aux forfaits payants Google AI Pro et Ultra.