
Les benchmarks de Gemini 4 Neon le placent n°1 de l’Artificial Analysis Coding Agent Index (58,6), à 65,2 % sur Terminal-Bench 4.1 et n°2 du Vals Index (70,9 %). Google affirme également qu’il coûte 32 % de moins par tâche que Gemini 4 Carbon à son niveau de réflexion high par défaut. La plupart des lignes ont toutefois été exécutées à xhigh, et certaines sur le propre harnais de Google.
Ce dernier détail est justement le sujet de cet article. Notre présentation de Gemini 4 Neon couvre les spécifications et le prix. Ici, vous trouverez chaque score publié, qui l’a mesuré, à quel niveau de réflexion, et comment transformer le « coût par tâche » en un chiffre que vous pouvez comparer à votre propre facture.
Les benchmarks de Gemini 4 Neon en un coup d’œil
Gemini 4 Neon est le modèle intermédiaire de la gamme Gemini 4 de Google, publié le 18 novembre 2026, facturé 3 $ par million de jetons d’entrée et 15 $ par million de jetons de sortie. Ses meilleurs résultats publiés concernent le codage agentique et le travail intellectuel, où il se classe n°1 ou n°2 sur quatre classements indépendants.
Voici les principaux résultats de l’article de lancement de Google :
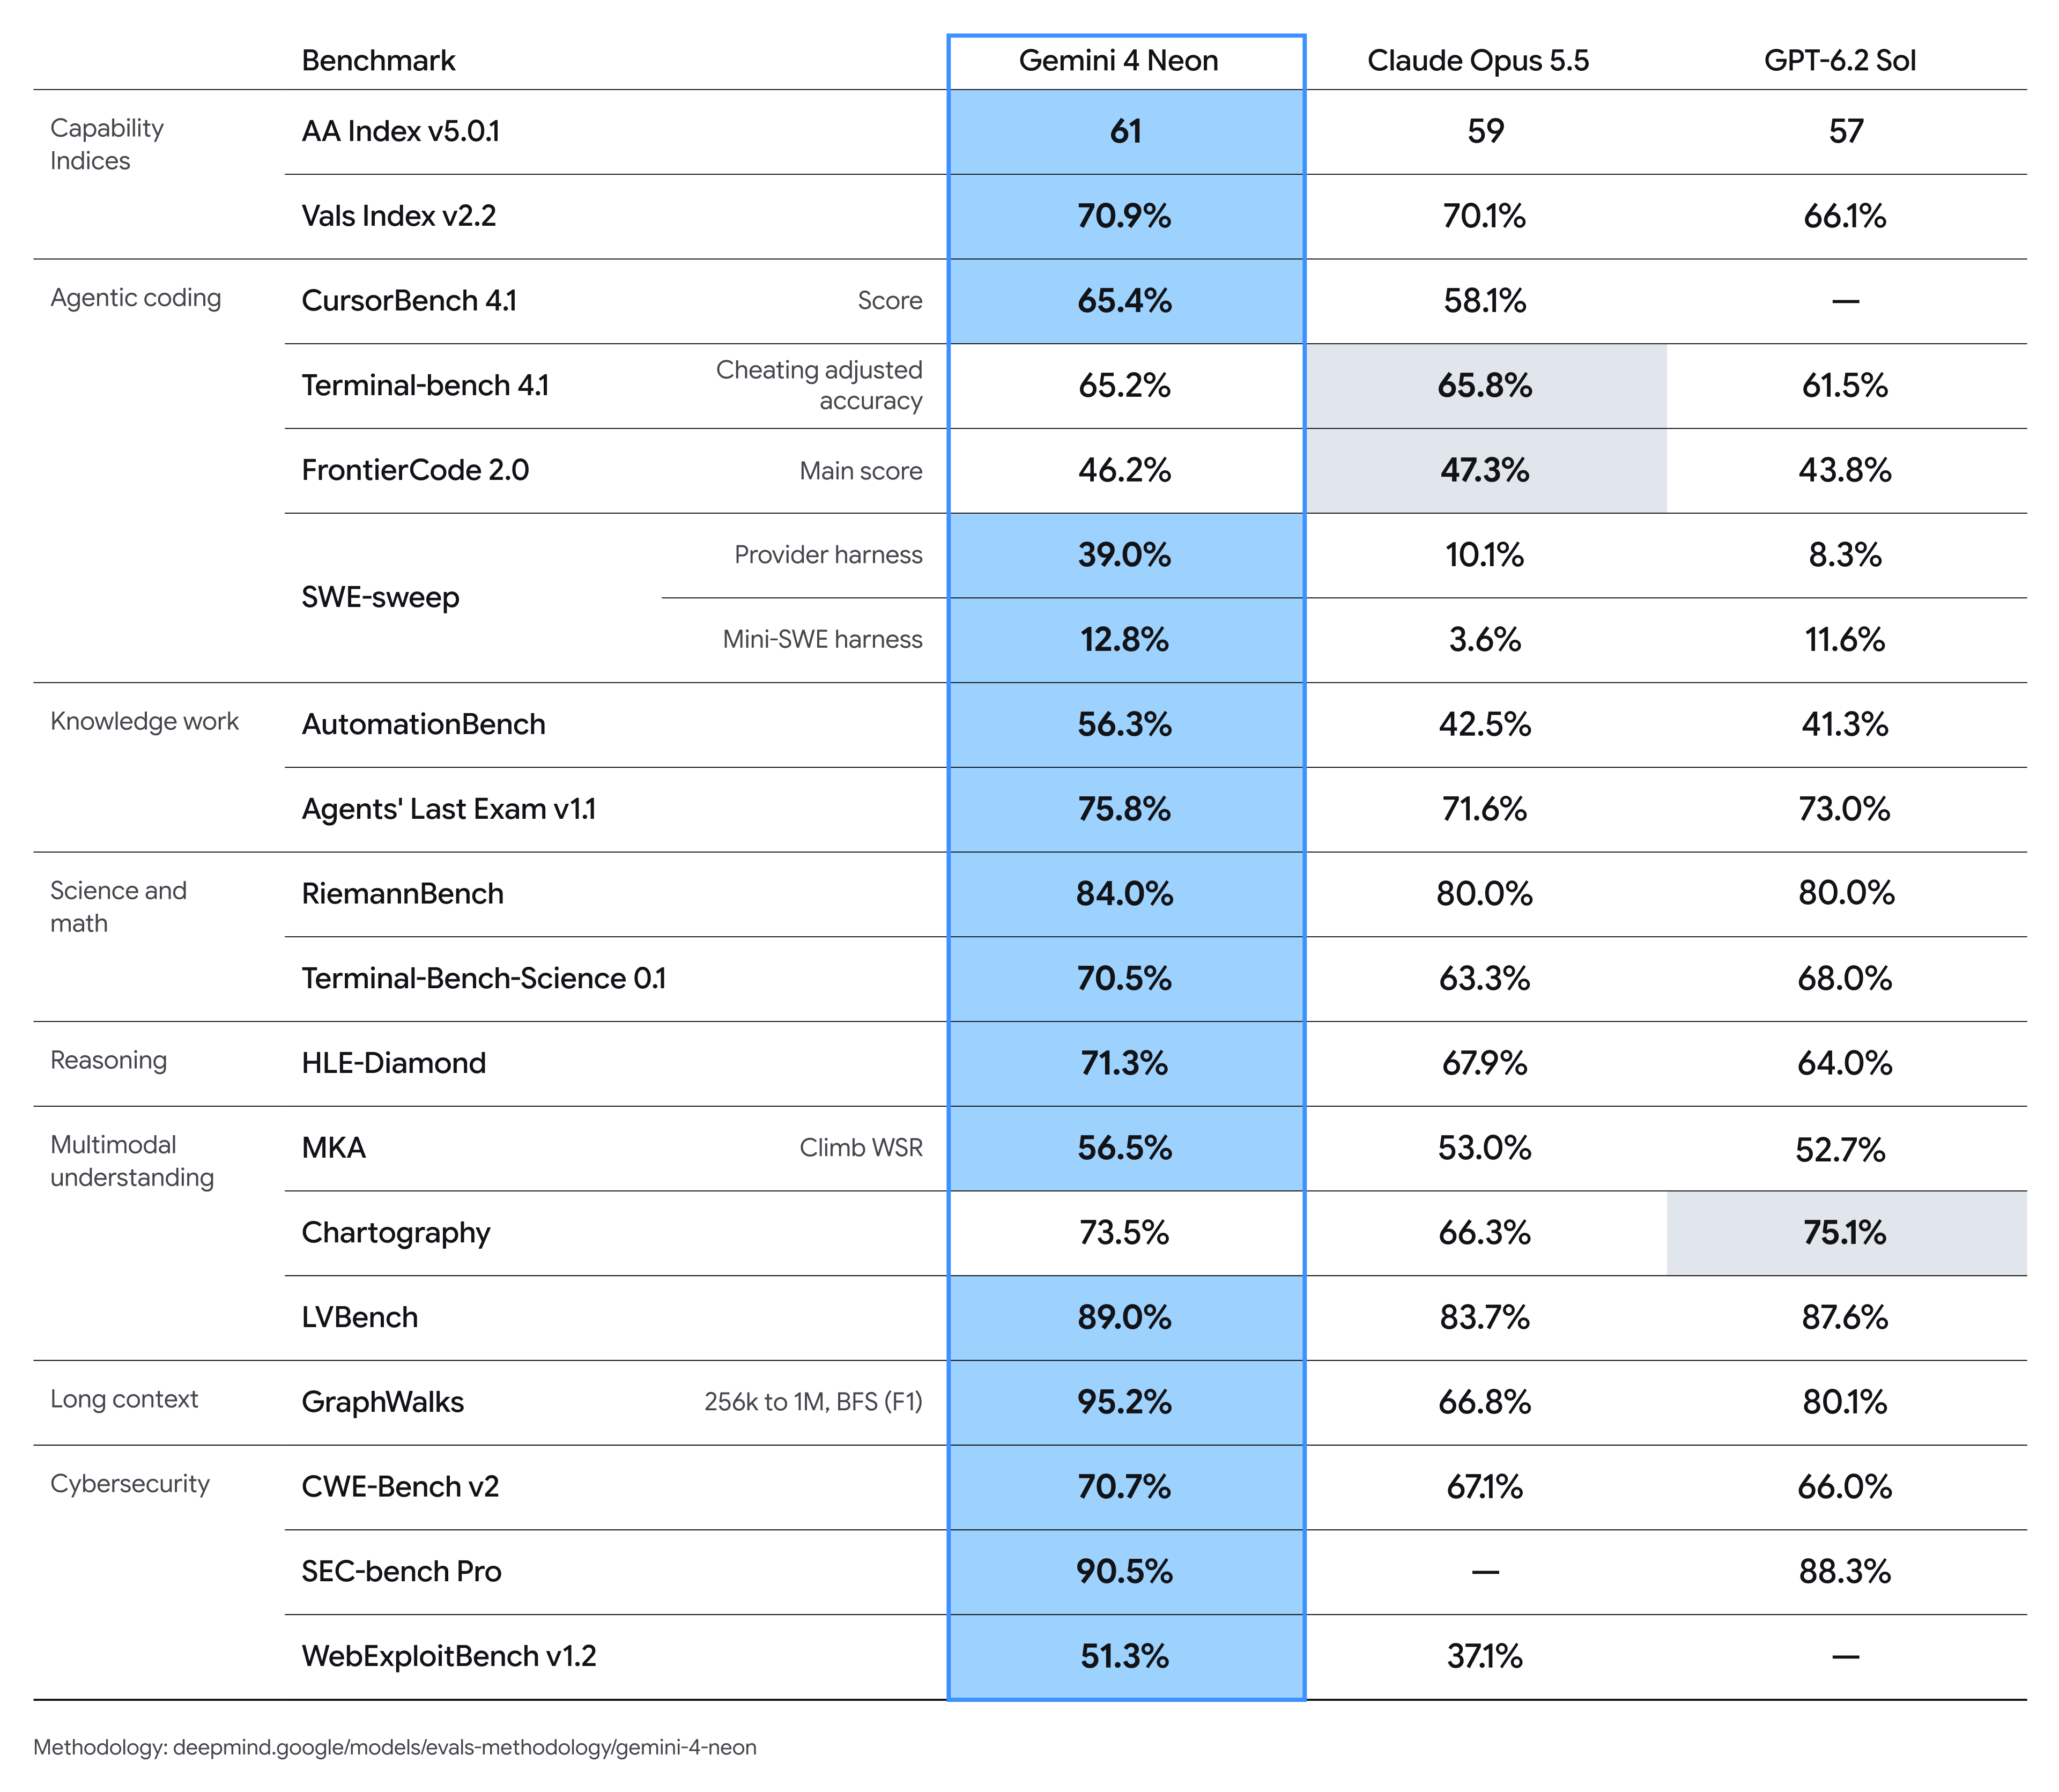
Google annonce également la première place sur le Legal Research Bench et le Tax Agent Bench de Vals AI.
Benchmarks de codage de Gemini 4 Neon
Le codage est le domaine où l’argumentaire de Neon est le plus solide, et aussi celui où le harnais de test compte le plus. Le PDF de méthodologie d’évaluation de Google explique comment chaque ligne de codage a été produite.
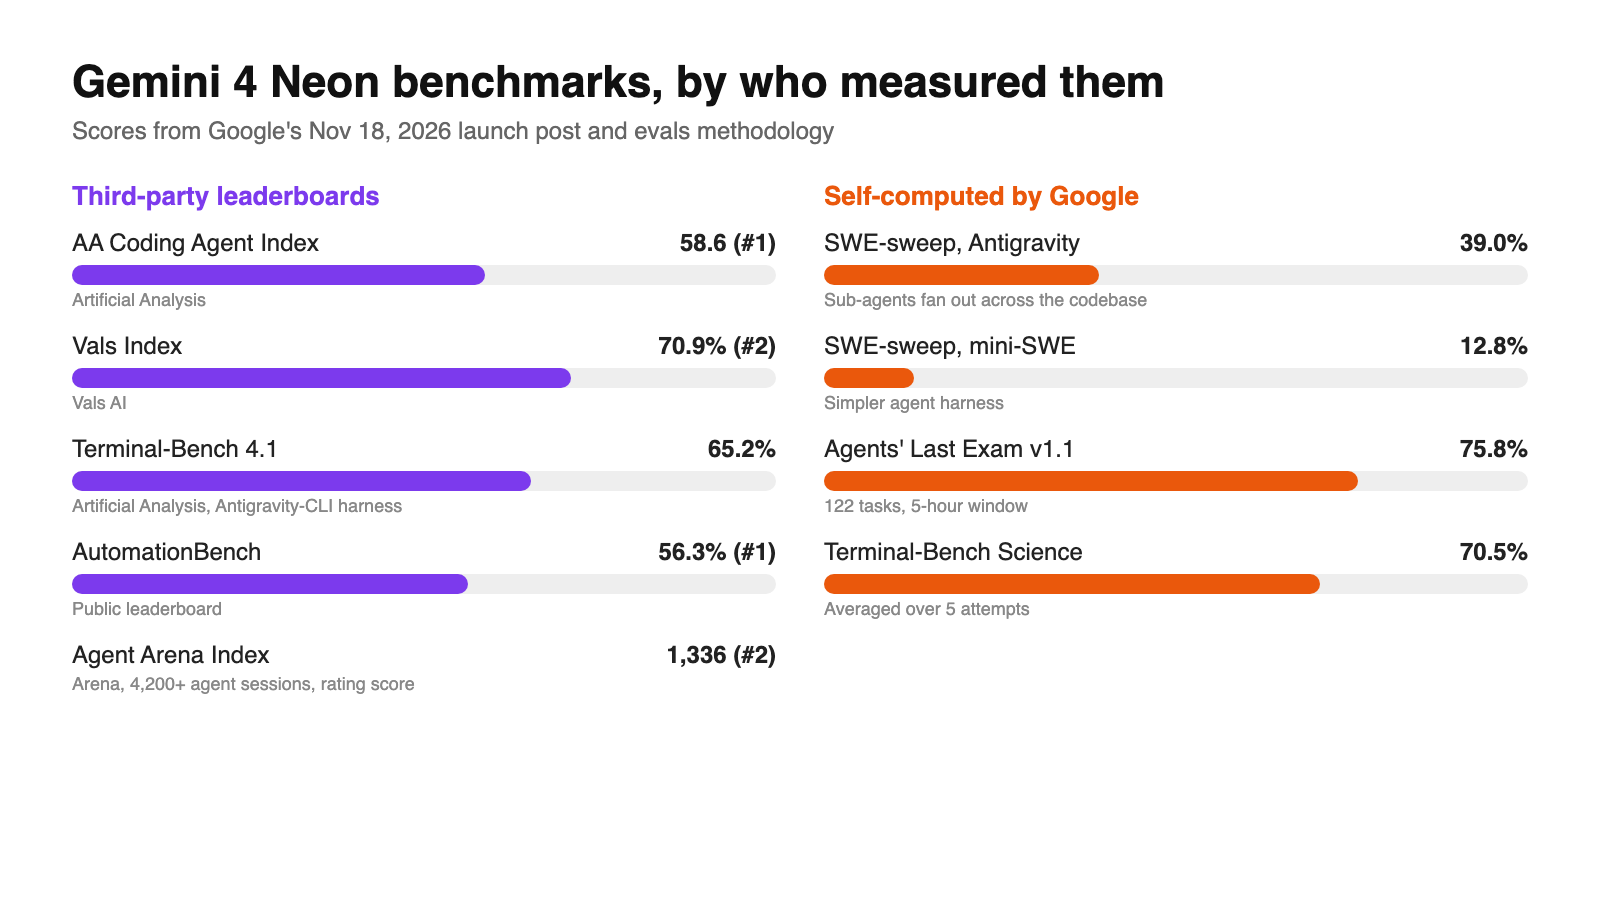
Artificial Analysis Coding Agent Index : 58,6, n°1. Il s’agit d’un indice composite indépendant, donc la ligne la moins influencée par la configuration de Google. Vous pouvez consulter le classement actuel sur Artificial Analysis.
Terminal-Bench 4.1 : 65,2 %. Artificial Analysis a évalué Neon avec le harnais public Antigravity-CLI, version 1.5.9. Les scores des autres modèles proviennent du classement officiel, et chaque résultat utilise une exactitude ajustée pour la triche. C’est équitable, mais Neon a tourné dans l’outillage agentique maison de Google.
FrontierCode 2.0 : 46,2 %. Ce résultat provient du classement public et a été exécuté à high, le paramètre par défaut en production. Si vous ne devez faire confiance qu’à un seul chiffre de codage pour le trafic quotidien, retenez celui-ci.
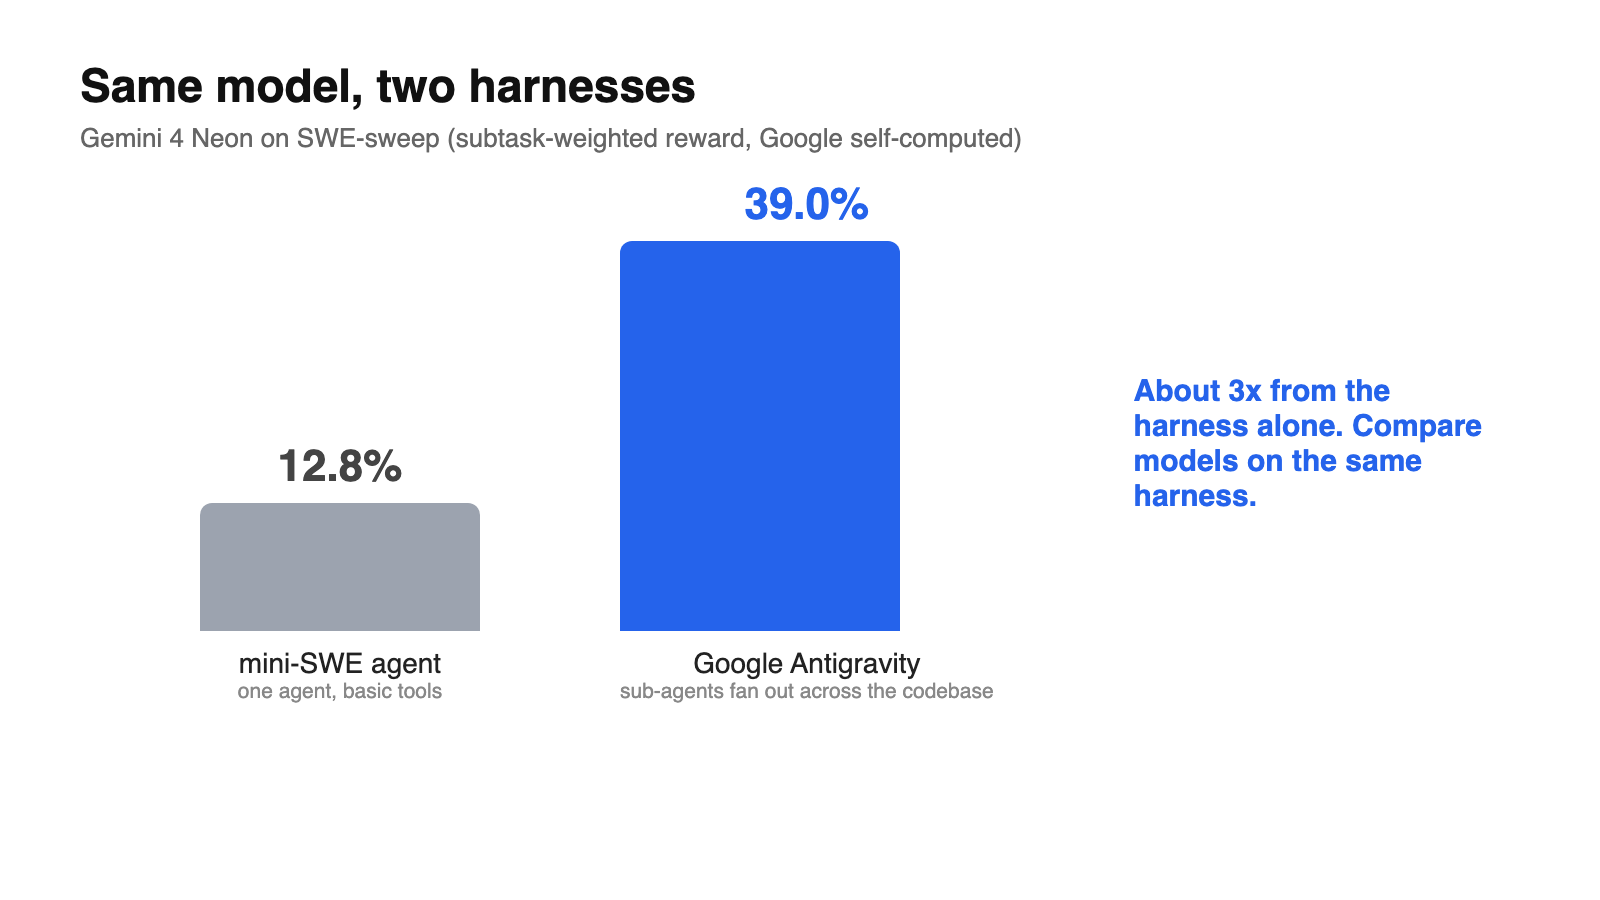
SWE-sweep : 39,0 % dans Antigravity, 12,8 % sur mini-SWE. Les deux sont calculés en interne par Google. Le facteur 3 vient du harnais : Google note qu’Antigravity-CLI inclut un outil par défaut qui répartit des sous-agents sur l’ensemble de la base de code, ce qui convient aux tâches de recherche de bugs. Opus 5.5 a tourné dans Claude Code et GPT-6.2 Sol dans Codex pour cette même comparaison. Lisez 12,8 % comme le modèle seul et 39,0 % comme le modèle avec son meilleur outillage.
Benchmarks pour agents et travail intellectuel
Ces résultats comptent si vous prévoyez d’exécuter Neon sans surveillance sur de nombreuses étapes.
- Agent Arena Index : 1 336, n°2. Construit à partir de plus de 4 200 sessions d’agents réelles. Google indique aussi que Neon y occupe la 2e place en pilotabilité, c’est-à-dire qu’il s’adapte proprement lorsqu’un utilisateur le corrige en cours de tâche.
- AutomationBench : 56,3 %, n°1. Le benchmark de Zapier pour l’automatisation métier, issu du classement public.
- Vending-Bench 2 : 16 843 $, n°1. La simulation à long horizon d’Andon Labs consistant à gérer une entreprise. Le score correspond à l’argent gagné, pas à un pourcentage.
- Agents’ Last Exam v1.1 : 75,8 %. Calculé en interne sur l’ensemble de 122 tâches dans Antigravity-CLI 1.4.8, avec une fenêtre de 5 heures par exécution. Le score d’Opus 5.5 provient du classement public et celui de GPT-6.2 Sol de sa fiche système ; les protocoles diffèrent donc.
- Chartography : 73,5 %. Lecture de graphiques professionnels denses, calculé en interne sans outils.
Pour les sciences et les mathématiques, Neon affiche 70,5 % sur Terminal-Bench Science (calculé en interne, moyenne sur 5 tentatives), 84,0 % sur RiemannBench et 71,3 % sur HLE-Diamond (d’après le classement Artificial Analysis).
Comment Google a obtenu ces chiffres
Quatre règles de la méthodologie changent la manière de lire le tableau :
- Niveau de réflexion le plus élevé par défaut. « Tous les résultats sont exécutés avec l’API Gemini avec les paramètres de réflexion les plus élevés, sauf indication contraire. » C’est-à-dire
xhigh. Seul FrontierCode 2.0 est explicitement marquéhigh. Les appels de production utilisenthighpar défaut ; attendez-vous donc à moins de jetons de réflexion et éventuellement à des scores inférieurs à ceux du tableau. - Pass@1, une seule tentative. Pas de vote majoritaire ni de calcul parallèle à l’inférence, sauf mention contraire (Terminal-Bench Science fait la moyenne sur 5 tentatives).
- Les chiffres des concurrents sont déclarés par leurs éditeurs. Les scores non-Gemini proviennent de chaque fournisseur, sauf mention contraire. Opus 5.5 et GPT-6.2 Sol utilisent leur paramètre de raisonnement maximal lorsqu’il est disponible.
- Filtres de sécurité activés, sauf pour la cybersécurité. Les lignes de cybersécurité ont été exécutées avec les filtres désactivés.
Notre guide des niveaux de réflexion explique quand xhigh justifie ses jetons supplémentaires.
Coût par tâche : que signifie l’affirmation des 32 %
Le coût par tâche est la dépense totale nécessaire pour terminer une tâche de benchmark, et non le prix par jeton. Un modèle dont le prix par jeton est plus élevé peut malgré tout coûter moins cher par tâche s’il atteint la réponse en moins d’étapes et avec moins de jetons de réflexion.
Google avance trois affirmations sur les coûts :
| Affirmation | Niveau de réflexion | Comparé à |
|---|---|---|
| Coût par tâche inférieur de 32 %, avec un score élevé à l’AA Intelligence Index | high |
Gemini 4 Carbon |
| Coût par tâche inférieur d’environ 50 % à 80 % sur le Vals Index et l’Agent Arena | high |
Principaux modèles frontières concurrents |
| Coût par tâche inférieur de 36 % ou plus | xhigh |
Modèles concurrents à leur paramètre le plus élevé |
Remarquez le décalage : les lignes de précision utilisent surtout xhigh, tandis que l’économie phare de 32 % est à high. Les deux sont vrais, mais pas en même temps. Vous obtenez soit l’économie, soit le meilleur score, et c’est à vous de mesurer l’écart entre les deux.
Voici comment estimer votre propre coût par tâche. Les jetons de réflexion sont facturés comme des jetons de sortie.
$$\text{cost} = \frac{\text{input} \times 3 + \text{cached input} \times 0.15 + \text{output} \times 15}{1{,}000{,}000}$$
Une tâche de codage avec 20 000 jetons d’entrée et 4 000 jetons de sortie coûte 0,06 $ + 0,06 $ = 0,12 $. Si 15 000 de ces jetons d’entrée touchent le cache, le coût tombe à 0,015 $ + 0,00225 $ + 0,06 $ = environ 0,077 $. Exécutez la même tâche à xhigh : c’est le nombre de jetons de sortie qui varie ; journalisez donc les jetons par niveau, pas seulement le succès ou l’échec. Notre décomposition tarifaire de Gemini 4 Neon couvre les tarifs Batch, Flex et Priority.
Lignes cybersécurité et sûreté
Les scores cyber proviennent de « Gemini 4 Neon for cyber », qui est réservé aux défenseurs de confiance via le programme Fairwind plutôt qu’à l’API publique.
| Benchmark | Score | Remarque |
|---|---|---|
| SEC-bench Pro | 90,5 % | État de l’art, environ moitié moins cher par défi |
| WebExploitBench v1.2 | 51,26 % | État de l’art, moitié du coût des grands modèles |
| AutoBaxBench (hard tier) | 76 % | État de l’art, code plus sûr que Carbon sur tous les niveaux |
| CWE-bench v2 | 70,7 % | Amélioration de 3,4 % par rapport à Carbon |
| ExploitGym | Non communiqué | Niveau frontière avec la moitié des jetons de Carbon |
Chiffres de sûreté du même article : Neon a refusé 1,98 % des tâches de Terminal-Bench 4.0, obtenu un score de 0,0 % de triche sur Terminal-Bench 4.0, pris des raccourcis dans 2,45 % de l’évaluation de triche en codage de Google et réussi 99,2 % de son évaluation d’honnêteté des agents. Avec les garde-fous en temps réel à son niveau de réflexion le plus élevé, il a résisté à toutes les attaques du benchmark d’injection de prompt indirect de Gray Swan.
Là où Neon n’est pas en tête
Neon n’arrive pas en tête partout, et Google le reconnaît :
- Artificial Analysis Intelligence Index : 3e au classement général, « juste derrière des modèles plus grands et plus lents ».
- Vals Index : 2e, pas 1er.
- Agent Arena Index : 2e.
Google continue par ailleurs de recommander Carbon pour ses projets à long horizon les plus difficiles. Si vous hésitez entre les trois modèles Gemini 4, notre comparaison Neon vs Carbon vs Hydrogen détaille les compromis, et l’article sur les benchmarks de Gemini 4 Argon montre comment lire le tableau du modèle précédent.
Testez vous-même Gemini 4 Neon avec Apidog CLI
Les classements décrivent le harnais de Google, pas votre produit. Le moyen le plus rapide de savoir si Neon justifie son prix est de laisser votre agent de codage exécuter les mêmes prompts à high et à xhigh, et de journaliser les jetons et la latence pour chacun.
Il n’existe pas de niveau d’API gratuit pour Neon ; vous avez donc besoin d’une clé API Gemini payante. Cette requête suit le format documenté de l’API Interactions de Google ; nous ne l’avons pas exécutée en direct pour cet article :
curl -s "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "gemini-4-neon", "input": "Find the race condition in this retry queue.", "generation_config": {"thinking_level": "high"}}'
Apidog CLI permet à Claude Code, Codex, Cursor ou OpenCode de créer et d’exécuter des tests d’API depuis le terminal. Configurez-le une fois :
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Ensuite, donnez un seul prompt à votre agent :
In Apidog project <id>, create a Gemini API environment with GEMINI_API_KEY
and THINKING variables. Add a test case for POST /v1beta/interactions on
gemini-4-neon that sends my 10 eval prompts from prompts.csv, asserts HTTP 200
and a non-empty output, and records token usage and response time. Run it at
THINKING=high and THINKING=xhigh and compare cost per task at $3/$15 per 1M.
L’agent crée l’environnement, vérifie la charge utile du cas de test par rapport à son schéma, puis l’exécute une fois par niveau de réflexion :
apidog environment create gemini-api --project <id> --base-url https://generativelanguage.googleapis.com
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -d prompts.csv --env-var "THINKING=high" -r cli,json
apidog run --test-case <caseId> --project <id> -e <envId> -d prompts.csv --env-var "THINKING=xhigh" -r cli,json
Ajoutez --timeout-request 900000 si vos prompts sont longs, car les exécutions difficiles à xhigh peuvent prendre plusieurs minutes. Pour relancer la comparaison à chaque modification de prompt, placez la même commande apidog run ... -r junit dans la CI avec le guide CI/CD d’Apidog CLI, ou partez de Apidog CLI dans Claude Code. Le forfait gratuit d’Apidog couvre jusqu’à 4 utilisateurs.
FAQ
Quel est le meilleur résultat de Gemini 4 Neon aux benchmarks ? La 1re place à l’Artificial Analysis Coding Agent Index avec 58,6, ainsi que la 1re place sur AutomationBench (56,3 %) et Vending-Bench 2 (16 843 $).
À quel niveau de réflexion les benchmarks ont-ils été exécutés ? Surtout à xhigh, le paramètre le plus élevé. La méthodologie de Google indique que les résultats utilisent les paramètres de réflexion les plus élevés, sauf mention contraire ; FrontierCode 2.0 (46,2 %) est indiqué comme utilisant high par défaut.
Gemini 4 Neon est-il moins cher que Carbon par tâche ? Google annonce un coût par tâche inférieur de 32 % à high. Il s’agit d’un chiffre par tâche issu d’exécutions de benchmark ; vérifiez-le sur vos propres prompts avant de transférer du trafic.
Pourquoi Neon obtient-il 39,0 % et 12,8 % sur SWE-sweep ? À cause de harnais différents. 39,0 % correspond à Google Antigravity, qui répartit des sous-agents sur l’ensemble de la base de code ; 12,8 % correspond à l’agent plus simple mini-SWE.
Les benchmarks de Gemini 4 Neon sont-ils indépendants ? En partie. Les lignes Artificial Analysis, Vals, Arena, AutomationBench et FrontierCode proviennent de tiers. SWE-sweep, Agents’ Last Exam et Terminal-Bench Science sont calculés en interne par Google.