
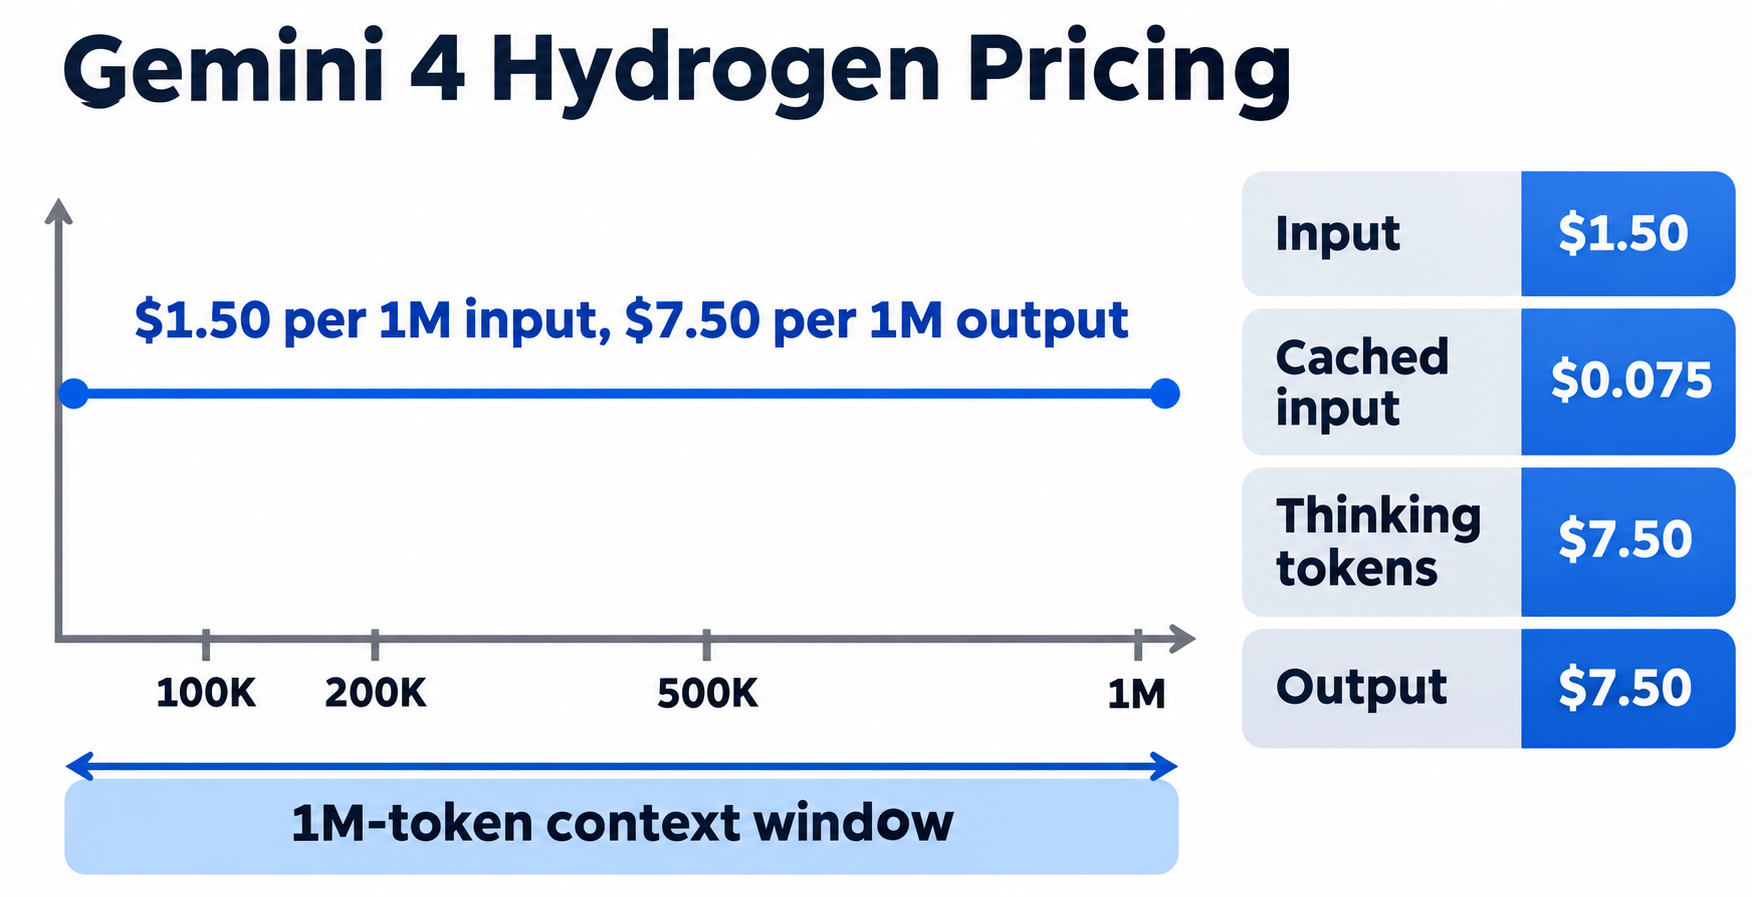
Gemini 4 Hydrogen coûte 1,50 $ par million de tokens en entrée et 7,50 $ par million de tokens en sortie sur le palier payant Standard de l’API Gemini, un tarif uniforme sur toute la fenêtre de contexte d’1M de tokens. Les tokens de réflexion sont facturés au tarif de sortie, l’entrée en cache coûte 0,075 $ par million, et Batch ou Flex réduit tous les tarifs de moitié.
Hydrogen, publié le 12 novembre 2026, est le membre rapide de la famille Gemini 4. Contrairement à Carbon et Argon, il n’a pas de tarif de lancement qui double ensuite, et il est disponible sur le palier gratuit. Vous trouverez ci-dessous le tableau des prix, des exemples de coûts détaillés, l’influence des niveaux de réflexion sur votre facture et comment mesurer vos propres coûts. Vous découvrez le modèle ? Commencez par qu’est-ce que Gemini 4 Hydrogen.
Combien coûte Gemini 4 Hydrogen par million de tokens ?
Gemini 4 Hydrogen (identifiant de modèle gemini-4-hydrogen
| Palier | Entrée | Sortie (réflexion incluse) | Entrée en cache | Palier gratuit |
|---|---|---|---|---|
| Standard | 1,50 $ | 7,50 $ | 0,075 $ | Gratuit |
| Batch | 0,75 $ | 3,75 $ | 0,0375 $ | Non disponible |
| Flex | 0,75 $ | 3,75 $ | 0,0375 $ | Non disponible |
| Priority | 2,70 $ | 13,50 $ | 0,135 $ | Voir la page tarifaire |
Trois détails de la même page influencent votre budget :
La réflexion est facturée. « Chaque token traité par le modèle est comptabilisé et facturé, y compris les tokens de réflexion. »Mise en cache implicite uniquement. La mise en cache explicite n’est pas prise en charge ; vous bénéficiez du tarif en cache lorsque le cache implicite de Google correspond à un préfixe d’invite déjà rencontré.Le grounding est en supplément. Le grounding via Google Search inclut 5 000 requêtes gratuites par mois, puis 14 $ par 1 000.
L’utilisation du palier gratuit est marquée « Used to improve our products: Yes » sur la page. Notre guide sur Gemini 4 Hydrogen gratuit passe en revue toutes les options à 0 $.
Que signifie « un tarif uniforme jusqu’à 1M de tokens » ?
Cela signifie un seul prix, quelle que soit la taille de l’invite. Le billet de lancement de Google indique qu’Hydrogen « est facturé au tarif uniforme sur toute sa fenêtre de contexte d’un million de tokens, à 1,50 $ par million de tokens en entrée et 7,50 $ par million de tokens en sortie ». Une invite de 5K tokens et une invite de 900K tokens sont facturées au même tarif par token.
Tous les modèles Gemini ne fonctionnent pas ainsi : Gemini 3.1 Pro Preview facture 2,00 $/12,00 $ par million jusqu’à 200K tokens, et 4,00 $/18,00 $ au-delà.
Deux chiffres pour illustrer :
Une invite de 900K tokens (une grande base de code ou une pile de PDF) coûte 1,35 $ en entrée sur Standard, ou 0,0675 $ lorsque le cache implicite est utilisé.La fenêtre de contexte est unifiée : entrée, réflexion et sortie partagent 1 048 576 tokens. Une invite de 900K laisse environ 148K tokens pour la réflexion et la réponse réunies.
Les réponses synchrones sont plafonnées à 65 536 tokens. Au-delà, la sortie passe par le long decode, toujours à 7,50 $ par million.
Comment les niveaux de réflexion influencent-ils votre facture Gemini 4 Hydrogen ?
Hydrogen prend en charge quatre niveaux de réflexion : low, medium, high (par défaut) et un nouveau xhigh. Vous le définissez via generation_config.thinking_level. Le prix par token ne change jamais ; c’est le nombre de tokens de réflexion qui varie, et ceux-ci sont facturés au tarif de sortie.
Artificial Analysis a exécuté son Intelligence Index à chaque niveau. Voici ses résultats :
| Niveau de réflexion | Score d’index | Tokens générés sur l’index | Coût par tâche d’index |
|---|---|---|---|
| low | 27 | 20,3M | 0,29 $ |
| medium | 41 | 54,4M | 0,80 $ |
| high (par défaut) | 51 | 110M | 1,87 $ |
| xhigh | 54 | 304M | 3,16 $ |
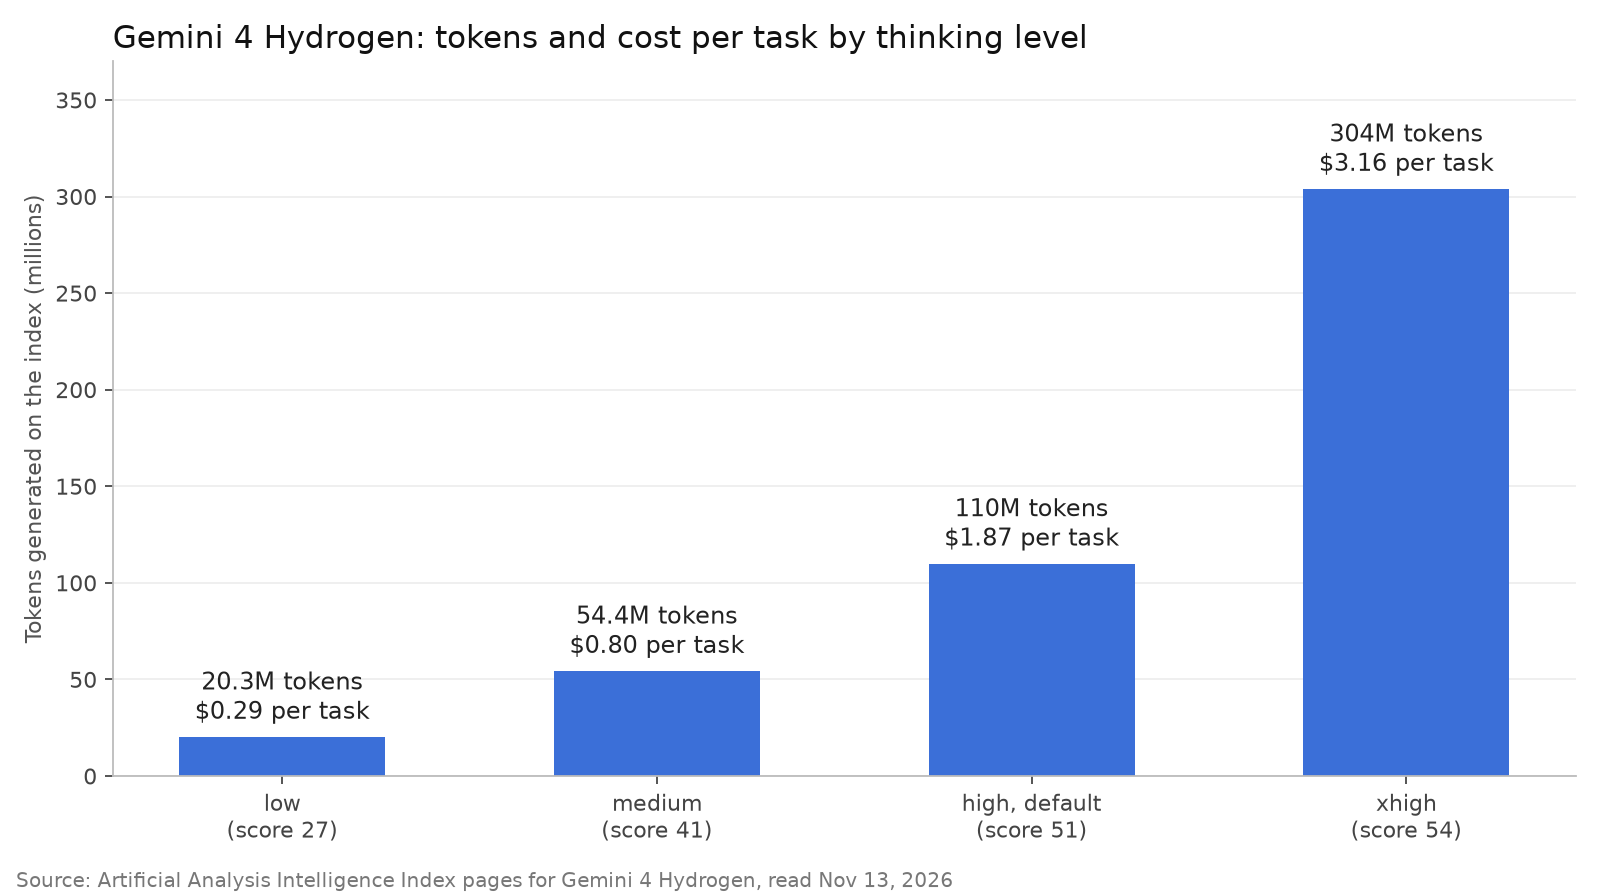
Lisez le tableau en termes de ratios. Passer de high à xhigh génère environ 2,8 fois plus de tokens et augmente le coût par tâche d’environ 1,7 fois, pour 3 points d’index de plus. Redescendre de high à low réduit les tokens à moins d’un cinquième.
La page What’s new in Gemini 4 Hydrogen de Google avertit que xhigh « peut provoquer une réflexion excessive sur des invites simples » et recommande de choisir « le thinking_level le plus bas qui satisfait votre barème de qualité ». Notez que max_output_tokens plafonne la réflexion et la sortie réunies.
Combien coûte un appel à Gemini 4 Hydrogen ?
Chaque requête suit une seule formule. Récupérez les compteurs de tokens depuis l’objet usage de la réponse (total_input_tokens, total_cached_tokens, total_thought_tokens, total_output_tokens) :
cost = (uncached_input x $1.50 / 1M)
     + (cached_input   x $0.075 / 1M)
     + ((thought + output) x $7.50 / 1M)
Les deux exemples ci-dessous utilisent des compteurs de tokens illustratifs, pas des mesures. Remplacez-les par les vôtres.
Exemple 1 : un appel de chat à high. 2 000 tokens en entrée, 1 500 tokens de réflexion, 600 tokens en sortie.
| Ligne | Standard | Batch ou Flex |
|---|---|---|
| Entrée (2 000) | 0,0030 $ | 0,0015 $ |
| Réflexion + sortie (2 100) | 0,0158 $ | 0,0079 $ |
| Total par appel | 0,0188 $ | 0,0094 $ |
| 10 000 appels par mois | 187,50 $ | 93,75 $ |
Exemple 2 : une boucle d’agent. Un agent de codage exécute 40 tours. Il renvoie la conversation à chaque tour, donc il lit au total 1,2M de tokens en entrée, dont 900K utilisent le cache implicite. Il réfléchit pendant 200K tokens et écrit 60K tokens de code et d’appels d’outils.
| Ligne | Standard | Batch ou Flex | Priority |
|---|---|---|---|
| Entrée non mise en cache (300K) | 0,45 $ | 0,23 $ | 0,81 $ |
| Entrée en cache (900K) | 0,07 $ | 0,03 $ | 0,12 $ |
| Réflexion + sortie (260K) | 1,95 $ | 0,98 $ | 3,51 $ |
| Total par exécution | 2,47 $ | 1,23 $ | 4,44 $ |
Environ 79 % de la facture Standard provient de la réflexion et de la sortie : le niveau de réflexion compte donc plus que la réduction de votre invite. Le code de requête des deux exemples se trouve dans notre guide de l’API Gemini 4 Hydrogen.
Comment les tarifs d’Hydrogen se comparent-ils à ceux de Carbon, Argon et Gemini 3.8 Flash ?
Voici les tarifs du palier payant Standard par million de tokens, issus de la page tarifaire de Google, consultée le 13 novembre 2026 :
| Modèle | Entrée | Sortie | Entrée en cache | Palier gratuit |
|---|---|---|---|---|
| Gemini 4 Hydrogen | 1,50 $ | 7,50 $ | 0,075 $ | Oui |
| Gemini 4 Carbon (jusqu’au 30 nov.) | 2,00 $ | 10,00 $ | 0,10 $ | Non |
| Gemini 4 Carbon (à partir du 1er déc.) | 4,00 $ | 20,00 $ | 0,20 $ | Non |
| Gemini 4 Argon (jusqu’au 30 nov.) | 2,00 $ | 10,00 $ | 0,10 $ | Non |
| Gemini 4 Argon (à partir du 1er déc.) | 4,00 $ | 20,00 $ | 0,20 $ | Non |
| Gemini 3.8 Flash (jusqu’au 31 déc.) | 0,75 $ | 3,75 $ | 0,075 $ | Oui |
| Gemini 3.8 Flash (à partir du 1er janv. 2027) | 1,50 $ | 7,50 $ | 0,15 $ | Oui |
Appliquez les compteurs de tokens de la boucle d’agent de l’exemple 2 à chaque tarif : vous obtenez 2,47 $ sur Hydrogen, 3,29 $ sur Carbon ou Argon ce mois-ci et 6,58 $ à partir du 1er décembre, et 1,27 $ sur Gemini 3.8 Flash jusqu’au 31 décembre. Une fois le tarif de Flash relevé le 1er janvier 2027, les mêmes tokens coûtent 2,54 $ sur Flash, légèrement plus qu’Hydrogen car le tarif en cache de Flash double à 0,15 $. Pour les détails sur la hausse des prix des modèles frontier, consultez nos guides sur les tarifs de Gemini 4 Carbon et les tarifs de Gemini 4 Argon.
À tokens identiques n’est toutefois pas la vraie comparaison, car chaque modèle consomme un nombre différent de tokens par tâche. Les pages Intelligence Index d’Artificial Analysis donnent un éclairage :
| Modèle (niveau de réflexion) | Score d’index | Tokens générés | Coût par tâche d’index |
|---|---|---|---|
| Gemini 4 Hydrogen (high) | 51 | 110M | 1,87 $ |
| Gemini 4 Hydrogen (xhigh) | 54 | 304M | 3,16 $ |
| Gemini 4 Argon (high) | 50 | 113M | 4,97 $ |
| Gemini 4 Carbon (high) | 60 | 205M | 5,48 $ |
| Gemini 3.8 Flash (high) | 31 | 126M | non comparé ici |
Sur ce benchmark, Hydrogen à son niveau par défaut a obtenu le score d’Argon pour environ 38 % de son coût par tâche, tandis que Carbon obtenait le meilleur score. À prendre comme le point de vue d’un seul benchmark. Google indique également qu’Hydrogen termine les tâches 2,5 fois plus vite que Gemini 3.8 Flash au niveau high.
En pratique : Hydrogen pour le codage quotidien et les agents, Carbon pour l’architecture complexe, le débogage et les revues de sécurité. Dans Antigravity, l’option Orchestrator alterne entre Carbon et Hydrogen au sein d’une même exécution. Notre comparaison Gemini 4 Carbon vs Argon couvre le versant frontier.
Comment réduire votre facture Gemini 4 Hydrogen ?
Utilisez Batch ou Flex pour les travaux qui peuvent attendre. Les deux sont à moitié prix.Choisissez le niveau de réflexion le plus bas qui passe vos évaluations. medium a consommé environ deux fois moins de tokens que high.Réservez xhigh aux tours difficiles.Conservez un préfixe d’invite stable pour que la mise en cache implicite facture l’entrée répétée à 0,075 $ par million, soit une remise de 95 %.Prototypez sur le palier gratuit.
Mesurez votre coût réel avec Gemini 4 Hydrogen grâce à Apidog CLI
Votre facture dépend de vos propres invites. Le moyen le plus rapide d’obtenir des chiffres réels est de faire exécuter vos invites par votre agent de codage (Claude Code, Codex, Cursor) à chaque niveau de réflexion via Apidog CLI, et d’enregistrer l’objet usage de chaque exécution.
Configuration en une fois :
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Placez 5 à 10 de vos invites réelles dans levels.csv, une ligne par invite et niveau de réflexion, avec les colonnes prompt et thinking_level (low, medium, high, xhigh). Puis donnez une seule invite à votre agent :
In Apidog project <projectId>, create a test case for
POST https://generativelanguage.googleapis.com/v1beta/interactions
with the x-goog-api-key header read from GEMINI_API_KEY in environment
<envId>. Send model "gemini-4-hydrogen", input {{prompt}} and
generation_config.thinking_level {{thinking_level}}. Assert status 200,
status "completed", non-empty output, and a usage object that includes
total_input_tokens and total_output_tokens. In a post-processor, read
total_input_tokens, total_cached_tokens, total_thought_tokens and
total_output_tokens, compute cost at $1.50 input, $0.075 cached and
$7.50 output per 1M, and log it. Run every row of levels.csv and give me
a table of tokens and cost per prompt and thinking level.
L’agent vérifie la structure du payload avant d’écrire quoi que ce soit, puis exécute chaque ligne :
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> \
  -d levels.csv -r cli,json --out-file hydrogen-cost-{GENERATE_TIME}
Le rapport JSON montre ce que coûte chaque niveau de réflexion sur votre charge de travail. Ajoutez -r junit et la même commande s’exécute en CI, où une assertion sur le budget de tokens peut faire échouer le build. Le guide CI/CD d’Apidog CLI présente le pipeline, et Apidog CLI dans Claude Code détaille la configuration de l’agent. Le plan gratuit d’Apidog couvre jusqu’à 4 utilisateurs.
Raccourci : dites à votre agent « Read https://apidog.com/apidog-cli-installation-guide.md and set up Apidog CLI. »
FAQ
Gemini 4 Hydrogen est-il gratuit ? Sur l’API, oui, dans les limites de débit du palier gratuit : Google indique l’entrée et la sortie Standard comme « Free of charge » sur le palier gratuit. Batch, Flex et le grounding Search nécessitent une clé payante. Voir notre guide sur Gemini 4 Hydrogen gratuit.
Le prix de Gemini 4 Hydrogen va-t-il augmenter comme celui de Carbon ? La page tarifaire de Google affiche un tarif unique de 1,50 $/7,50 $ pour Hydrogen, sans période de lancement ni date de fin. Carbon et Argon comportent des tarifs de lancement datés ; Hydrogen non.
Les tokens de réflexion sont-ils facturés pour Gemini 4 Hydrogen ? Oui, au tarif de sortie de 7,50 $ par million sur Standard. L’objet usage de la réponse les signale séparément via total_thought_tokens.
Gemini 4 Hydrogen est-il moins cher que Gemini 3.8 Flash ? Pas cette année : Flash coûte 0,75 $/3,75 $ jusqu’au 31 décembre 2026. À partir du 1er janvier 2027, Flash passe à 1,50 $/7,50 $, le même tarif par token qu’Hydrogen, et Hydrogen a obtenu un score de 51 contre 31 pour Flash sur l’index d’Artificial Analysis.