
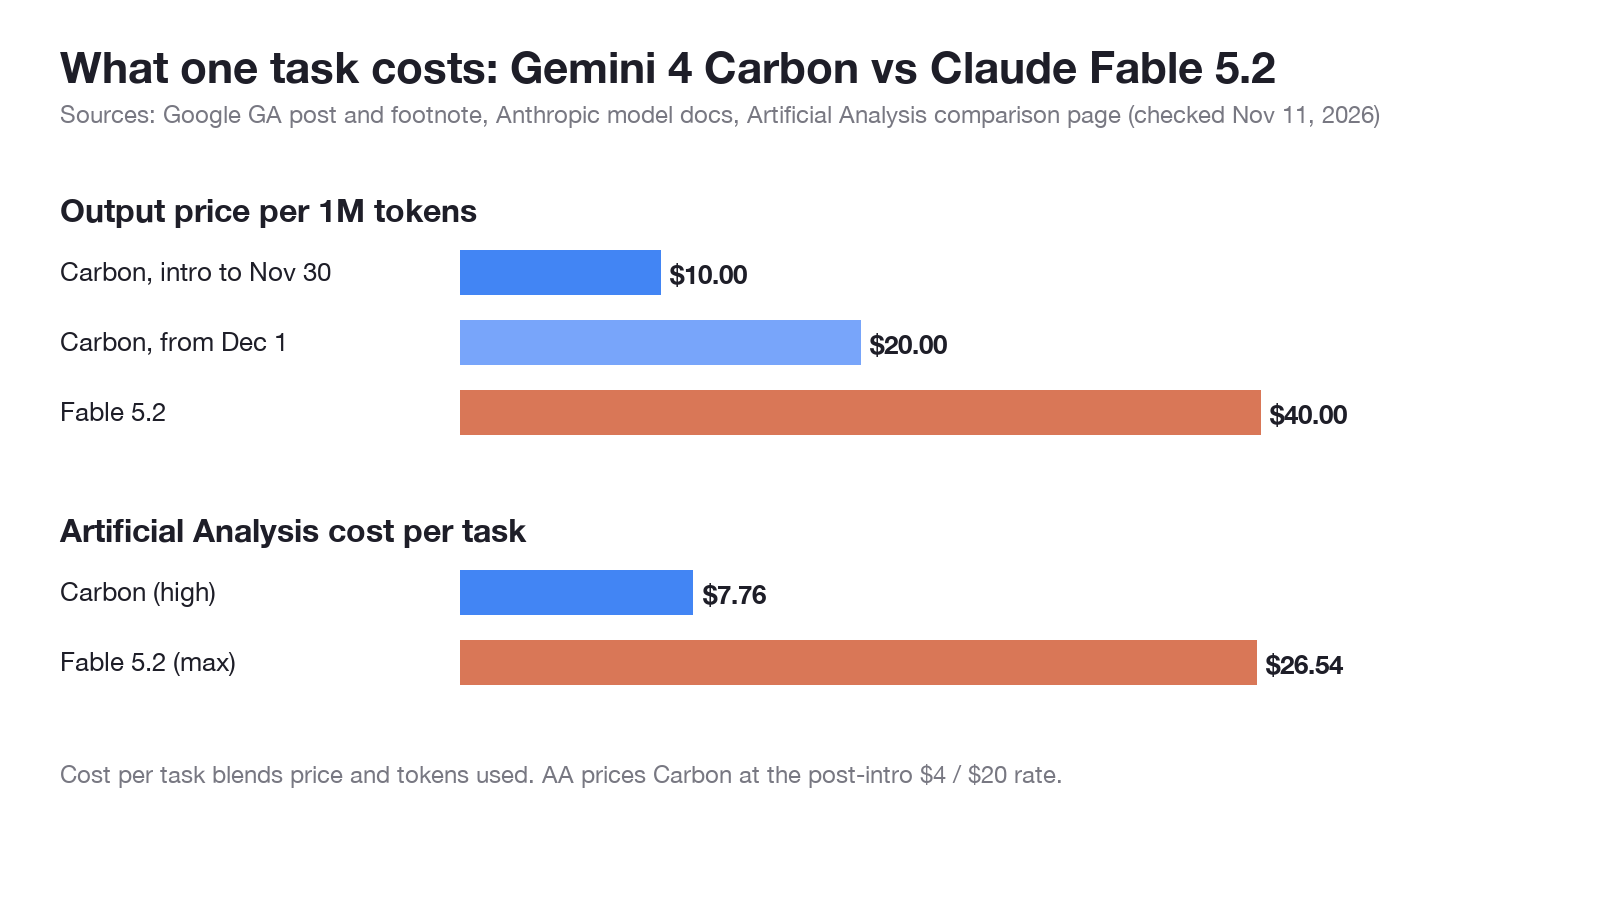
Depuis le 11 novembre 2026, le Gemini 4 Carbon de Google est le modèle le moins cher, tandis que le Claude Fable 5.2 est le plus performant sur la plupart des benchmarks de code et d'agents publiés. Carbon est tarifé à 2 $ / 10 $ par million de tokens d'entrée/sortie jusqu'au 30 novembre (puis 4 $ / 20 $), Fable 5.2 à 8 $ / 40 $, et Artificial Analysis évalue le coût d'une tâche à 7,76 $ contre 26,54 $.
Les deux modèles ont été lancés à un jour d'intervalle (Fable 5.2 le 9 novembre, Carbon en GA le 10 novembre), et les tableaux de chaque éditeur favorisent leur propre modèle. Ce guide distingue chaque chiffre selon la source qui l'a mesuré, puis montre comment tester les deux en A/B sur vos propres requêtes.
Gemini 4 Carbon vs Claude Fable 5.2 : le verdict rapide
Choisissez Gemini 4 Carbon lorsque le coût par tâche est prioritaire, pour les flux d'automatisation métier ou pour les travaux de sécurité. Choisissez Claude Fable 5.2 lorsque vous avez besoin des meilleurs scores sur les tâches de code complexes, de terminal et d'utilisation de l'ordinateur, et que vous pouvez payer environ 3,4 fois plus par tâche. Pour le développement au quotidien, les deux éditeurs vous orientent d'abord vers un modèle par défaut moins cher.
Google indique dans son article d'annonce de la GA qu'« Argon reste le choix idéal pour la majorité des travaux de génie logiciel et de knowledge work », et positionne Carbon pour les tâches plus difficiles, où il dépense davantage de tokens pour explorer et vérifier. La documentation d'Anthropic dit la même chose autrement : commencez avec Claude Opus 5.5 pour la plupart des charges de travail et passez à Fable 5.2 pour le raisonnement exigeant et les tâches agentiques de longue haleine.
Ces deux modèles sont donc à envisager une fois que votre modèle par défaut atteint ses limites. Vous hésitez encore sur le modèle par défaut ? Lisez d'abord Gemini 4 Carbon vs Argon.
Comment se comparent Gemini 4 Carbon et Claude Fable 5.2 en termes de prix et de caractéristiques ?
Voici les faits publiés par chaque éditeur, avec la source de chaque ligne.
| Caractéristique | Gemini 4 Carbon | Claude Fable 5.2 | Source |
|---|---|---|---|
| ID du modèle | gemini-4-carbon |
claude-fable-5-2 |
Google, Anthropic |
| Sortie | GA le 10 nov. 2026 | 9 nov. 2026 | Google, Anthropic |
| Prix d'entrée par million de tokens | 2 $ jusqu'au 30 nov., puis 4 $ | 8 $ (16 $ en mode rapide) | Note de bas de page de Google, Anthropic |
| Prix de sortie par million de tokens | 10 $ jusqu'au 30 nov., puis 20 $ | 40 $ (80 $ en mode rapide) | Note de bas de page de Google, Anthropic |
| Fenêtre de contexte | 1 M de tokens | 1 M de tokens | Fiche modèle AI Studio, docs Anthropic |
| Sortie maximale | 65K / 1 M annoncés [À VÉRIFIER] | 128K tokens | Fiche modèle AI Studio, docs Anthropic |
| Réflexion | Niveau de réflexion configurable | Adaptatif, toujours actif, effort par défaut high |
Quickstart Google, docs Anthropic |
| Où y accéder | Palier payant de l'API Gemini, AI Studio, Android Studio, Gemini pour les entreprises, Antigravity, CodeMender, Google AI Ultra | Claude Platform, Amazon Web Services, Google Cloud, Microsoft Azure | Google, Anthropic |
| Palier API gratuit | Aucun mentionné | Aucun mentionné | Google, Anthropic |
L'article d'annonce de la GA de Google ne mentionne ni Vertex AI, ni Gemini CLI, ni GitHub Copilot : ne misez donc pas encore sur ces outils. Le prix de lancement de Carbon correspond à celui d'Argon, ce qui fait de novembre le mois le moins cher pour réaliser votre évaluation.
Pour les grilles tarifaires complètes, consultez la tarification de Claude Fable 5.2 et l'annonce de Gemini 4 Carbon de Google.
Quel modèle remporte les benchmarks ?
Cela dépend du tableau que vous lisez ; voici donc trois tableaux soigneusement distingués.
Le tableau d'Anthropic (publié avec Fable 5.2)
L'article de lancement Fable 5.2 d'Anthropic inclut une colonne pour Gemini 4 Carbon. La page ne précise pas qui a mesuré les résultats de Carbon : considérez-les donc comme communiqués par l'éditeur.
| Benchmark (tableau d'Anthropic) | Fable 5.2 | Gemini 4 Carbon |
|---|---|---|
| FrontierSWE v2 | 69,9 % | 61,2 % |
| FrontierCode 2.0 | 49,1 % (effort xhigh) | 41,1 % (effort medium) |
| Terminal-Bench-Science 0.1 | 74,6 % | 64,8 % |
| OSWorld 2.1 (ensemble hors ligne, partiel) | 89,3 % | 81,5 % |
| AA-Briefcase v1.1 (rubrique) | 66,1 % | 61,8 % |
| Chartography (sans outils) | 73,4 % | 72,5 % |
| AutomationBench | 51,4 % | 53,9 % |
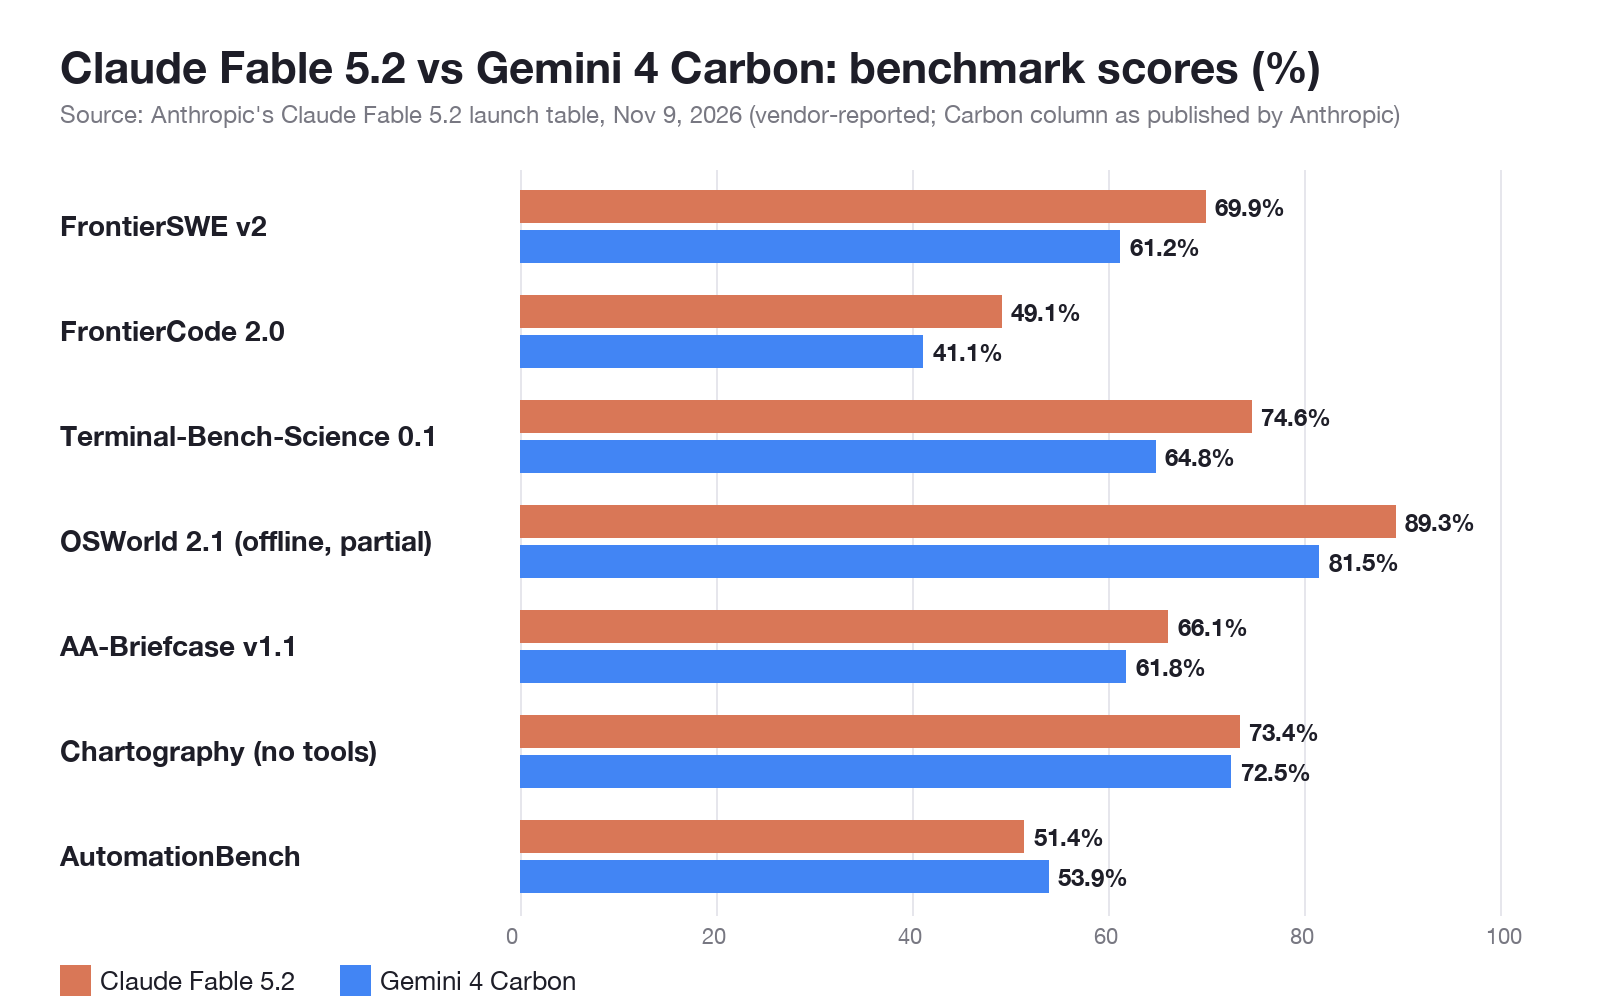
Notez la ligne FrontierCode : Fable a tourné avec un effort xhigh et Carbon avec un effort medium. Cet écart de configuration compte autant que l'écart de scores.
Le tableau de Google (publié avec la GA de Carbon)
Google ne publie pas de comparaison directe avec Fable 5.2. Il se appuie plutôt sur des classements de partenaires : Carbon arrive premier sur CursorBench 4.0, WANDR de Perplexity et AutomationBench de Zapier « à un coût par tâche plus de deux fois inférieur à celui du meilleur modèle externe suivant ». Il se classe deuxième sur le benchmark Multimodal Knowledge Agent, avec un coût moyen par tâche plus de six fois inférieur à celui du meilleur modèle. Google ne nomme pas les modèles concurrents dans ces affirmations.
Artificial Analysis (indépendant)
La page de comparaison d'Artificial Analysis fait passer les deux modèles par le même Intelligence Index v5.0.1 :
| Métrique (Artificial Analysis) | Fable 5.2 (max) | Gemini 4 Carbon (high) |
|---|---|---|
| Intelligence Index | 65 | 60 |
| Coût par tâche | 26,54 $ | 7,76 $ |
| Coût pour exécuter l'index complet | 22 191 $ | 8 240 $ |
| Vitesse de sortie | 103 tokens/s | 82 tokens/s |
Fable 5.2 (max) occupe la première place de cet index aujourd'hui. Carbon obtient 5 points de moins, pour environ 29 % du coût par tâche. Artificial Analysis tarife Carbon à 4 $ / 20 $, le tarif post-novembre : ses chiffres de coût reflètent donc déjà le prix de décembre.
Où Claude Fable 5.2 s'impose-t-il ?
Fable 5.2 l'emporte sur les tâches de code et d'utilisation de l'ordinateur les plus difficiles, selon les chiffres d'Anthropic :
- Codage à l'échelle d'un dépôt : 69,9 % contre 61,2 % sur FrontierSWE v2.
- Travail en terminal et recherche : 74,6 % contre 64,8 % sur Terminal-Bench-Science 0.1.
- Utilisation de l'ordinateur : 89,3 % contre 81,5 % sur OSWorld 2.1.
- Index indépendant : 65 contre 60 sur Artificial Analysis, le seul score mesuré par aucun des deux éditeurs.
- Longueur de sortie : une sortie maximale documentée de 128K tokens par requête.
Si l'échec d'une tâche coûte un après-midi d'ingénieur, un gain de 8 points sur FrontierSWE peut dépasser la facture de tokens. Pour la configuration, consultez le guide API de Claude Fable 5.2.
Où Gemini 4 Carbon s'impose-t-il ?
Carbon l'emporte sur le coût par tâche et sur les charges de travail pour lesquelles Google l'a conçu :
- Coût par tâche : 7,76 $ contre 26,54 $ sur Artificial Analysis, soit environ 3,4 fois moins cher.
- Automatisation métier : 53,9 % contre 51,4 % sur AutomationBench, dans le propre tableau d'Anthropic.
- Sécurité : en tête sur SEC-bench Pro, ExploitGym et CWE-bench v1 selon Google, avec un modèle Carbon for cyber en accès restreint pour les défenseurs via le Fairwind Program.
- Tarif en novembre : 2 $ / 10 $ jusqu'au 30 novembre, soit un quart du tarif de Fable, tant en entrée qu'en sortie.
- Équipes d'agents : la préversion /swarm de Google Antigravity transforme une seule invite en équipe coordonnée, Carbon planifiant et auditant pendant que des modèles plus légers travaillent en parallèle.
Vous ne connaissez pas encore ce modèle ? Commencez par qu'est-ce que Gemini 4 Carbon.
Quel est le coût réel d'une tâche ?
Le tarif de liste indique le prix unitaire, pas la facture. Le coût d'une tâche correspond au prix multiplié par les tokens que le modèle choisit de dépenser, et Google précise que Carbon dépense davantage de tokens pour explorer et vérifier.
Prenons une requête avec 50 000 tokens d'entrée et 10 000 tokens de sortie :
- Carbon, tarif de lancement : (0,05 x 2 $) + (0,01 x 10 $) = 0,20 $
- Carbon, à partir du 1er décembre : (0,05 x 4 $) + (0,01 x 20 $) = 0,40 $
- Fable 5.2 : (0,05 x 8 $) + (0,01 x 40 $) = 0,80 $
Cela suppose que les deux émettent 10 000 tokens. Ce ne sera pas le cas. Si Carbon rédige 30 000 tokens de raisonnement là où Fable en écrit 10 000, le coût de Carbon en décembre monte à 0,80 $ et l'écart se referme. Artificial Analysis a mesuré la réalité sur l'ensemble de sa suite de tests et a malgré tout constaté que Carbon est environ 3,4 fois moins cher par tâche : c'est le signal le plus fiable dont vous disposiez jusqu'à ce que vous fassiez vos propres mesures.
Comment tester en A/B Gemini 4 Carbon et Claude Fable 5.2 sur vos propres requêtes ?
Les benchmarks, ce sont les tâches des autres. Le test équitable consiste à envoyer la même invite aux deux API et à enregistrer tokens et latence côte à côte.
Les deux appels sont du simple HTTP. Voici la requête de Carbon, construite à partir du quickstart de Google pour l'API Interactions, avec le nom du modèle dans une variable :
MODEL="gemini-4-carbon"
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Api-Revision: 2026-05-20" \
  -d "{\"model\": \"$MODEL\", \"input\": \"Review this diff and list the bugs.\"}"
Fable 5.2 passe par l'API Messages d'Anthropic avec claude-fable-5-2 comme modèle.
Laissez votre agent de code exécuter le A/B avec Apidog CLI
Exécuter des paires de requêtes à la main devient vite lassant. Laissez plutôt Claude Code, Codex ou Cursor piloter Apidog CLI. La configuration ne prend que trois commandes :
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_APIDOG_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Donnez ensuite une seule invite à votre agent :
In Apidog project <PROJECT_ID>, create two test cases: one that sends
our code-review prompt to gemini-4-carbon through the Gemini API, and
one that sends the same prompt to claude-fable-5-2 through the Claude
Messages API. Keep both API keys in private environment variables.
Assert a 200 status and a non-empty answer, record token usage and
response time, run each case 5 times and summarize cost per run.
Validate every payload before you write it.
L'agent vérifie le schéma, écrit les cas et les exécute. Les options ci-dessous proviennent de apidog run --help sur la CLI 2.2.12 :
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file carbon-case.json
apidog test-case create --project <PROJECT_ID> --file carbon-case.json
apidog test-case create --project <PROJECT_ID> --file fable-case.json
apidog run --test-case <CARBON_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir ab-results
apidog run --test-case <FABLE_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir ab-results
-n 5 répète chaque cas cinq fois, pour qu'une réponse lente seule ne décide pas du résultat. Ajoutez --upload-report pour consulter les exécutions dans l'application Apidog. Il s'agit d'un modèle de workflow ; nous ne l'avons pas exécuté contre Carbon depuis cette machine. Le guide Apidog CLI dans Claude Code couvre la configuration de l'agent, et le guide API Gemini 4 Argon couvre le côté requête Gemini.
Le plan gratuit d'Apidog couvre jusqu'à 4 utilisateurs, ce qui suffit pour réaliser cette comparaison.
FAQ
Gemini 4 Carbon est-il meilleur que Claude Fable 5.2 ?
Pas de façon générale. Fable 5.2 obtient de meilleurs scores sur la plupart des benchmarks d'Anthropic et sur l'index d'Artificial Analysis (65 contre 60). Carbon l'emporte sur le coût par tâche (7,76 $ contre 26,54 $) et sur AutomationBench.
De combien Gemini 4 Carbon est-il moins cher que Claude Fable 5.2 ?
Au tarif de liste, Carbon est 4 fois moins cher jusqu'au 30 novembre 2026 (2 $ / 10 $ contre 8 $ / 40 $ par million de tokens) et 2 fois moins cher à partir du 1er décembre (4 $ / 20 $). Mesuré par tâche par Artificial Analysis, il est environ 3,4 fois moins cher.
Les deux modèles ont-ils une fenêtre de contexte d'un million de tokens ?
Oui. La fiche modèle d'AI Studio de Google annonce 1 M de tokens pour Carbon et la documentation d'Anthropic 1 M de tokens pour Fable 5.2. La sortie maximale de Fable est de 128K tokens ; consultez le guide développeur de Google pour la limite de sortie exacte de Carbon.
Existe-t-il un palier gratuit pour Gemini 4 Carbon ou Claude Fable 5.2 via l'API ?
Aucun des deux éditeurs n'en mentionne. Carbon se situe sur le palier payant de l'API Gemini et dans les applications Google AI Ultra ; Fable 5.2 est facturé au token.
Devrais-je remplacer mon modèle par défaut par l'un des deux ?
Probablement pas. Google indique qu'Argon reste le bon choix pour la majorité des travaux de génie logiciel et de knowledge work, et Anthropic recommande Opus 5.5 pour la plupart des charges de travail. Orientez vers Carbon ou Fable uniquement les tâches où votre modèle par défaut échoue, puis comparez les résultats sur vos propres requêtes.