
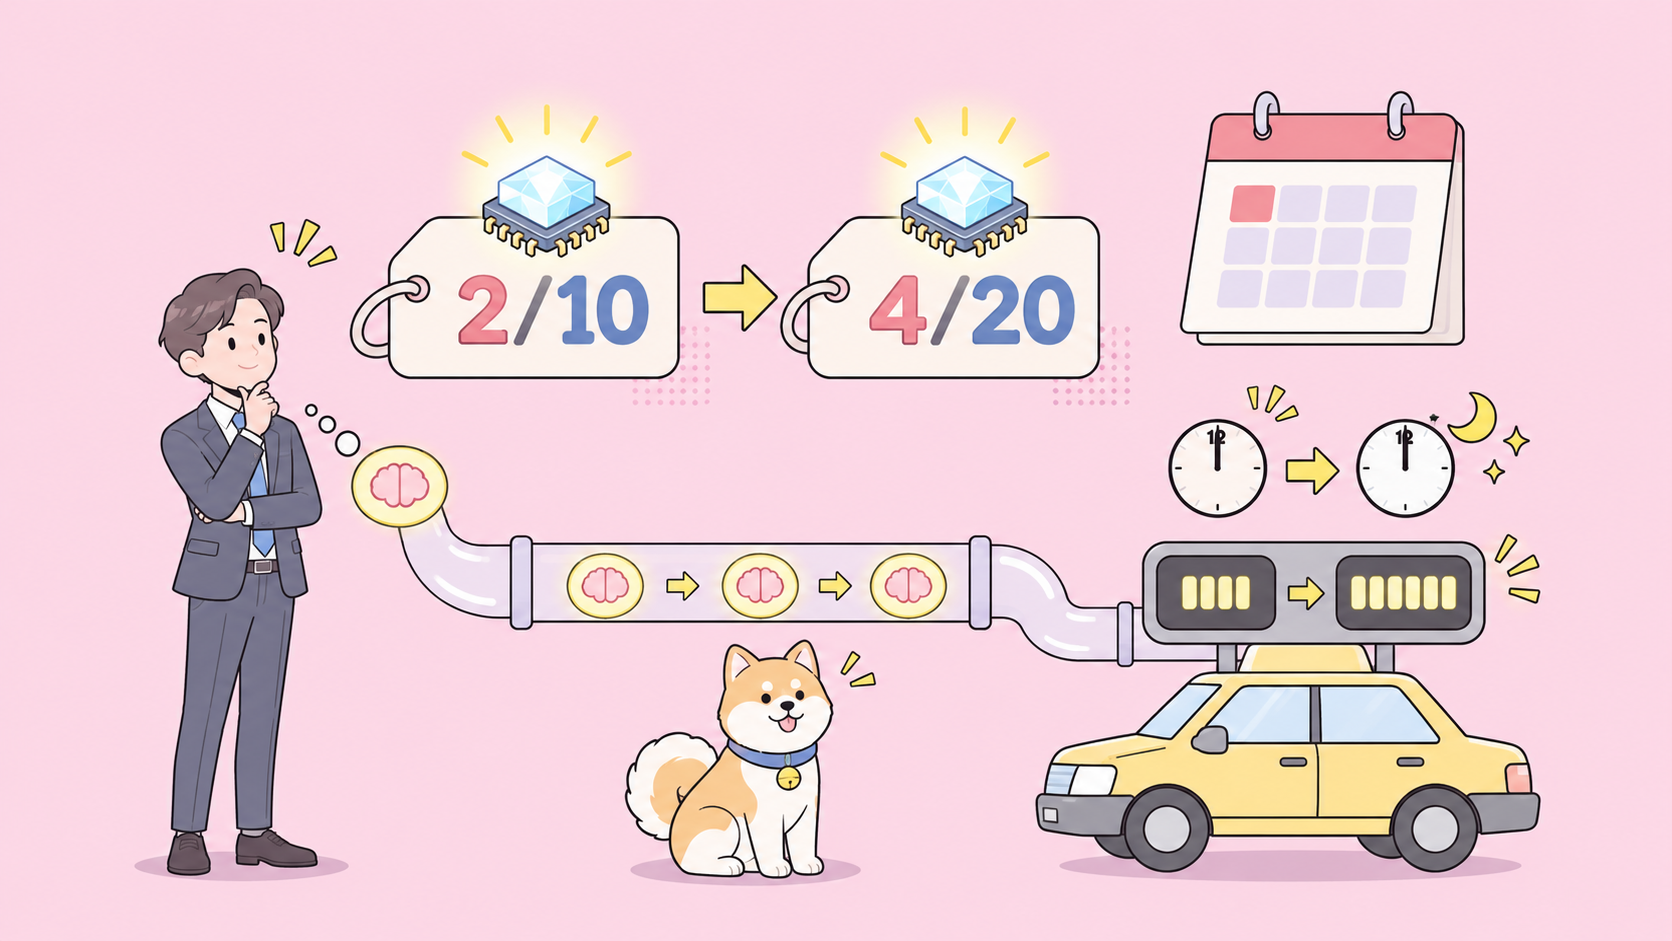
Au 11 novembre 2026, Gemini 4 Carbon de Google coûte 2 $ par million de tokens d'entrée et 10 $ par million de tokens de sortie via l'API Gemini, un prix de lancement qui prend fin le 30 novembre 2026. À partir du 1ᵉʳ décembre, la tarification de Gemini 4 Carbon double : 4 $ en entrée et 20 $ en sortie par million de tokens, les tokens de réflexion étant facturés au tarif de sortie.
Votre facture réelle dépend du nombre de tokens que Carbon consacre à la réflexion, et Carbon en consomme beaucoup. Vous trouverez ci-dessous : le tableau complet des tarifs, des exemples chiffrés aux deux niveaux de prix, l'écart de coût par rapport à Argon et aux modèles concurrents, ainsi qu'une méthode pour consigner votre coût réel par requête. Vous découvrez le modèle ? Commencez par ce qu'est Gemini 4 Carbon.
Combien coûte Gemini 4 Carbon par million de tokens ?
Gemini 4 Carbon (ID de modèle gemini-4-carbon) est un modèle de l'offre payante. La page de tarification de Google liste quatre niveaux, chacun avec un prix de lancement valable jusqu'au 30 novembre 2026 et un nouveau prix à partir du 1ᵉʳ décembre 2026 :
| Niveau | Entrée (jusqu'au 30 nov.) | Entrée (à partir du 1ᵉʳ déc.) | Sortie incl. réflexion (jusqu'au 30 nov.) | Sortie incl. réflexion (à partir du 1ᵉʳ déc.) | Entrée en cache (jusqu'au 30 nov. / à partir du 1ᵉʳ déc.) | Source |
|---|---|---|---|---|---|---|
| Standard | 2,00 $ | 4,00 $ | 10,00 $ | 20,00 $ | 0,10 $ / 0,20 $ | |
| Batch | 1,00 $ | 2,00 $ | 5,00 $ | 10,00 $ | 0,05 $ / 0,10 $ | |
| Flex | 1,00 $ | 2,00 $ | 5,00 $ | 10,00 $ | 0,05 $ / 0,10 $ | |
| Priority | 3,60 $ | 7,20 $ | 18,00 $ | 36,00 $ | 0,18 $ / 0,36 $ |
Tous les prix sont exprimés par million de tokens. Quelques détails figurant sur la même page ont une incidence sur votre budget :
- Pas d'offre gratuite. La page de Google indique : « Gemini 4 Carbon is not available on the Free tier » (Gemini 4 Carbon n'est pas disponible sur le niveau gratuit).
- La réflexion est facturée. « Chaque token traité par le modèle est comptabilisé et facturé, y compris les tokens de réflexion. »
- Mise en cache implicite uniquement. La mise en cache explicite n'est pas prise en charge ; vous bénéficiez donc du tarif en cache lorsque le cache implicite de Google reconnaît un préfixe de prompt déjà rencontré.
L'article de lancement de Google précise le changement en note de bas de page : « Après la fin de la période de lancement le 30 novembre 2026, le tarif de 4 $ par million de tokens d'entrée et 20 $ par million de tokens de sortie s'appliquera. Applicable uniquement au modèle Carbon destiné à l'accès public. »
Qu'est-ce qui change le 1ᵉʳ décembre 2026 ?
Tous les tarifs doublent. L'entrée Standard passe de 2 $ à 4 $, la sortie de 10 $ à 20 $, et le tarif en cache de 0,10 $ à 0,20 $. Les niveaux Batch et Flex doublent également, si bien que la remise Batch de 50 % est maintenue.
La note de bas de page ne prévoit aucune exception pour les premiers utilisateurs, et rien sur la page de tarification n'indique que les projets existants conserveront le tarif de lancement. Budgétez tous les tokens envoyés à partir du 1ᵉʳ décembre à 4 $/20 $.
Gemini 4 Argon suit le même calendrier ; consultez notre guide de tarification de Gemini 4 Argon.
Comment les tokens de réflexion de Gemini 4 Carbon sont-ils facturés ?
Les tokens de réflexion sont facturés au tarif de sortie : 10 $ par million jusqu'au 30 novembre, puis 20 $. L'API Interactions les signale dans un champ distinct ; l'objet usage d'une réponse ressemble donc à cet exemple tiré de la documentation de Google :
"usage": {
  "total_tokens": 530,
  "total_input_tokens": 62,
  "total_output_tokens": 171,
  "total_thought_tokens": 297
}
Le modèle a réfléchi pendant 297 tokens pour en écrire 171, et vous payez le tarif de sortie pour du texte que vous ne voyez jamais. Par défaut, Carbon utilise un thinking_level « medium » et accepte aussi « low » et « high », selon le guide sur la réflexion de Google.
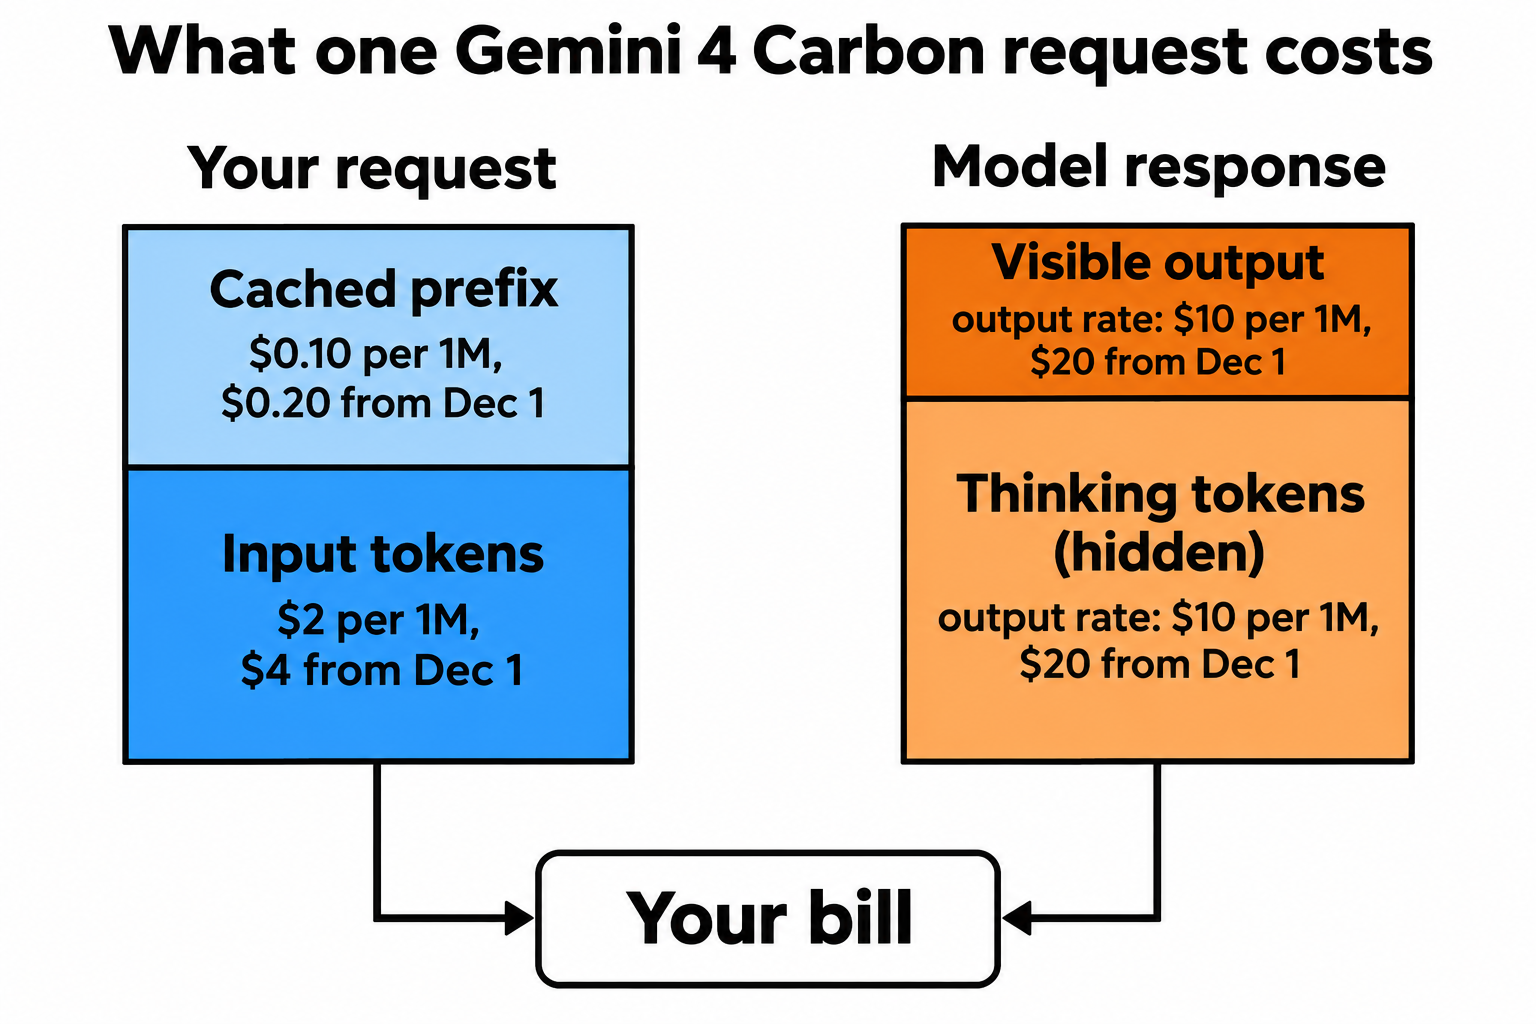
La formule pour une requête est :
cost = (uncached_input x input_rate)
     + (cached_input x cached_rate)
     + ((thought + output) x output_rate)
Combien coûte un appel à Gemini 4 Carbon ?
Les deux exemples ci-dessous présentent des nombres de tokens illustratifs, et non des mesures réelles. Remplacez-les par les chiffres de votre propre objet usage.
Exemple 1 : un appel de chat unique. 1 500 tokens d'entrée, 2 500 tokens de réflexion, 800 tokens de sortie.
| Ligne | Jusqu'au 30 nov. | À partir du 1ᵉʳ déc. |
|---|---|---|
| Entrée (1 500) | 0,0030 $ | 0,0060 $ |
| Réflexion + sortie (3 300) | 0,0330 $ | 0,0660 $ |
| Total par appel | 0,036 $ | 0,072 $ |
| 10 000 appels par mois | 360 $ | 720 $ |
Exemple 2 : une longue exécution d'agent avec une réflexion intensive. Une boucle d'agent compte 40 tours. Comme elle renvoie la conversation à chaque tour, elle lit au total 1,2 M de tokens d'entrée, dont 900 K touchent le cache implicite. Elle réfléchit pendant 300 K tokens et écrit 60 K tokens de code et d'appels d'outils.
| Ligne | Jusqu'au 30 nov. | À partir du 1ᵉʳ déc. |
|---|---|---|
| Entrée hors cache (300 K) | 0,60 $ | 1,20 $ |
| Entrée en cache (900 K) | 0,09 $ | 0,18 $ |
| Réflexion + sortie (360 K) | 3,60 $ | 7,20 $ |
| Total par exécution | 4,29 $ | 8,58 $ |
| Mêmes tokens aux tarifs Batch ou Flex | 2,15 $ | 4,29 $ |
Dans l'exécution d'agent, 84 % de la facture correspond à la réflexion et à la sortie : abaisser le niveau de réflexion permet donc d'économiser davantage que de raccourcir le prompt. Le code de la requête figure dans notre guide de l'API Gemini 4 Carbon.
Gemini 4 Carbon est-il plus cher que Gemini 4 Argon ?
Par token, non : les deux coûtent 2 $/10 $ actuellement et 4 $/20 $ à partir du 1ᵉʳ décembre. Par tâche, oui, en général. Google indique que Carbon traite les tâches plus difficiles « en utilisant plus de tokens qu'Argon pour explorer en profondeur, raisonner finement et exécuter des boucles de vérification étendues », et que « Argon reste le choix idéal pour la majorité du travail d'ingénierie logicielle et de traitement de la connaissance ».
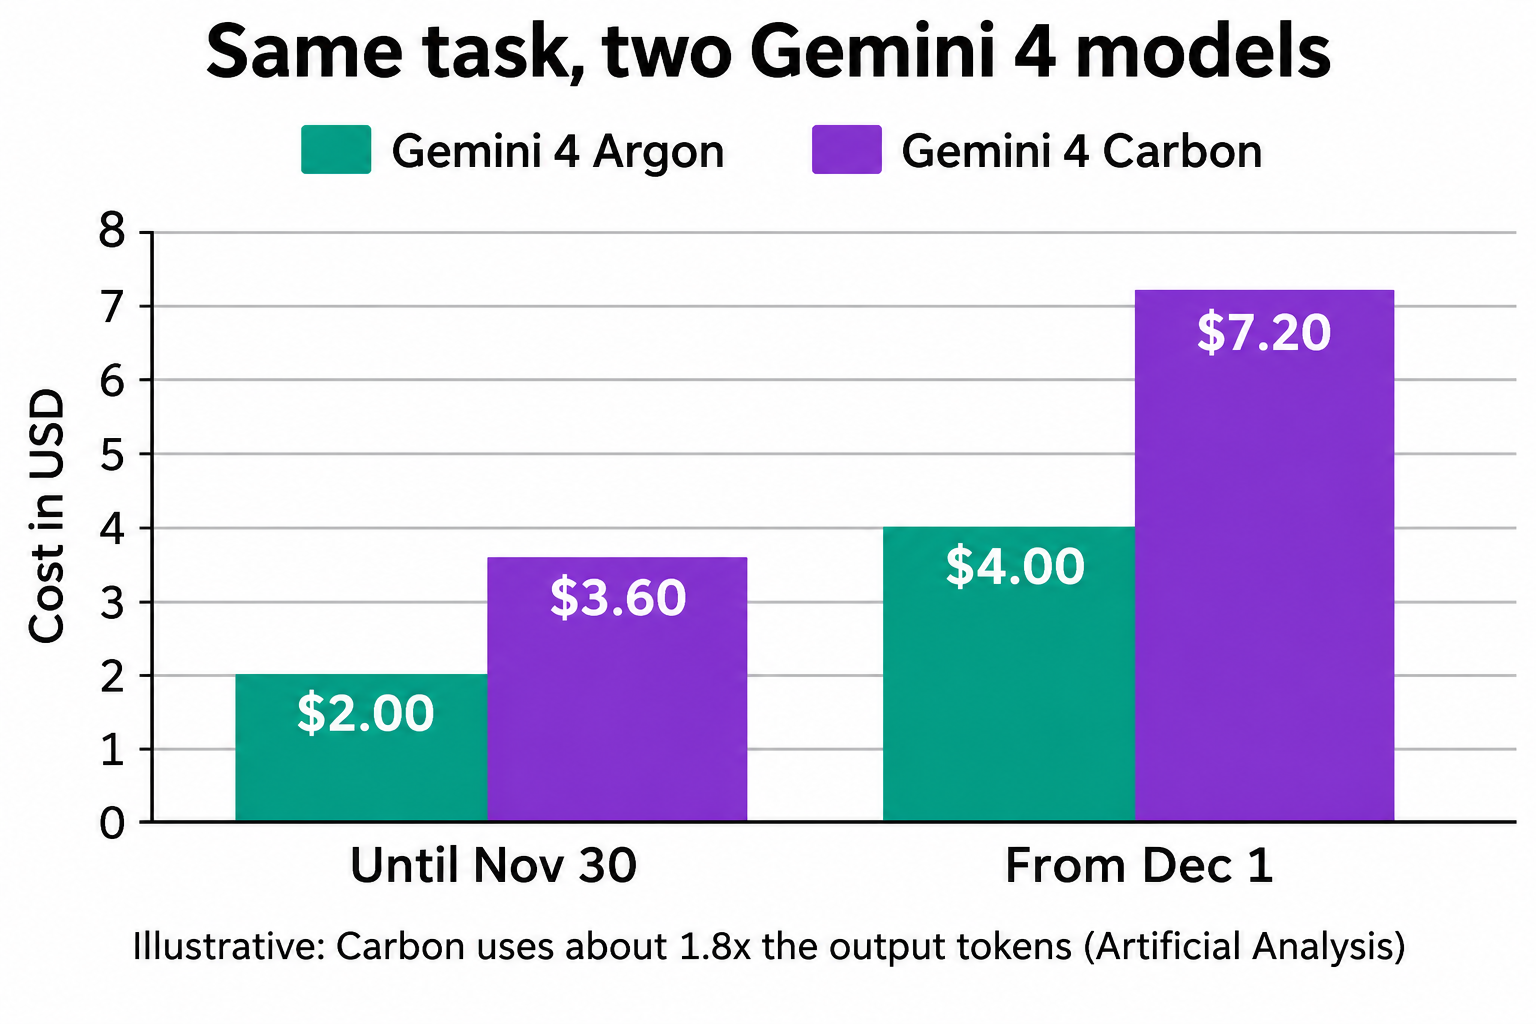
Artificial Analysis a chiffré cet écart. Lors de l'exécution de son Intelligence Index, Gemini 4 Carbon (high) a produit 205 M de tokens de sortie, contre 113 M pour Gemini 4 Argon. Cela représente environ 1,8 fois plus de tokens de sortie pour le même ensemble de tâches, et cela a permis d'obtenir un score supérieur : 60 pour Carbon contre 50 pour Argon.
Appliquons ce ratio à une tâche où Argon dépense 200 K tokens de sortie :
| Modèle | Tokens de sortie | Coût jusqu'au 30 nov. | Coût à partir du 1ᵉʳ déc. |
|---|---|---|---|
| Gemini 4 Argon | 200 000 | 2,00 $ | 4,00 $ |
| Gemini 4 Carbon (environ 1,8x) | 360 000 | 3,60 $ | 7,20 $ |
Acheminez donc les tâches selon leur difficulté : débogage complexe, architecture et audits de sécurité vers Carbon ; codage quotidien vers Argon. Notre comparaison Gemini 4 Carbon vs Argon détaille quelles tâches justifient les tokens supplémentaires.
Comment la tarification de Gemini 4 Carbon se compare-t-elle à Claude Fable 5.2, Opus 5.5 et GPT-6.1 Sol ?
Voici les tarifs standard de l'API par million de tokens, relevés sur la page de tarification de chaque fournisseur le 11 novembre 2026 :
| Modèle | Entrée | Sortie | Entrée en cache | Source |
|---|---|---|---|---|
| Gemini 4 Carbon (jusqu'au 30 nov.) | 2,00 $ | 10,00 $ | 0,10 $ | |
| Gemini 4 Carbon (à partir du 1ᵉʳ déc.) | 4,00 $ | 20,00 $ | 0,20 $ | |
| Gemini 4 Argon (jusqu'au 30 nov.) | 2,00 $ | 10,00 $ | 0,10 $ | |
| Claude Fable 5.2 | 8,00 $ | 40,00 $ | 0,20 $ (cache hit) | Anthropic |
| Claude Opus 5.5 | 4,00 $ | 20,00 $ | 0,20 $ (cache hit) | Anthropic |
| GPT-6.1 Sol | 2,00 $ | 10,00 $ | 0,10 $ | OpenAI |
| GPT-6 Astra | 10,00 $ | 50,00 $ | 1,00 $ | OpenAI |
À partir du 1ᵉʳ décembre, le prix par token de Carbon égale celui de Claude Opus 5.5 et reste la moitié de celui de Claude Fable 5.2. Anthropic facture des frais supplémentaires pour l'écriture en cache ; Google n'annonce aucun frais d'écriture pour la mise en cache implicite. Le prix de Sol d'OpenAI couvre les prompts jusqu'à 272 K tokens d'entrée.
Les prix affichés ne suffisent pas à trancher, car chaque modèle réfléchit en quantités différentes. Artificial Analysis publie un chiffre de coût pour chaque modèle sur son Intelligence Index : 7,76 $ pour Gemini 4 Carbon (high) avec un score de 60, et 26,54 $ pour Claude Fable 5.2 (max) avec un score de 65. Fable 5.2 a également produit plus de tokens de sortie sur l'index (275 M contre 205 M pour Carbon). Considérez ces chiffres comme le point de vue d'un seul benchmark ; votre charge de travail sera différente. Pour le face-à-face complet, consultez Gemini 4 Carbon vs Claude Fable 5.2, ainsi que le guide de l'API Claude Fable 5.2 pour le côté Anthropic.
Comment réduire votre facture Gemini 4 Carbon ?
- Utilisez Batch ou Flex pour les tâches qui peuvent attendre. Les deux coûtent moitié prix du niveau standard.
- Abaissez le niveau de réflexion. « low » pour les tours courants, « high » uniquement là où la précision en vaut la peine.
- Acheminez les tours simples vers Argon. Même prix par token, bien moins de tokens de sortie.
- Conservez un préfixe de prompt stable afin que la mise en cache implicite facture l'entrée répétée à 0,10 $ par million (puis 0,20 $).
- Terminez les gros travaux avant le 1ᵉʳ décembre, date à laquelle la même exécution coûtera deux fois plus cher.
Consignez votre coût réel Gemini 4 Carbon par requête avec Apidog CLI
Votre facture découle du nombre de tokens, et celui-ci change à chaque modification d'un prompt ou d'un niveau de réflexion. Le moyen le plus rapide d'obtenir des chiffres réels est de laisser votre agent de codage (Claude Code, Codex, Cursor) exécuter vos prompts réels via Apidog CLI et de consigner l'objet usage de chacun.
Configurez-le une seule fois :
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Placez 10 à 20 de vos prompts réels dans prompts.csv avec les colonnes prompt et thinking_level. Puis donnez à votre agent un seul prompt :
In Apidog project <projectId>, create a test case for
POST https://generativelanguage.googleapis.com/v1beta/interactions
with the x-goog-api-key header read from GEMINI_API_KEY in environment
<envId>. Send model {{model}} (default "gemini-4-carbon"), input {{prompt}}
and generation_config.thinking_level {{thinking_level}}. In a post-processor,
read usage.total_input_tokens, total_thought_tokens and total_output_tokens,
compute cost at $2/$10 and at $4/$20 per 1M, and log both. Assert status is
"completed". Run it once per row of prompts.csv and give me a table of
tokens and cost per prompt, plus the totals.
L'agent vérifie la structure de la charge utile avant d'écrire quoi que ce soit, puis exécute chaque ligne :
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case category --project <projectId>
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> \
  -d prompts.csv -r cli,json --out-file carbon-cost-{GENERATE_TIME}
Le rapport JSON conserve une trace datée des tokens par prompt. Relancez avec --env-var "model=gemini-4-argon" et vous obtiendrez les chiffres d'Argon pour les mêmes prompts : c'est la manière la plus propre de décider quel modèle mérite chaque tâche. Ajoutez -r junit et la même commande s'exécute en CI, où une assertion de coût peut faire échouer le build ; le guide Apidog CLI CI/CD présente le pipeline, et Apidog CLI dans Claude Code couvre la configuration de l'agent. Le plan Free d'Apidog couvre jusqu'à 4 utilisateurs.
Astuce : demandez à votre agent « Lis https://apidog.com/apidog-cli-installation-guide.md et configure Apidog CLI. »
FAQ
Gemini 4 Carbon est-il gratuit ? Pas via l'API : Carbon ne figure pas sur le niveau gratuit, une clé payante est donc nécessaire. Les chercheurs peuvent demander à Google six mois d'accès gratuit sur Antigravity. Notre guide Gemini 4 Carbon gratuit détaille toutes les possibilités.
Google AI Ultra inclut-il Gemini 4 Carbon ? Google indique que Carbon est en cours de déploiement pour les abonnés AI Ultra dans l'application Gemini, le mode AI de Search et Antigravity. Les appels API sont facturés séparément, au token, sur le niveau payant.
Le prix augmente-t-il pour les utilisateurs existants le 1ᵉʳ décembre ? La note de bas de page de Google ne mentionne aucune exception pour les utilisateurs existants. Budgétez 4 $ en entrée et 20 $ en sortie par million de tokens pour toute utilisation de Carbon à partir du 1ᵉʳ décembre 2026.
Gemini 4 Carbon est-il moins cher que Claude Fable 5.2 ? Par token, oui : 4 $/20 $ à partir du 1ᵉʳ décembre contre 8 $/40 $ pour Fable 5.2. Sur l'Intelligence Index d'Artificial Analysis, le coût de Carbon était de 7,76 $ contre 26,54 $ pour Fable 5.2 (max), même si Fable a obtenu un score supérieur : 65 contre 60.