Depuis le 11 novembre 2026, l’API Gemini 4 Carbon de Google utilise l’identifiant de modèle gemini-4-carbon et coûte 2 $ par million de tokens d’entrée et 10 $ par million de tokens de sortie jusqu’au 30 novembre 2026, puis 4 $ et 20 $. Google l’a rendue généralement disponible le 10 novembre 2026, uniquement sur le forfait payant de l’API Gemini.
Ce guide vous accompagne d’une clé toute nouvelle jusqu’à votre première requête, vous montre quels chiffres d’utilisation déterminent votre facture et confie les tests à votre agent de programmation.
Quel est l’identifiant du modèle Gemini 4 Carbon ?
L’identifiant du modèle Gemini 4 Carbon est gemini-4-carbon. Vous le transmettez dans le champ model d’une requête envoyée à l’endpoint Interactions de l’API Gemini, via le SDK Python ou JavaScript, ou dans un prompt de Google AI Studio. Google présente Carbon comme son modèle de raisonnement le plus puissant et le recommande pour les tâches difficiles, tandis que Gemini 4 Argon reste le choix par défaut pour le travail quotidien.
Pour en savoir plus sur le modèle lui-même, commencez par notre article sur ce qu’est Gemini 4 Carbon.
| Élément | Valeur | Source |
|---|---|---|
| Identifiant du modèle | gemini-4-carbon |
Documentation de Google AI Studio |
| Disponible depuis | Le 10 novembre 2026 | Article de lancement de Google |
| Où | Forfait payant de l’API Gemini, Google AI Studio, Android Studio | Article de lancement de Google |
| Forfait gratuit | Non disponible | Documentation de Google AI Studio |
| Fenêtre de contexte | 1 048 576 tokens, partagés entre l’entrée, le raisonnement et la sortie | Documentation de Google AI Studio |
| Sortie maximale par réponse synchrone | 65 536 tokens | Documentation de Google AI Studio |
| Décodage long | Jusqu’à 1 M de tokens moins votre entrée, avec background: true |
Documentation de Google AI Studio |
| Niveaux de raisonnement | low, medium (par défaut), high |
Documentation de Google AI Studio |
| Tarif jusqu’au 30 novembre 2026 | 2 $ en entrée, 10 $ en sortie par million de tokens | Article de lancement de Google |
| Tarif à partir du 1er décembre 2026 | 4 $ en entrée, 20 $ en sortie par million de tokens | Article de lancement de Google |
| Entrée en cache (mise en cache implicite) | 0,10 $ par million, puis 0,20 $ à partir du 1er décembre | Documentation de Google AI Studio |
Comment obtenir une clé API Gemini pour Gemini 4 Carbon ?
Carbon ne fonctionne que sur le forfait payant, donc une clé seule ne suffit pas. Il vous faut une clé sur un projet associé à la facturation Cloud :
- Ouvrez la page des clés API dans Google AI Studio. Les nouveaux utilisateurs obtiennent automatiquement un projet et une clé ; sinon, cliquez sur Create API key.
- Cliquez sur Set up billing sur la page des clés API ou des projets.
- Créez ou liez un compte de facturation Cloud, ajoutez un moyen de paiement et prépayez au moins 5 $ de crédits, conformément au guide de démarrage rapide de Google.
- Exportez la clé dans votre shell :
export GEMINI_API_KEY="YOUR_API_KEY".
L’article sur les options gratuites de Gemini 4 Carbon présente les solutions qui ne nécessitent aucune clé API.
Comment envoyer votre première requête à l’API Gemini 4 Carbon ?
Le guide de démarrage rapide de Google pour Carbon utilise l’API Interactions : un POST vers /v1beta/interactions avec model et input dans le corps de la requête. Placez le nom du modèle dans une variable pour que passer de Carbon à Argon plus tard ne nécessite qu’une modification d’une ligne.
Avec curl :
export GEMINI_MODEL="gemini-4-carbon"

curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "'"$GEMINI_MODEL"'",
    "input": "Find the race condition in this retry loop and rewrite the lock safely.",
    "generation_config": {
      "thinking_level": "medium"
    }
  }'
Avec le SDK Python (pip install -U google-genai) :
import os
from google import genai

MODEL = os.environ.get("GEMINI_MODEL", "gemini-4-carbon")

client = genai.Client()  # reads GEMINI_API_KEY from the environment

interaction = client.interactions.create(
    model=MODEL,
    input="Find the race condition in this retry loop and rewrite the lock safely.",
    generation_config={"thinking_level": "medium"},
)

print(interaction.output_text)
print(interaction.usage)
Ces deux extraits reprennent les exemples de la documentation de Google. Nous ne les avons pas exécutés pour cet article, ne disposant pas d’une clé Carbon payante sur cette machine ; vérifiez donc la structure de la réponse lors de votre premier appel.
Trois détails tirés des notes de migration de Google vous éviteront une session de débogage :
- Supprimez les paramètres d’échantillonnage.
temperature,top_pettop_ksont ignorés par Carbon : retirez-les. - Augmentez les délais d’attente. Les prompts difficiles peuvent prendre plusieurs minutes. Google recommande l’exécution en arrière-plan ou des délais d’attente HTTP d’au moins 15 minutes.
- Conservez l’état côté serveur. Transmettez
previous_interaction_idpour les conversations multi-tours et le function calling plutôt que de renvoyer tout l’historique.
Déjà sur Argon ? Notre guide de l’API Gemini 4 Argon utilise la même structure de requête.
Comment lire les tokens d’utilisation et de raisonnement dans la réponse ?
Chaque interaction renvoie un objet usage. Voici les champs qui comptent pour le coût :
total_input_tokens: ce que vous avez envoyé, y compris les instructions système et les déclarations d’outils.total_thought_tokens: les tokens que le modèle a consacrés au raisonnement avant de répondre.total_output_tokens: la réponse visible.total_tokens: la somme.
Le champ à surveiller est total_thought_tokens. Le guide de raisonnement de Google indique que la tarification d’une réponse correspond à la somme des tokens de sortie et des tokens de raisonnement, le raisonnement étant donc facturé au tarif de sortie de 10 $. Google précise également que Carbon « consacre plus de tokens de raisonnement » par tour qu’Argon pour explorer et vérifier son travail. Sur un prompt difficile, le raisonnement peut représenter l’essentiel de la facture.
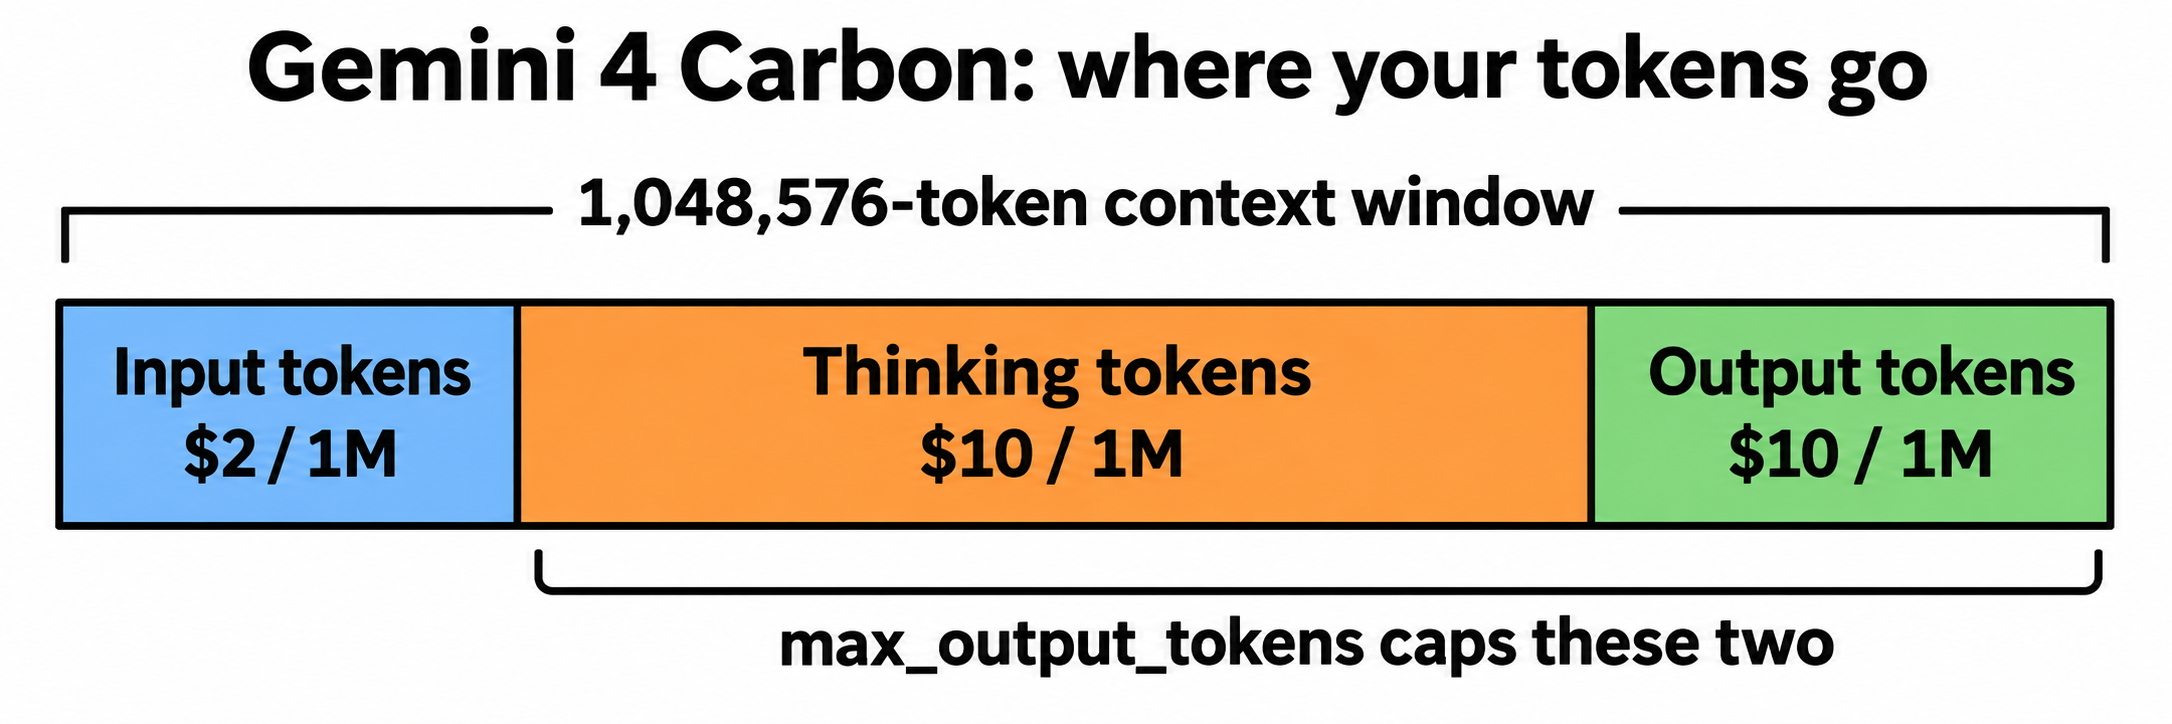
max_output_tokens plafonne le raisonnement et la sortie combinés. S’il est trop bas, Carbon peut épuiser ce budget en raisonnement et tronquer la réponse. Voici les points de départ recommandés par Google :
- Tâches standard : conservez la valeur par défaut de 65 536.
- Applications limitées à moins de 32 K : augmentez à au moins 32 768.
- Raisonnement complexe et codage : définissez
background: trueet 131 072 ou 262 144 tokens.
Avec background: true, les serveurs de Google poursuivent la réponse par tranches de 64 K tokens. Vous interrogez l’interaction jusqu’à ce que son statut quitte in_progress ou queued, puis vous concaténez le texte de chaque étape model_output.
Quel niveau de raisonnement Gemini 4 Carbon choisir ?
Le niveau de raisonnement est votre principal levier sur la qualité, la latence et les dépenses. D’après les recommandations de Google, dans le guide de raisonnement et la documentation de Carbon :
| Niveau de raisonnement | Consommation de tokens | À utiliser pour |
|---|---|---|
low |
Le moins de tokens, la latence la plus faible | Tâches simples et sensibles aux coûts, analyses légères et rédaction |
medium (par défaut) |
Équilibré | La plupart des tâches, y compris le code complexe et le travail d’agents |
high |
Le plus de tokens, le premier token le plus lent | Mathématiques et sciences difficiles, code ou tâches d’agents les plus complexes |
Google recommande d’exécuter vos évaluations aux trois niveaux et de conserver le plus bas qui atteint votre seuil de qualité. Sur Carbon, l’écart entre low et high correspond à l’endroit où part votre budget.
Quand confier une tâche à Gemini 4 Carbon plutôt qu’à Argon ?
Google est explicite à ce sujet : « Argon reste le choix idéal pour la majorité du travail d’ingénierie logicielle et de traitement du savoir. » Les deux modèles partagent la fenêtre de contexte de 1 M de tokens, les outils intégrés et le même tarif promotionnel par token ; la différence réside dans le nombre de tokens que chacun consomme par tour. Utilisez Carbon pour le débogage complexe de causes racines, la conception d’architecture, la synthèse multimodale dense, les démonstrations mathématiques et les audits de sécurité. Gardez Argon pour le codage interactif, les fonctionnalités quotidiennes et les boucles de production rapides. Notre comparaison Gemini 4 Carbon vs Argon approfondit le sujet, et si vous hésitez entre Carbon et le dernier modèle d’Anthropic, consultez Gemini 4 Carbon vs Claude Fable 5.2 ainsi que le guide de l’API Claude Fable 5.2.
Combien coûte un appel à l’API Gemini 4 Carbon ?
Gemini 4 Carbon coûte 2 $ par million de tokens d’entrée et 10 $ par million de tokens de sortie (raisonnement inclus) jusqu’au 30 novembre 2026, puis 4 $ et 20 $, selon Google.
Pour illustrer sur un appel, prenons une requête type avec 2 000 tokens d’entrée, 6 000 tokens de raisonnement et 1 500 tokens de sortie. Il s’agit de chiffres d’exemple, pas d’une mesure réelle :
- Entrée : 2 000 × 2 $ / 1 M = 0,004 $
- Raisonnement plus sortie : 7 500 × 10 $ / 1 M = 0,075 $
- Total : environ 0,079 $ aujourd’hui, environ 0,158 $ à partir du 1er décembre
Le raisonnement varie considérablement selon le prompt : lisez donc votre propre objet usage. Pour le calcul complet des tarifs, le saut de décembre et le coût par tâche, consultez la tarification de Gemini 4 Carbon.
Laissez votre agent de programmation tester l’API Carbon avec Apidog CLI
Vous allez modifier les niveaux de raisonnement, les limites de sortie et les prompts de nombreuses fois. Plutôt que d’inspecter le JSON à chaque changement, laissez votre agent de programmation (Claude Code, Codex, Cursor) écrire un test répétable et l’exécuter avec Apidog CLI.
Configuration en une fois :
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Donnez ensuite un seul prompt à votre agent :
In Apidog project <projectId>, add an endpoint for
POST https://generativelanguage.googleapis.com/v1beta/interactions
with the x-goog-api-key header read from the GEMINI_API_KEY variable in
environment <envId>. Create a test case that sends model "gemini-4-carbon",
a short prompt and thinking_level "low", and asserts: HTTP 200, status is
"completed", usage.total_thought_tokens exists, and usage.total_tokens is
below 20000. Run it and summarize any failures.
Utiliser low dans le test permet de garder chaque exécution à bas coût. L’agent lit les schémas, valide ses charges utiles et exécute le cas de test :
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog test-case category --project <projectId>
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
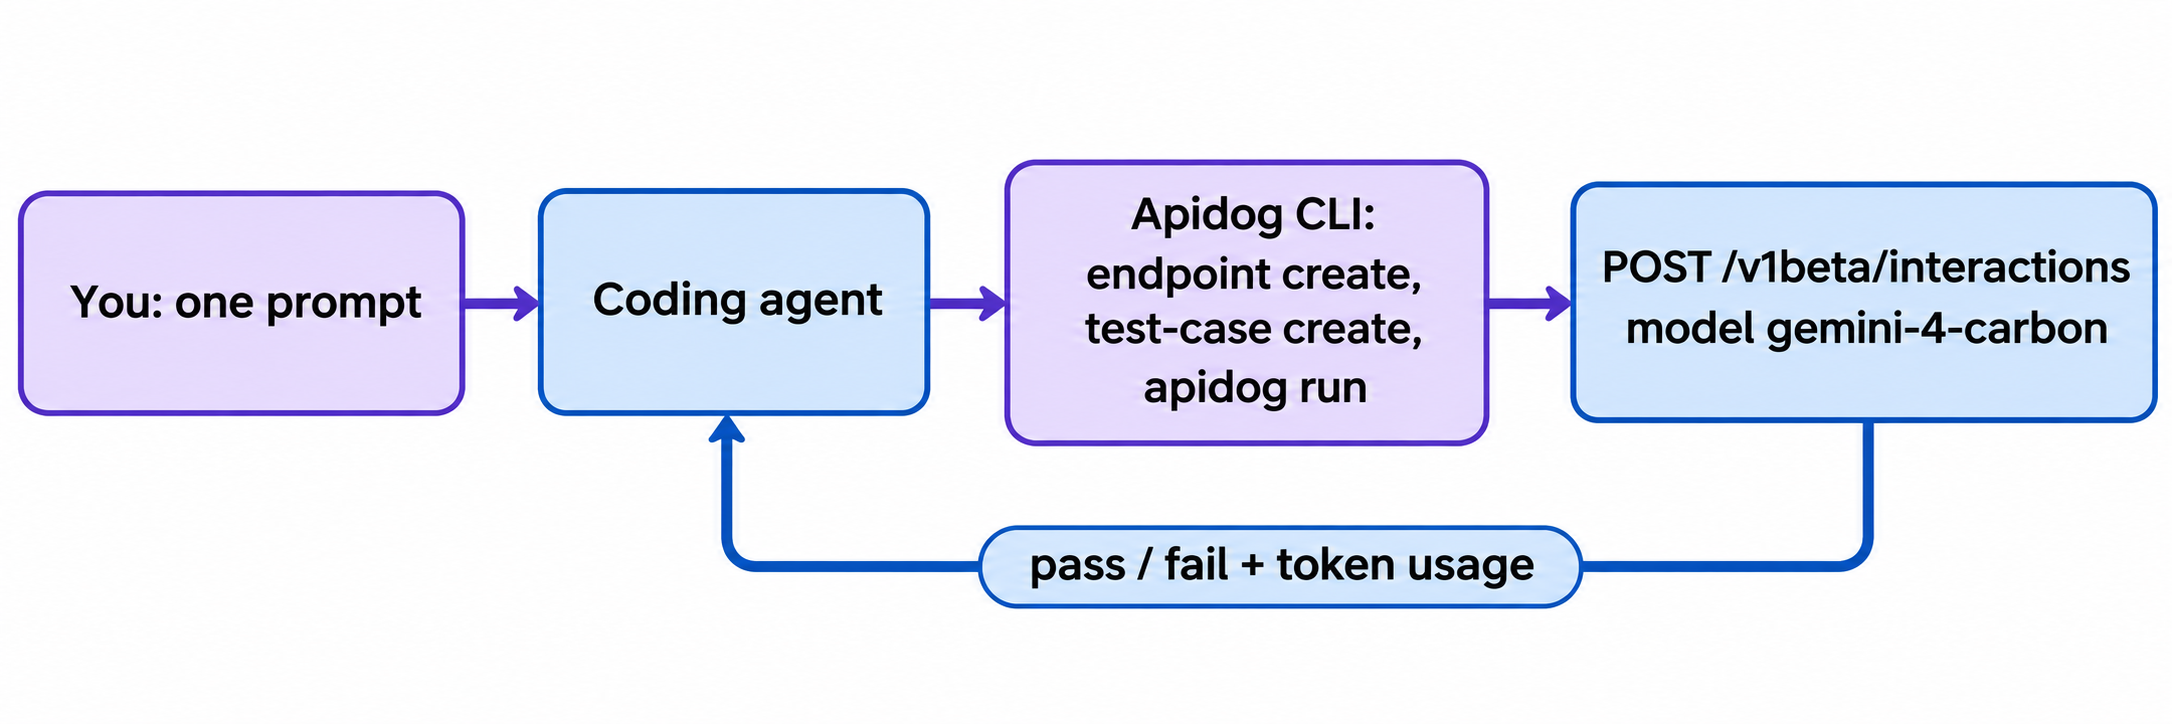
L’assertion sur le budget de tokens est la plus utile. Si un changement de prompt fait dépasser la limite de raisonnement, le test échoue avant que la facture n’augmente. Remplacez -r cli,json par -r junit et la même commande s’exécute en CI ; le guide CI/CD d’Apidog CLI présente le pipeline, et Apidog CLI dans Claude Code détaille la configuration de l’agent. Le forfait gratuit d’Apidog couvre jusqu’à 4 utilisateurs.
Si vous souhaitez que l’agent fasse toute la configuration à partir de zéro, indiquez-lui : « Lis https://apidog.com/apidog-cli-installation-guide.md et configure Apidog CLI. »
FAQ
L’API Gemini 4 Carbon est-elle gratuite ? Non. La documentation de Google indique que Gemini 4 Carbon n’est pas disponible sur le forfait gratuit de l’API Gemini. Vous avez besoin d’un projet sur le forfait payant avec la facturation Cloud et au moins 5 $ de crédits prépayés. Côté grand public, Google déploie Carbon auprès des abonnés Google AI Ultra dans l’application Gemini, le mode AI et Antigravity.
Gemini 4 Carbon est-il disponible sur Vertex AI ? L’article de lancement de Google mentionne l’API Gemini, Google AI Studio, Android Studio, Gemini pour les entreprises, Antigravity et CodeMender. Vertex AI n’y figure pas : vérifiez donc la liste des modèles de Google Cloud avant de bâtir vos plans dessus.
Quelle est la fenêtre de contexte de Gemini 4 Carbon ? 1 048 576 tokens, partagés entre l’entrée, le raisonnement et la sortie. Une réponse synchrone s’arrête à 65 536 tokens ; avec l’exécution en arrière-plan, une réponse peut atteindre 1 M de tokens moins votre entrée.
Puis-je utiliser generateContent au lieu de l’API Interactions ? Le guide de démarrage rapide de Carbon utilise l’API Interactions, et la documentation mentionne l’API GenerateContent pour la continuation du décodage long côté client. Si votre application utilise déjà generateContent, testez le remplacement de l’identifiant de modèle à cet endroit avant de migrer.
Comment passer de Gemini 4 Argon à Carbon ? Changez la chaîne du modèle de gemini-4-argon à gemini-4-carbon. Google indique qu’aucune modification du schéma de requête n’est nécessaire. Augmentez max_output_tokens et vos délais d’attente HTTP, car Carbon raisonne plus longtemps, et conservez thinking_level à medium sauf si une tâche exige high.