
Gemini 4 Argon coûte 2 $ par million de jetons d'entrée et 10 $ par million de jetons de sortie pendant une période de lancement, puis 4 $ et 20 $. L'entrée en cache bénéficie d'une réduction de 95 % sur le prix d'entrée, ce qui représente 0,10 $ par million de jetons au taux de lancement et 0,20 $ après. Google n'a pas précisé la durée de la période de lancement, et Argon n'est pas encore disponible à l'achat : il est annoncé mais non généralement disponible, et aujourd'hui, il est déployé uniquement pour les cyberdéfenseurs du programme Fairwind.
bouton
Cet article transforme cette grille tarifaire en chiffres budgétaires : une comparaison avec sept modèles actuels, quatre scénarios concrets, le coût par tâche d'un tiers, et les contrôles de coûts à mettre en place dès maintenant. Pour le modèle lui-même, commencez par ce qu'est Gemini 4 Argon ; pour y accéder, consultez Gemini 4 Argon est-il gratuit. Vous pouvez créer des assertions de coût dans Apidog pour un modèle que vous pouvez appeler aujourd'hui et échanger le nom du modèle plus tard.
La grille tarifaire
Google a publié les prix dans l'annonce de lancement de Gemini 4 Argon, avec le tarif post-lancement dans la note de bas de page 1 : "Après l'expiration de la période de lancement, le prix de 4 $ par million de jetons d'entrée et 20 $ par million de jetons de sortie s'appliquera."
| Gemini 4 Argon, par million de jetons | Lancement | Standard (après lancement) |
|---|---|---|
| Entrée | 2,00 $ | 4,00 $ |
| Entrée en cache (95 % de réduction sur l'entrée) | 0,10 $ | 0,20 $ |
| Sortie | 10,00 $ | 20,00 $ |
| Sortie maximale par réponse (Google) | 1M de jetons | 1M de jetons |
| Coût d'une sortie complète de 1M de jetons | 10,00 $ | 20,00 $ |
Les tarifs en cache sont calculés arithmétiquement à partir de la règle des 95 % de Google (2 $ x 0,05 et 4 $ x 0,05). Google n'a pas publié de fenêtre de contexte d'entrée ni d'identifiant de modèle. Il indique que la limite de sortie est de 1M de jetons, "contre 64K jetons précédemment" ; au moins un évaluateur tiers, Vals AI, liste une sortie maximale de 262K pour la configuration qu'il a testée.
Argon vs les modèles de pointe actuels et Gemini
Tous les prix sont par million de jetons.
| Modèle | Entrée | Entrée en cache | Sortie | Sortie maximale |
|---|---|---|---|---|
| Gemini 4 Argon (lancement) | 2 $ | 0,10 $ | 10 $ | 1M |
| Gemini 4 Argon (standard) | 4 $ | 0,20 $ | 20 $ | 1M |
| GPT-6 Astra | 10 $ | 1 $ | 50 $ | 128 000 |
| Claude Opus 5.5 | 4 $ | 0,20 $ | 20 $ | 128K (300K sur Batch, bêta) |
| Claude Sonnet 5.5 | 2 $ | 0,20 $ | 10 $ | 128K (300K sur Batch, bêta) |
| GPT-6.1 Sol | 2 $ | 0,10 $ | 10 $ | 128 000 |
| Claude Fable 5.1 | 10 $ | 0,25 $ | 50 $ | 128K |
| gemini-3.1-pro-preview (invite <=200K / >200K) | 2 $ / 4 $ | 0,20 $ / 0,40 $ | 12 $ / 18 $ | 65 536 |
| gemini-3.8-flash (lancement / à partir du 01-01-2027) | 0,75 $ / 1,50 $ | 0,075 $ / 0,15 $ | 3,75 $ / 7,50 $ | 65 536 |
Les prix des concurrents proviennent des pages des fournisseurs eux-mêmes : page GPT-6 Astra d'OpenAI, page de tarification d'Anthropic et page de tarification de l'API Gemini de Google.
- Argon Standard = Claude Opus 5.5. Mêmes 4 $/20 $, même entrée en cache de 0,20 $.
- Argon de lancement = Claude Sonnet 5.5 et GPT-6.1 Sol. Mêmes 2 $/10 $ ; le taux d'entrée en cache de 0,10 $ correspond à GPT-6.1 Sol.
- GPT-6 Astra et Claude Fable 5.1 coûtent 5 fois le prix d'Argon de lancement et 2,5 fois le prix d'Argon standard. Voir la tarification de Claude Fable 5.1.
- La sortie d'Argon de lancement (10 $) est inférieure à celle de gemini-3.1-pro-preview (12 $), le précédent modèle Pro de pointe de Google.
- Les invites longues modifient les calculs. OpenAI facture les invites de plus de 272K jetons d'entrée à 2x le prix d'entrée et de cache et 1,5x le prix de sortie pour la requête complète. Gemini 3.1 Pro facture plus au-dessus de 200K ; Anthropic ne le fait pas. Google n'a pas dit si Argon avait un palier pour les invites longues.
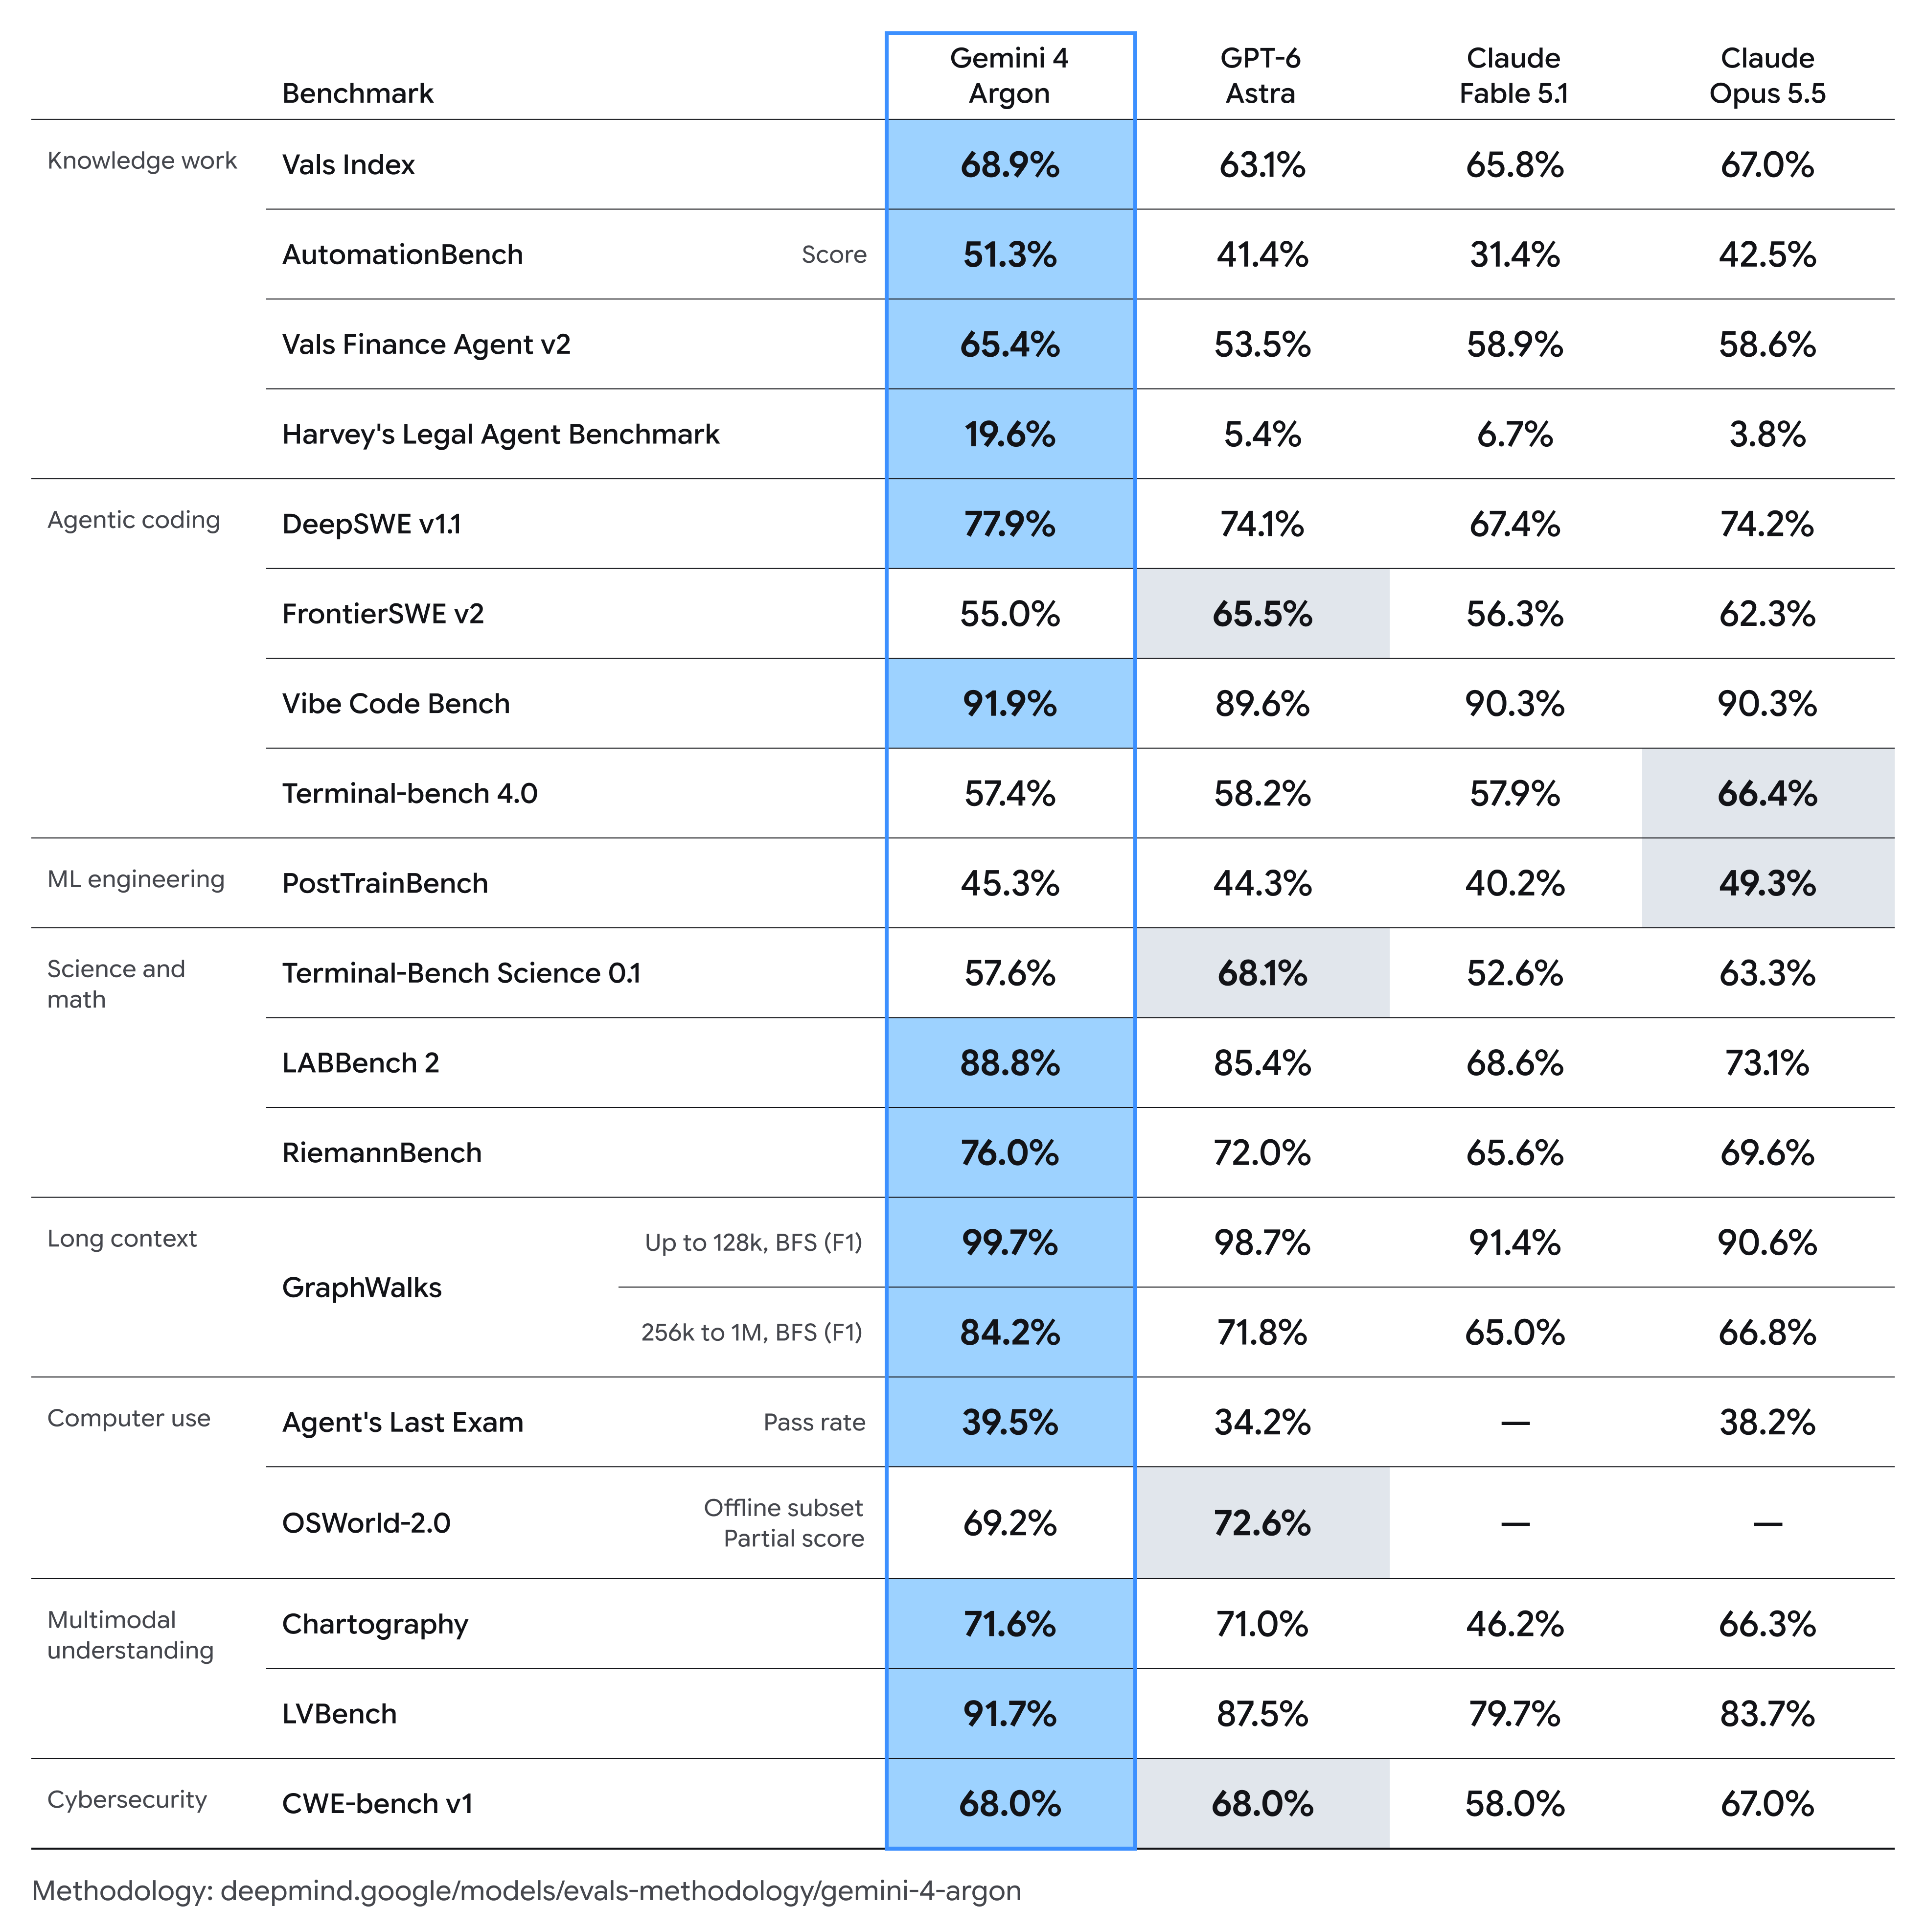
Pour les capacités et les prix, consultez Gemini 4 Argon vs GPT-6 Astra vs Claude Opus 5.5.
Les jetons de réflexion sont facturés comme des jetons de sortie
Sur les modèles Gemini actuels, les jetons de réflexion sont facturés comme des jetons de sortie : la documentation de Google sur la réflexion indique que "la tarification de la réponse est la somme des jetons de sortie et des jetons de réflexion". Google n'a pas spécifiquement documenté Argon, mais il faut prévoir la même règle. Google a effectué les évaluations d'Argon "avec les paramètres de réflexion les plus élevés", il faut donc lire "10 $ par million de jetons de sortie" comme la réponse plus le raisonnement.
Quatre scénarios concrets
Chaque chiffre ci-dessous correspond aux jetons divisés par 1M, multipliés par le taux par 1M. Les scénarios 1 à 3 supposent l'absence de mise en cache.
1. Un appel API typique : 20K en entrée, 5K en sortie
- Lancement : 20 000 / 1M x 2 $ = 0,04 $ en entrée, plus 5 000 / 1M x 10 $ = 0,05 $ en sortie. Total 0,09 $.
- Standard : 0,08 $ + 0,10 $ = 0,18 $.
À 1 000 appels par jour, cela représente 90 $ au lancement ou 180 $ en standard. Le même appel coûte 0,18 $ sur Claude Opus 5.5, 0,45 $ sur GPT-6 Astra (0,20 $ + 0,25 $), 0,10 $ sur gemini-3.1-pro-preview (0,04 $ + 0,06 $), et environ 0,034 $ sur gemini-3.8-flash à son taux de lancement (0,015 $ + 0,019 $).
2. Une longue interaction d'agent : 200K en entrée, 50K en sortie
- Lancement : 200 000 / 1M x 2 $ = 0,40 $, plus 50 000 / 1M x 10 $ = 0,50 $. Total 0,90 $.
- Standard : 0,80 $ + 1,00 $ = 1,80 $.
GPT-6 Astra facturerait 4,50 $ (2,00 $ + 2,50 $). gemini-3.1-pro-preview facture 1,00 $ (0,40 $ + 0,60 $), mais 200K est sa limite de palier : les invites plus longues sont facturées 4 $/18 $. Si Argon obtient un palier similaire, les interactions plus longues coûteront plus cher.
3. Une réponse maximisée : 1M de jetons de sortie
La sortie seule coûte 1 000 000 / 1M x 10 $ = 10,00 $ au lancement et 20,00 $ en standard. Ajoutez une invite de 100K jetons (0,20 $ au lancement, 0,40 $ en standard) et l'appel coûte 10,20 $ ou 20,40 $.
Aucun autre modèle du tableau ne produit cela en une seule réponse synchrone : les concurrents plafonnent à 128K, l'ancien Gemini Pro à 65 536. À la sortie maximale de 262K répertoriée par Vals, une réponse complète coûte environ 2,62 $ au lancement ou 5,24 $ en standard. Les aspects techniques (délais d'attente, streaming, passerelles) sont détaillés dans les 1M de jetons de sortie de Gemini 4 Argon.
4. Une invite de 500K jetons mise en cache et réutilisée 10 fois
Supposons que vous envoyiez le même code ou ensemble de contrats de 500K jetons dix fois, avec 5K jetons de sortie à chaque fois. Supposons que le premier appel paie le prix d'entrée complet pour construire le cache et que les neuf suivants le lisent.
| 10 appels, invite de 500K, 5K de sortie chacun | Lancement | Standard |
|---|---|---|
| Entrée, sans mise en cache (10 x 500K) | 10,00 $ | 20,00 $ |
| Entrée, en cache (1 complet + 9 en cache) | 1,00 $ + 9 x 0,05 $ = 1,45 $ | 2,00 $ + 9 x 0,10 $ = 2,90 $ |
| Sortie (10 x 5K) | 0,50 $ | 1,00 $ |
| Total avec mise en cache | 1,95 $ | 3,90 $ |
| Total sans mise en cache | 10,50 $ | 21,00 $ |
La mise en cache réduit la facture d'entrée de 85,5 %. Deux mises en garde : Google n'a pas dit si Argon facture le stockage en cache (gemini-3.1-pro-preview facture 4,50 $ par million de jetons par heure, ce qui ajouterait 2,25 $ pour conserver 500K jetons pendant une heure), et une invite de 500K dépasse la limite de 200K de 3.1 Pro. Le taux en cache standard d'Argon correspond à 0,20 $ d'Opus 5.5, donc la logique de rentabilité de Claude Opus 5.5 prompt caching cost math s'applique.
Le prix par jeton n'est pas le coût par tâche
Artificial Analysis indique un coût de 1,99 $ par tâche pour exécuter son Intelligence Index sur Gemini 4 Argon (High) aux prix de lancement ; The Decoder estime le même coût à 3,98 $ aux prix standards. AA attribue à Argon un score de 53, le même que GPT-6 Astra (max), qu'il liste à 3,26 $ par tâche.
Le piège est le volume de jetons. AA compte environ 62K jetons de sortie par tâche pour Argon (élevé) contre environ 27K pour Astra à son réglage maximal, soit environ 2,3x. La sortie par tâche au lancement : 62 000 / 1M x 10 $ = 0,62 $, contre 27 000 / 1M x 50 $ = 1,35 $ pour Astra. En standard, le chiffre de tâche complète de The Decoder pour Argon (3,98 $) dépasse celui d'AA pour Astra (max) (3,26 $), même si les tarifs standard d'Argon sont 60 % inférieurs à ceux d'Astra.
Vals AI montre le même schéma. Il indique 15,68 $ par test pour Argon sur le Vals Index, contre 32,14 $ pour Claude Opus 5.5, 21,34 $ pour Claude Sonnet 5.5, et 3,24 $ pour GPT-6.1 Sol, et il liste Argon au tarif standard de 4 $/20 $. Sonnet 5.5 et GPT-6.1 Sol partagent le prix de lancement d'Argon sur le papier, pourtant leurs coûts par test sont séparés par plus de 6x.
Budgétisez à partir de vos propres comptes de jetons, et non de la grille tarifaire.
Contrôles de coûts à mettre en place avant la sortie d'Argon
- Plafonner la sortie. Sur generateContent,
generationConfig.maxOutputTokensdéfinit un plafond. Google indique que les nouveaux modèles sont lancés sur l'API Interactions, donc définissez le plafond équivalent une fois que la documentation le listera pour Argon. Un plafond de 1M représente un plafond de sortie de 20 $ par appel aux tarifs standards. - Mettre en cache le contenu stable. Les instructions système, les schémas et les documents de référence qui se répètent entre les appels sont là où la réduction de 95 % est payante.
- Choisir délibérément le niveau de réflexion. Google n'a pas publié les niveaux d'Argon. Actuellement, gemini-3.1-pro-preview est par défaut sur
highet gemini-3.8-flash surmedium. Lorsque ceux d'Argon seront documentés, testez si un niveau inférieur maintient la qualité de votre tâche. - Vérifier l'utilisation. Chaque réponse generateContent se termine par
usageMetadata. Dans Apidog, enregistrez la requête avec le modèle dans une variable d'environnementGEMINI_MODEL, ajoutez une assertion post-réponse qui calcule le coût à partir du nombre de jetons dansusageMetadata, et faites échouer le test lorsqu'un appel dépasse votre plafond. Exécutez-le contre gemini-3.8-flash aujourd'hui ; lorsque l'ID d'Argon sera livré, changez une variable et relancez la suite.
L'arithmétique pour cette assertion :
cost = uncached_input / 1,000,000 x input_rate
     + cached_input   / 1,000,000 x cached_rate
     + (output + thinking) / 1,000,000 x output_rate
Ce que Google n'a pas encore tarifé
La durée de la période de lancement et la date de début des tarifs à 4 $/20 $ ; si les invites de plus de 200K coûtent plus cher ; la tarification Batch ou Flex (3.1 Pro a les deux, à 1 $/2 $ en entrée et 6 $/9 $ en sortie) ; les frais de stockage en cache ; les limites de débit ; et s'il existe un niveau gratuit.
FAQ
Combien coûte Gemini 4 Argon par million de jetons ? 2 $ en entrée et 10 $ en sortie pendant la période de lancement, puis 4 $ et 20 $. L'entrée en cache bénéficie d'une réduction de 95 % : 0,10 $, puis 0,20 $.
Combien de temps dure le prix de lancement ? Google ne l'a pas dit. L'annonce de lancement ne donne ni date de fin ni durée.
Les jetons de réflexion sont-ils facturés comme des jetons de sortie ? Sur les modèles Gemini actuels, oui. Google n'a pas spécifiquement documenté les règles d'Argon.
Combien coûte une réponse de sortie de 1M de jetons ? 10 $ au prix de lancement et 20 $ en standard, avant l'entrée.
Argon est-il moins cher que Claude Opus 5.5 ou GPT-6 Astra ? Par jeton, Argon standard équivaut à Opus 5.5 et se situe 60 % en dessous d'Astra. Par tâche, cela dépend du volume de jetons : Artificial Analysis a mesuré qu'Argon utilisait environ 2,3 fois plus de jetons de sortie qu'Astra. Pour un Gemini moins cher aujourd'hui, consultez la tarification de Gemini 3.8 Flash.
Puis-je payer pour Argon aujourd'hui ? Non. Il est déployé uniquement pour les partenaires du programme Fairwind. Les clients API payants et les abonnés Google AI Ultra viendront ensuite, sans date précisée.
Budgétisez-le maintenant, mesurez-le plus tard
Multipliez le nombre de jetons de votre trafic actuel par 2 $/10 $ et 4 $/20 $, et vous obtiendrez la fourchette de prix de lancement et standard d'Argon. Ensuite, mettez en place la mesure : téléchargez Apidog, enregistrez votre requête contre gemini-3.8-flash avec GEMINI_MODEL comme variable, et ajoutez une assertion de coût sur usageMetadata. Lorsque Google publiera l'ID du modèle, vous échangerez une valeur et verrez votre coût réel par appel dès le premier jour.