
Il n'existe pas encore d'API publique Gemini 4 Argon, et Google n'a pas publié d'ID de modèle. Google a annoncé Argon le 30 septembre 2026, et il n'est disponible aujourd'hui que pour les défenseurs du programme Fairwind : un ensemble de partenaires Fairwind l'utilisent comme un modèle géré sur Gemini Enterprise. Artificial Analysis répertorie Google AI Studio comme le seul fournisseur d'API d'Argon, mais sans données de vitesse ou de latence, ce qui correspond à un accès pré-commercialisé sur liste blanche plutôt qu'à un point d'accès auquel on peut s'inscrire. Lorsque le déploiement plus large commencera, Google indique qu'il débutera "avec les clients API payants et les abonnés Google AI Ultra", donc une clé API Gemini payante vous place en première ligne.
Cet écart entre l'annonce et l'accès est un temps que vous pouvez utiliser. Ce guide sépare ce que Google a confirmé à propos de l'API Argon de ce qu'il n'a pas confirmé, puis vous présente du code que vous pouvez exécuter aujourd'hui sur Gemini 3.8 Flash afin que le passage à Argon ne soit qu'un changement de variable. Vous construirez la requête, configurerez une alerte de mise en service, simulerez la réponse dans Apidog, et ajouterez un plafond de coût aux prix d'Argon. Pour le modèle lui-même, commencez par ce qu'est Gemini 4 Argon ; pour les étapes de déploiement, consultez le guide de la date de sortie de Gemini 4 Argon.
Ce qui est confirmé à propos de l'API Gemini 4 Argon et ce qui ne l'est pas
Le billet de lancement de Google donne les prix et une limite de sortie. Presque tout le reste dont une intégration a besoin n'est pas encore publié.
| Élément | Statut | Détail |
|---|---|---|
| Prix d'entrée | Confirmé | 2 $ par 1M de jetons (introduction), 4 $ après la période d'introduction |
| Prix de sortie | Confirmé | 10 $ par 1M de jetons (introduction), 20 $ après |
| Entrée en cache | Confirmé | 95 % de réduction sur l'entrée : 0,10 $ intro, 0,20 $ standard |
| Limite de sortie | Confirmé | 1M de jetons, contre 64K |
| Surface d'API | Signalé | Les documents de Google indiquent que tous les nouveaux modèles sont lancés sur l'API Interactions |
| ID de modèle | Non publié | Absent de la page des modèles, de la page des prix et du journal des modifications |
| Fenêtre de contexte d'entrée | Non publié | L'évaluation de Google pour le contexte long a utilisé des invites allant jusqu'à 1M de jetons, mais ce n'est pas une spécification |
| Niveaux de réflexion | Non publié | Les évaluations ont été exécutées avec les "paramètres de réflexion les plus élevés" ; les noms et les valeurs par défaut sont inconnus |
| Limites de débit | Non publié | Aucun palier annoncé |
| Prise en charge des lots | Non publié | Pas de prix pour les lots ou Flex |
| Palier d'invite longue | Non publié | 3.1 Pro facture plus cher au-delà de 200K ; la règle d'Argon n'est pas précisée |
| Durée de la période d'introduction | Non publié | Pas de date de fin pour 2 $/10 $ |
Deux lignes méritent un examen plus approfondi. La ligne de la surface d'API provient des documents de l'API Interactions, qui indiquent que les nouveaux modèles "seront lancés sur l'API Interactions". Argon est un nouveau modèle, attendez-vous donc à le voir d'abord ici ; Google n'a pas dit si generateContent le servira. La ligne de sortie est la limite déclarée par Google pour le modèle, mais Vals AI répertorie une sortie maximale de 262K pour la configuration qu'il a testée, ne supposez donc pas que chaque point de terminaison sert le million complet dès le premier jour. Notre guide sur les 1M de jetons de sortie couvre ce que cette limite fait au streaming, aux délais d'attente et au stockage.
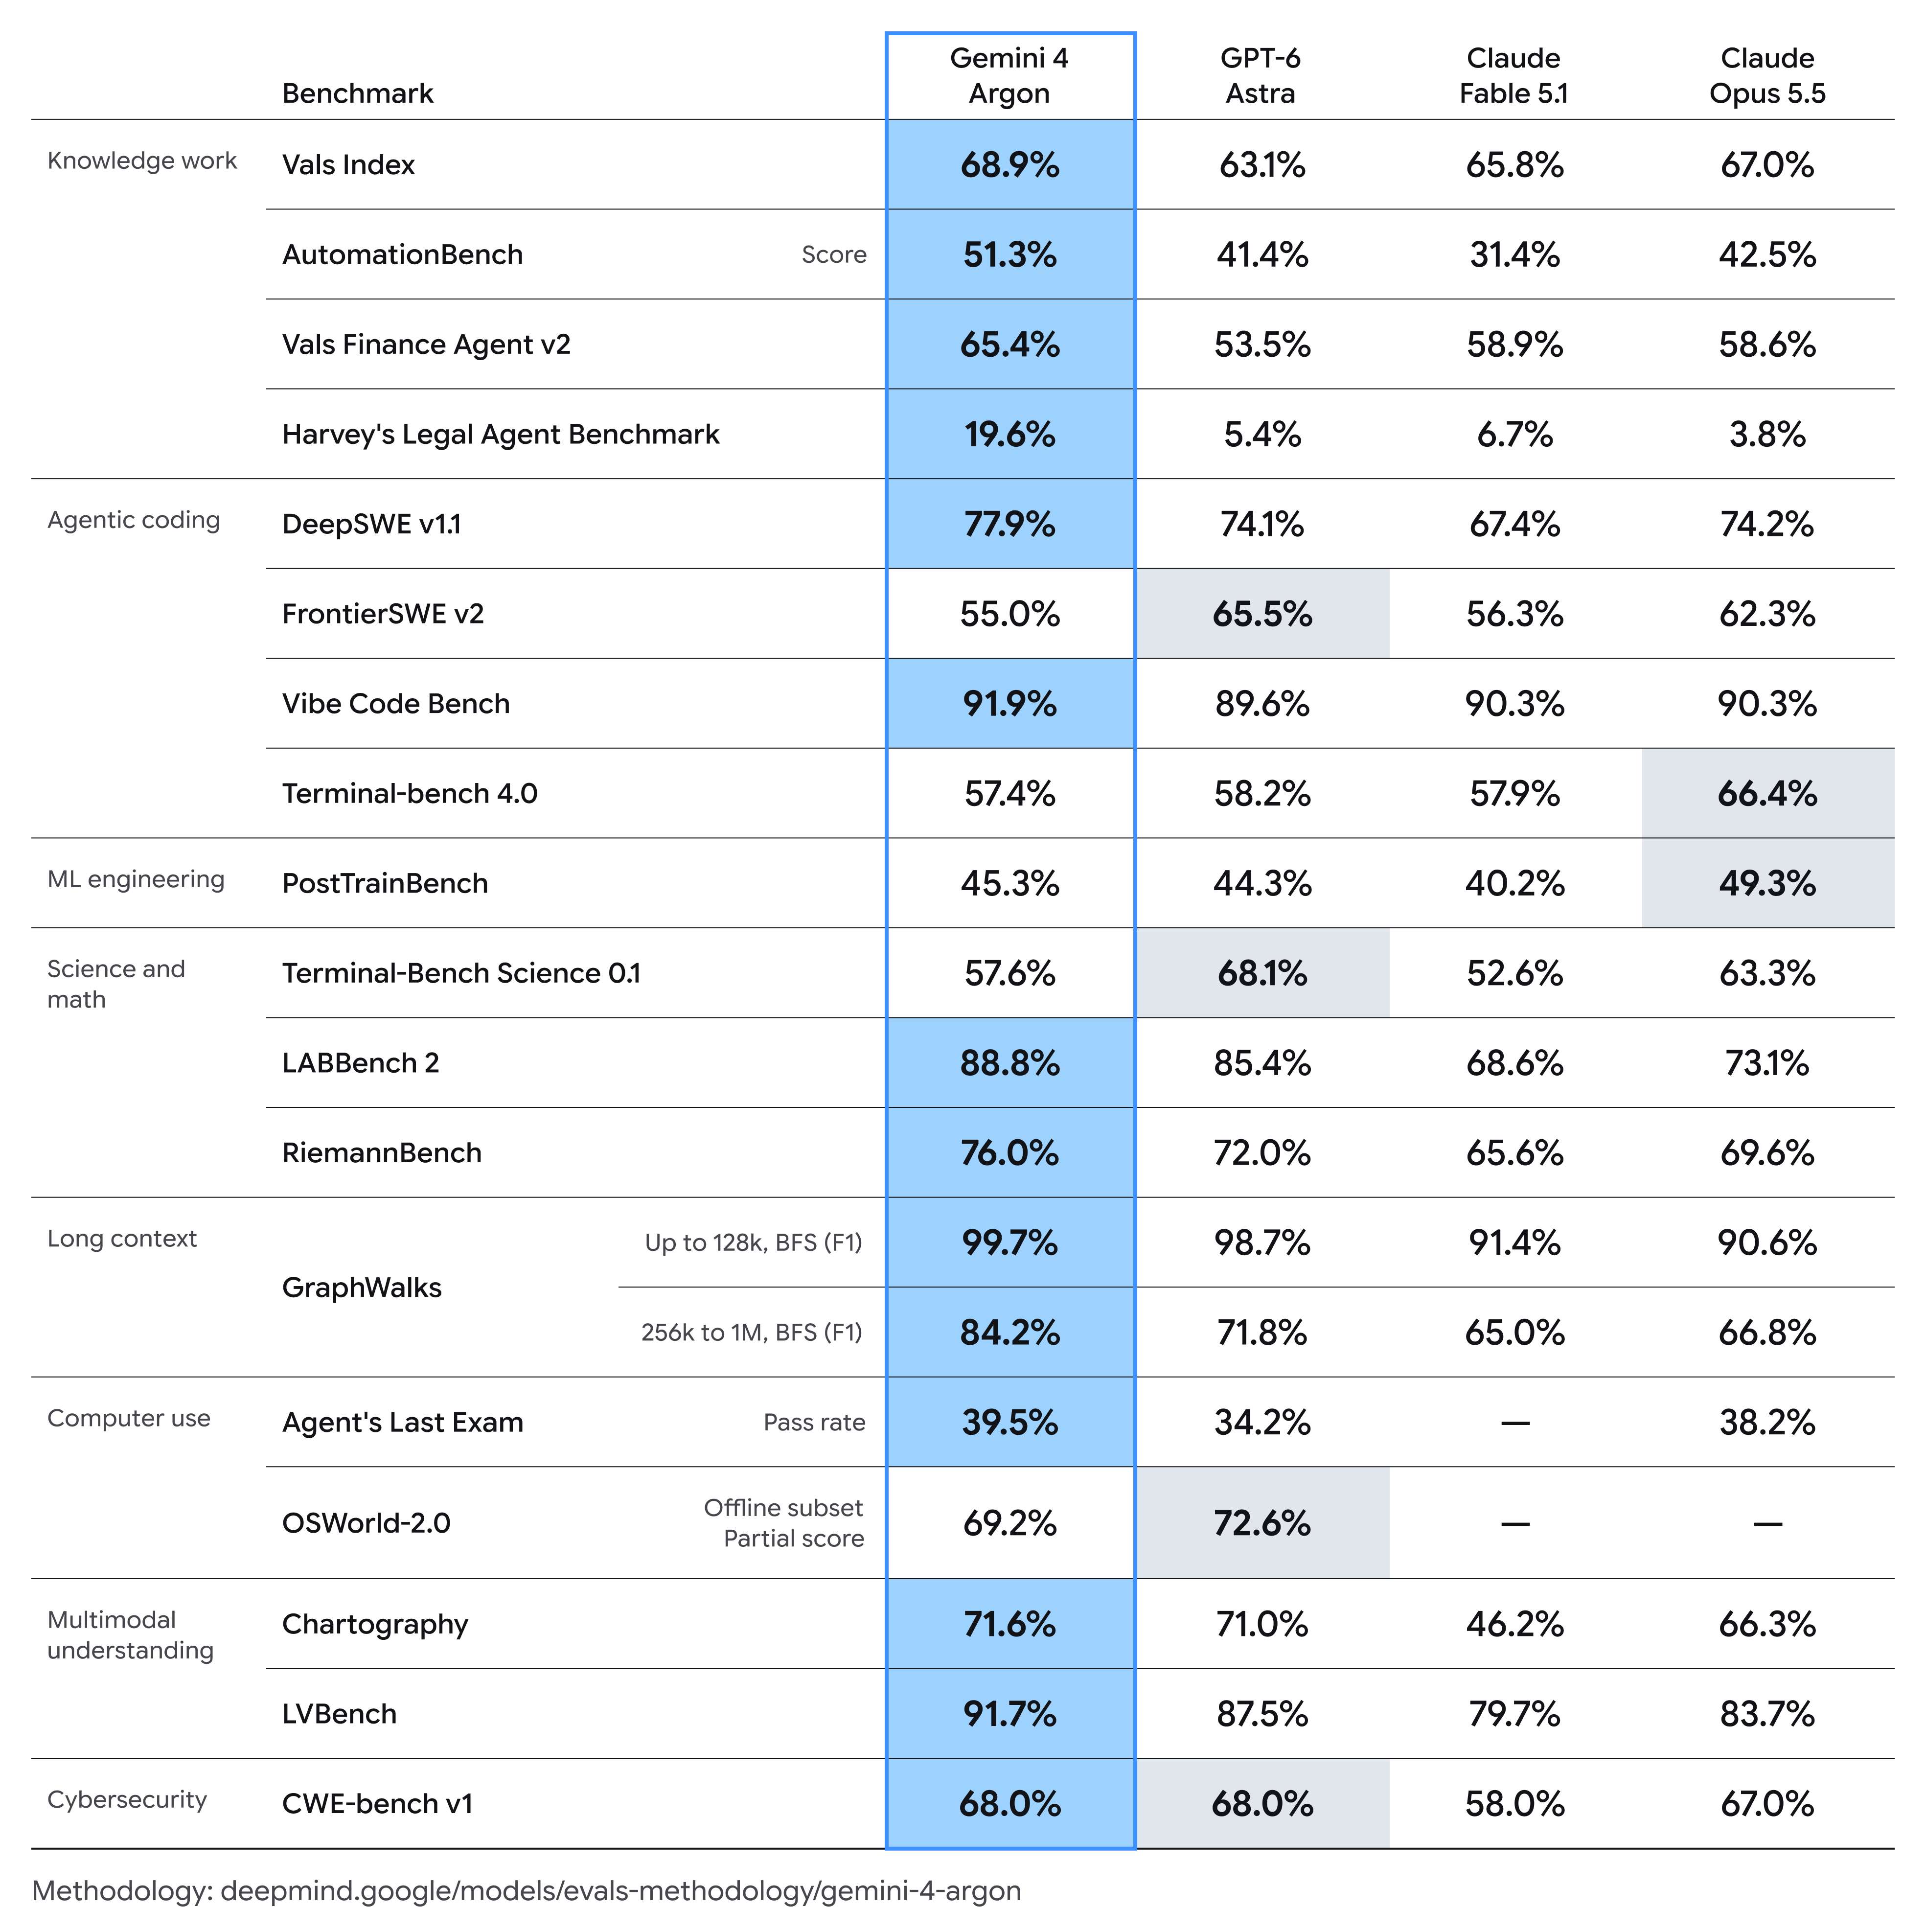
Concernant le prix, un paragraphe suffit ici. Une requête avec une invite de 20 000 jetons et 5 000 jetons de sortie coûte 20 000 x 2 $/1M + 5 000 x 10 $/1M = 0,04 $ + 0,05 $ = 0,09 $ aux taux d'introduction, et 0,18 $ aux taux standard de 4 $/20 $. Le prix de sortie d'introduction d'Argon (10 $) est inférieur à celui de Gemini 3.1 Pro Preview (12 $), et son prix standard correspond exactement à Claude Opus 5.5. La ventilation des prix de Gemini 4 Argon présente tous les scénarios, y compris l'entrée en cache et une réponse maximale de 1M de jetons.
Ne codez pas en dur un ID de modèle trouvé en ligne
Cherchez l'ID du modèle Argon et vous trouverez des chaînes sur des sites de benchmark, des agrégateurs et des requêtes de tirage (pull requests) open-source. Ce sont des espaces réservés. Vals AI utilise son propre slug pour sa page de modèle, une requête de tirage GitHub ajoute un ID "à titre provisoire", et le chemin de style OpenRouter mène à une page introuvable. Google n'a confirmé aucun d'entre eux, et plusieurs sources mettent explicitement en garde contre le codage en dur d'une supposition.
Un ID deviné échoue de la manière la moins utile : une erreur 404 en production le jour du déploiement, ou un repli silencieux si votre wrapper gère les erreurs de manière trop large. Gardez plutôt le nom du modèle dans la configuration. Dans chaque exemple ci-dessous, le modèle provient d'une variable d'environnement `GEMINI_MODEL` qui par défaut est `gemini-3.8-flash`, un modèle stable que vous pouvez appeler aujourd'hui. Lorsque Google publiera l'ID d'Argon, vous ne changerez qu'une seule valeur.
Préparez votre code sur Gemini 3.8 Flash
Gemini 3.8 Flash (`gemini-3.8-flash`) fonctionne sur les mêmes points de terminaison, en-têtes et formes de réponse qu'Argon devrait utiliser, à 0,75 $/3,75 $ par 1M de jetons jusqu'au 31 décembre 2026. Votre clé se trouve dans `GEMINI_API_KEY` ; ne la collez jamais dans le code. La configuration complète est expliquée dans notre guide de l'API Gemini 3.8 Flash.
Étape 1 : Envoyer une requête à l'API Interactions
L'API Interactions est l'API principale de Google, disponible en version générale depuis juin 2026. Gardez le modèle et le niveau de réflexion dans des variables, car les noms des niveaux d'Argon ne sont pas publiés.
MODEL="${GEMINI_MODEL:-gemini-3.8-flash}"
THINKING="${GEMINI_THINKING:-medium}"

curl -s -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d "{
    \"model\": \"${MODEL}\",
    \"input\": \"List the retry rules a REST client should follow for HTTP 429.\",
    \"generation_config\": {\"thinking_level\": \"${THINKING}\"}
  }"
Le SDK Python nécessite `google-genai` 2.3.0 ou une version ultérieure pour l'API Interactions :
# pip install "google-genai>=2.3.0"
import os
from google import genai

MODEL = os.environ.get("GEMINI_MODEL", "gemini-3.8-flash")
THINKING = os.environ.get("GEMINI_THINKING", "medium")

client = genai.Client()  # reads GEMINI_API_KEY from the environment
interaction = client.interactions.create(
    model=MODEL,
    input="List the retry rules a REST client should follow for HTTP 429.",
    generation_config={"thinking_level": THINKING},
)
print(interaction.output_text)
Sur 3.8 Flash, les niveaux valides sont `low`, `medium` (par défaut) et `high` ; `minimal` renvoie une erreur HTTP 400. Notre guide sur les niveaux de réflexion explique les compromis. Pour un travail en plusieurs tours, passez l'ID de la réponse précédente comme `previous_interaction_id`, et envoyez `store: false` pour désactiver le stockage côté serveur.
Étape 2 : Maintenir le chemin generateContent fonctionnel
La plupart du code existant appelle l'ancien point de terminaison generateContent, qui, selon Google, reste entièrement pris en charge. Voici la même requête :
curl -s "https://generativelanguage.googleapis.com/v1beta/models/${MODEL}:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d "{
    \"contents\": [{\"parts\": [{\"text\": \"List the retry rules a REST client should follow for HTTP 429.\"}]}],
    \"generationConfig\": {\"thinkingConfig\": {\"thinkingLevel\": \"${THINKING}\"}}
  }"
Notez où se trouve le niveau de réflexion : `generation_config.thinking_level` sur Interactions, `generationConfig.thinkingConfig.thinkingLevel` ici. Si votre client gère les deux, acheminez les nouveaux modèles via Interactions par défaut. Les définitions d'outils nécessitent la même attention ; voir l'appel de fonctions Gemini 3.8 Flash.
Étape 3 : Planifier une vérification de mise en ligne avec models.list
Ne rafraîchissez pas le journal des modifications. Demandez à l'API. Le point de terminaison `models` renvoie les modèles disponibles avec leurs limites de jetons et les méthodes prises en charge :
import os, sys, requests

resp = requests.get(
    "https://generativelanguage.googleapis.com/v1beta/models",
    params={"pageSize": 1000},
    headers={"x-goog-api-key": os.environ["GEMINI_API_KEY"]},
    timeout=30,
)
resp.raise_for_status()
hits = [m for m in resp.json().get("models", []) if "argon" in m["name"].lower()]
for m in hits:
    print(m["name"], "in:", m.get("inputTokenLimit"),
          "out:", m.get("outputTokenLimit"), m.get("supportedGenerationMethods"))
sys.exit(1 if hits else 0)  # a failed run is the alert
Exécutez-le toutes les heures à partir de cron ou d'un calendrier CI, en utilisant la clé que votre application de production utilise. Lorsque nous avons exécuté cet appel le 1er octobre 2026, avec une clé de projet payante, il a renvoyé 61 modèles, aucun `nextPageToken`, et aucun nom contenant "argon". Le jour où cela correspond, l'entrée vous indique trois choses à la fois : le vrai nom du modèle, si `outputTokenLimit` est le million complet, et les méthodes répertoriées.
Étape 4 : Simuler la réponse pour que le client soit construit avant l'accès
Vous n'avez pas besoin d'Argon pour construire le code qui consomme Argon. Enregistrez la requête de l'étape 2 dans Apidog avec `GEMINI_API_KEY` et `GEMINI_MODEL` comme variables d'environnement, envoyez-la une fois contre 3.8 Flash, et extrayez la réponse réelle dans le point de terminaison comme exemple de réponse. Le Smart Mock par défaut d'Apidog génère des données à partir du schéma, alors définissez la méthode de moquerie par défaut du projet sur "Response example first" (Paramètres du projet, Paramètres des fonctionnalités, Paramètres de moquerie). L'URL de moquerie renvoie alors votre réponse enregistrée, afin que votre front-end, vos workers de file d'attente et vos analyseurs puissent l'exécuter sans dépenser de jetons.
Soyez clair sur ce qu'est cette moquerie : le schéma de réponse actuel de Gemini, pas un schéma spécifique à Argon, car Google n'en a pas publié. C'est toujours le bon choix, car Argon devrait utiliser la même API. Pour simuler une réponse Argon lourde, modifiez `usageMetadata` de l'exemple avec de grands nombres et confirmez que votre code de facturation et d'alerte réagit.
Étape 5 : Affirmer sur usageMetadata et un plafond de coût
Chaque réponse `generateContent` inclut `usageMetadata`. Ajoutez un script de post-traitement dans Apidog qui évalue chaque réponse aux taux standard d'Argon, de sorte qu'un test échoue avant qu'une facture ne le fasse :
// Apidog post-processor: price this response at Gemini 4 Argon's standard rates
const u = pm.response.json().usageMetadata;
const IN = 4 / 1e6;   // USD par jeton d'entrée après la période d'introduction
const OUT = 20 / 1e6; // USD par jeton de sortie ; la réflexion est facturée comme sortie sur les modèles Gemini actuels
const out = (u.candidatesTokenCount || 0) + (u.thoughtsTokenCount || 0);
const cost = u.promptTokenCount * IN + out * OUT;
pm.test("usageMetadata est présent", () => pm.expect(u).to.be.an("object"));
pm.test("coût inférieur à 0,10 $ aux tarifs Argon", () => pm.expect(cost).to.be.below(0.10));
Choisissez le plafond par requête ; 0,10 $ convient à une courte invite comme celle-ci. Google n'a pas précisé comment Argon facture les jetons de réflexion, le script suppose donc la règle actuelle de Gemini. Gardez la même requête enregistrée et exécutez-la d'abord contre 3.8 Flash, puis contre Argon : la différence dans le nombre de jetons et le coût est votre comparaison de régression.
FAQ
L'API Gemini 4 Argon est-elle disponible ? Pas publiquement. Argon est déployé uniquement auprès d'un ensemble de partenaires du programme Fairwind, qui l'utilisent via Gemini Enterprise. Les clients API payants et les abonnés Google AI Ultra viendront ensuite, sans date précisée.
Quel est l'ID du modèle Gemini 4 Argon ? Google n'en a pas publié. Les chaînes sur les sites tiers sont des espaces réservés, alors gardez le modèle dans une variable d'environnement et surveillez `models.list`.
Combien coûtera l'API Gemini 4 Argon ? 2 $ en entrée et 10 $ en sortie par 1M de jetons pendant une période d'introduction de durée non précisée, puis 4 $ et 20 $. L'entrée en cache bénéficie d'une réduction de 95 %. Voir les tarifs de Gemini 4 Argon.
Argon fonctionnera-t-il avec generateContent ? Google ne l'a pas dit. Ses documents indiquent que tous les nouveaux modèles sont lancés sur l'API Interactions, alors construisez sur Interactions et traitez generateContent comme une option de secours.
Google AI Ultra me donne-t-il accès à l'API ? Non. AI Ultra est un abonnement grand public, pas une clé API. Google déclare que l'accès à l'API commence avec les clients API payants.
Votre prochaine étape
Définissez `GEMINI_MODEL` dans chaque environnement, planifiez la vérification `models.list`, et enregistrez les requêtes Interactions et generateContent avec l'assertion de coût attachée. Téléchargez Apidog pour conserver ces requêtes, simulations et tests dans un seul espace de travail, puis changez une seule variable lorsque Google publiera l'ID.