
Google a lancé deux nouveaux modèles de parole à parole le 15 septembre 2026, et le fil de discussion sur Hacker News a dépassé les 337 points en une journée. C'est une réaction importante pour le lancement d'une API vocale, et la majeure partie de la discussion ne portait pas sur la vidéo de démonstration. Il s'agissait de développeurs posant la même question : combien cela coûte-t-il de développer avec cela, et comment s'y connecter concrètement ?
Ceci est ce guide. gemini-3.8-live et gemini-3.8-live-extended-thinking sont en cours de déploiement dans l'API Gemini et Google AI Studio, avec un accès à Gemini Enterprise et Search Live en préversion privée. Les deux modèles acceptent des jetons d'entrée et de sortie gratuits en plus d'un niveau payant avec des tarifs par jeton et par minute, ce qui est suffisamment inhabituel pour un modèle audio en direct pour justifier de parcourir la session WebSocket elle-même, et pas seulement la page de tarification. Nous avons déjà comparé les assistants vocaux grand public dans GPT-Live vs Gemini Live ; cet article est le chemin du développeur vers l'API derrière l'un des côtés de cette comparaison.
Ce qui a réellement été lancé le 15 septembre
L'annonce de Google couvre deux modèles. gemini-3.8-live est le modèle standard de parole à parole. gemini-3.8-live-extended-thinking ajoute une couche de raisonnement qui s'exécute pendant que le modèle parle, décrite ci-dessous. Les deux prennent en charge 97 langues avec une commutation automatique en cours de conversation, ce qui signifie qu'un appelant peut commencer une phrase en anglais et la terminer en espagnol sans indicateur de langue manuel.
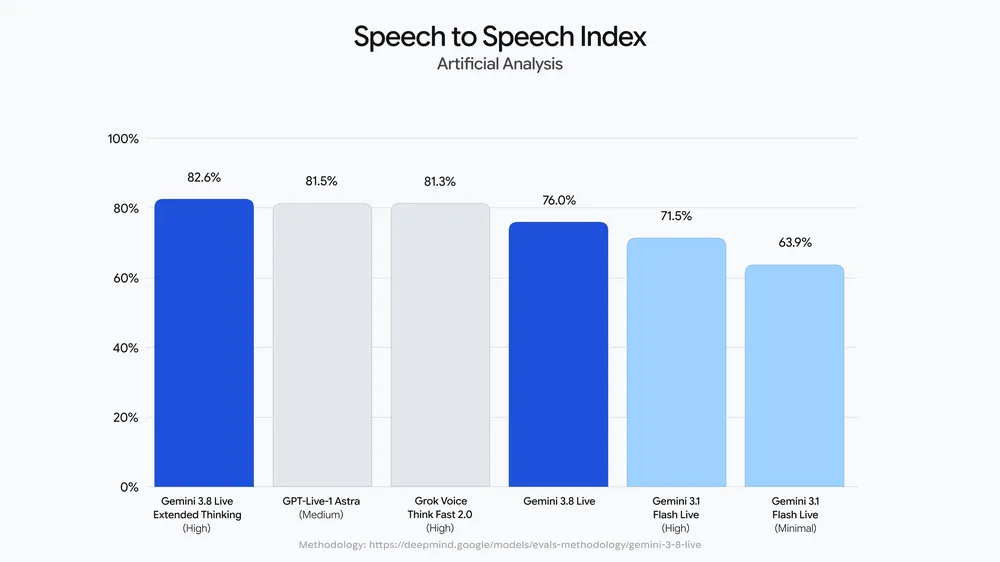
Disponibilité au lancement : l'API Gemini et Google AI Studio (accès général), ainsi que Gemini Enterprise et Search Live (préversion privée, donc la plupart des développeurs lisant ceci commenceront par l'API ou AI Studio). Des jetons gratuits s'appliquent aux deux modèles, en entrée et en sortie, ce qui rend un véritable prototype accessible avant de devoir utiliser une carte de crédit.
Un détail que Google n'a pas publié : les limites de débit du niveau gratuit pour les deux modèles Live. La page des limites de débit sera la source de vérité une fois qu'elles y seront listées ; considérez tout chiffre que vous voyez ailleurs comme non confirmé jusqu'à ce que vous le vérifiiez vous-même à cet endroit.
Le fait que l'accès à Search Live et Gemini Enterprise soit uniquement en préversion privée, plutôt qu'ouvert comme l'API, est un signal à interpréter : Google est à l'aise de laisser les développeurs construire des solutions proches de la production avant de s'engager avec le même modèle pour la recherche grand public ou les licences d'entreprise payantes. C'est normal pour le déploiement d'un modèle vocal, et cela signifie que la surface de l'API est le point de départ stable pour le moment, et non une préversion allégée d'une meilleure expérience utilisateur à venir plus tard.
Obtenez une clé API gratuite et ouvrez une session
Une clé API Gemini provient de Google AI Studio, liée à un compte Google, et elle fonctionne avec les modèles Live le jour même de leur lancement, car il n'y a pas d'étape d'approbation distincte pour le niveau gratuit. Une fois que vous avez la clé, le point de connexion est un WebSocket, et non un point de terminaison REST, ce qui est le premier ajustement si vous êtes habitué aux appels generateContent :
wss://generativelanguage.googleapis.com/ws/google.ai.generativelanguage.v1alpha.GenerativeService.BidiGenerateContent
Cette URL provient du compte-rendu pratique de Simon Willison du jour du lancement, publié parallèlement à sa lecture attentive habituelle d'une nouvelle API. Il a également signalé quelque chose à savoir avant de construire une interface utilisateur autour de cela : vous pouvez interrompre le modèle en pleine réponse, comme vous interrompriez une personne qui parle, et la transcription qui revient peut inclure un discours que le modèle a commencé à générer mais n'a jamais fini de jouer, car la lecture a été coupée par votre interruption. Gérez cela comme un état distinct dans votre client plutôt que de supposer que chaque ligne de transcription a été entendue en entier.
Une session bidirectionnelle sur ce socket suit le modèle utilisé par toutes les API de streaming basées sur WebSocket : un message de configuration d'abord, identifiant le modèle et sa configuration de génération, puis un flux de messages de contenu transportant des morceaux audio ou du texte dans les deux sens, le serveur renvoyant des segments de réponse partiels et finaux dès qu'ils sont prêts. Le schéma exact des messages doit être documenté précisément par Google, et il peut changer entre la préversion et la disponibilité générale, alors vérifiez les noms des champs par rapport à la documentation de l'API Gemini en direct et la référence de votre SDK avant de vous engager sur un client de production. Ce qui est stable, c'est le modèle : se connecter, envoyer la configuration, diffuser le contenu, lire les réponses diffusées et s'attendre à ce que l'interruption soit un événement normal plutôt qu'un cas d'erreur.
Concrètement, cela signifie que votre première session de travail devrait viser la boucle la plus petite possible : ouvrir le socket, envoyer un message de configuration nommant le modèle que vous souhaitez (gemini-3.8-live ou gemini-3.8-live-extended-thinking), envoyer un seul tour audio ou texte court, et confirmer que vous recevez une réponse en streaming avant d'ajouter une logique de réessai, la gestion de la reconnexion ou une interface utilisateur. Construisez le chemin d'interruption en second, une fois que le chemin nominal fonctionne, car le tester correctement signifie parler délibérément par-dessus le modèle en pleine réponse et vérifier que votre client marque correctement la transcription coupée plutôt que de la traiter comme un tour complet.
Pensée étendue : quand le raisonnement se manifeste à voix haute
Le modèle simple gemini-3.8-live répond directement. gemini-3.8-live-extended-thinking fait quelque chose de différent : Google affirme qu'il « raisonne et parle simultanément », maintenant ce qu'il appelle un « flux conversationnel ininterrompu » en remplissant le temps de raisonnement avec des indices verbaux, des phrases comme « Laissez-moi vérifier cela » au lieu d'un silence total pendant que le modèle travaille.
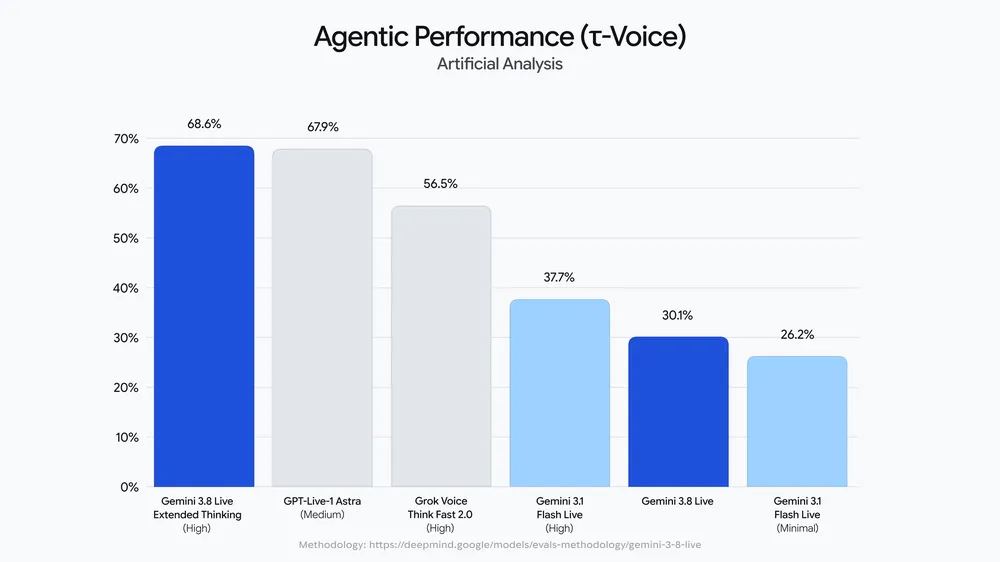
Cela est important pour une catégorie spécifique d'applications : les agents vocaux qui appellent des outils ou des API externes en pleine conversation. Le modèle à pensée étendue « exécute des outils et des appels API en arrière-plan tout en poursuivant la conversation », et l'appel de fonctions est pris en charge sur les deux modèles. Imaginez un agent de réservation qui doit vérifier la disponibilité via une API de calendrier : au lieu de rester silencieux pendant deux secondes pendant que la recherche s'exécute, le modèle peut accuser réception de la demande à voix haute et maintenir l'échange pendant que l'appel se termine en arrière-plan.
Choisissez la pensée étendue lorsque votre session inclut des appels d'outils, des recherches en plusieurs étapes ou des réponses nécessitant un raisonnement approfondi où un silence semblerait rompu. Choisissez le modèle simple pour des échanges plus courts et à faible latence où le surcoût de raisonnement n'est pas nécessaire. Les deux coûtent le même prix par jeton, donc le choix porte sur le comportement, pas sur le budget. Si votre agent s'appuie spécifiquement sur l'appel de fonctions, notre guide d'appel de fonctions pour Gemini 3.8 Flash couvre la forme de requête que Google utilise pour toute la famille Gemini 3.8 actuelle, bien que vous deviez confirmer la charge utile d'appel de fonctions spécifique à Live par rapport à la documentation de l'API Live avant de déployer, car les API texte et vocales ne sont pas garanties de partager le même schéma.
Ce que cela coûte, calculé
Les deux modèles Live partagent la même tarification standard :
| Type | Tarif |
|---|---|
| Entrée texte | 0,75 $ par 1 million de jetons |
| Entrée audio | 3,00 $ par 1 million de jetons, ou 0,005 $ par minute |
| Entrée image/vidéo | 1,00 $ par 1 million de jetons, ou 0,002 $ par minute |
| Sortie texte | 4,50 $ par 1 million de jetons |
| Sortie audio | 12,00 $ par 1 million de jetons, ou 0,018 $ par minute |
Les jetons de réflexion sont facturés comme de la sortie, comme pour tous les autres modèles Gemini 3.x, de sorte que le raisonnement en arrière-plan de la pensée étendue apparaît sur la ligne de sortie plutôt que comme un coût distinct.
Exemple concret : un appel vocal de 10 minutes, audio entrant et sortant pendant toute la durée, sur le niveau standard payant. Entrée audio : 10 minutes x 0,005 $ = 0,05 $. Sortie audio : 10 minutes x 0,018 $ = 0,18 $. Total : 0,23 $ pour une conversation complète de 10 minutes, avant l'ajout de jetons de texte ou d'appels d'outils. Exécutez le même appel sur le niveau gratuit pendant le prototypage et le coût des jetons est nul, sous réserve de la limite de débit que Google publiera finalement pour cela.
Le modèle gemini-3.1-flash-live-preview sur la même page de tarification présente des tarifs identiques à ceux des deux nouveaux modèles Live, ce qui vaut la peine d'être vérifié si vous avez déjà une intégration Live sur cet ancien modèle ; la décision de tarification n'est pas une raison de retarder la migration.
Ce que les développeurs en disent, jusqu'à présent
La discussion sur Hacker News n'est pas uniformément positive. Une plainte récurrente : les abonnés payants à Google Workspace et Google AI Plus n'ont pas encore accès à l'expérience Live pour les consommateurs, même s'ils sont des clients payants, alors que l'accès à l'API et à AI Studio est ouvert. Un rapport du fil de discussion a décrit une boucle agentique où le modèle a inventé des exigences supplémentaires qui ne faisaient pas partie de la tâche originale, un mode de défaillance qu'il vaut la peine de tester spécifiquement si vous intégrez Live dans un agent autonome plutôt que dans un assistant vocal avec intervention humaine. Si vous construisez quelque chose de plus proche d'une boucle autonome que d'un assistant supervisé, ajoutez une vérification explicite qui compare ce que le modèle prétend avoir besoin avec la définition de tâche que vous lui avez donnée, plutôt que de faire confiance aux exigences déclarées du modèle au pied de la lettre. Traitez ces deux points comme un signal du premier jour provenant d'un seul fil de discussion, et non comme un rapport de défaut vérifié, et re-testez-les par rapport à votre propre cas d'utilisation avant de généraliser à partir d'eux.
Visualisez le protocole brut avant d'écrire du code client
Avant de vous engager sur une bibliothèque cliente, il est utile d'observer les trames réelles qui transitent. Apidog peut ouvrir une connexion WebSocket au point de terminaison `BidiGenerateContent`, envoyer manuellement le message de configuration JSON et les messages de contenu suivants, et vous montrer les trames diffusées en temps réel, ce qui est le moyen le plus rapide de comprendre le modèle de configuration puis de diffusion avant d'écrire une seule ligne de code SDK autour de cela. Apidog ne capture pas l'audio du microphone pour vous ; vous fournissez vous-même les charges utiles audio ou texte et utilisez la connexion pour inspecter ce que le serveur renvoie, confirmer que votre message de configuration est accepté et observer le comportement de l'interruption avant de construire la gestion des erreurs en production. La référence complète du protocole pour la construction et le test des API WebSocket de cette manière se trouve sur docs.apidog.com. Téléchargez Apidog pour tester la connexion vous-même avant votre première construction de client.
À titre de comparaison, notre analyse WebSocket vs WebRTC explique pourquoi Google a choisi un WebSocket pour ce flux bidirectionnel au lieu du chemin WebRTC utilisé par certaines API vocales concurrentes, et ce que ce compromis signifie spécifiquement pour les clients de navigateur.
FAQ
L'API Gemini 3.8 Live est-elle gratuite ? Oui, pour les deux modèles, les jetons d'entrée et de sortie sont gratuits sur le niveau gratuit. Les tarifs standard payants s'appliquent une fois que vous dépassez la limite de débit fixée par Google, et cette limite de niveau gratuit n'est pas encore publiée, alors consultez directement la page des limites de débit.
Quelle est la différence entre les deux nouveaux modèles ? gemini-3.8-live répond directement. gemini-3.8-live-extended-thinking raisonne tout en parlant, en utilisant des éléments verbaux de remplissage pour couvrir les appels d'outils en arrière-plan et les recherches en plusieurs étapes, au même prix par jeton.
Ai-je besoin de WebRTC pour l'utiliser ? Non. L'API est basée sur WebSocket, se connectant à un point de terminaison `BidiGenerateContent` plutôt qu'à une connexion pair-à-pair WebRTC.
Puis-je tester cela sans écrire de client ? Oui. Ouvrez le WebSocket dans Apidog, envoyez manuellement les messages de configuration et de contenu, et lisez la réponse diffusée avant de construire un véritable client autour.