
Voici la décision d'emblée. Choisissez Gemini 3.5 Flash-Lite lorsque vous exécutez des tâches simples à volume élevé et que vous vous souciez le plus du coût et de la vitesse : classification, extraction, courtes réponses de chat, réponses RAG, auto-complétion. Choisissez Gemini 3.6 Flash lorsque la qualité est plus importante que la facture : agents multi-étapes, utilisation d'outils, codage, utilisation d'ordinateurs et réponses où un mauvais résultat est coûteux.
Les deux modèles ont été lancés dans la mise à jour de la série Flash de Google le 21 juillet 2026. Les deux acceptent jusqu'à 1 million de jetons en entrée. Ils se situent à des points différents de la même courbe, donc la question n'est pas vraiment de savoir quel modèle est "meilleur". Il s'agit de savoir quel compromis correspond le mieux à la tâche à accomplir.
Une particularité de la dénomination à éclaircir d'abord : le modèle phare est passé à la version 3.6, mais le niveau Lite est resté à la version 3.5. Vous comparez donc un modèle 3.5 à un modèle 3.6, et c'est ce qui est attendu, ce n'est pas une faute de frappe. Plus de détails à ce sujet dans la FAQ.
bouton
La réponse courte
Par défaut, utilisez Flash-Lite pour tout ce qui est simple et que vous exécutez des millions de fois, et utilisez 3.6 Flash dès que la tâche nécessite un raisonnement, des outils ou du code. Si vous ne pouvez pas décider, commencez avec Flash-Lite, observez où les réponses sont insuffisantes, et ne promouvez que ces appels vers 3.6 Flash. Vous avez rarement besoin d'un seul modèle pour toute l'application.
Prix et vitesse côte à côte
| Attribut | Gemini 3.5 Flash-Lite | Gemini 3.6 Flash |
|---|---|---|
| ID du modèle | gemini-3.5-flash-lite |
gemini-3.6-flash |
| Prix en entrée | 0,30 $ / 1 million de jetons | 1,50 $ / 1 million de jetons |
| Prix en sortie | 2,50 $ / 1 million de jetons | 7,50 $ / 1 million de jetons |
| Débit | ~350 jetons de sortie/sec | Non publié séparément |
| Fenêtre de contexte | 1 million de jetons | 1 million de jetons |
| Niveau gratuit | Oui (limité en débit) | Oui (limité en débit) |
Flash-Lite est moins cher pour chaque jeton. L'entrée coûte 5 fois moins cher ; la sortie 3 fois moins cher. Google publie un chiffre de débit d'environ 350 jetons de sortie par seconde pour Flash-Lite, ce qui le rend instantané dans une boîte de chat ou un champ d'auto-complétion. Google n'a pas publié de chiffre séparé de jetons par seconde pour 3.6 Flash, mais 3.6 Flash produit environ 17 % moins de jetons de sortie que le 3.5 Flash qu'il remplace, de sorte qu'il termine les travaux multi-étapes plus rapidement que ne le suggère le prix affiché. Vous pouvez confirmer les tarifs actuels sur la page des tarifs de l'API Gemini et dans notre analyse des tarifs de Gemini 3.6 Flash.
Qualité et benchmarks
L'écart de prix vous offre une marge de manœuvre sur les tâches difficiles. Sur Terminal-Bench 2.1, qui mesure le travail d'agent sur terminal, Flash-Lite obtient un score de 54 et 3.6 Flash un score de 78,0. Cet écart de 24 points est toute l'histoire : sur les tâches véritablement multi-étapes et basées sur des outils, 3.6 Flash est le modèle le plus performant, et ce, de loin.
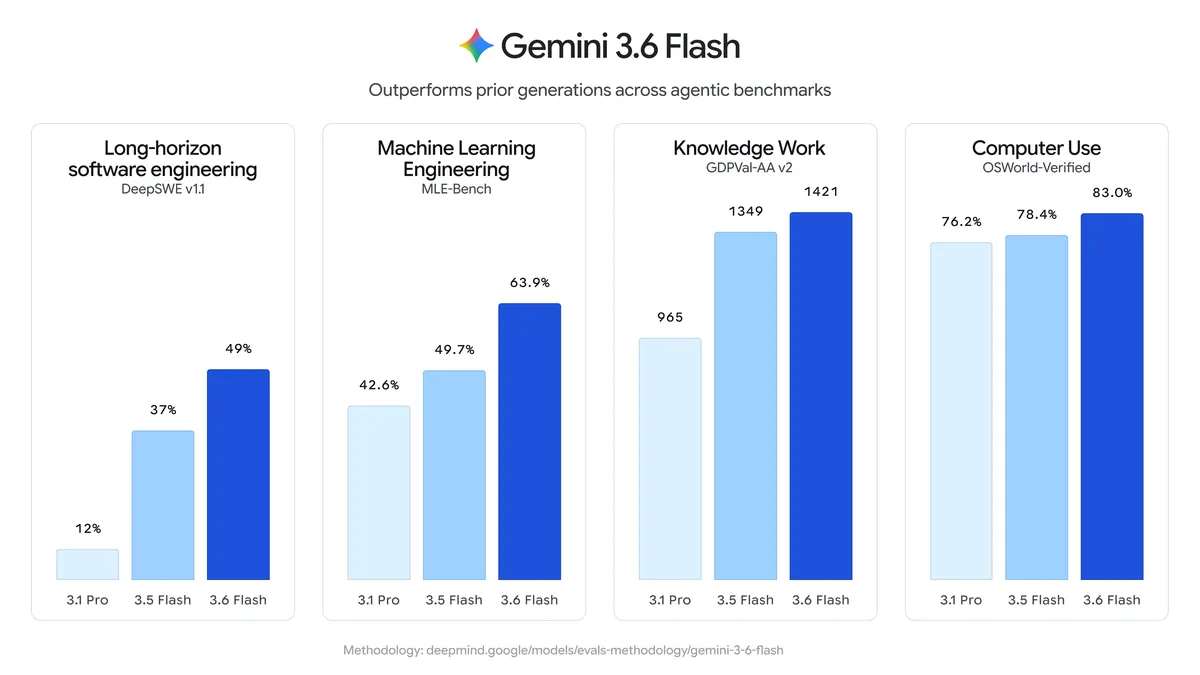
3.6 Flash obtient également un score de 83,0 sur OSWorld-Verified, le benchmark d'utilisation d'ordinateur qui mesure la capacité à utiliser un véritable navigateur ou un bureau. Flash-Lite ne cible pas cette compétence. Si votre charge de travail implique de cliquer sur un écran, c'est un travail pour 3.6 Flash. En matière de codage spécifiquement, 3.6 Flash affiche 58,7 % sur SWE-Bench Pro et 49 % sur DeepSWE v1.1, le genre de scores qui le placent dans la catégorie du codage agentique réel. Flash-Lite n'est pas conçu pour ce type de travail.
Il convient d'être juste envers Flash-Lite ici. Son score de 54 sur Terminal-Bench 2.1 est en hausse par rapport aux 31 de la génération Lite précédente, de sorte que le niveau bon marché est devenu beaucoup plus performant cette fois-ci. Ce n'est pas un modèle faible. C'est un modèle réglé pour une tâche différente : un raisonnement rapide, bon marché, et suffisamment bon sur des tâches qui ne se ramifient pas. La propre page du modèle Flash de Google et l'annonce de lancement décrivent les deux de la même manière : un niveau pour le volume, un niveau pour la profondeur.
Quel modèle pour quelle tâche
Utilisez ceci comme une matrice de départ, puis ajustez avec vos propres évaluations.
| Tâche | Meilleure option |
|---|---|
| Classification ou extraction à grand volume | Flash-Lite |
| Assistants de chat et réponses courtes | Flash-Lite |
| Réponses RAG sur contexte récupéré | Flash-Lite |
| UX de type auto-complétion, critique pour la latence | Flash-Lite |
| Pipelines à l'échelle de la recherche, pour chaque requête | Flash-Lite |
| Agents multi-étapes | 3.6 Flash |
| Utilisation d'outils et chaînes d'appels de fonctions | 3.6 Flash |
| Codage et révision de code | 3.6 Flash |
| Utilisation d'ordinateur (navigateur ou bureau) | 3.6 Flash |
| Réponses à enjeux plus élevés où les erreurs coûtent cher | 3.6 Flash |
Le modèle est simple. Flash-Lite l'emporte lorsque la tâche est spécifique et que le volume est énorme. 3.6 Flash l'emporte lorsque la tâche se ramifie et que le coût d'une erreur est élevé. Un modèle qui catégorise les tickets de support dix millions de fois par jour appartient à Flash-Lite. Un modèle qui lit une trace de pile, modifie trois fichiers et ouvre une pull request appartient à 3.6 Flash. Si vous comparez cela à l'ancien 3.5 Flash au lieu de Flash-Lite, notre comparaison 3.6 Flash vs 3.5 Flash couvre ce chemin de mise à niveau.
Une comparaison des coûts pour la même charge de travail
Les chiffres concrétisent le compromis. Supposons qu'un travail quotidien envoie 10 millions de jetons d'entrée et génère 2 millions de jetons de sortie, une forme typique pour un pipeline de résumé ou d'extraction par lots.
| Modèle | Entrée (10M) | Sortie (2M) | Total quotidien |
|---|---|---|---|
| Flash-Lite | 3,00 $ | 5,00 $ | 8,00 $ |
| 3.6 Flash | 15,00 $ | 15,00 $ | 30,00 $ |
Avec ce mélange, 3.6 Flash coûte 3,75 fois plus cher : 8,00 $ contre 30,00 $ par jour, soit environ 240 $ contre 900 $ par mois pour le même volume.
Le multiplicateur n'est cependant pas fixe. Étant donné que Flash-Lite est 5 fois moins cher en entrée et 3 fois moins cher en sortie, vos économies réelles se situent entre 3 et 5 fois, selon la nature de votre trafic. Le travail intensif en entrée (contexte RAG long, gros documents, classification de grandes entrées) tend vers l'extrémité 5x, et ce sont exactement les charges de travail pour lesquelles Flash-Lite est conçu. La génération intensive en sortie tend vers 3x.
Donc, la vraie question n'est pas seulement "est-ce que 3.6 Flash peut faire ça ?" C'est "est-ce que l'amélioration de la qualité vaut la peine de payer 3 à 4 fois plus cher par appel, à mon volume ?" Pour un pipeline à l'échelle de la recherche, la réponse est généralement non. Pour un agent qui modifie du code ou dépose un ticket, la réponse est généralement oui.
Comment A/B tester les deux dans Apidog
Vous n'avez pas besoin de deviner quel niveau est suffisant. L'API Gemini est un simple point de terminaison REST, vous pouvez donc envoyer la même requête aux deux modèles et comparer directement les réponses. Apidog est un client API conçu précisément pour ce type de vérification côte à côte.
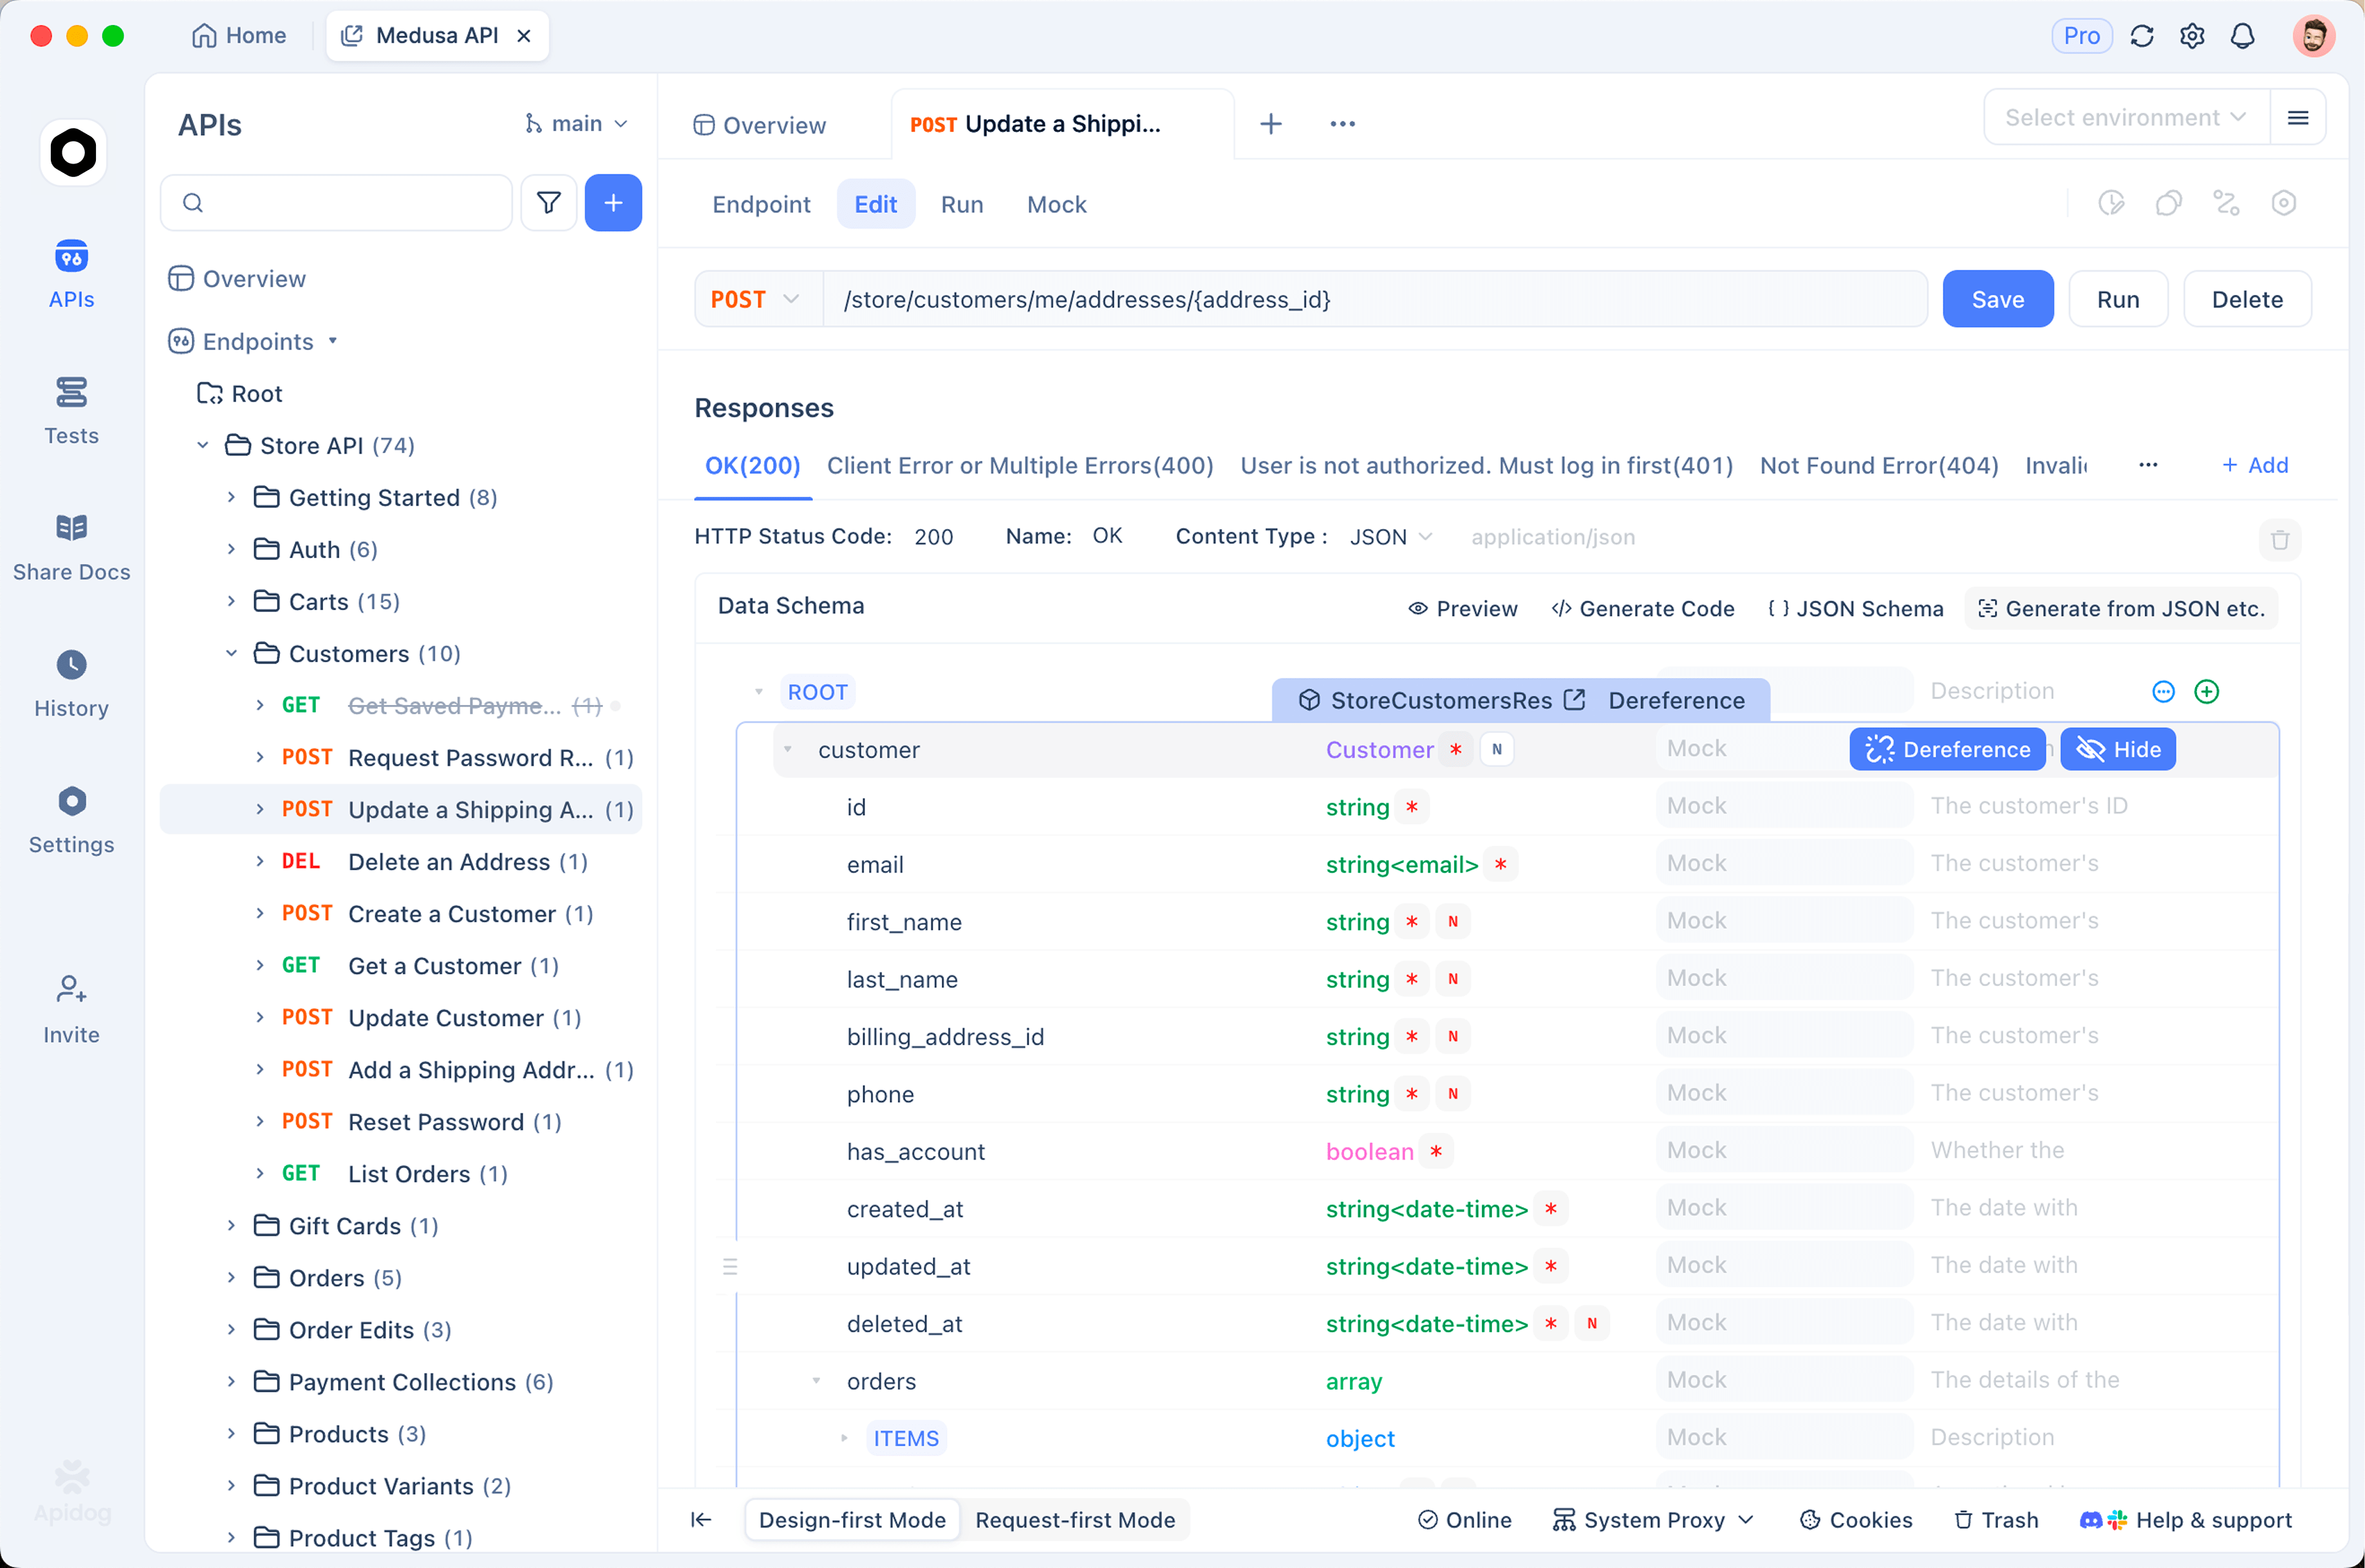
Voici un workflow qui prend quelques minutes :
- Créez une requête POST vers le point de terminaison de l'API Gemini et stockez votre clé API dans une variable d'environnement Apidog, afin que la clé ne se trouve jamais dans le corps de la requête ou dans le contrôle de version.
- Envoyez-la une fois avec le modèle défini sur
gemini-3.5-flash-lite. Notez la réponse et la latence rapportée par Apidog. - Dupliquez la requête et ne changez qu'une chose : l'ID du modèle en
gemini-3.6-flash. Même requête, mêmes paramètres, donc la seule variable est le modèle. - Comparez les deux réponses sur la qualité et comparez les délais enregistrés par Apidog pour chaque appel.
- Ajoutez des assertions sur la réponse (code d'état, champs JSON attendus, contenu requis) afin que le "suffisamment bon" soit défini par une vérification, et non par un examen visuel.
Une fois les requêtes existantes, enregistrez-les et transformez-les en un test reproductible. Vous pouvez planifier les tests API dans Apidog pour réexécuter les mêmes requêtes à une fréquence donnée, ce qui permet de détecter les dérives de qualité ou de latence lorsque Google met à jour l'un ou l'autre modèle. Soyez clair sur la limite : Apidog envoie les requêtes et vérifie vos assertions, mais il n'exécute pas le modèle et ne vous dira pas quelle réponse est la plus intelligente. Ce jugement vous appartient. Pour suivre, téléchargez Apidog et pointez une requête vers le point de terminaison Gemini.
FAQ
Flash-Lite est-il juste une version moins bonne de 3.6 Flash ? Non. C'est un point différent sur la courbe coût, qualité et vitesse. Flash-Lite est moins cher et plus rapide avec un plafond inférieur pour le raisonnement difficile ; 3.6 Flash coûte plus cher et raisonne mieux. Pour les tâches simples à grand volume, Flash-Lite est souvent la bonne réponse précisément parce qu'il est moins cher et plus rapide, et non malgré cela.
Pourquoi l'un s'appelle-t-il 3.5 et l'autre 3.6 ? Versionnement mixte. Lors de cette mise à jour, Google a fait passer le cheval de bataille principal de Flash à 3.6 mais a maintenu le niveau Lite à 3.5 (la même version comprenait également un modèle de sécurité 3.5 Flash Cyber). Même famille, numéros de version différents. Ne considérez pas le 3.5 de Flash-Lite comme "ancien et abandonné".
Partagent-ils la même fenêtre contextuelle ? Oui. Les deux acceptent jusqu'à 1 million de jetons en entrée, donc les requêtes à contexte long ne sont pas une raison de choisir l'un plutôt que l'autre. Choisissez plutôt en fonction de la qualité du raisonnement, du prix et de la vitesse.
Puis-je utiliser les deux dans une seule application ? C'est le modèle recommandé. Dirigez les appels simples, bon marché et à grand volume vers Flash-Lite et transférez les plus difficiles vers 3.6 Flash. Comme la forme de l'API est identique, le basculement n'implique qu'un seul changement de champ, ce qui rend l'A/B test d'Apidog si rapide à exécuter.
Sont-ils gratuits à essayer ? Les deux ont un niveau gratuit dans Google AI Studio, avec un débit limité, et Google peut utiliser les données du niveau gratuit pour améliorer ses produits. C'est acceptable pour les tests ; lisez les conditions avant d'envoyer quoi que ce soit de sensible.
En résumé
Optez pour Flash-Lite comme solution par défaut pour les tâches simples, rapides et bon marché à grande échelle, et transférez les appels difficiles, ramifiés ou à forte composante de code vers 3.6 Flash, où l'écart de 24 points sur Terminal-Bench justifie son prix 3 à 4 fois plus élevé. Ne choisissez pas dans l'abstrait : envoyez vos requêtes réelles aux deux, mesurez la qualité et la latence, et laissez les chiffres décider. Apidog facilite cette comparaison en deux requêtes.
bouton