EN BREF
Février 2026 a vu l'arrivée de trois modèles d'IA de pointe : Gemini 3.1 Pro, Claude Opus 4.6, et GPT-5.3 Codex. Aucun modèle unique ne domine tous les cas d'utilisation — chacun excelle dans des domaines spécifiques :
- Gemini 3.1 Pro : Leader sur les benchmarks de raisonnement (77,1 % ARC-AGI-2) et le codage algorithmique avec un coût 7 fois inférieur (2 $/12 $ par million de tokens)
- Claude Opus 4.6 : Le plus performant sur les tâches de codage réelles (80,8 % SWE-Bench Verified) avec la fonction unique d'Équipes d'Agents
- GPT-5.3 Codex : Domine les workflows terminaux (77,3 % Terminal-Bench 2.0) avec une direction interactive et une inférence 25 % plus rapide
Introduction
Février 2026 restera dans les mémoires comme le mois où les laboratoires d'IA ont cessé de rivaliser sur les benchmarks pour commencer à le faire sur les workflows des développeurs. En seulement 15 jours, trois grands laboratoires ont lancé quatre modèles phares — Claude Opus 4.6 (5 fév.), GPT-5.3 Codex (5 fév.) et Gemini 3.1 Pro (19 fév.) — chacun se présentant comme le modèle "le plus performant" pour le codage et le développement.
Pour les développeurs, cela pose un problème pratique : quel modèle devriez-vous réellement utiliser ? La réponse n'est pas simple, car contrairement aux générations précédentes où un modèle dominait clairement, ces trois modèles excellent chacun dans différentes parties du workflow de développement.
Dans ce guide, nous allons démêler les arguments marketing avec des données de benchmark réelles, une analyse des prix et des cas d'utilisation pratiques. Nous vous montrerons également comment tester et intégrer ces API de modèles d'IA à l'aide de l'espace de travail unifié d'Apidog, afin que vous puissiez évaluer les trois modèles dans votre environnement de développement réel avant de vous engager sur un seul.
À la fin, vous saurez exactement quel modèle choisir pour vos tâches de codage spécifiques — ou si vous devriez utiliser plusieurs modèles ensemble.
La course aux modèles d'IA de février 2026
Le calendrier des lancements raconte l'histoire d'un sprint concurrentiel sans précédent :
- 5 février 2026 : Anthropic lance Claude Opus 4.6 avec les Équipes d'Agents et une fenêtre de contexte de 1M (bêta)
- 5 février 2026 : OpenAI lance GPT-5.3 Codex quelques heures plus tard, en mettant l'accent sur la direction interactive
- 19 février 2026 : Google entre en scène avec Gemini 3.1 Pro, revendiquant "13 victoires sur 16" sur les benchmarks
Ce n'était pas une coïncidence. Chaque laboratoire a positionné son modèle comme la réponse au codage agentique — une IA qui ne se contente pas de suggérer du code, mais planifie, exécute et débogue des projets entiers de manière autonome.
Le timing stratégique était important car ces modèles ciblent les mêmes utilisateurs à haute valeur : les développeurs professionnels, les entreprises d'outils de développement créant des fonctionnalités d'IA et les entreprises automatisant le développement logiciel. La question est passée de "l'IA peut-elle écrire du code ?" à "quelle IA écrit du code que vous pouvez réellement livrer ?"
Analyse approfondie des performances des benchmarks
Examinons comment ces modèles se comportent sur les benchmarks de codage standard de l'industrie :
ARC-AGI-2 : Raisonnement abstrait
Gagnant : Gemini 3.1 Pro (77,1 %)
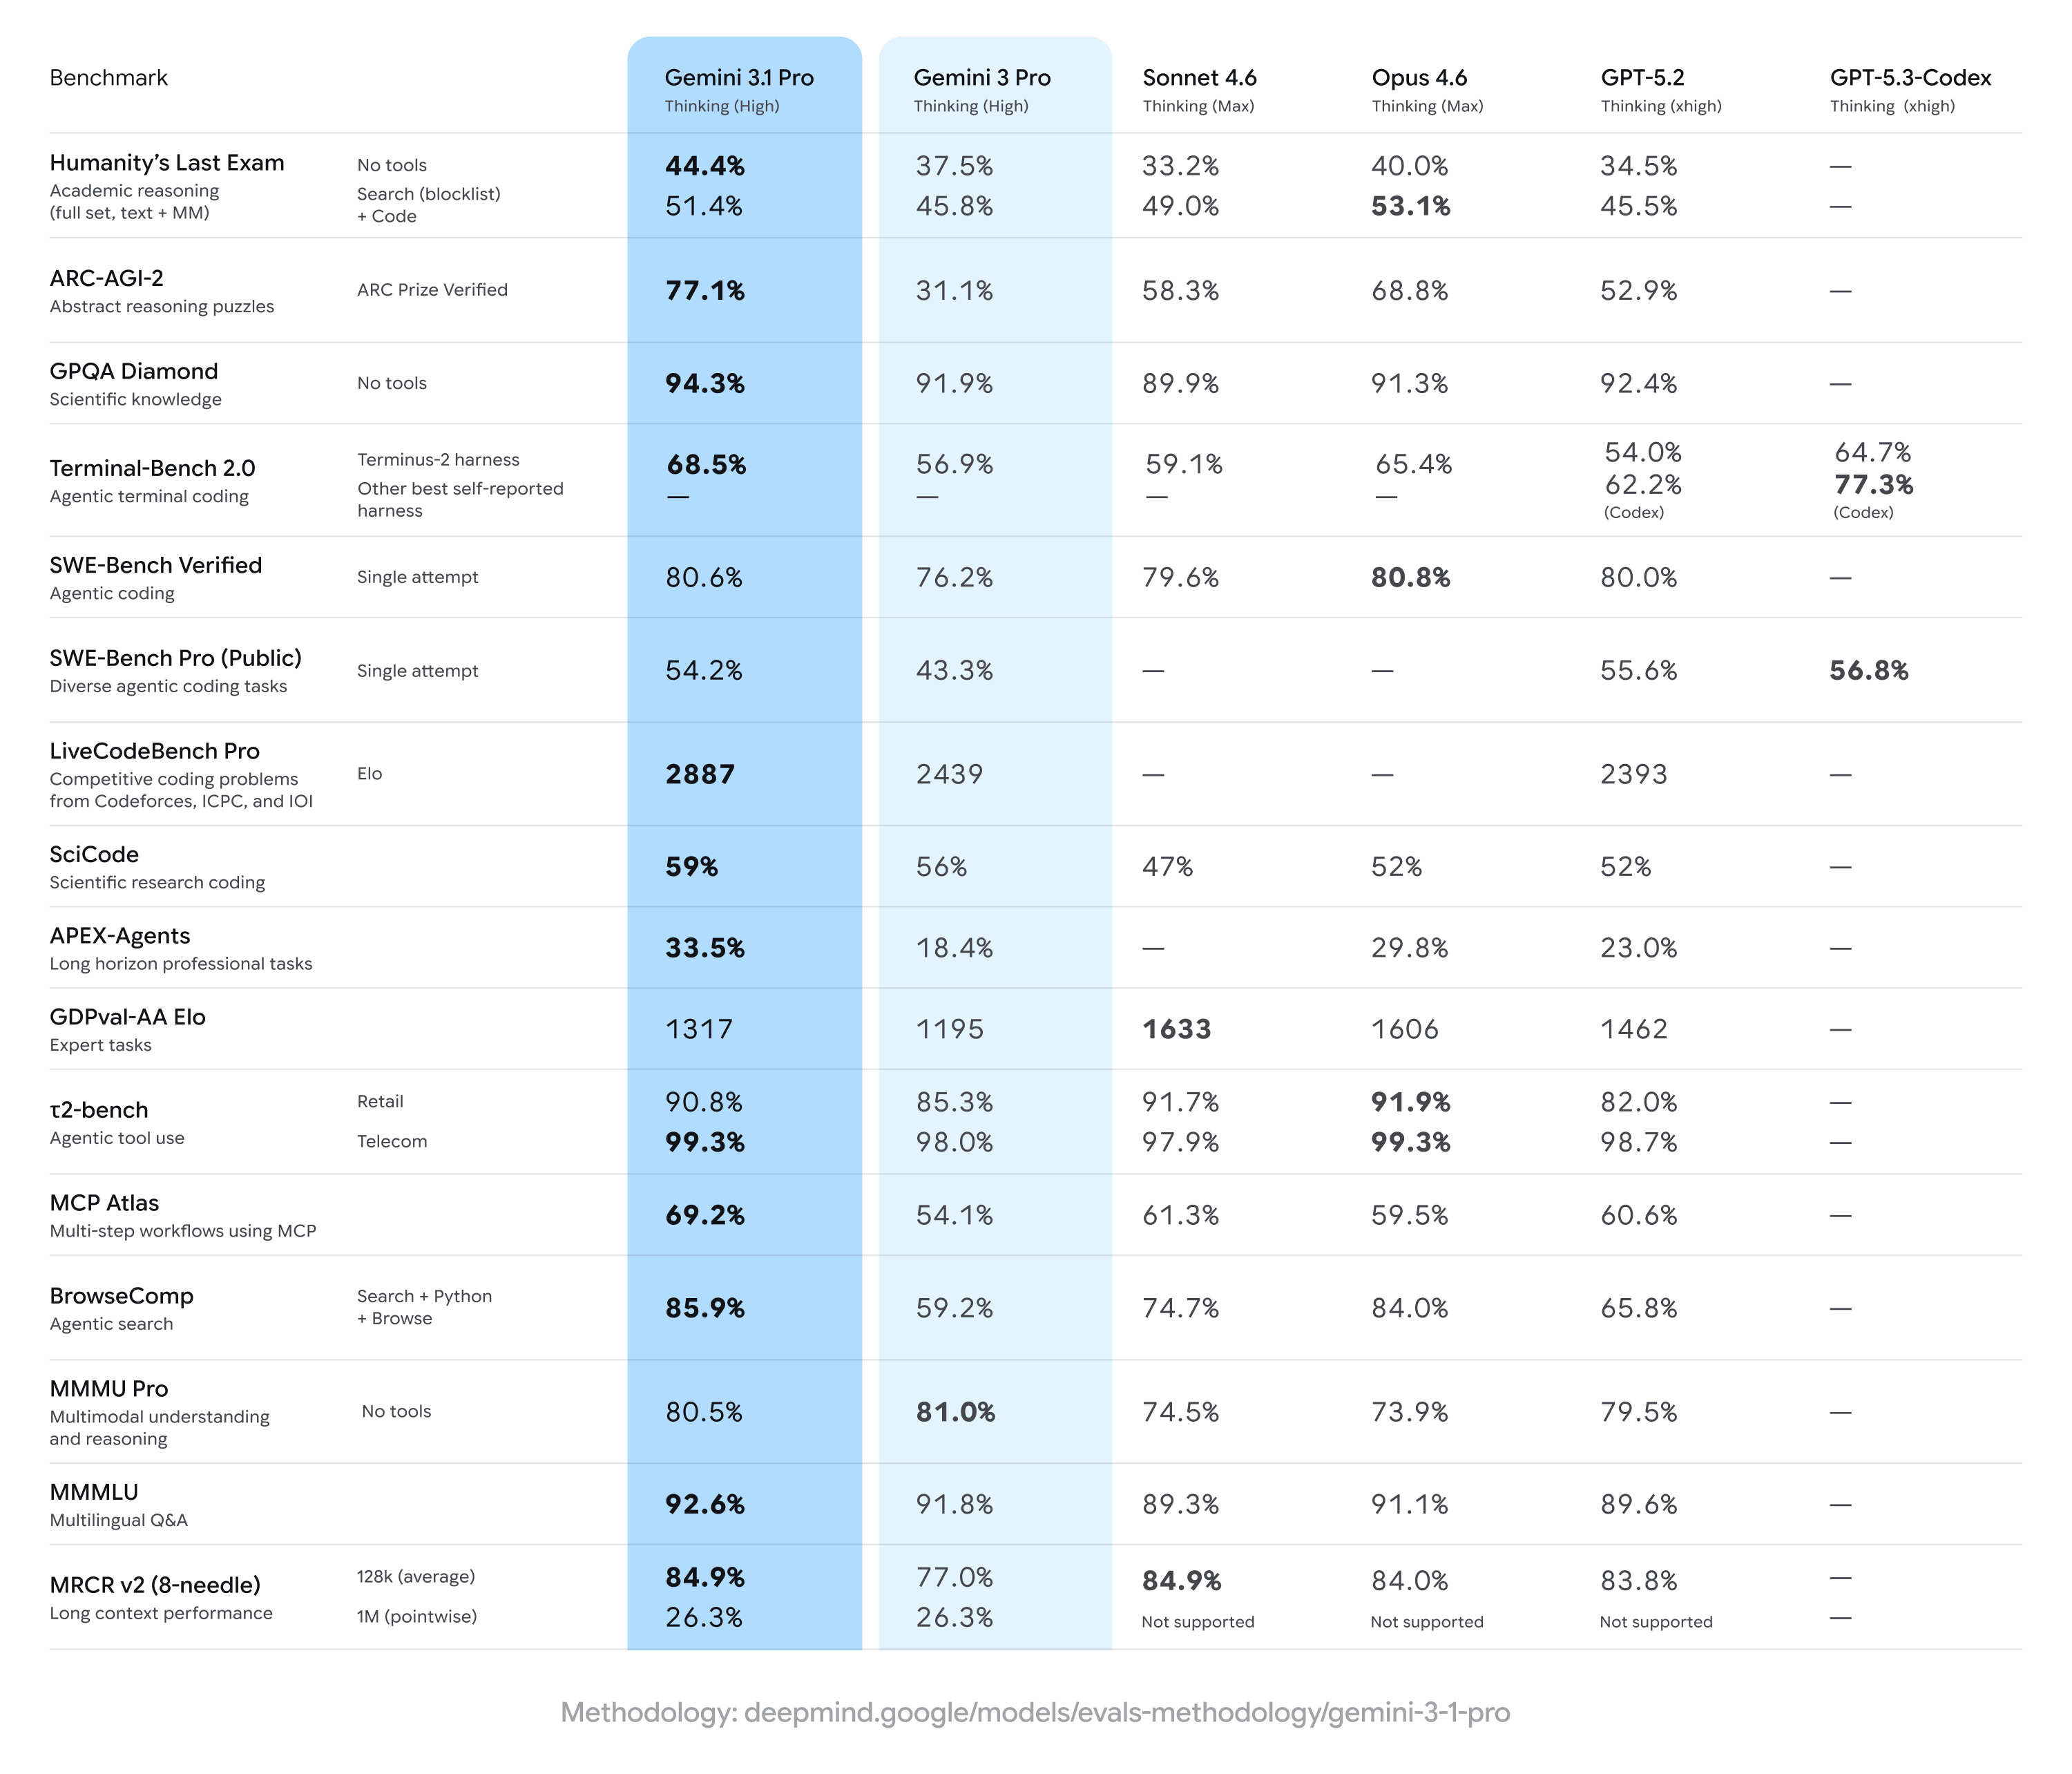
Le benchmark ARC-AGI-2 teste le raisonnement abstrait — la capacité à résoudre de nouveaux modèles logiques sans formation préalable. Le score de 77,1 % de Gemini 3.1 Pro représente un bond énorme par rapport aux 31,1 % de Gemini 3 Pro, démontrant l'accent mis par Google sur l'amélioration du raisonnement.
- Gemini 3.1 Pro : 77,1 %
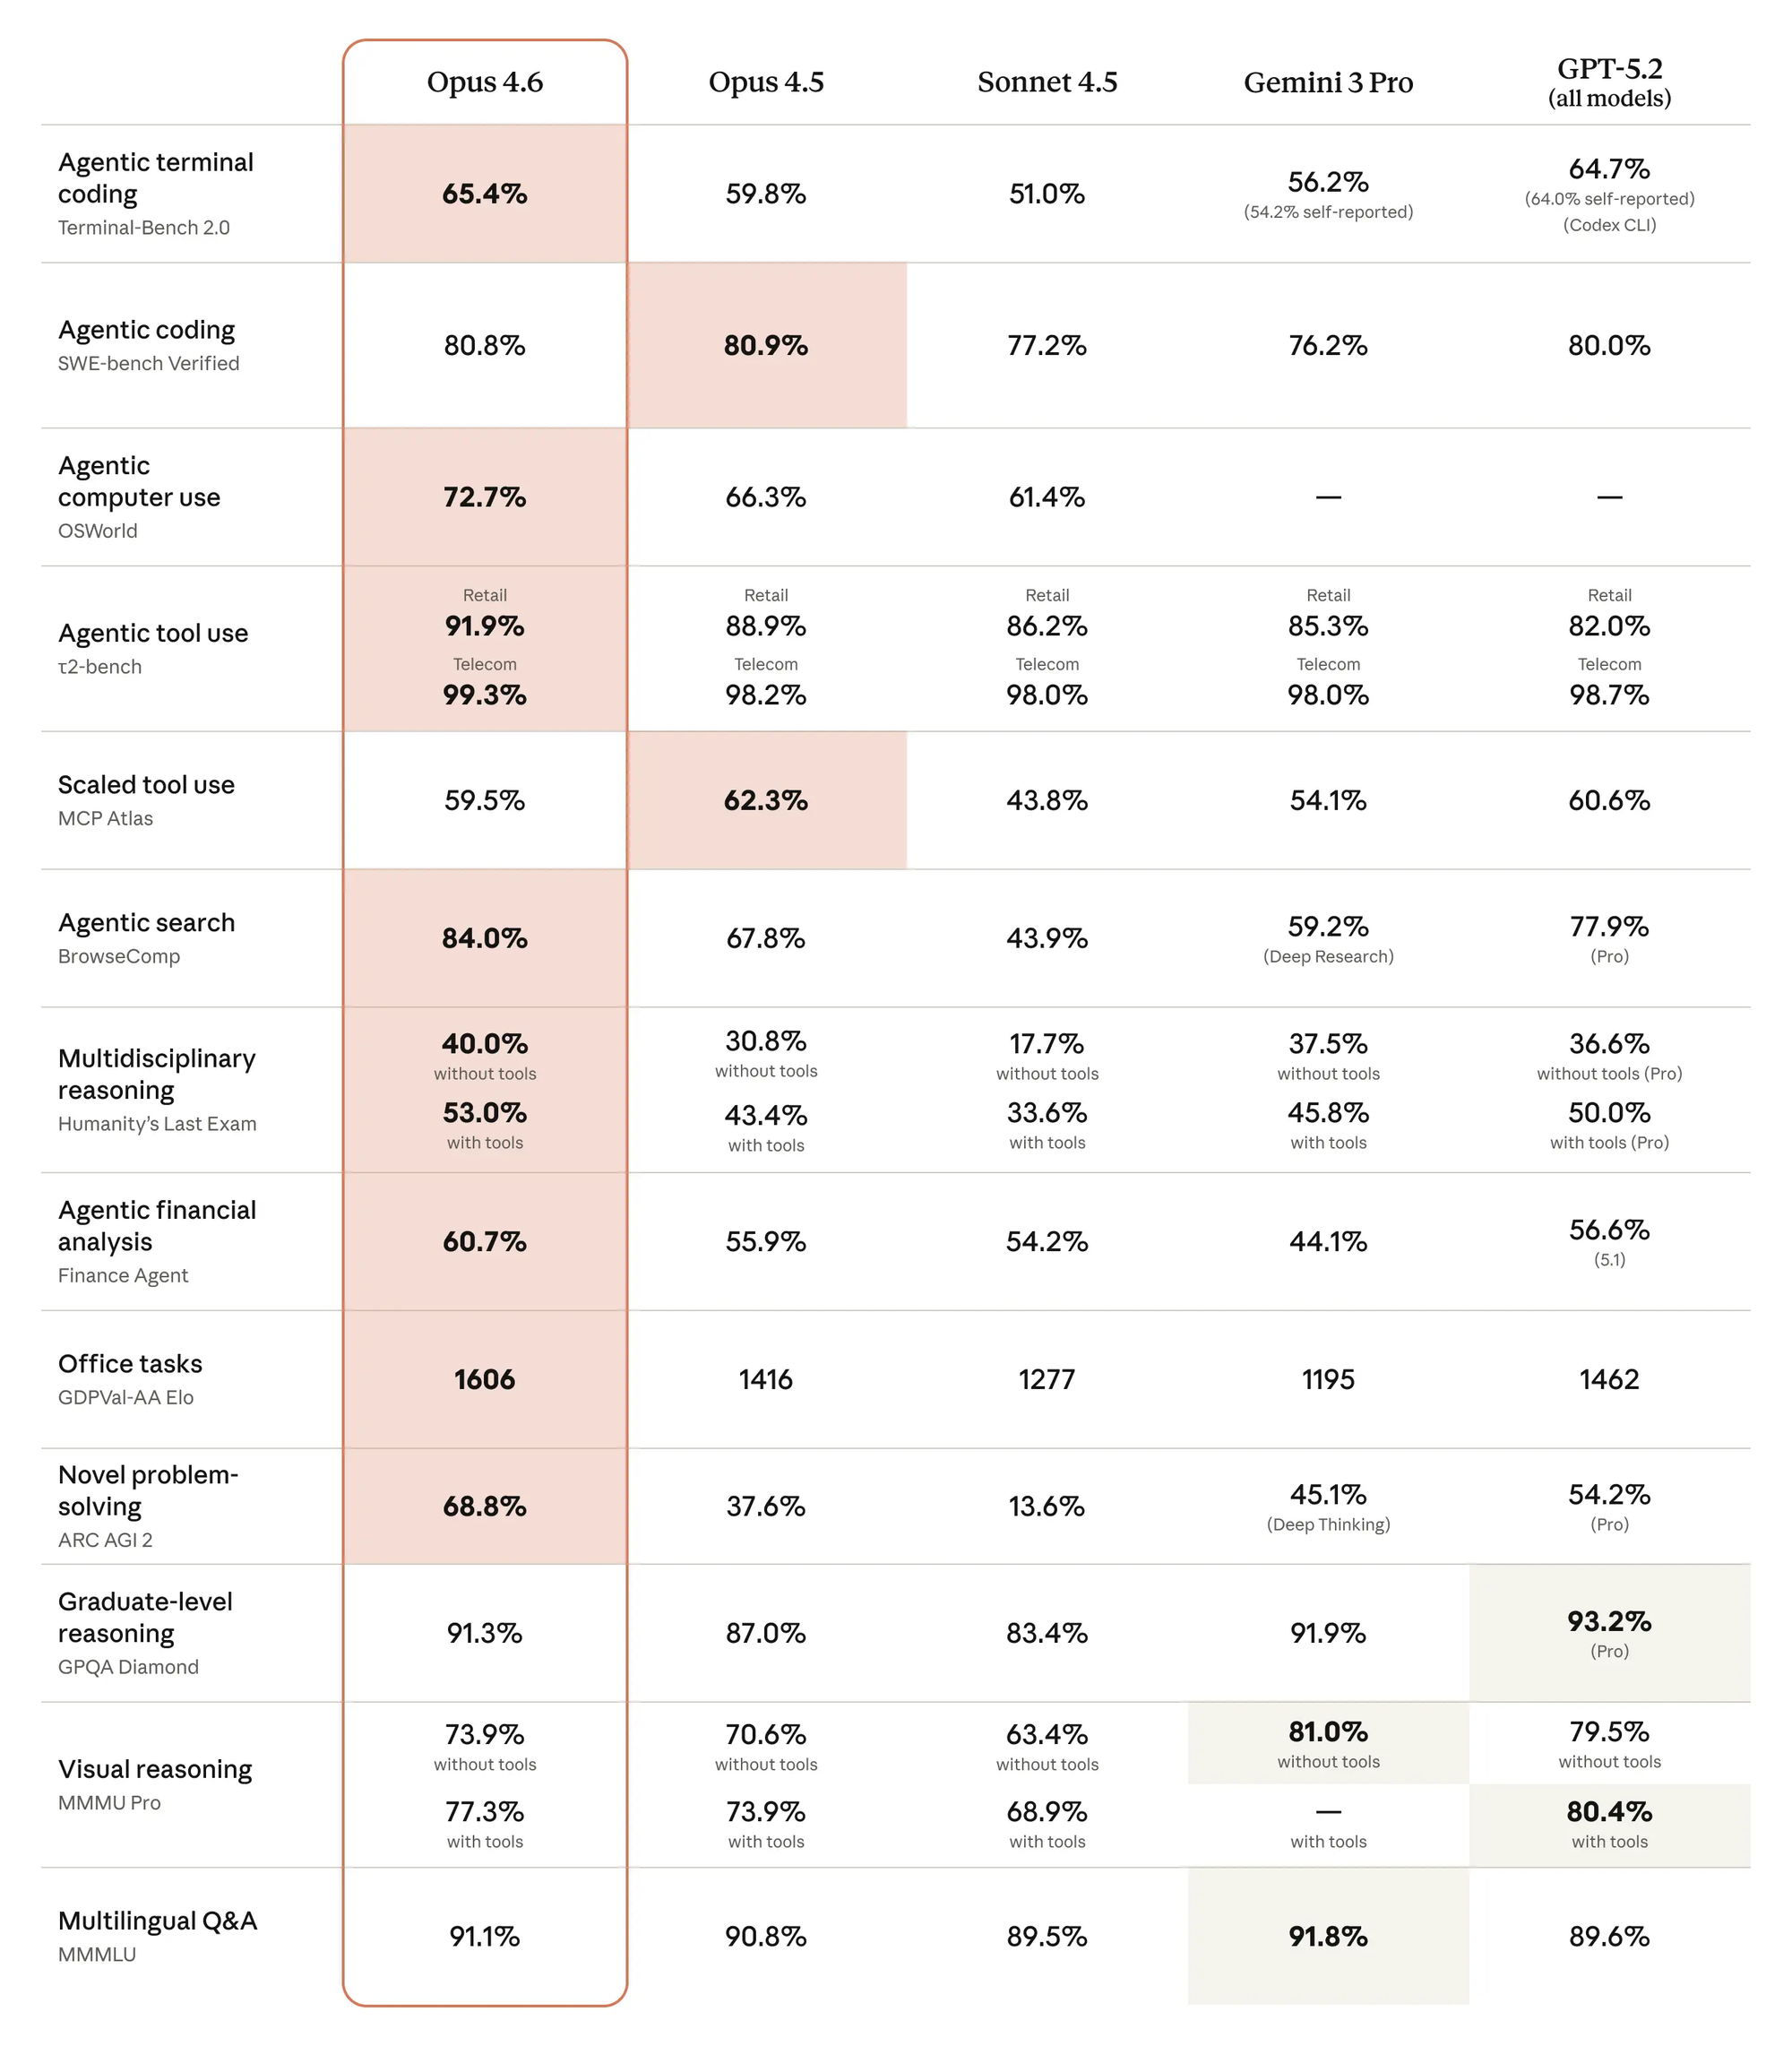
- Claude Opus 4.6 : 68,8 %
- GPT-5.2 : 52,9 % (scores de GPT-5.3 Codex non encore publiés pour ARC-AGI-2)
Ceci est important pour la programmation compétitive et la conception d'algorithmes, où il faut résoudre des problèmes inconnus plutôt qu'appliquer des schémas connus.
SWE-Bench : Ingénierie logicielle réelle
Gagnant : Claude Opus 4.6 (80,8 % sur Verified)
SWE-Bench teste si les modèles peuvent résoudre de vrais problèmes GitHub dans les dépôts Python populaires. C'est le proxy le plus proche que nous ayons pour les tâches d'ingénierie logicielle du monde réel.
- Claude Opus 4.6 : 80,8 % (SWE-Bench Verified)
- GPT-5.3 Codex : 56,8 % (SWE-Bench Pro Public)
- Gemini 3.1 Pro : 54,2 % (SWE-Bench Pro Public)
Remarque : Ceux-ci utilisent différentes variantes de SWE-Bench, donc une comparaison directe nécessite de la prudence. Le sous-ensemble "Verified" est plus petit mais de meilleure qualité que "Pro Public".
Terminal-Bench 2.0 : Workflows en ligne de commande
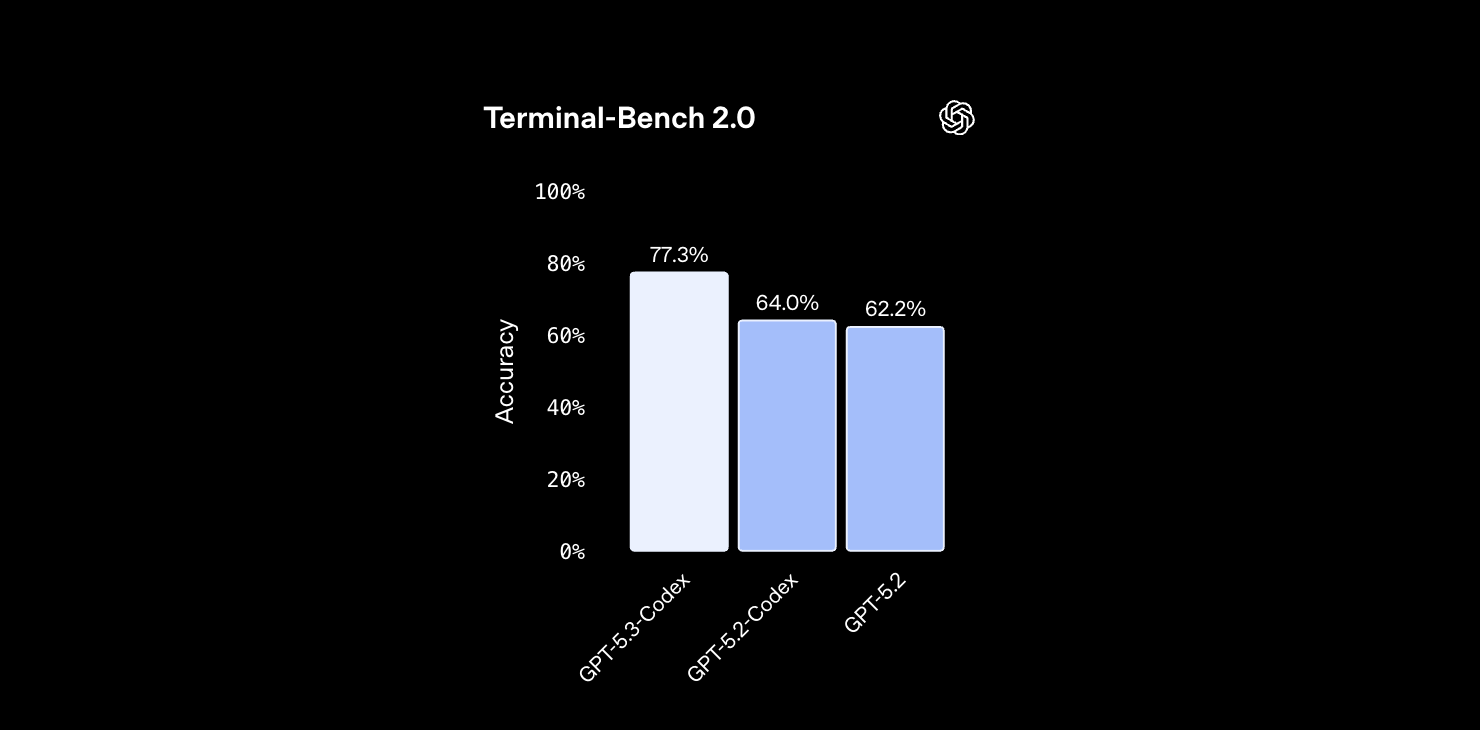
Gagnant : GPT-5.3 Codex (77,3 %)
Terminal-Bench évalue les modèles sur des tâches de développement basées sur le terminal — débogage, administration système, opérations Git et systèmes de build.
- GPT-5.3 Codex : 77,3 % (avec harnais Codex)
- Gemini 3.1 Pro : 68,5 %
- Claude Opus 4.6 : Données non largement publiées
La domination de Codex ici reflète l'optimisation spécifique d'OpenAI pour les workflows terminaux interactifs.
LiveCodeBench : Codage compétitif
Gagnant : Gemini 3.1 Pro (2887 Elo)
LiveCodeBench utilise un système de classement Elo pour les défis de programmation compétitive, mis à jour en continu pour éviter la contamination des données d'entraînement.
- Gemini 3.1 Pro : 2887 Elo
- GPT-5.2 : ~2650 Elo (estimé à partir de benchmarks antérieurs)
- Claude Opus 4.6 : Données non mises en avant dans les versions
GPQA Diamond : Questions scientifiques de niveau Master
Gagnant : Gemini 3.1 Pro (94,3 %)
Bien que non spécifique au codage, GPQA Diamond teste les connaissances de niveau expert en physique, biologie et chimie — pertinent pour les applications de calcul scientifique.
- Gemini 3.1 Pro : 94,3 %
- GPT-5.2 : 92,4 %
- Claude Opus 4.6 : 91,3 %
GDPval-AA : Performances des tâches expert (Classements Elo)
Gagnant : Claude Sonnet 4.6 (1633 Elo, bien que nous comparions Opus 4.6)
Ce benchmark évalué par des humains mesure la qualité sur des tâches d'expert. Claude Opus 4.6 obtient un score de 1606 Elo, tandis que Gemini 3.1 Pro atteint 1317 Elo — suggérant que Claude produit des résultats plus raffinés et contextuellement appropriés.
Résumé : Modèles différents, forces différentes
Les données des benchmarks révèlent un schéma clair :
- Gemini 3.1 Pro domine les tâches de raisonnement pur et algorithmiques
- Claude Opus 4.6 excelle dans l'ingénierie logicielle du monde réel avec une qualité de sortie préférée par l'humain
- GPT-5.3 Codex se spécialise dans les workflows terminaux et le débogage interactif
Il n'y a pas de modèle "meilleur" unique — votre choix dépend de votre workflow spécifique.
Analyse des prix et des coûts
Le coût est important lorsque vous effectuez des milliers d'appels API quotidiens. Voici comment se présentent les tarifs :
Comparaison des prix des tokens
| Modèle | Tokens d'entrée | Tokens de sortie | Prime Contexte Long |
|---|---|---|---|
| Gemini 3.1 Pro | 2 $ par million | 12 $ par million | 4 $/18 $ (200K-1M tokens) |
| Claude Opus 4.6 | 5 $ par million | 25 $ par million | 10 $/37,50 $ (>200K tokens) |
| GPT-5.3 Codex | Pas encore annoncé | Pas encore annoncé | À déterminer |
Point clé : Gemini 3.1 Pro est 7 fois moins cher que Claude Opus 4.6 par requête pour les invites standard de moins de 200K tokens.
Exemples de coûts réels
Calculons les coûts pour des tâches de développement courantes :
Tâche 1 : Revue de code (3 000 tokens d'entrée, 800 tokens de sortie)
- Gemini 3.1 Pro : 0,006 $ + 0,0096 $ = 0,0156 $
- Claude Opus 4.6 : 0,015 $ + 0,020 $ = 0,035 $
- GPT-5.3 Codex : À déterminer
Tâche 2 : Refactoring d'un grand fichier (15 000 tokens d'entrée, 12 000 tokens de sortie)
- Gemini 3.1 Pro : 0,030 $ + 0,144 $ = 0,174 $
- Claude Opus 4.6 : 0,075 $ + 0,300 $ = 0,375 $
- GPT-5.3 Codex : À déterminer
Tâche 3 : Analyse de dépôt à contexte long (500 000 tokens d'entrée, 3 000 tokens de sortie)
- Gemini 3.1 Pro : 2,00 $ + 0,054 $ = 2,054 $
- Claude Opus 4.6 : 5,00 $ + 0,112 $ = 5,112 $
- GPT-5.3 Codex : À déterminer
Analyse du rapport qualité-prix
Bien que Gemini 3.1 Pro offre le coût par token le plus bas, le coût par tâche dépend de l'efficacité :
- Si Claude Opus 4.6 accomplit une tâche correctement en une seule tentative alors que Gemini 3.1 Pro nécessite trois itérations, Claude pourrait être globalement moins cher
- L'utilisation des tokens varie — certains modèles génèrent un code ou des explications plus verbeux
- Les réductions pour contexte long favorisent Gemini pour l'analyse à l'échelle d'un dépôt
Recommandation : Commencez avec Gemini 3.1 Pro pour les workflows sensibles aux coûts, mais suivez les taux de réussite pour calculer le coût réel par tâche réussie.
Principales fonctionnalités et capacités
Au-delà des benchmarks et des prix, chaque modèle offre des fonctionnalités uniques qui modifient votre façon de travailler :
Fonctionnalités de Gemini 3.1 Pro
Fenêtre de contexte de 1 million de tokens (Standard)
Le contexte de 1M tokens de Gemini 3.1 Pro est disponible sans accès bêta, vous permettant de :
- Charger des bases de code entières pour une analyse complète
- Traiter 900 images, 8,4 heures d'audio ou 1 heure de vidéo en une seule invite
- Maintenir l'historique des conversations à travers des sessions de débogage complexes
La limite de sortie est de 65 536 tokens — suffisant pour générer des modules complets.
Raisonnement multimodal
Contrairement aux modèles de codage axés sur le texte, Gemini 3.1 Pro gère :
- Images de wireframe → code fonctionnel
- Diagrammes d'architecture → implémentation
- Présentations vidéo → exigences fonctionnelles
Ceci est important pour les workflows de développement basés sur le design.
Intégration à l'écosystème Google
Intégration native avec :
- Vertex AI pour le déploiement en entreprise
- Services Google Cloud
- NotebookLM pour la documentation
- GitHub Copilot (en préversion au 19 fév. 2026)
Architecture de transformeur à mélange d'experts
Le système de pensée à trois niveaux optimise le raisonnement profond — évident dans l'amélioration du score ARC-AGI-2.
Fonctionnalités de Claude Opus 4.6
Équipes d'Agents (Changement de paradigme)
Claude Opus 4.6 introduit les Équipes d'Agents — plusieurs instances de Claude collaborant sur une tâche avec des rôles distincts (planificateur, exécuteur, réviseur). Cela n'a pas d'équivalent direct dans les offres d'OpenAI ou de Google.
Cas d'utilisation :
- Un agent génère du code pendant qu'un autre écrit des tests
- Exploration parallèle de plusieurs approches de solution
- Revue de code automatique avant présentation aux humains
Mode de pensée adaptatif
Opus 4.6 passe un temps variable à "réfléchir" avant de répondre, similaire au raisonnement de type o1. Vous voyez un indicateur de pensée pendant qu'il planifie l'approche, puis reçoit une solution plus élaborée.
Cela réduit les itérations sur les problèmes complexes.
Contexte de 1 million de tokens (Bêta) + 128K de sortie
Alors que Gemini offre 1M de tokens d'entrée en standard, la capacité de sortie de 128K de Claude permet :
- Génération d'applications complètes en une seule réponse
- Génération de documentation longue
- Refactoring complet de grands modules
Le contexte de 1M est actuellement en version bêta mais disponible pour les utilisateurs de l'API.
Pensée étendue sur demande
Vous pouvez demander une "pensée étendue" pour les tâches nécessitant une planification approfondie, échangeant la latence contre la qualité de la solution.
Fonctionnalités de GPT-5.3 Codex
Direction interactive
Contrairement aux LLM traditionnels qui complètent votre invite et s'arrêtent, GPT-5.3 Codex prend en charge la direction en cours d'exécution :
- Vous pouvez corriger le tir pendant qu'il travaille
- Fournir des retours sans perdre le contexte
- Affiner l'approche de manière itérative en temps réel
Cela ressemble plus à de la programmation en binôme qu'à de l'ingénierie d'invite.
Environnements sandbox auto-amorçables
Codex peut lancer des environnements isolés, tester son propre code et déboguer les échecs de manière autonome — réduisant la boucle de rétroaction de minutes à secondes.
Inférence 25% plus rapide
OpenAI a optimisé GPT-5.3 Codex pour la vitesse, le rendant nettement plus réactif que GPT-5.2 tout en maintenant la qualité.
Diffs profonds
Codex génère des diffs contextuels qui expliquent non seulement ce qui a changé mais pourquoi, rendant la revue de code et les workflows Git plus efficaces.
Premier modèle auto-améliorant
GPT-5.3 Codex est le premier modèle d'OpenAI dont les premières versions ont aidé à déboguer sa propre formation, à gérer le déploiement et à diagnostiquer les résultats des tests — une étape intéressante dans le développement de l'IA.
Tester les API de modèles d'IA avec Apidog
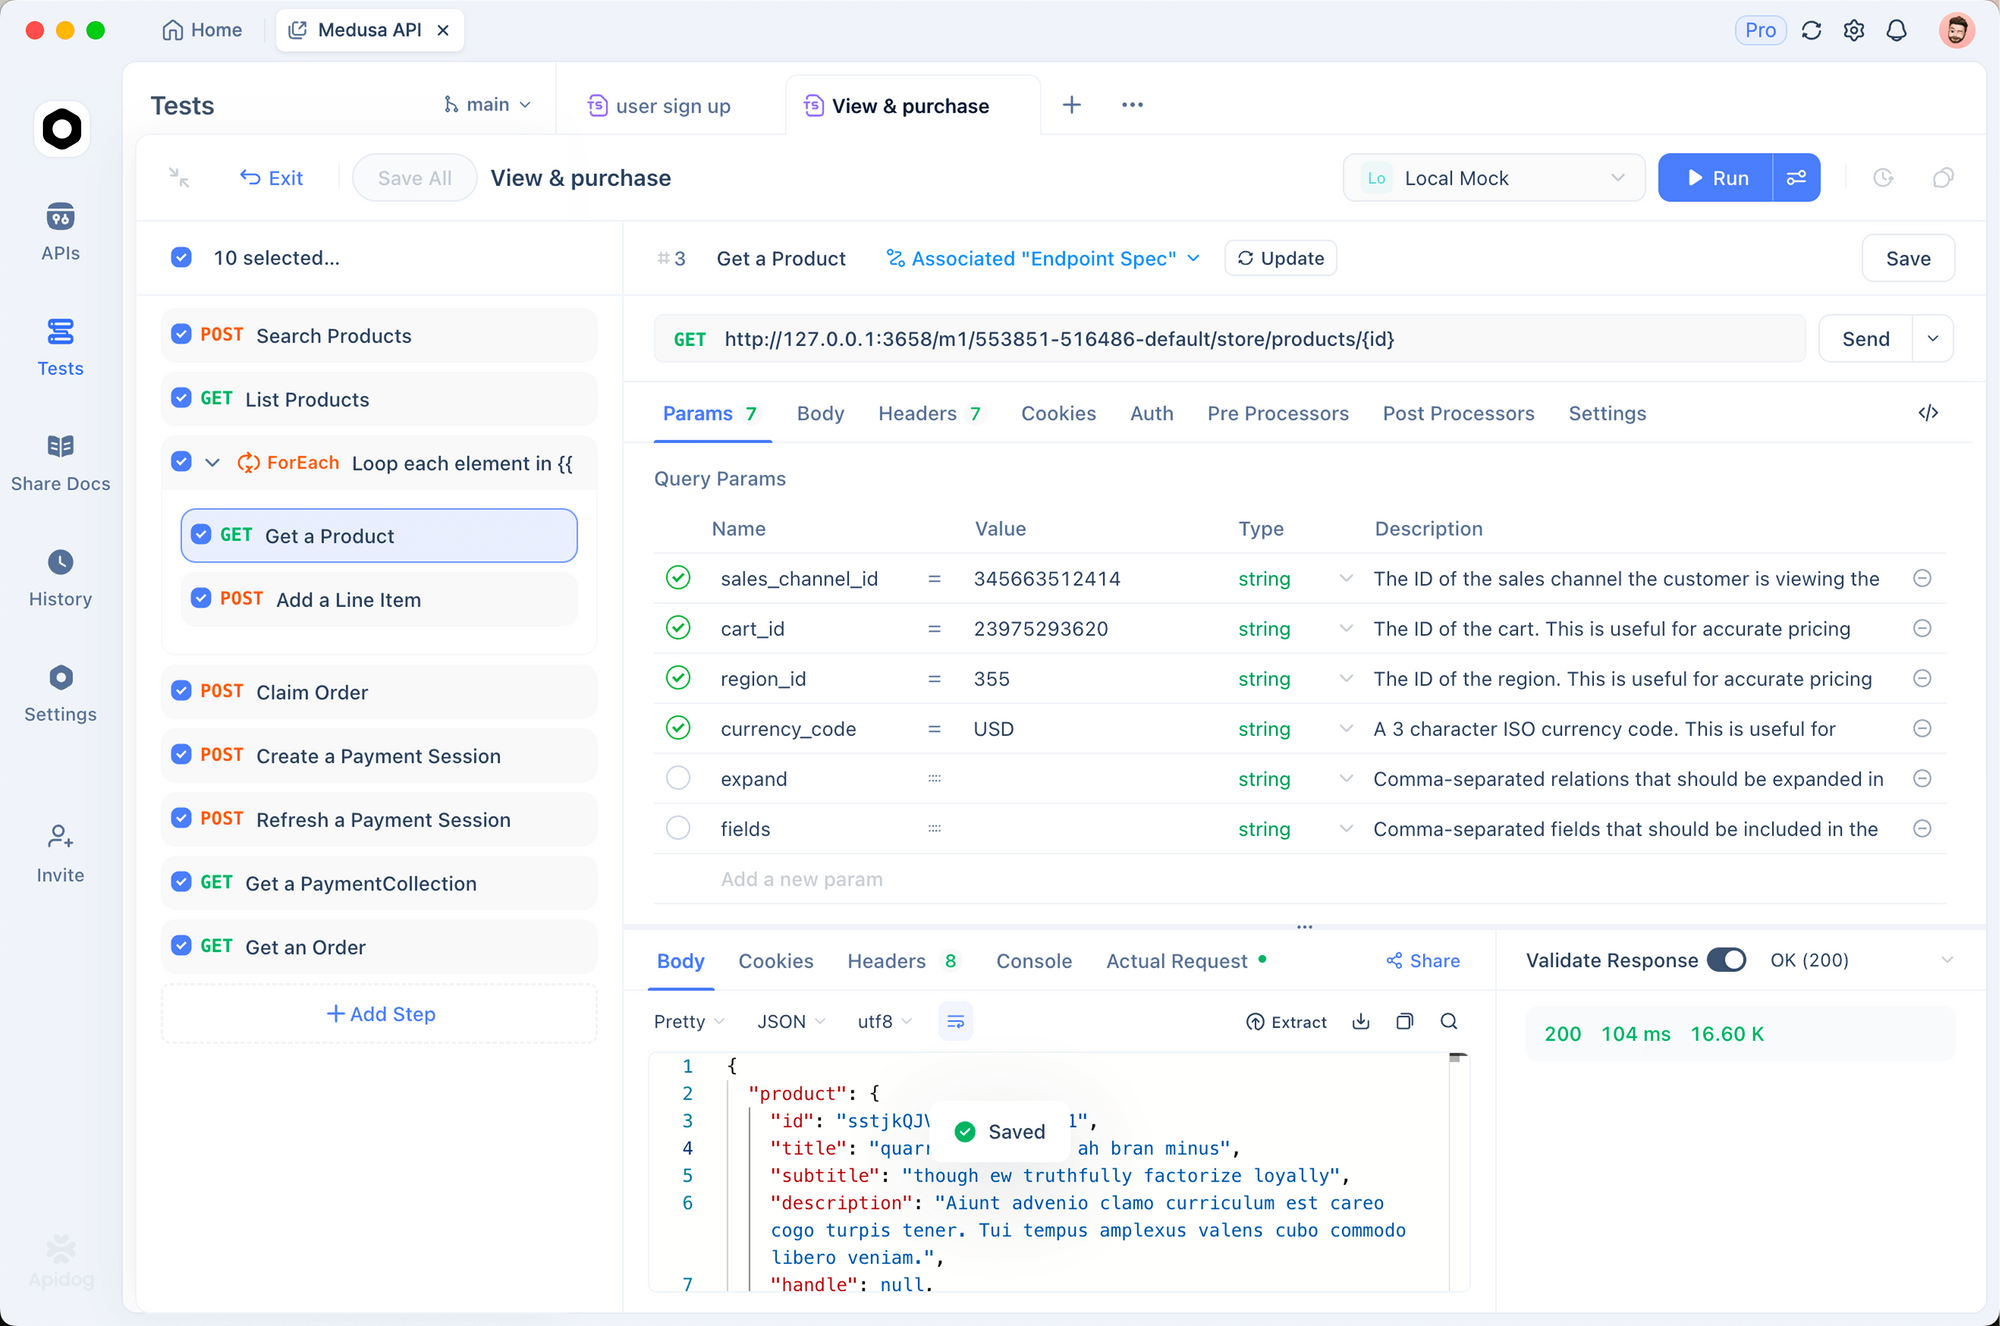
Si vous êtes sérieux quant au choix du bon modèle d'IA, vous devez les tester avec vos cas d'utilisation réels. L'espace de travail unifié d'Apidog facilite la comparaison des trois modèles côte à côte.
Pourquoi tester les API de modèles d'IA ?
- Le temps de réponse varie considérablement entre les fournisseurs
- L'utilisation des tokens diffère — certains modèles sont plus verbeux
- La qualité de sortie est subjective ; testez avec vos invites spécifiques
- Les taux d'erreur et la gestion des cas limites varient
- Les limites de débit et les quotas diffèrent selon les fournisseurs
Configurer les points de terminaison des modèles d'IA dans Apidog
Voici comment configurer les trois modèles dans un seul espace de travail Apidog :
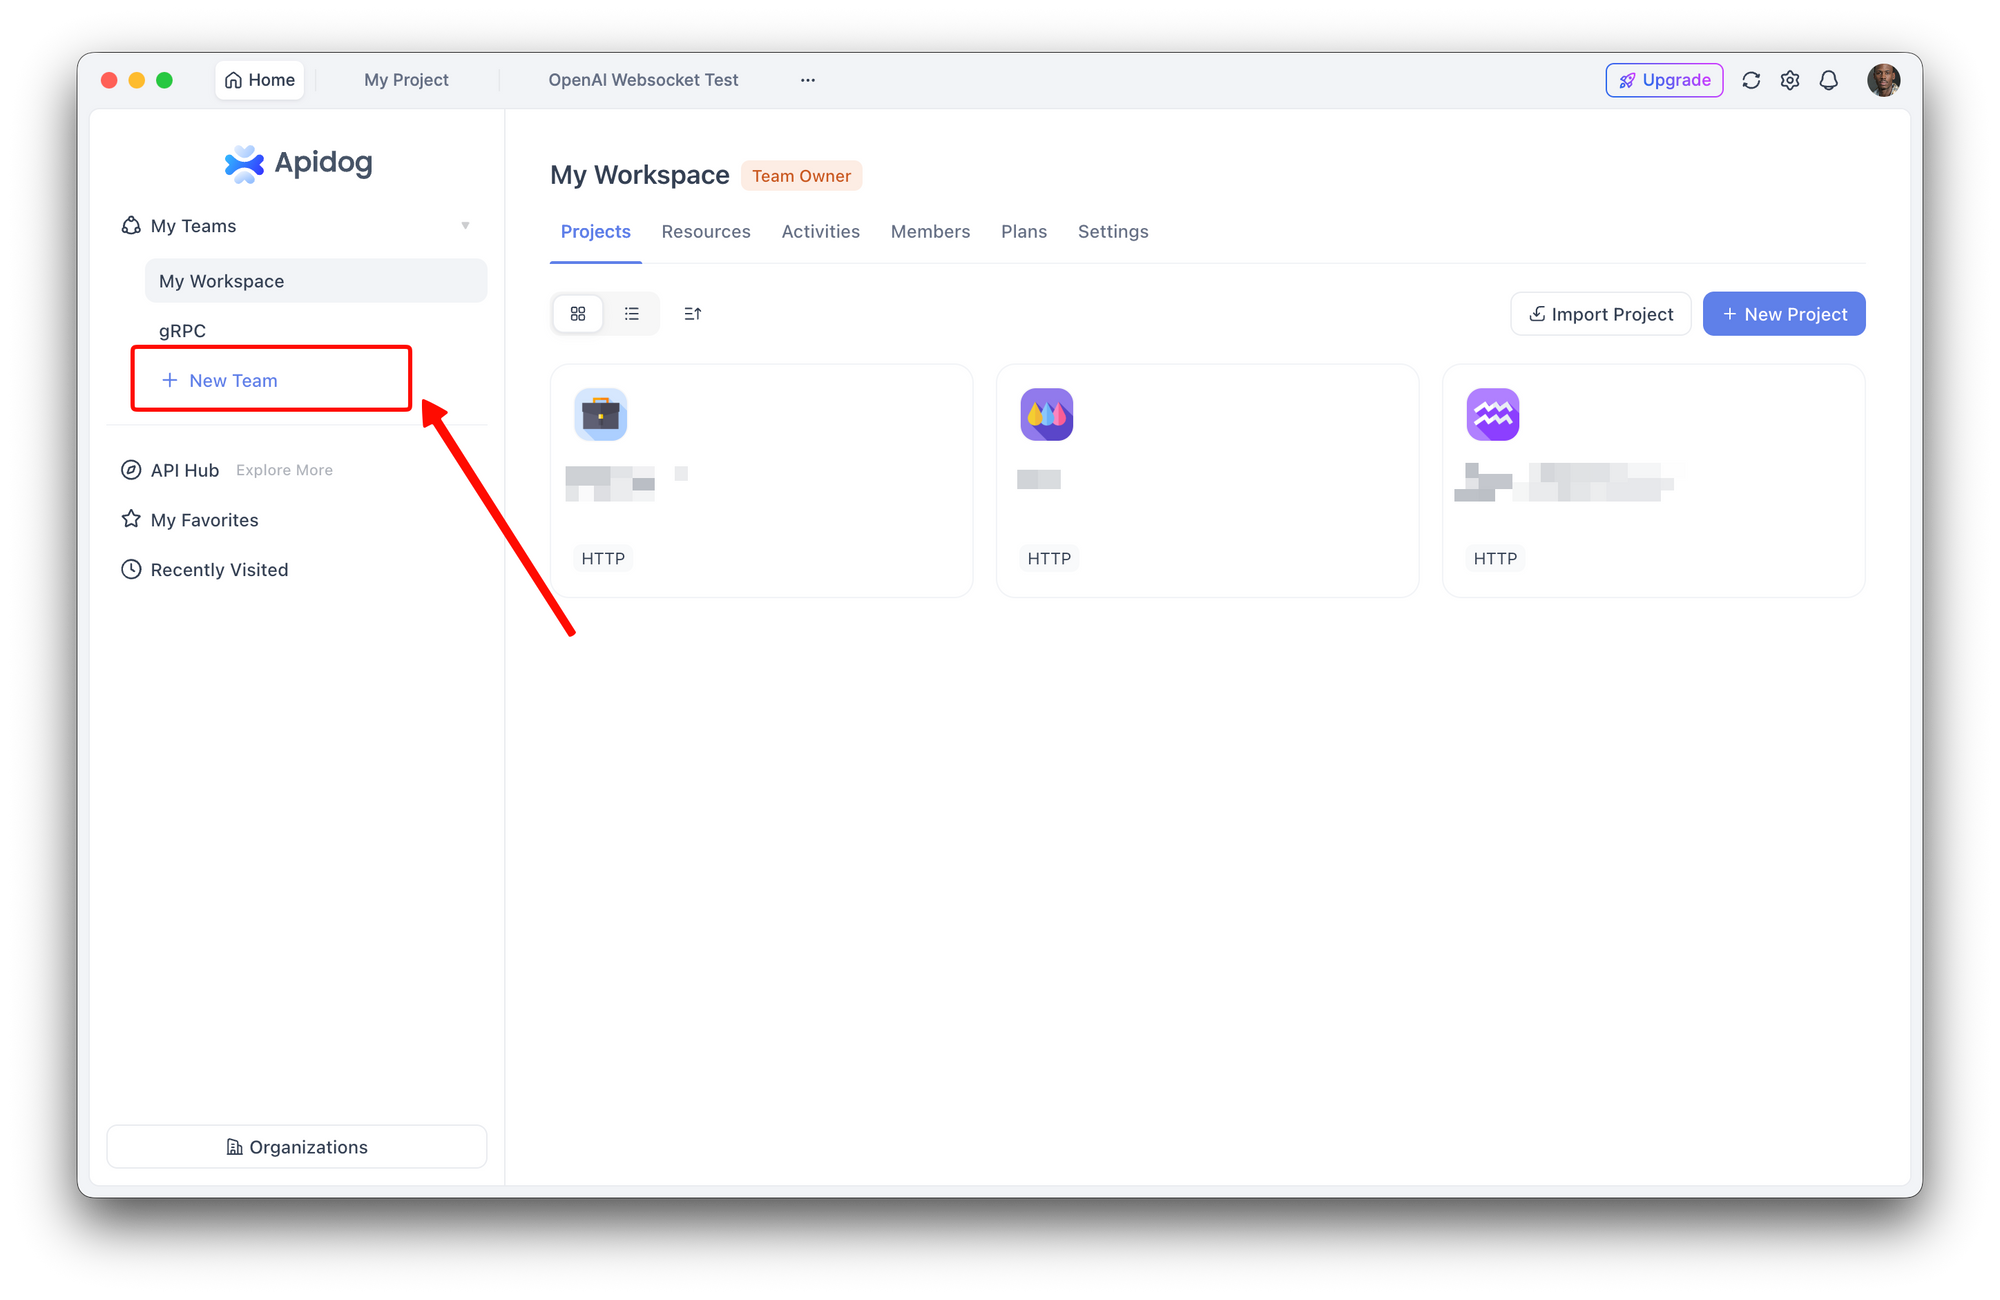
Étape 1 : Créer un nouvel espace de travail
Dans Apidog, créez un espace de travail nommé "Comparaison de Modèles d'IA" pour organiser vos requêtes de test.
Étape 2 : Configurer les variables d'environnement
Accédez à Environnements → Créez des variables d'environnement pour chaque clé API :
GEMINI_API_KEY=your_google_api_key_here
CLAUDE_API_KEY=your_anthropic_api_key_here
OPENAI_API_KEY=your_openai_api_key_here
Cela maintient les identifiants sécurisés et facilite le passage entre les clés de développement et de production.
Étape 3 : Ajouter le point de terminaison Gemini 3.1 Pro
Créez une nouvelle requête POST :
URL: https://generativelanguage.googleapis.com/v1beta/models/gemini-3.1-pro:generateContent
Headers:
  x-goog-api-key: {{GEMINI_API_KEY}}
  Content-Type: application/json

Body:
{
  "contents": [{
    "parts": [{
      "text": "Écrire une fonction Python pour vérifier si un nombre est premier."
    }]
  }],
  "generationConfig": {
    "temperature": 0.7,
    "maxOutputTokens": 2048
  }
}
Étape 4 : Ajouter le point de terminaison Claude Opus 4.6
Créez une nouvelle requête POST :
URL: https://api.anthropic.com/v1/messages
Headers:
  x-api-key: {{CLAUDE_API_KEY}}
  anthropic-version: 2023-06-01
  Content-Type: application/json

Body:
{
  "model": "claude-opus-4-6-20260205",
  "max_tokens": 2048,
  "messages": [{
    "role": "user",
    "content": "Écrire une fonction Python pour vérifier si un nombre est premier."
  }]
}
Étape 5 : Ajouter le point de terminaison GPT-5.3 Codex
Créez une nouvelle requête POST :
URL: https://api.openai.com/v1/chat/completions
Headers:
  Authorization: Bearer {{OPENAI_API_KEY}}
  Content-Type: application/json

Body:
{
  "model": "gpt-5.3-codex",
  "messages": [{
    "role": "user",
    "content": "Écrire une fonction Python pour vérifier si un nombre est premier."
  }],
  "temperature": 0.7,
  "max_tokens": 2048
}
Comparer la qualité de réponse
Avec les trois points de terminaison configurés, vous pouvez :
- Envoyer des invites identiques à chaque modèle
- Comparer les temps de réponse dans le panneau de réponse d'Apidog
- Analyser l'utilisation des tokens à partir des en-têtes de réponse
- Évaluer la qualité du code côte à côte
- Suivre les coûts à l'aide des décomptes de tokens et des données de tarification
Astuce de pro : Utilisez les scénarios de test d'Apidog pour automatiser cette comparaison sur plusieurs invites, vous fournissant des données de qualité statistiquement significatives.
Surveiller l'utilisation des tokens et les coûts
Ajoutez des scripts post-requête pour calculer les coûts automatiquement :
// Exemple pour Gemini 3.1 Pro
const inputTokens = pm.response.json().usageMetadata.promptTokenCount;
const outputTokens = pm.response.json().usageMetadata.candidatesTokenCount;
const cost = (inputTokens * 0.000002) + (outputTokens * 0.000012);

console.log(`Tokens utilisés : ${inputTokens} en entrée, ${outputTokens} en sortie`);
console.log(`Coût estimé : $${cost.toFixed(4)}`);
Cela vous donne une visibilité des coûts en temps réel pendant les tests.
Recommandations de cas d'utilisation
Après avoir analysé les benchmarks, les fonctionnalités et les retours des développeurs, voici quand utiliser chaque modèle :
Utiliser Gemini 3.1 Pro pour :
Codage algorithmique et programmation compétitive
- Problèmes de type LeetCode
- Optimisation d'algorithmes
- Calculs mathématiques
- Implémentations de structures de données
Raison : Les scores les plus élevés à ARC-AGI-2 et LiveCodeBench démontrent un raisonnement supérieur pour les problèmes nouveaux.
Analyse de grandes bases de code
- Refactoring à l'échelle du dépôt
- Analyse de dépendances
- Revues d'architecture
- Audits de sécurité
Raison : Fenêtre de contexte de 1M tokens (standard, non bêta) + coût le plus bas pour les tâches à contexte long.
Développement multimodal
- Conversion de designs en code
- Analyse de diagrammes d'architecture
- Extraction d'exigences à partir de vidéos
- Débogage par capture d'écran
Raison : Support multimodal natif pour les images, l'audio et la vidéo.
Projets sensibles aux coûts
- Appels API à volume élevé
- Prototypage et expérimentation
- Cas d'utilisation éducatifs
- Start-ups soucieuses de leur budget
Raison : 2 $/12 $ par million de tokens est 7 fois moins cher que Claude Opus 4.6.
Utiliser Claude Opus 4.6 pour :
Projets greenfield et travail créatif
- Développement de nouvelles fonctionnalités
- Implémentation UI/UX
- Conception d'architecture
- Conception d'API
Raison : Les développeurs rapportent que Claude produit un code plus "poli et contextuellement approprié" pour les tâches créatives.
Tâches complexes à plusieurs étapes
- Grands projets de refactoring
- Migration entre frameworks
- Conception de systèmes
- Implémentation de fonctionnalités de bout en bout
Raison : Les Équipes d'Agents et le mode de pensée adaptative gèrent mieux la planification complexe.
Génération de code long
- Génération d'applications complètes
- Documentation complète
- Implémentations de modules complets
- Création de suites de tests
Raison : La limite de 128K tokens de sortie permet de générer des applications complètes en une seule réponse.
Qualité avant la vitesse
- Code de production
- Fonctionnalités client
- Systèmes critiques
- Code que vous maintiendrez à long terme
Raison : Les évaluateurs humains préfèrent constamment la qualité de sortie de Claude (GDPval-AA : 1606 Elo).
Utiliser GPT-5.3 Codex pour :
Workflows de terminal et de ligne de commande
- Scripting shell
- Configuration de pipelines CI/CD
- Automatisation DevOps
- Tâches d'administration système
Raison : Score de 77,3 % au Terminal-Bench 2.0 — le plus élevé avec une marge significative.
Revue et analyse de code
- Revues de pull request
- Critique architecturale
- Analyse des vulnérabilités de sécurité
- Recherche de cas limites
Raison : Capacités de diffs profonds et optimisations pour la revue de code.
Débogage interactif
- Dépannage en temps réel
- Débogage pas à pas
- Optimisation des performances
- Affinement itératif
Raison : La direction interactive permet une correction en cours d'exécution.
Refactoring de code existant
- Modernisation de bases de code existantes
- Mises à jour de dépendances
- Nettoyage de code
- Améliorations des performances
Raison : Excelle à comprendre les schémas existants et à appliquer des changements cohérents.
Stratégies multi-modèles
De nombreux développeurs professionnels utilisent plusieurs modèles ensemble :
Stratégie 1 : Routage de modèle par type de tâche
- Claude Opus 4.6 pour le développement de fonctionnalités
- GPT-5.3 Codex pour la revue de code
- Gemini 3.1 Pro pour les défis algorithmiques
Stratégie 2 : Optimisation des coûts
- Commencez avec Gemini 3.1 Pro (le moins cher)
- Passez à Claude Opus 4.6 si Gemini échoue
- Utilisez Codex pour les tâches spécifiques au terminal
Stratégie 3 : Consensus sur la qualité
- Générer des solutions avec les trois modèles
- Comparer les sorties
- Choisir la meilleure ou synthétiser une approche hybride
Expériences réelles de développeurs
Au-delà des benchmarks, comment les développeurs utilisent-ils réellement ces modèles ?
Étude de cas : Livrer 93 000 lignes en 5 jours
Un développeur a documenté l'utilisation de Claude Opus 4.6 pour livrer 93 000 lignes de code en 5 jours, incluant 44 pull requests. Le workflow reposait sur les Équipes d'Agents — un agent écrivant du code pendant qu'un autre écrivait des tests et un troisième révisait les problèmes de sécurité.
Point clé : Le mode de pensée adaptatif a réduit les itérations, permettant de livrer plus de fonctionnalités dès la première tentative.
Points faibles courants
À travers les forums de développeurs et les études de cas, des thèmes communs émergent :
Gemini 3.1 Pro :
- Produit parfois des explications verbeuses alors que vous voulez juste du code
- Les fonctionnalités multimodales nécessitent une ingénierie d'invite minutieuse
- Sorties moins raffinées sur des tâches subjectives
Claude Opus 4.6 :
- Le coût plus élevé devient prohibitif pour une utilisation à volume élevé
- Le contexte de 1M est toujours en bêta (disponibilité non garantie)
- Temps de réponse plus lents que les concurrents
GPT-5.3 Codex :
- L'accès à l'API est toujours en cours de déploiement (pas encore universellement disponible)
- Prix non annoncés, créant une incertitude budgétaire
- Les fonctionnalités interactives nécessitent un travail d'intégration
Modèles de commutation
Les développeurs rapportent commencer avec un modèle et changer lorsque :
- Le coût s'accumule : Commencez avec Gemini, passez à Claude pour les tâches critiques en qualité
- La tâche change : Utilisez Codex pour le travail terminal, Claude pour le développement créatif
- La qualité n'est pas adéquate : Passez des modèles moins chers aux plus chers
Comment démarrer
Prêt à tester ces modèles par vous-même ? Voici comment commencer avec chacun :
Démarrer avec Gemini 3.1 Pro
Accès :
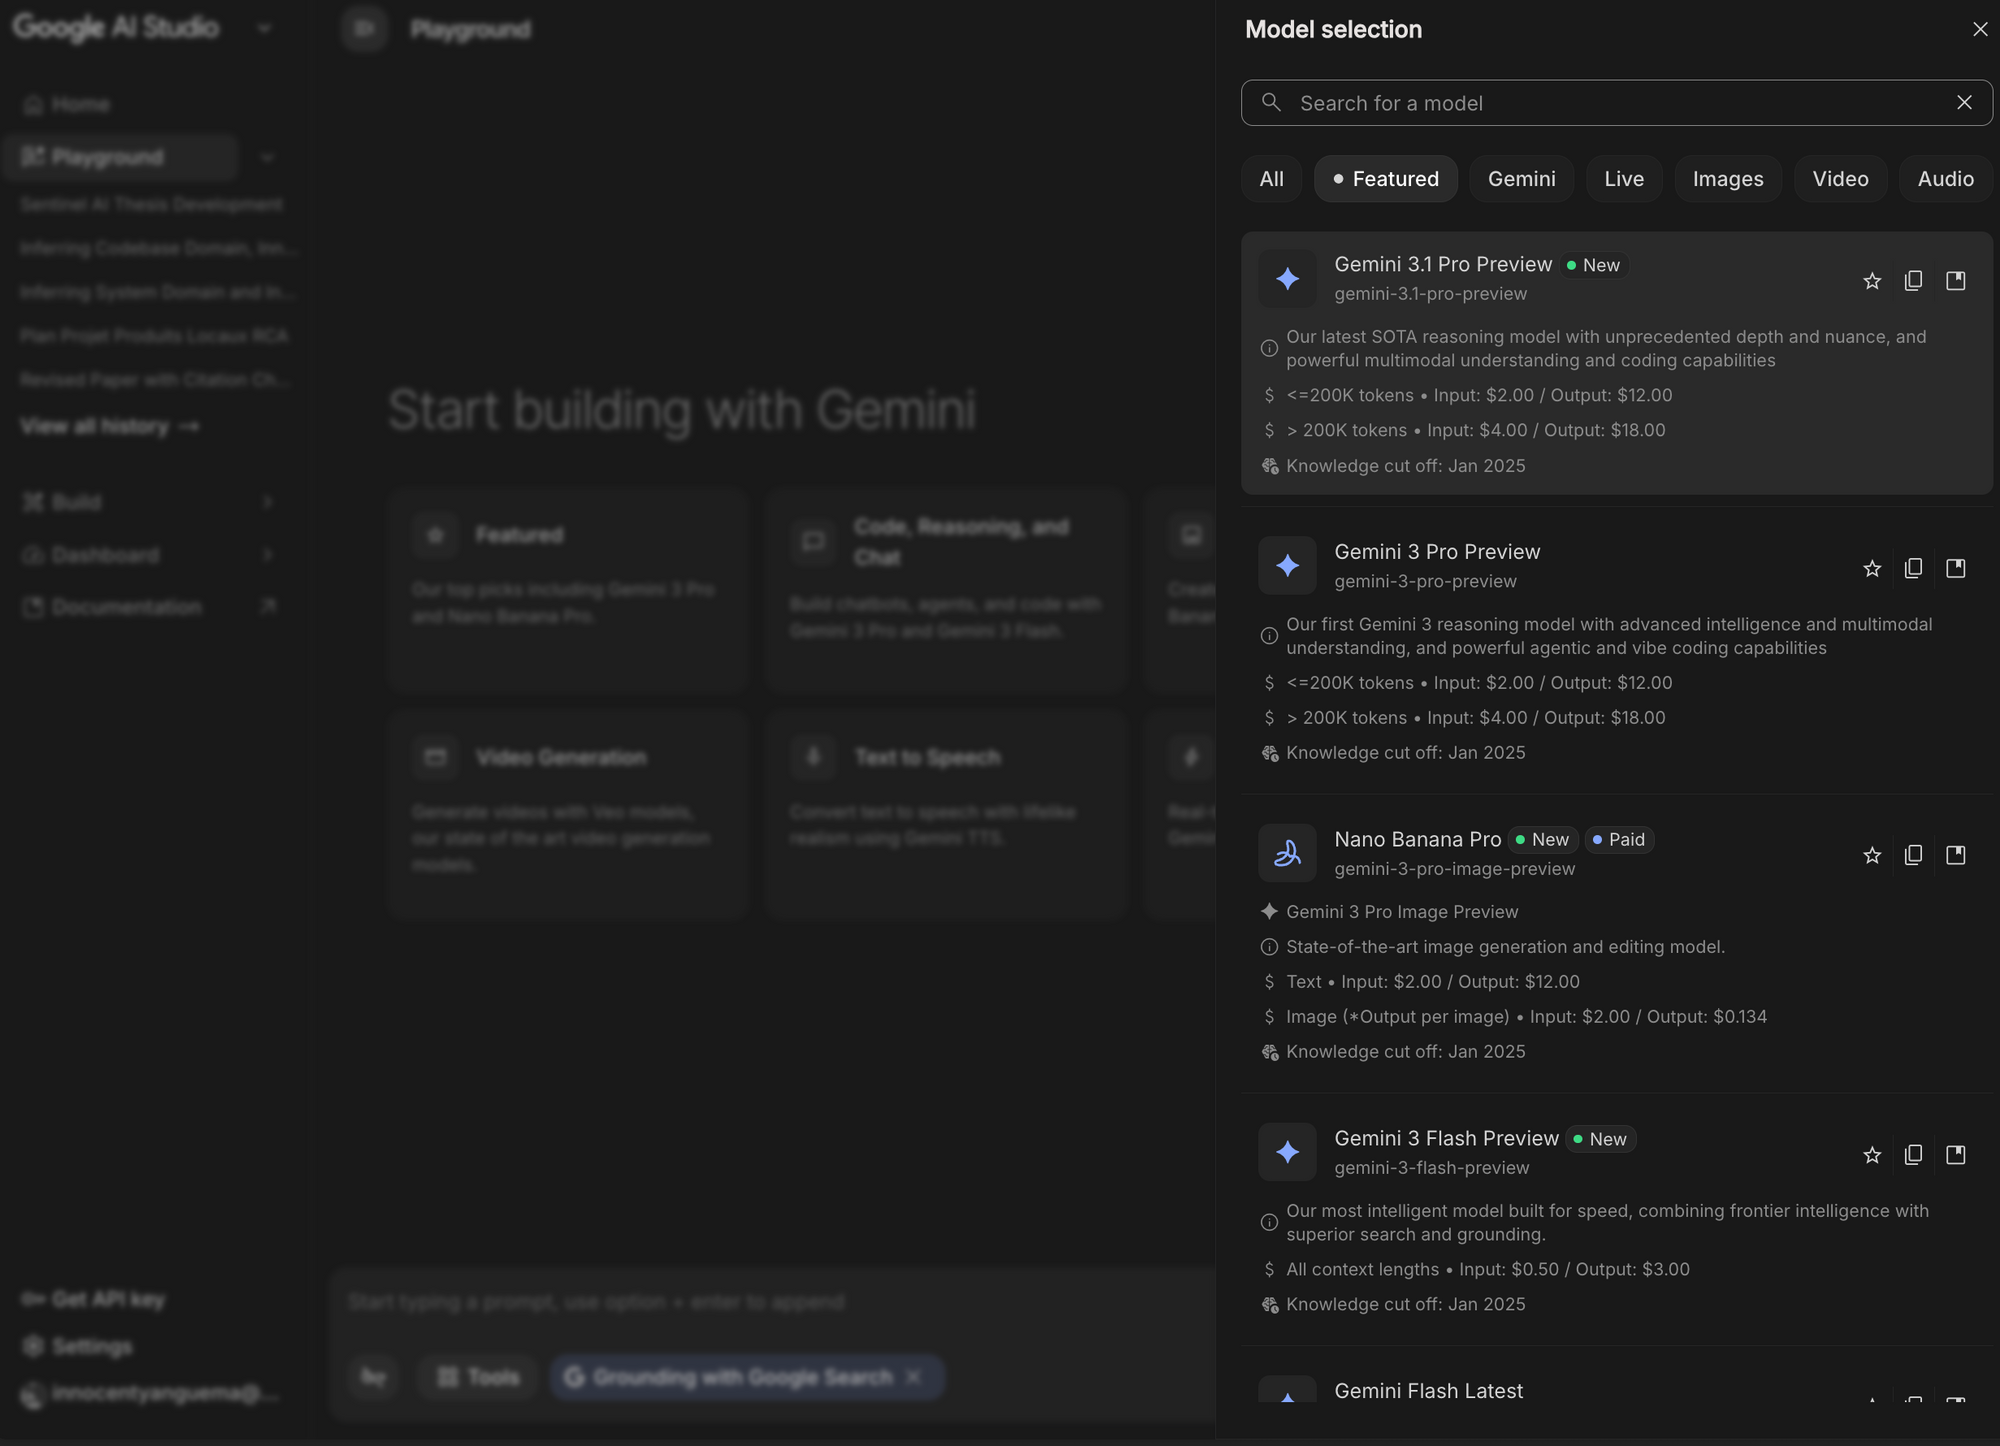
- Google AI Studio (interface web)
- API Gemini (nécessite un compte Google Cloud)
- Vertex AI (clients entreprise)
- GitHub Copilot (préversion, au 19 fév.)
Authentification :
- Visitez Google AI Studio
- Créez une clé API
- Utilisez la clé dans l'en-tête
x-goog-api-key
Première requête API :
curl https://generativelanguage.googleapis.com/v1beta/models/gemini-3.1-pro:generateContent \
  -H "x-goog-api-key: YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "contents": [{
      "parts": [{"text": "Écrire une fonction Python pour inverser une chaîne."}]
    }]
  }'
Tarification : Paiement à l'utilisation, 2 $/12 $ par million de tokens
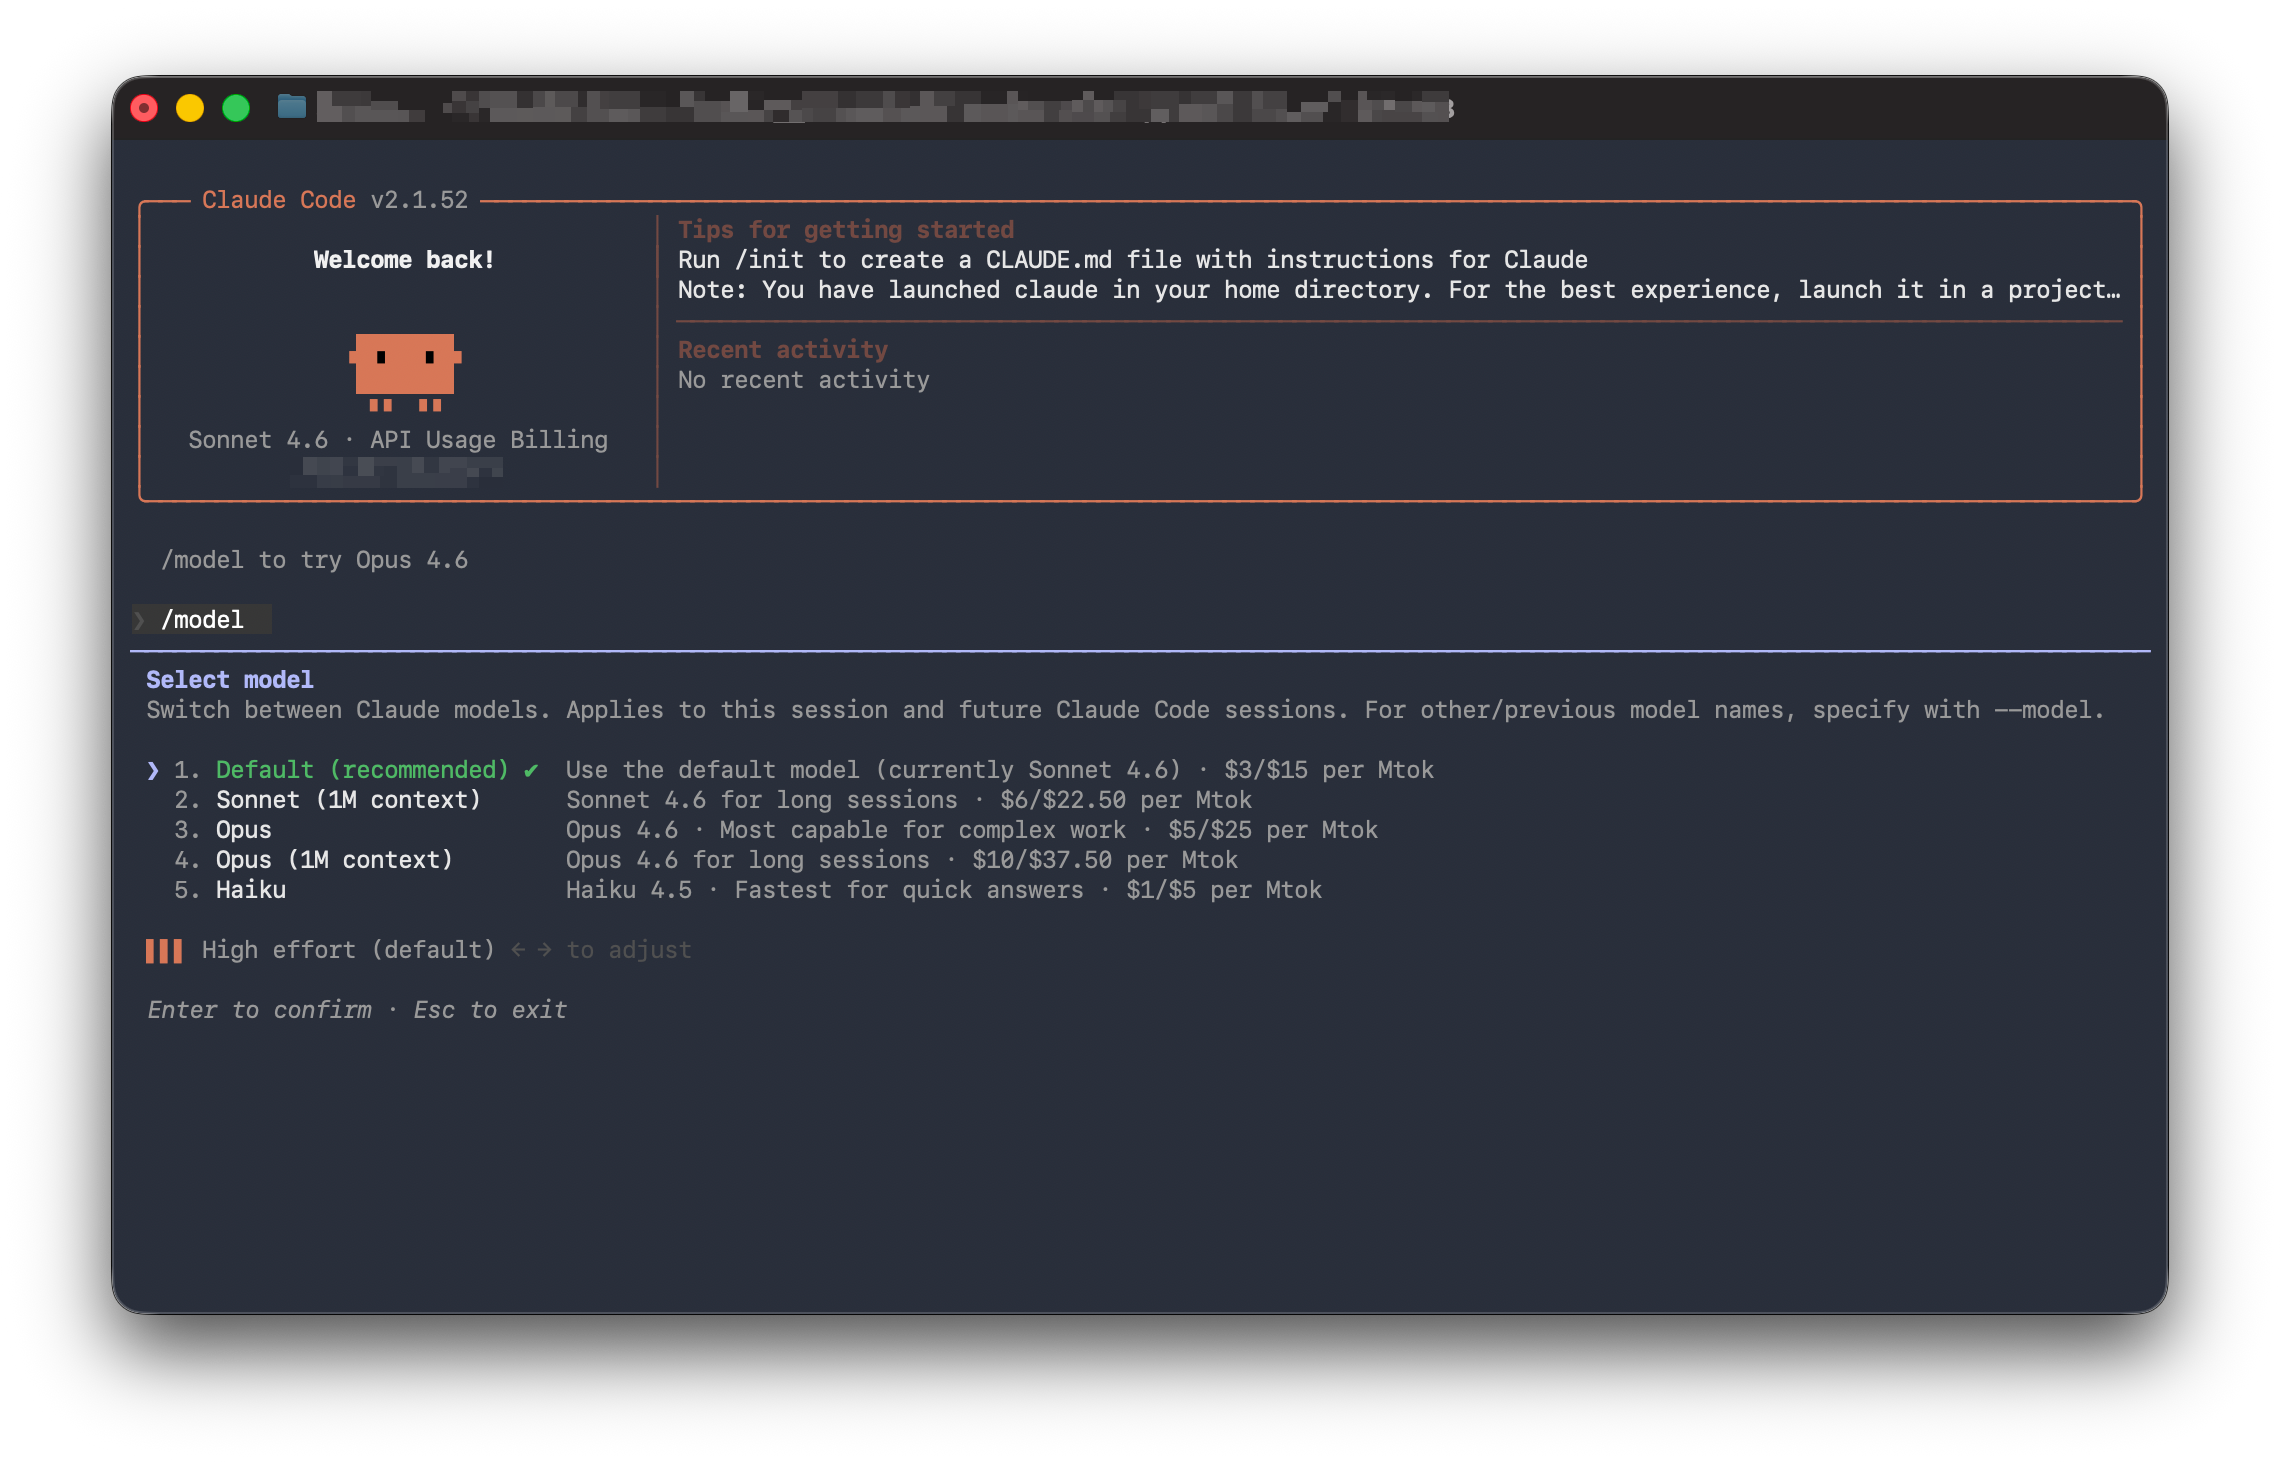
Démarrer avec Claude Opus 4.6
Accès :
- claude.ai (interface web, niveau gratuit disponible)
- API Anthropic (accès API direct)
- AWS Bedrock (clients AWS)
- Google Cloud Vertex AI
- Microsoft Foundry sur Azure
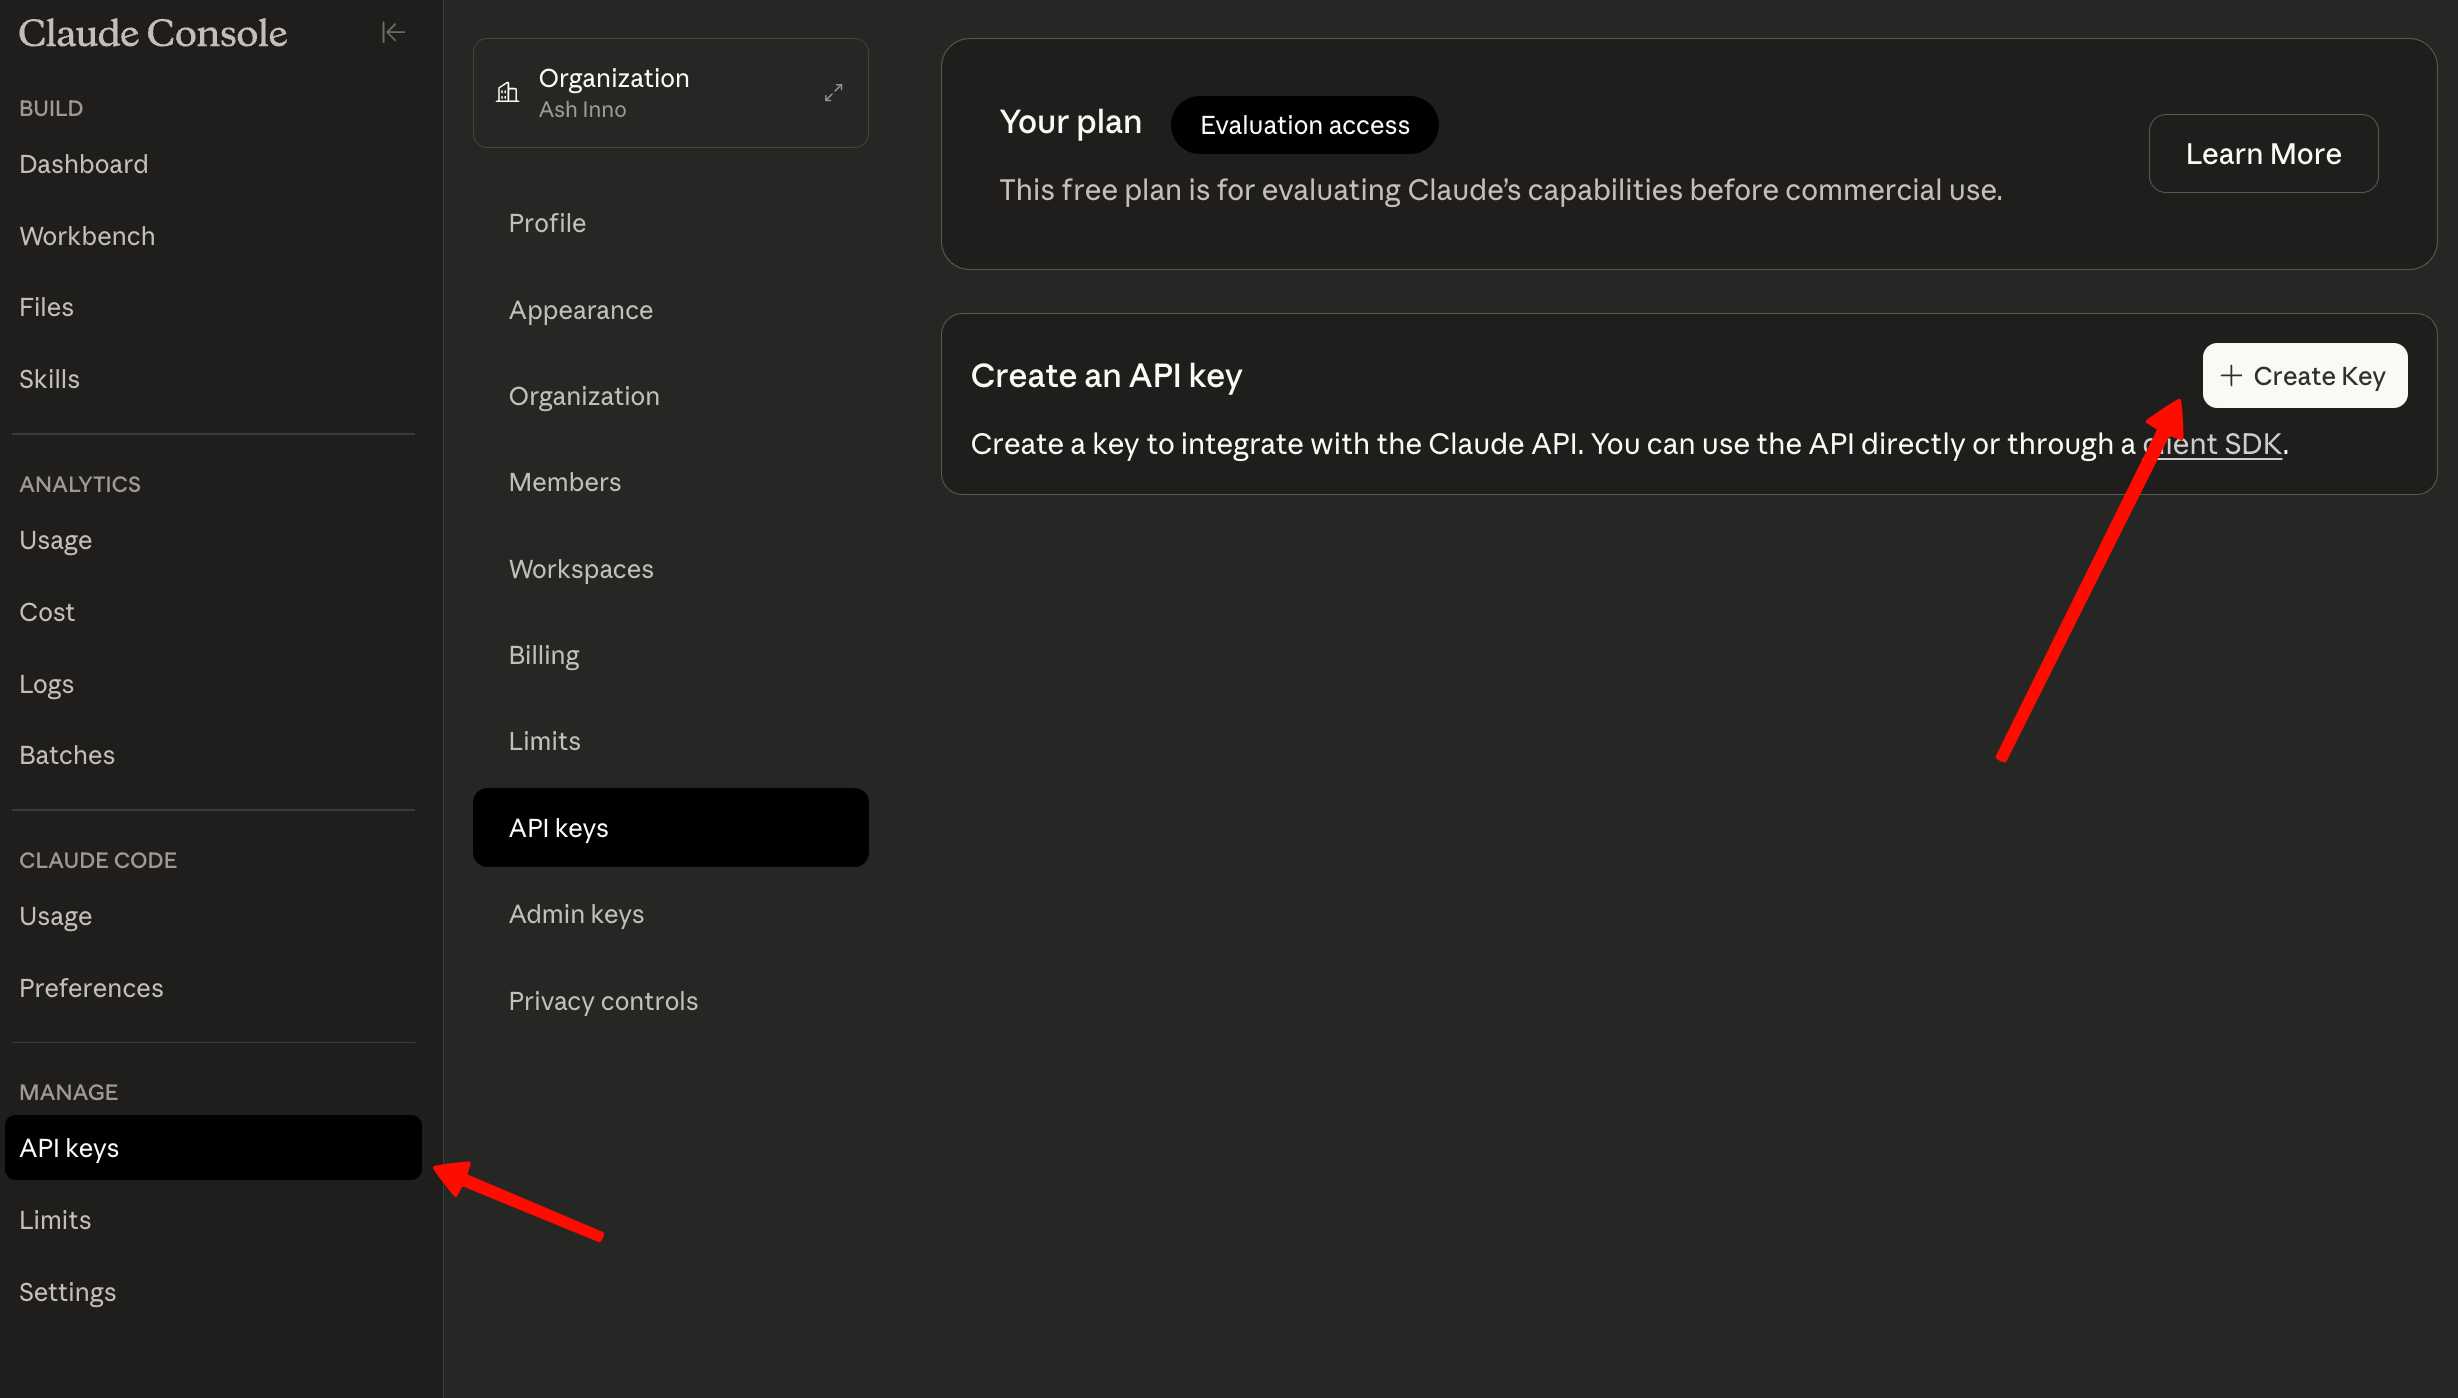
Authentification :
- Visitez platform.claude.com
- Générez une clé API
- Utilisez la clé dans l'en-tête
x-api-key
Première requête API :
curl https://api.anthropic.com/v1/messages \
  -H "x-api-key: YOUR_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "claude-opus-4-6-20260205",
    "max_tokens": 1024,
    "messages": [{
      "role": "user",
      "content": "Écrire une fonction Python pour inverser une chaîne."
    }]
  }'
Tarification : 5 $/25 $ par million de tokens (10 $/37,50 $ pour >200K de contexte)
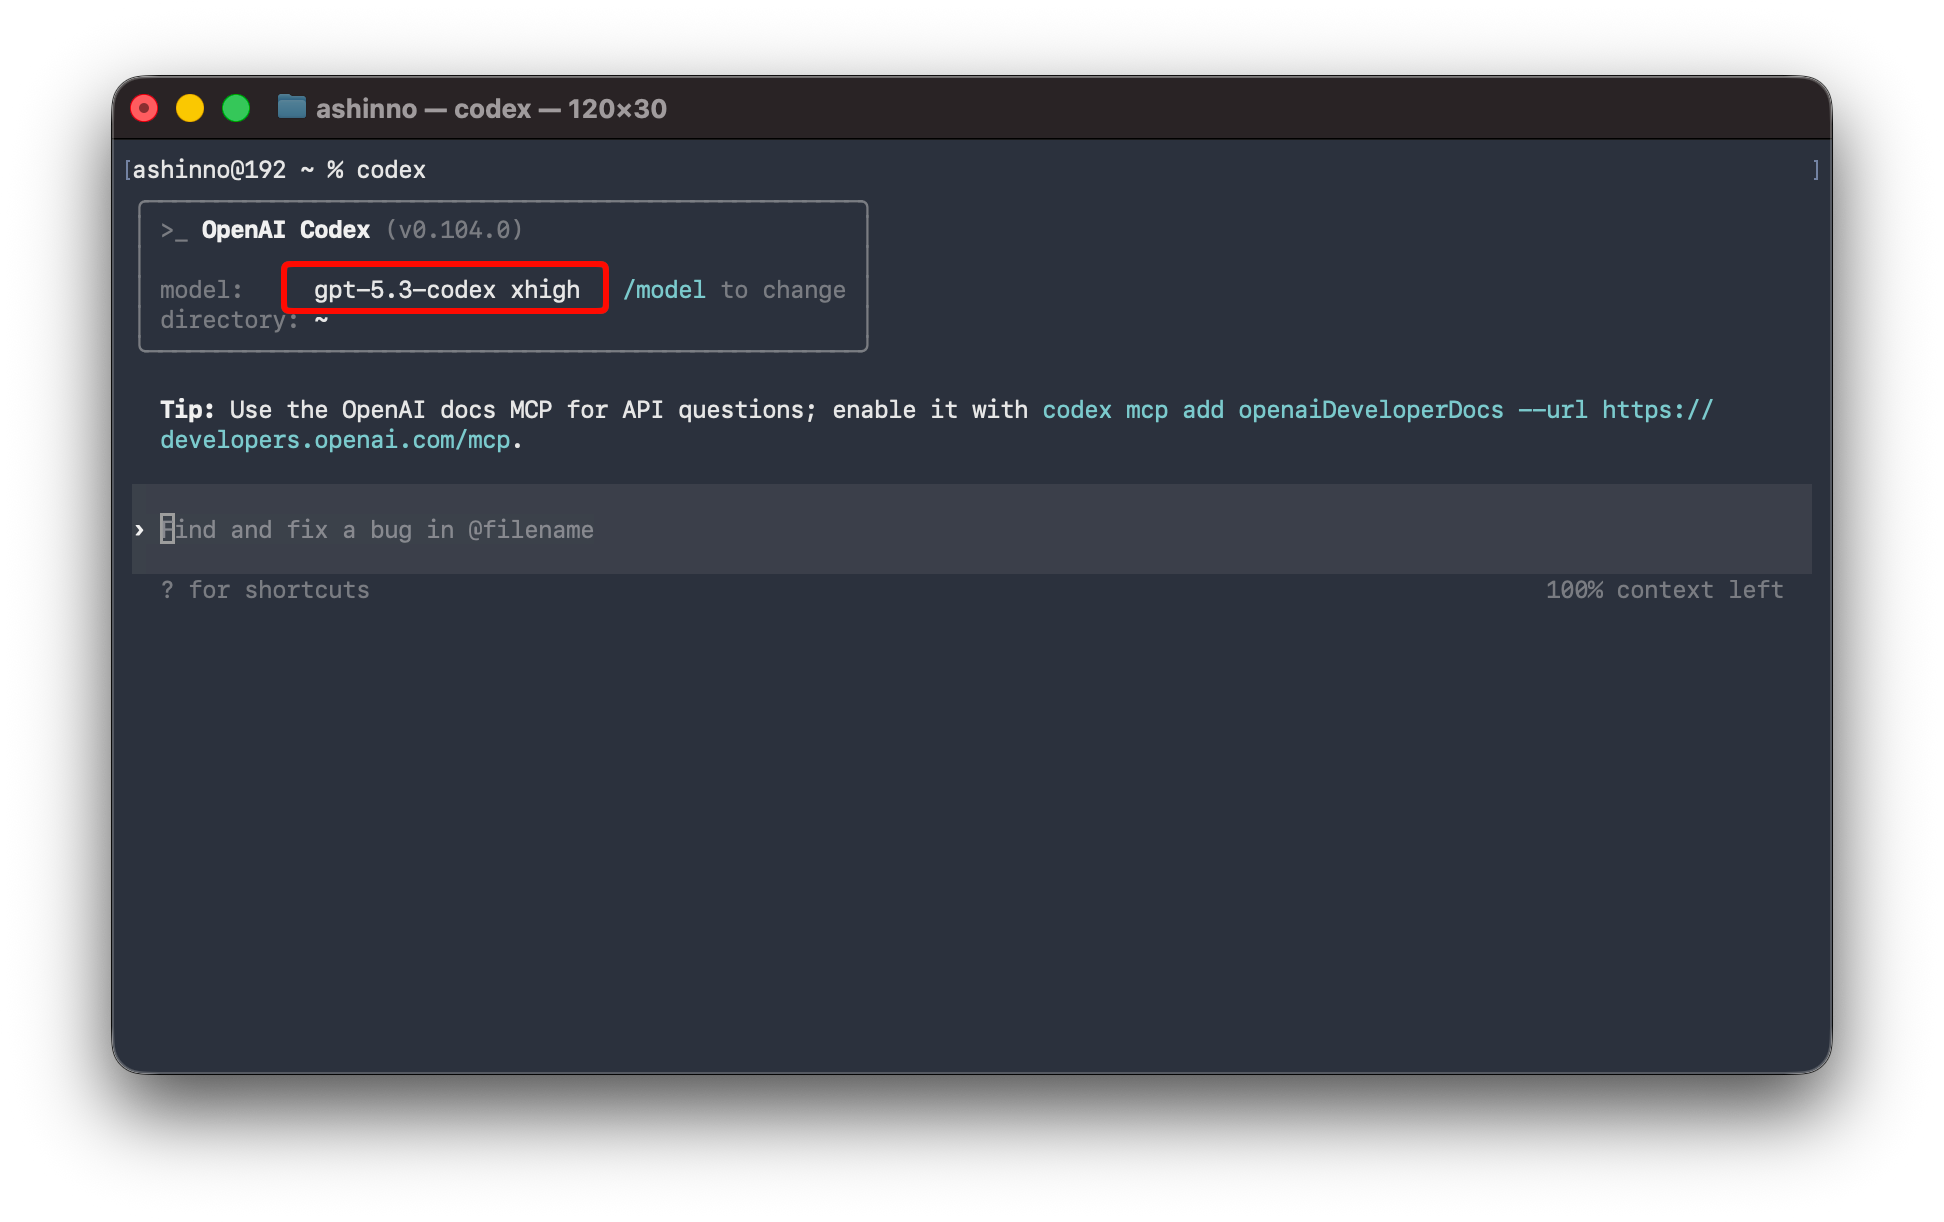
Démarrer avec GPT-5.3 Codex
Accès :
- ChatGPT Plus (interface web, mode Codex)
- API OpenAI (en cours de déploiement, vérifiez la disponibilité)
- GitHub Copilot (généralement disponible au 9 fév.)
- Outil CLI Codex (téléchargeable depuis OpenAI)
Authentification :
- Visitez platform.openai.com
- Générez une clé API
- Utilisez la clé dans l'en-tête
Authorization: Bearer
Première requête API (lorsque l'accès API est disponible) :
curl https://api.openai.com/v1/chat/completions \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-5.3-codex",
    "messages": [{
      "role": "user",
      "content": "Écrire une fonction Python pour inverser une chaîne."
    }]
  }'
Tarification : Pas encore annoncée (actuellement incluse avec ChatGPT Plus pour l'accès web)
Tester les trois dans Apidog
La façon la plus rapide de comparer les trois modèles :
- Importez la collection de modèles d'IA depuis la bibliothèque de modèles d'Apidog (si disponible)
- Configurez les variables d'environnement pour les trois clés API
- Exécutez des scénarios de test avec des invites identiques pour tous les modèles
- Comparez les temps de réponse, l'utilisation des tokens et la qualité de la sortie
- Surveillez les coûts à l'aide des fonctionnalités de suivi des coûts d'Apidog
Cela vous fournit des données empiriques pour faire un choix éclairé pour votre cas d'utilisation spécifique.
Conclusion
Les lancements de modèles d'IA de février 2026 marquent un tournant : nous sommes passés de "quel modèle est le meilleur ?" à "quel modèle est le meilleur pour cette tâche spécifique ?"
Le verdict :
- Gemini 3.1 Pro est le champion du rapport qualité-prix pour les tâches exigeantes en raisonnement, offrant des coûts 7 fois inférieurs avec des scores de référence de pointe en codage algorithmique
- Claude Opus 4.6 est le champion de la qualité pour l'ingénierie logicielle du monde réel, les évaluateurs humains préférant constamment ses sorties raffinées et contextuellement appropriées
- GPT-5.3 Codex est le champion spécialiste des workflows terminaux et du débogage interactif, offrant des fonctionnalités uniques telles que la direction en cours d'exécution
Plutôt que de choisir un seul modèle, les développeurs professionnels utilisent de plus en plus plusieurs modèles ensemble — routant les tâches vers le modèle optimal ou utilisant des approches de consensus pour le code critique.
La façon la plus rapide de déterminer quel modèle fonctionne le mieux pour votre workflow est de tester les trois avec vos cas d'utilisation réels. L'espace de travail unifié d'Apidog facilite cela — configurez les trois points de terminaison API, configurez vos clés API une seule fois, et envoyez des invites identiques pour comparer la qualité de réponse, la vitesse et le coût en temps réel.
Prêt à comparer ces modèles d'IA pour votre cas d'utilisation spécifique ? Importez vos collections d'API existantes dans l'espace de travail d'Apidog en 60 secondes et testez Gemini 3.1 Pro, Claude Opus 4.6 et GPT-5.3 Codex côte à côte sans nécessiter de code.
Essayez Apidog gratuitement — aucune carte de crédit requise.