
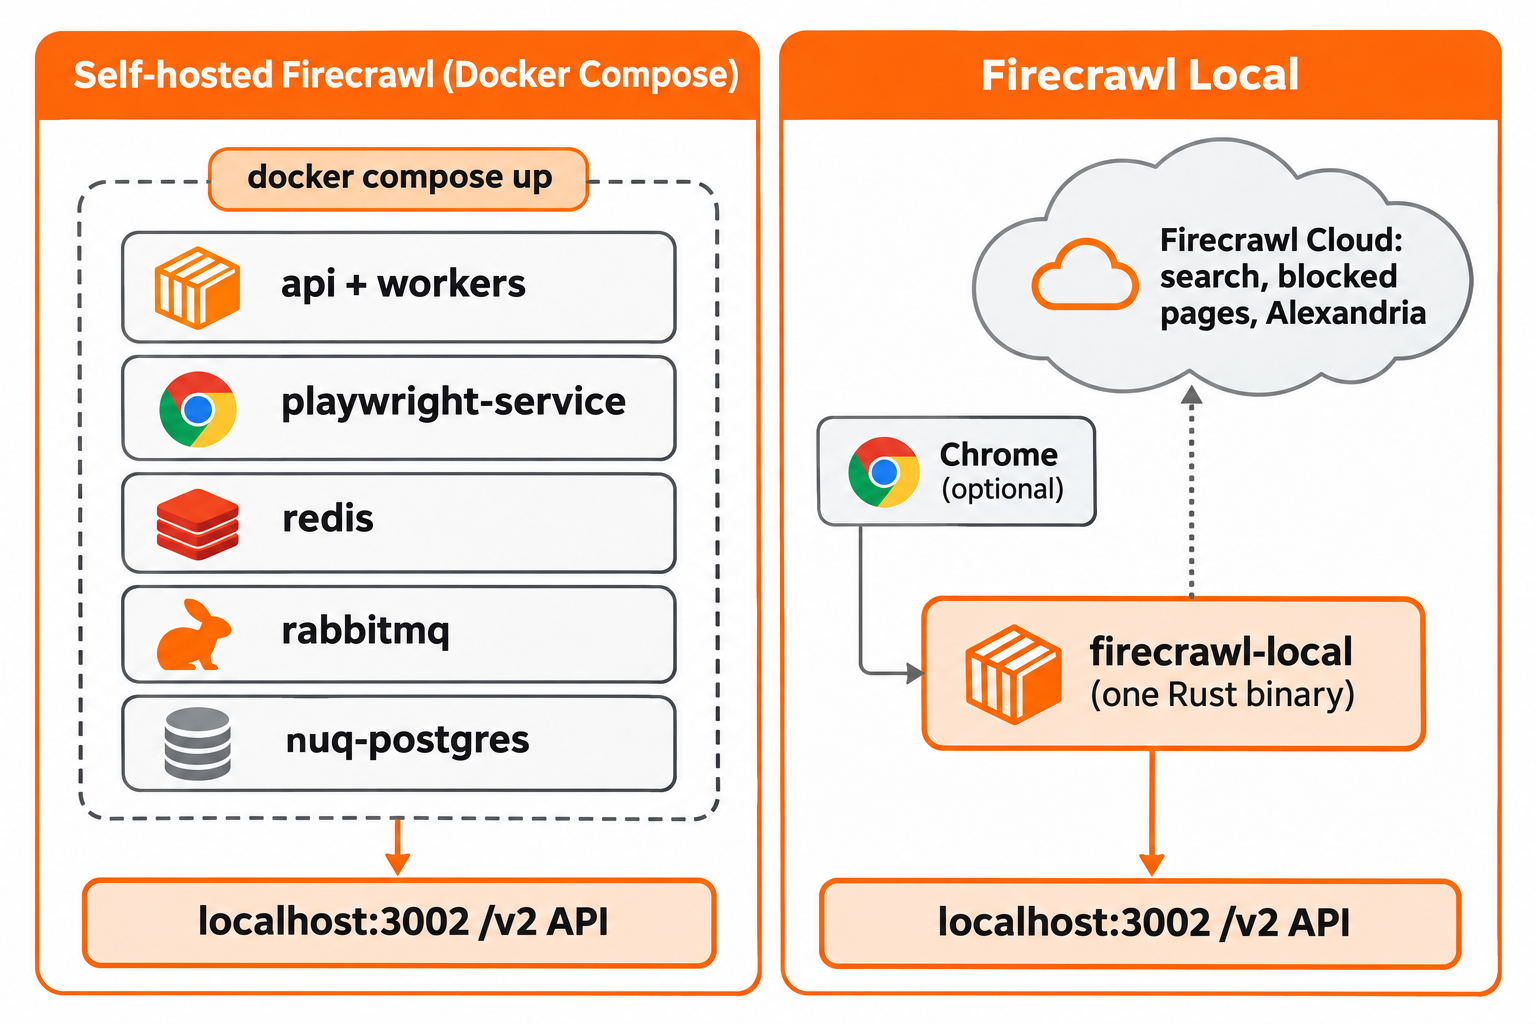
Firecrawl auto-hébergé ne signifiait qu'une seule chose : cloner le dépôt, lancer Docker Compose et maintenir en vie une API, un service Playwright, Redis, RabbitMQ et Postgres sur votre machine. Le 18 novembre 2026, Firecrawl a livré une seconde option. Firecrawl Local est un unique binaire Rust qui scrape, crawle et mappe des sites vers du markdown et répond à la même API v2 sur localhost:3002, sans base de données, file d'attente ni conteneur.
Réponse rapide : choisissez Firecrawl Local si vous voulez faire du scrape, du crawl, du map et du batch scrape sur un ordinateur portable ou dans la boîte à outils d'un agent sans aucune infrastructure. Conservez la stack Docker auto-hébergée si vous avez besoin de jobs persistants, des formats json et summary, d'une extraction LLM via votre propre modèle, ou d'une route de recherche qui ne touche jamais Firecrawl Cloud.
Qu'est-ce que Firecrawl auto-hébergé, et qu'est-ce que Firecrawl Local ?
Firecrawl auto-hébergé, c'est le serveur Firecrawl complet de apps/api, exécuté sur votre propre infrastructure avec Docker Compose. Firecrawl Local est une build distincte et plus légère dans apps/local : un seul binaire qui récupère et nettoie les pages sur votre machine à l'aide du même code de nettoyage HTML, et délègue la recherche, les pages bloquées et Alexandria à Firecrawl Cloud.
Les deux vivent dans le dépôt GitHub Firecrawl, les deux servent l'API v2 sur le port 3002, et les deux sont open source sous AGPL-3.0. Firecrawl Local ne remplace pas le serveur. Le README de Firecrawl Local le dit sans détour : le guide d'auto-hébergement « vit dans apps/api et n'est pas modifié par Firecrawl Local ».
Vous découvrez Firecrawl ? Commencez par notre guide de web scraping Firecrawl.
Firecrawl Local vs Firecrawl auto-hébergé en un coup d'œil
En voici la version courte, construite à partir du guide d'auto-hébergement, de la page open source vs cloud et du README de Local, tous consultés le 19 novembre 2026.
| Firecrawl auto-hébergé | Firecrawl Local | |
|---|---|---|
| Ce que vous exécutez | Stack Docker Compose : api, playwright-service, redis, rabbitmq, nuq-postgres | Un seul binaire, firecrawl-local |
| Installation | git clone, création du .env, docker compose up --build -d |
cargo install firecrawl-local |
| Prérequis | Git, Docker Engine, Compose v2 | Rust et un compilateur C ; Chrome et Node 22+ en option |
| API | v2 sur le port 3002 | v2 sur le port 3002 (scrape, map, crawl, batch scrape, health) |
| Route de recherche | Incluse dans la stack par défaut | Transférée à Firecrawl Cloud |
Formats LLM (json, summary) |
Connecter un fournisseur compatible OpenAI ou Ollama | Ignorés avec un avertissement |
| Captures d'écran | Nécessitent Fire-engine, absent de la stack par défaut | Fonctionnent si Chrome est installé |
actions du navigateur |
Nécessitent Fire-engine | Ignorées |
| Stockage des jobs | File d'attente adossée à Postgres | En mémoire, expire au bout d'une heure |
| Alexandria | Non listé dans le tableau des fonctionnalités auto-hébergées | Via Firecrawl Cloud avec un compte gratuit |
| Configuration MCP | Pointer le serveur MCP vers votre URL | firecrawl-local init écrit la configuration |
| Licence | AGPL-3.0 | AGPL-3.0 |
Local échange de la profondeur contre de la légèreté : il conserve les routes que les agents appellent le plus souvent et abandonne ce qui nécessite une file d'attente, un modèle ou une batterie de navigateurs.
Ce qui a changé : de cinq services à un seul binaire
Le parcours auto-hébergé épingle la version v2.11.162 dans son guide. Vous clonez le dépôt, écrivez un petit .env avec les identifiants Postgres et USE_DB_AUTHENTICATION=false, puis construisez et démarrez la stack :
git clone https://github.com/firecrawl/firecrawl.git
cd firecrawl
git checkout v2.11.162
docker compose up --build -d
docker compose ps --all
Ce fichier compose démarre un conteneur api (il fait aussi tourner les workers), un playwright-service pour le rendu, puis redis, rabbitmq et nuq-postgres pour la file d'attente des jobs. Le fichier compose plafonne l'API à 4 CPU et 8 Go de mémoire, et le service Playwright à 2 CPU et 4 Go ; le guide précise que ces limites « ne sont pas des exigences minimales vérifiées ».
Firecrawl Local résume tout cela en une seule commande :
cargo install firecrawl-local
firecrawl-local scrape https://example.com --markdown
firecrawl-local crawl https://docs.firecrawl.dev --limit 50 --out ./pages
firecrawl-local map https://firecrawl.dev
firecrawl-local serve
Pas de .env, pas de conteneurs. Les pages JavaScript sont rendues dans le Chrome ou Chromium que vous possédez déjà ; sans lui, les pages statiques fonctionnent toujours et les autres renvoient un avertissement.
Les commandes search, find-tools, data et login atteignent Firecrawl Cloud. firecrawl-local login réutilise les identifiants du CLI hébergé, décrits dans notre guide d'installation du CLI Firecrawl.
Couverture des endpoints : ce que sert chacun
C'est là que les migrations cassent, alors vérifiez-le avant de changer l'URL de base d'un SDK.
Firecrawl Local sert ces routes sur votre machine :
POST /v2/scrapescrape une URLPOST /v2/mapliste les URL d'un sitePOST /v2/crawl, plusGETetDELETE /v2/crawl/{id}POST /v2/batch/scrape, plusGETetDELETE /v2/batch/scrape/{id}GET /health
Toutes les autres routes /v2, comme /v2/search, sont transmises à Firecrawl Cloud, sauf si FIRECRAWL_CLOUD en décide autrement. Les routes v0 et v1 ne sont pas servies du tout.
Firecrawl auto-hébergé couvre les fonctions de base scrape, crawl, map et search dans sa stack par défaut, d'après la page open source vs cloud. L'extraction assistée par LLM nécessite un fournisseur que vous connectez. Agent, Browser, Interact et le dashboard ne sont pas inclus.
Deux pièges concrets :
- Les health checks diffèrent. Le guide d'auto-hébergement vérifie la disponibilité sur
/v0/health/readiness. Firecrawl Local ne sert pas v0, utilisez doncGET /healthà la place. Pensez à mettre à jour vos moniteurs et les healthchecks de compose. - La recherche change d'endroit où elle s'exécute. Sur la stack Docker, la recherche reste sur votre infrastructure. Sur Local, elle part vers Firecrawl Cloud, et la recherche sans clé est limitée en débit. Définissez
FIRECRAWL_CLOUD=offsi rien ne doit quitter la machine ; la recherche cesse alors de fonctionner.
Vitesse et mémoire : lisez les affirmations avec attention
Le post de lancement sur X de Firecrawl affirme que Firecrawl Local est « une primitive de scrape en Rust 37 fois plus rapide (par rapport à l'auto-hébergé) » et utilise « 230 fois moins de mémoire (11 Mo au repos) ». Le post a attiré environ 324 000 vues et 3 200 likes le premier jour.
Considérez ces chiffres comme des affirmations de Firecrawl. Le README ne publie ni méthode de benchmark, ni ensemble de pages, ni matériel, nous ne pouvons donc pas vous dire ce que mesure le « 37x ». Ce que l'architecture confirme, c'est la direction : un processus inactif devrait peser bien moins lourd que cinq conteneurs dont les limites compose autorisent jusqu'à 12 Go rien qu'entre l'API et les services Playwright.
Si la vitesse décide de votre choix, mesurez-la sur vos propres URL. Lancez le même scrape contre les deux serveurs, comparez les temps et vérifiez que le markdown correspond. La section sur le CLI Apidog ci-dessous montre comment transformer cela en test reproductible.
Sécurité, renvoi vers le cloud et flux de données
L'auto-hébergement vous donne un contrôle total et une responsabilité totale. Le quickstart du guide désactive l'authentification et avertit que ce n'est « pas une architecture de production » : les volumes durables, l'authentification, TLS et la supervision sont donc à votre charge.
Firecrawl Local est livré avec des valeurs par défaut plus strictes, pensées pour une seule machine :
servese lie à127.0.0.1et refuse localhost ainsi que les adresses privées, sauf si vous passez--allow-private.- Les adresses link-local et de métadonnées cloud sont bloquées dans tous les modes, y compris après les redirections.
scrape,crawletmcpacceptent--public-only, que le README recommande lorsqu'un agent parcourt des sites auxquels vous ne faites pas confiance.- Les crawls respectent
robots.txt.
Le compromis, c'est le renvoi vers le cloud. Avec la valeur par défaut FIRECRAWL_CLOUD=auto, la recherche, les pages qui bloquent votre machine et Alexandria passent par Firecrawl Cloud. Ces résultats portent "source": "firecrawl-cloud". Définissez FIRECRAWL_CLOUD=search pour n'autoriser que la recherche, ou off pour n'envoyer rien du tout.
Alexandria, le catalogue de fournisseurs de données de Firecrawl, nécessite un compte gratuit et firecrawl-local login. Notre article explicatif sur Firecrawl Alexandria détaille ce qu'il renvoie.
Lequel choisir ?
Choisissez Firecrawl Local si :
- Vous voulez qu'un agent IA scrape et crawle sur votre ordinateur portable.
firecrawl-local initajoute le serveur MCP à Claude Code, Claude Desktop, Cursor, Windsurf, Gemini CLI et Codex, en sauvegardant chaque configuration au préalable. - Vous exécutez des jobs courts qui se terminent en moins d'une heure.
- Vous n'avez besoin que de markdown, HTML, HTML brut et liens.
- Vous ne voulez pas gérer Postgres, Redis et RabbitMQ.
Conservez Firecrawl auto-hébergé si :
- Les jobs de crawl doivent survivre à un redémarrage ou durer plus d'une heure.
- Vous avez besoin d'une sortie
jsonousummaryvia votre propre modèle. - La recherche doit rester sur votre infrastructure.
- Plusieurs services ou utilisateurs partagent un même backend de scraping derrière votre authentification.
De nombreuses équipes utiliseront les deux : Local sur les ordinateurs portables et dans les agents, la stack Docker ou Firecrawl Cloud en production. Pour les configurations d'agents qui n'ont besoin que de la recherche, notre sélection de recherche web open source pour Claude liste d'autres options, et le guide Firecrawl MCP et llms.txt couvre le serveur MCP hébergé.
Migrer du code SDK de l'auto-hébergé vers Local
Votre code SDK ne change pas, seule l'URL change : définissez l'URL de l'API du SDK Python ou Node sur http://localhost:3002, sans clé API pour les routes locales. Avant de basculer, assurez-vous que votre code n'effectue aucun appel v0 ou v1, ne demande jamais json, summary ou actions, et n'interroge jamais un ID de crawl datant de plus d'une heure ou ayant survécu à un redémarrage de serve.
Laissez votre agent de codage exécuter un test de parité avec le CLI Apidog
Changer de backend est une question de contrat : est-ce que /v2/scrape sur Local renvoie la même structure que celle que votre code parse déjà ? Ne comparez pas les réponses à la main. Lancez les deux serveurs côte à côte (Docker sur 3002, firecrawl-local serve --port 3012) et laissez votre agent de codage tester les deux avec Apidog CLI.
Configurez-le une fois :
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
Puis donnez à votre agent un seul prompt :
Self-hosted Firecrawl runs on http://localhost:3002 and Firecrawl Local on
http://localhost:3012. In Apidog project <id>, create two environments,
"self-hosted" and "local". Add test cases for POST /v2/scrape on
https://example.com (assert 200, success: true, non-empty data.markdown) and
POST /v2/map (assert 200 and a non-empty links array). Run the cases against
both environments and tell me every assertion that differs.
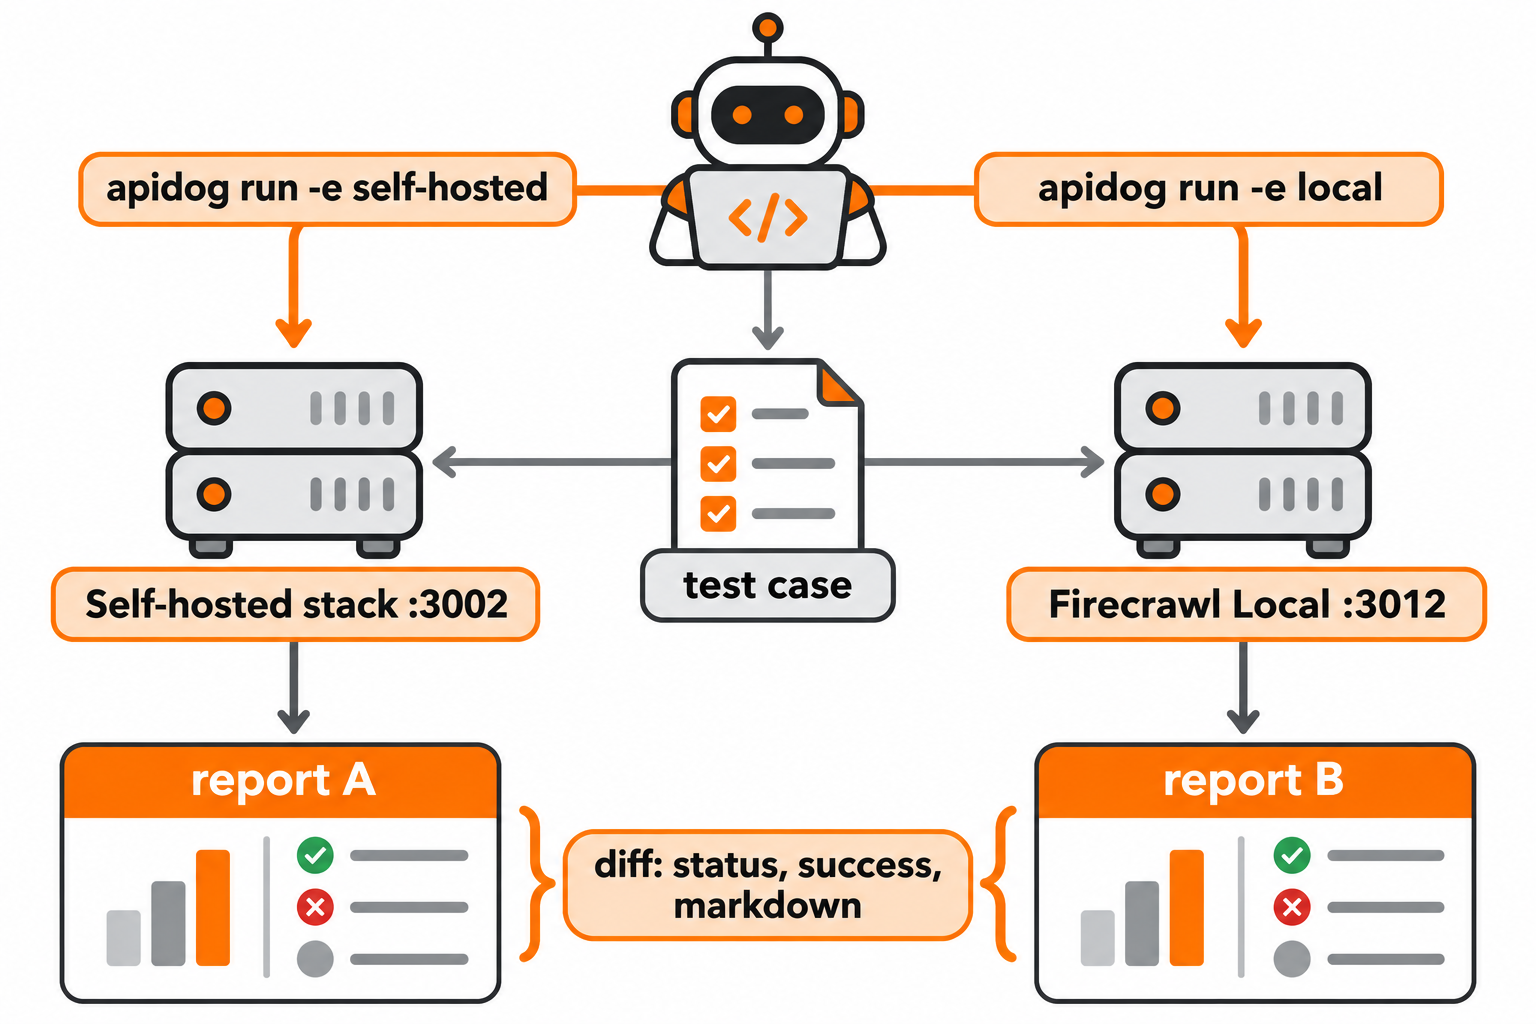
L'agent lit le schéma du payload, le valide et exécute le même cas deux fois :
firecrawl-local serve --port 3012 &
apidog environment create self-hosted --project <id> --base-url http://localhost:3002
apidog environment create local --project <id> --base-url http://localhost:3012
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file scrape-case.json
apidog test-case create --project <id> --file scrape-case.json
apidog run --test-case <caseId> --project <id> -e <selfHostedEnvId> -r cli,json --out-file self-hosted
apidog run --test-case <caseId> --project <id> -e <localEnvId> -r cli,json --out-file local
Apidog CLI envoie les requêtes depuis votre machine, donc les deux ports localhost sont accessibles. Remplacez -r cli,json par -r junit et la même vérification tourne en CI à chaque mise à jour de Firecrawl ; notre guide CI/CD du CLI Apidog montre la configuration, et Apidog CLI dans Claude Code couvre le côté agent. Le plan gratuit d'Apidog couvre les équipes jusqu'à 4 utilisateurs.
FAQ
Firecrawl Local remplace-t-il Firecrawl auto-hébergé ? Non. C'est une build distincte dans apps/local. Le serveur complet dans apps/api et son guide d'auto-hébergement sont inchangés, et vous en avez toujours besoin pour les jobs persistants et les formats LLM.
Firecrawl Local est-il vraiment 37 fois plus rapide que Firecrawl auto-hébergé ? C'est l'affirmation de Firecrawl dans son post de lancement, avec 230 fois moins de mémoire et 11 Mo au repos. Le README ne publie aucune méthode de benchmark, alors testez sur vos propres URL.
Firecrawl Local fonctionne-t-il sans le cloud ? Oui. Définissez FIRECRAWL_CLOUD=off et le scraping, le crawling et le mapping restent sur votre machine. La recherche, le repli sur les pages bloquées et Alexandria cessent de fonctionner.
Firecrawl auto-hébergé est-il gratuit ? Le code est gratuit sous AGPL-3.0, tant pour le serveur que pour Local. Vous payez les machines et le temps passé à faire tourner vous-même Postgres, Redis et RabbitMQ.
Lequel un agent IA doit-il utiliser ? Firecrawl Local, dans la plupart des cas. firecrawl-local init l'enregistre comme serveur MCP dans six outils d'agents, et --public-only empêche un agent d'atteindre votre réseau privé.