ERNIE 5.5 Flash vs DeepSeek V4.1 Flash vs GPT-6 Luna : trois compromis différents. ERNIE 5.5 Flash Preview est gratuit à appeler aujourd'hui sur OpenRouter. DeepSeek V4.1 Flash vous offre des poids ouverts sous licence MIT et un tarif de 0,30 $/1,20 $ par million de tokens en heures de pointe, soit deux fois moins en heures creuses. GPT-6 Luna affiche le prix catalogue payant le plus bas : 0,10 $ en entrée, 0,50 $ en sortie.
Les trois modèles acceptent environ 1 million de tokens de contexte et savent appeler des outils. Ils se distinguent par leur structure tarifaire, leurs poids et leur maturité. Tous les prix ci-dessous ont été relevés sur les pages officielles le 12 novembre 2026, et la dernière section montre votre agent de code tester les trois avec un seul prompt.
ERNIE 5.5 Flash vs DeepSeek V4.1 Flash vs GPT-6 Luna en un coup d'œil
| ERNIE 5.5 Flash Preview | DeepSeek V4.1 Flash | GPT-6 Luna | |
|---|---|---|---|
| ID de modèle API | baidu/ernie-5.5-flash-preview:free (OpenRouter) |
deepseek-flash |
gpt-6-luna |
| Entrée par 1M | Gratuit sur OpenRouter ; prix payant [VERIFY] | 0,30 $ en heure de pointe, 0,15 $ en heure creuse | 0,10 $ |
| Entrée en cache par 1M | s/o sur l'endpoint gratuit | 0,006 $ en heure de pointe, 0,003 $ en heure creuse | 0,01 $ |
| Sortie par 1M | Gratuit sur OpenRouter ; prix payant [VERIFY] | 1,20 $ en heure de pointe, 0,60 $ en heure creuse | 0,50 $ |
| Fenêtre de contexte | 1 024 000 tokens | 1M tokens | 1 050 000 tokens |
| Sortie max. | 1 024 000 (fiche OpenRouter) | 384K | 128 000 |
| Paramètres | 280B au total, 14B actifs (MoE) | 552B en backbone, 8B actifs en préfill / 16B en decode | Non publiés |
| Types d'entrée | Texte | Texte, image | Texte, image |
| Poids ouverts | Modèle de base oui ; Preview « bientôt » sous Apache 2.0 | Oui, MIT | Non |
| Statut | Checkpoint de preview | En production (version 1017) | En production |
Sources : l'annonce de Baidu, OpenRouter, la tarification DeepSeek et la page Luna d'OpenAI.
Ce qu'est chaque modèle économique
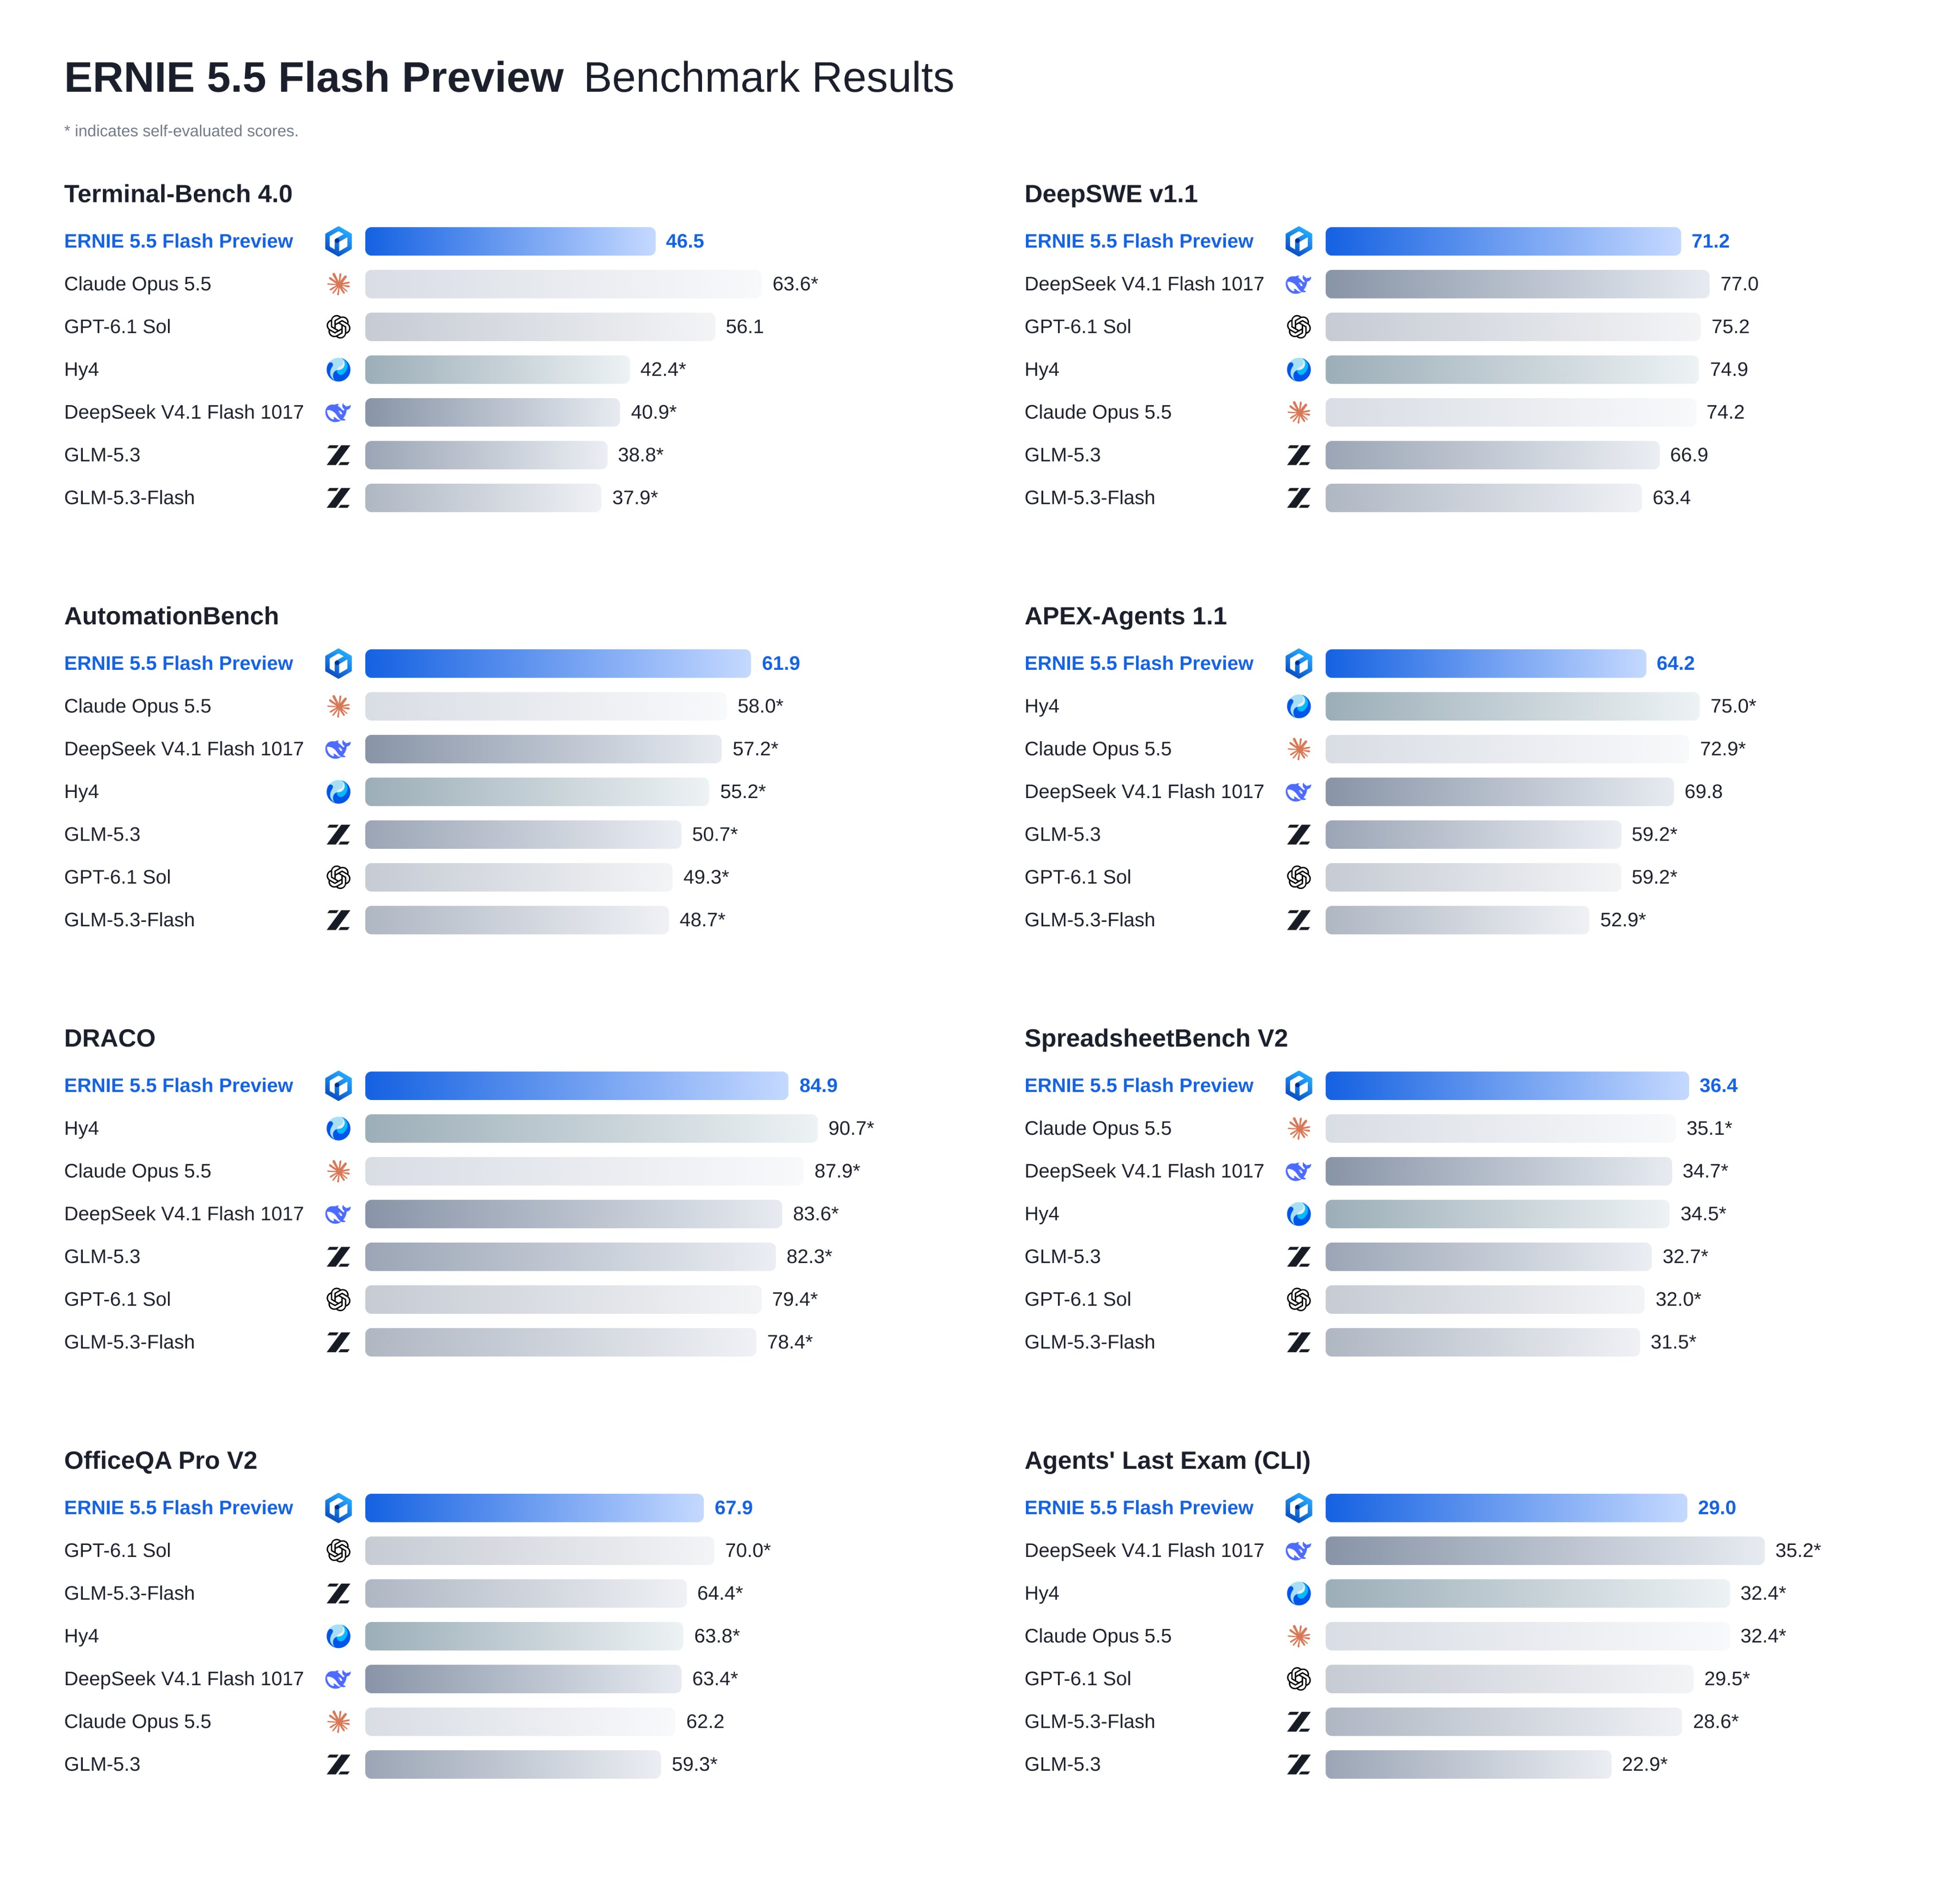
ERNIE 5.5 Flash Preview est le premier modèle post-entraîné de Baidu, construit sur ERNIE 5.5 Flash Base qu'il a publié sur Hugging Face début novembre. C'est un modèle sparse mixture-of-experts de 280B paramètres avec 14B paramètres actifs et un contexte de 1M tokens. Baidu le présente comme un checkpoint intermédiaire : le post-training n'est pas terminé. Pour le contexte : ce qu'est ERNIE 5.5 Flash et le précédent ERNIE 5.1.
DeepSeek V4.1 Flash est un MoE multimodal avec 552B paramètres de backbone. Il active 8B paramètres par token en préfill et 16B en decode, ce qui rend le travail d'agent gourmand en entrées peu coûteux. Les poids sont sous licence MIT sur Hugging Face. Voir l'explication de DeepSeek V4.1 Flash.
GPT-6 Luna est le « modèle le plus efficace d'OpenAI pour des tâches ciblées à haut volume ». Il accepte texte et images, prend en charge un niveau d'effort de raisonnement de none à max, et fonctionne avec les outils de l'API Responses. Voir ce qu'est GPT-6 Luna.
Prix par million de tokens, et coût réel d'un appel d'agent
Les boucles d'agent renvoient le même long contexte à chaque étape, donc le caching et les règles horaires comptent autant que le tarif affiché.
- GPT-6 Luna : 0,10 $ l'entrée, 0,01 $ l'entrée en cache, 0,125 $ l'écriture en cache, 0,50 $ la sortie. Les prompts dépassant 272K tokens d'entrée coûtent 2x l'entrée et 1,5x la sortie pour toute la requête. Batch et Flex fonctionnent à 50 % du tarif standard.
- DeepSeek V4.1 Flash : 0,30 $ l'entrée (cache manqué), 0,006 $ en cas de cache touché, 1,20 $ la sortie pendant les heures de pointe. Les tarifs hors pointe sont la moitié. Les heures de pointe vont de 01 h à 04 h et de 06 h à 10 h UTC, du lundi au vendredi ; tout le reste, week-ends compris, est hors pointe.
- ERNIE 5.5 Flash Preview : 0 $ en entrée et en sortie sur l'endpoint
:freed'OpenRouter, soumis à des limites de débit selon OpenRouter. Baidu n'a pas publié de prix payant par token sur une page consultable aujourd'hui, donc considérez tout chiffre vu ailleurs comme [VERIFY].
Prenons une étape d'agent avec 50 000 tokens d'entrée et 2 000 tokens de sortie, sans cache :
| Modèle | Coût par appel | Coût pour 1 000 appels |
|---|---|---|
| GPT-6 Luna | 0,0060 $ | 6,00 $ |
| DeepSeek V4.1 Flash, heure de pointe | 0,0174 $ | 17,40 $ |
| DeepSeek V4.1 Flash, heure creuse | 0,0087 $ | 8,70 $ |
ERNIE 5.5 Flash Preview, :free |
0 $ | 0 $ (dans les limites de débit) |
Supposons maintenant que 90 % de cette entrée provienne d'un cache touché, ce qui est normal pour un agent relisant le même dépôt. Luna descend à environ 0,0020 $ par appel (plus une écriture en cache ponctuelle). DeepSeek descend à environ 0,0042 $ en heure de pointe et 0,0021 $ hors pointe. L'écart entre les deux modèles payants se referme presque hors pointe.
Deux réserves : chaque fournisseur a son propre tokenizer, donc le nombre de tokens diffère pour un même prompt, et les tokens de raisonnement sont facturés comme sortie, si bien qu'un effort de raisonnement élevé gonfle la ligne de sortie. Notre analyse des tarifs de DeepSeek V4.1 Flash et la comparaison des offres API à moins de 1 $ approfondissent les calculs de cache.
Fenêtre de contexte, longueur de sortie et vitesse
Le contexte ne tranchera pas. Les limites de sortie diffèrent davantage : 384K pour DeepSeek, 128 000 pour Luna, et 1 024 000 annoncés pour l'endpoint gratuit d'ERNIE. Les affirmations de vitesse demandent de la prudence :
- ERNIE 5.5 Flash Preview : la description du modèle sur OpenRouter indique plus de 200 tokens par seconde. Le débit P50 mesuré par OpenRouter lui-même sur les 3 derniers jours était de 79 tokens par seconde, avec une latence P50 de 2,53 secondes, sur un seul fournisseur (Baidu Qianfan).
- DeepSeek V4.1 Flash : aucun chiffre de tokens par seconde sur la page de tarification ; il indique une limite de concurrence de 2 500.
- GPT-6 Luna : OpenAI la classe « Fast », avec des limites de niveau Build de 5 000 requêtes et 2 000 000 tokens par minute.
Mesurez depuis votre propre région avec vos propres prompts ; la section Apidog ci-dessous vous y prépare.
Poids ouverts, accès gratuit et licences
- DeepSeek V4.1 Flash est le seul dont vous pouvez télécharger aujourd'hui des poids en production, sous licence MIT. Auto-hébergez-le ou choisissez un fournisseur hébergé depuis sa fiche Hugging Face.
- ERNIE 5.5 Flash comporte deux artefacts. Le modèle Base (pré-entraînement uniquement, 33,5T tokens) est déjà sur Hugging Face. Le Preview, le modèle de chat et d'agent, n'a pas encore de poids publics ; Baidu annonce un open sourcing sous Apache 2.0 « bientôt ». Une date circulant en ligne n'est pas confirmée [VERIFY].
- GPT-6 Luna est fermée. On y accède via l'API d'OpenAI ou Amazon Bedrock, et le niveau gratuit de l'API est indiqué « Not supported ».
Pour tester à 0 $, l'endpoint :free d'ERNIE est la porte la plus simple. DeepSeek et Luna ont leurs propres routes gratuites, traitées dans comment utiliser DeepSeek V4.1 Flash gratuitement et comment utiliser GPT-6 Luna gratuitement.
Le meilleur choix pour les agents et le code
Chaque éditeur évalue son modèle dans son propre environnement de test, ne comparez donc pas ces chiffres comme s'ils provenaient d'un même test. Comparez plutôt ce que chacun met en avant.
DeepSeek V4.1 Flash affiche 90,6 sur Terminal-Bench 2.1 et 74,2 sur DeepSWE v1.1 à effort de raisonnement maximal, les deux mesurés par DeepSeek dans son propre environnement. L'effort de raisonnement est un curseur de 1 à 100, et l'endpoint parle les formats OpenAI, Anthropic et Responses, si bien qu'il s'intègre à Claude Code, Codex ou OpenCode.
ERNIE 5.5 Flash Preview est présenté sur la page de lancement de Baidu comme capable de créer un jeu Unreal Engine 5.8 en une seule tâche de code de 11 heures, ainsi que près de 100 mini-jeux mobiles à partir de documents de conception. Il est textuel uniquement, donc les boucles d'agent pilotées par captures d'écran sont exclues pour l'instant. Le tableau de bord d'OpenRouter montrait aussi un taux d'erreur de 21,70 % sur les sorties structurées et de 1,01 % sur les appels d'outils sur 3 jours : validez donc les sorties JSON avant de vous y fier dans un pipeline.
GPT-6 Luna l'emporte sur l'étendue des outils. L'API Responses lui donne accès à un shell hébergé, à l'application de correctifs, au computer use et à MCP. Une limite : dans Chat Completions, le function calling ne fonctionne qu'avec reasoning_effort réglé sur none ; utilisez l'API Responses pour les outils avec raisonnement activé.
Quel modèle économique choisir ?
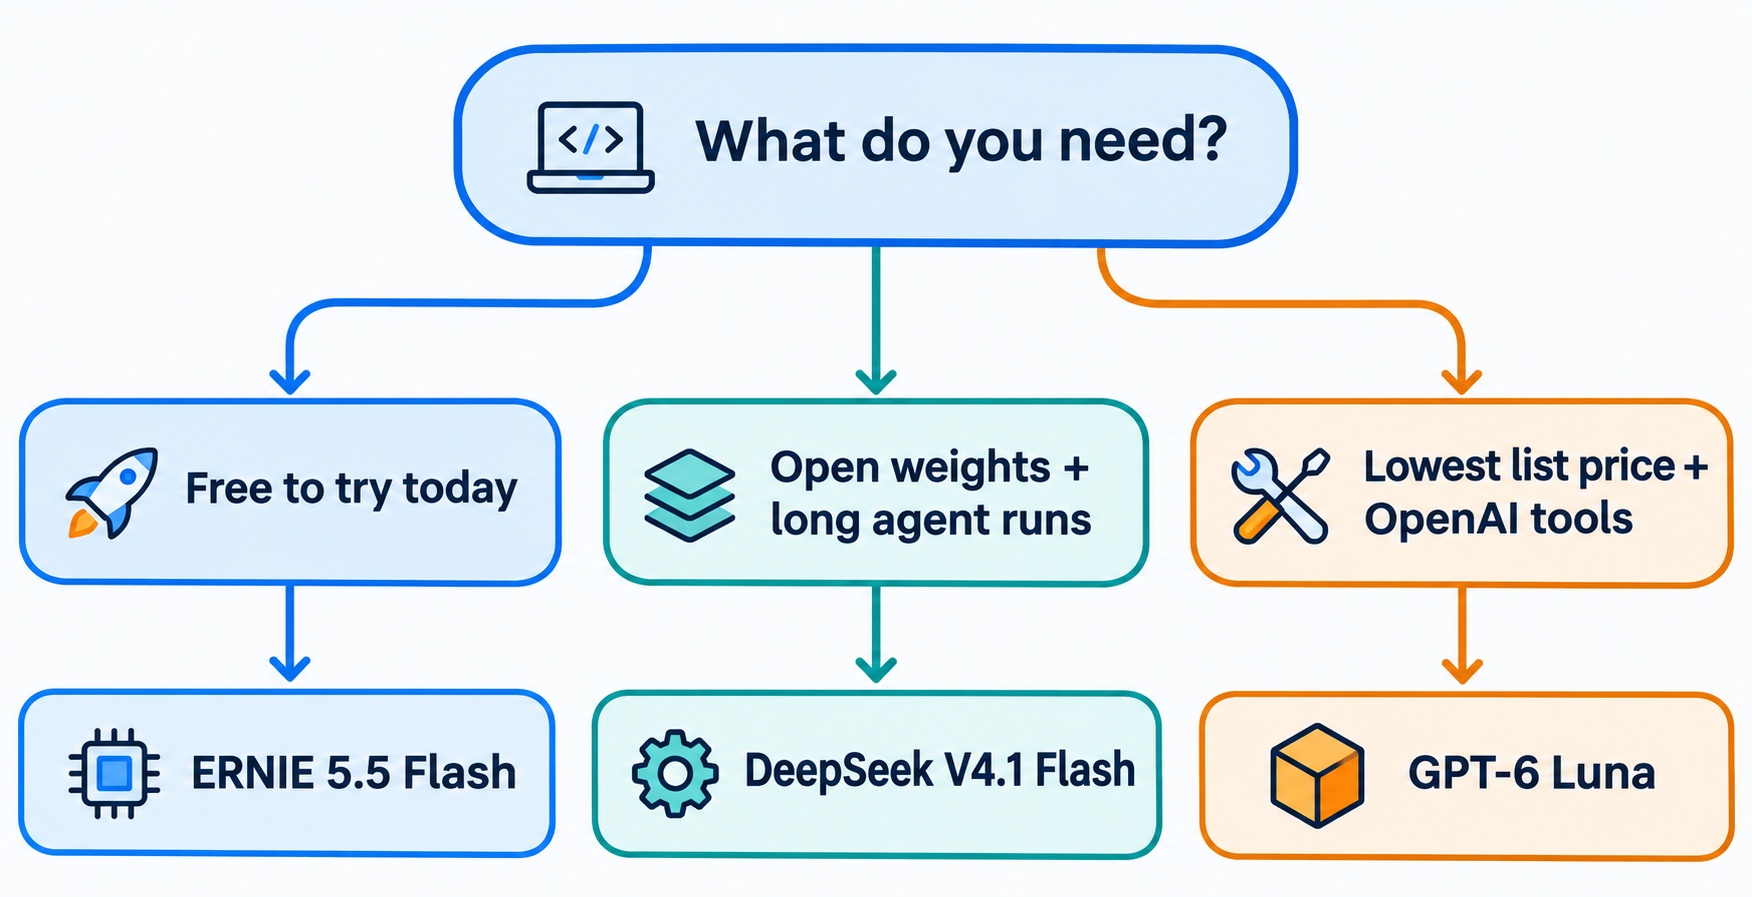
Choisissez selon votre contrainte, pas selon un classement :
- Vous voulez essayer un nouveau modèle à 0 $ aujourd'hui : ERNIE 5.5 Flash Preview sur OpenRouter. Attendez-vous à un comportement de preview et à des limites de débit.
- Vous avez besoin de poids ouverts ou prévoyez de vous auto-héberger : DeepSeek V4.1 Flash.
- Votre agent exécute de longues sessions gourmandes en entrées et vous pouvez programmer hors pointe : DeepSeek V4.1 Flash, où les cache hits hors pointe coûtent 0,003 $ par million de tokens.
- Vous voulez le prix catalogue payant le plus bas et les outils hébergés d'OpenAI : GPT-6 Luna.
- Vous avez besoin d'entrées image : DeepSeek V4.1 Flash ou GPT-6 Luna, pas ERNIE.
Laissez votre agent de code comparer les trois avec Apidog CLI
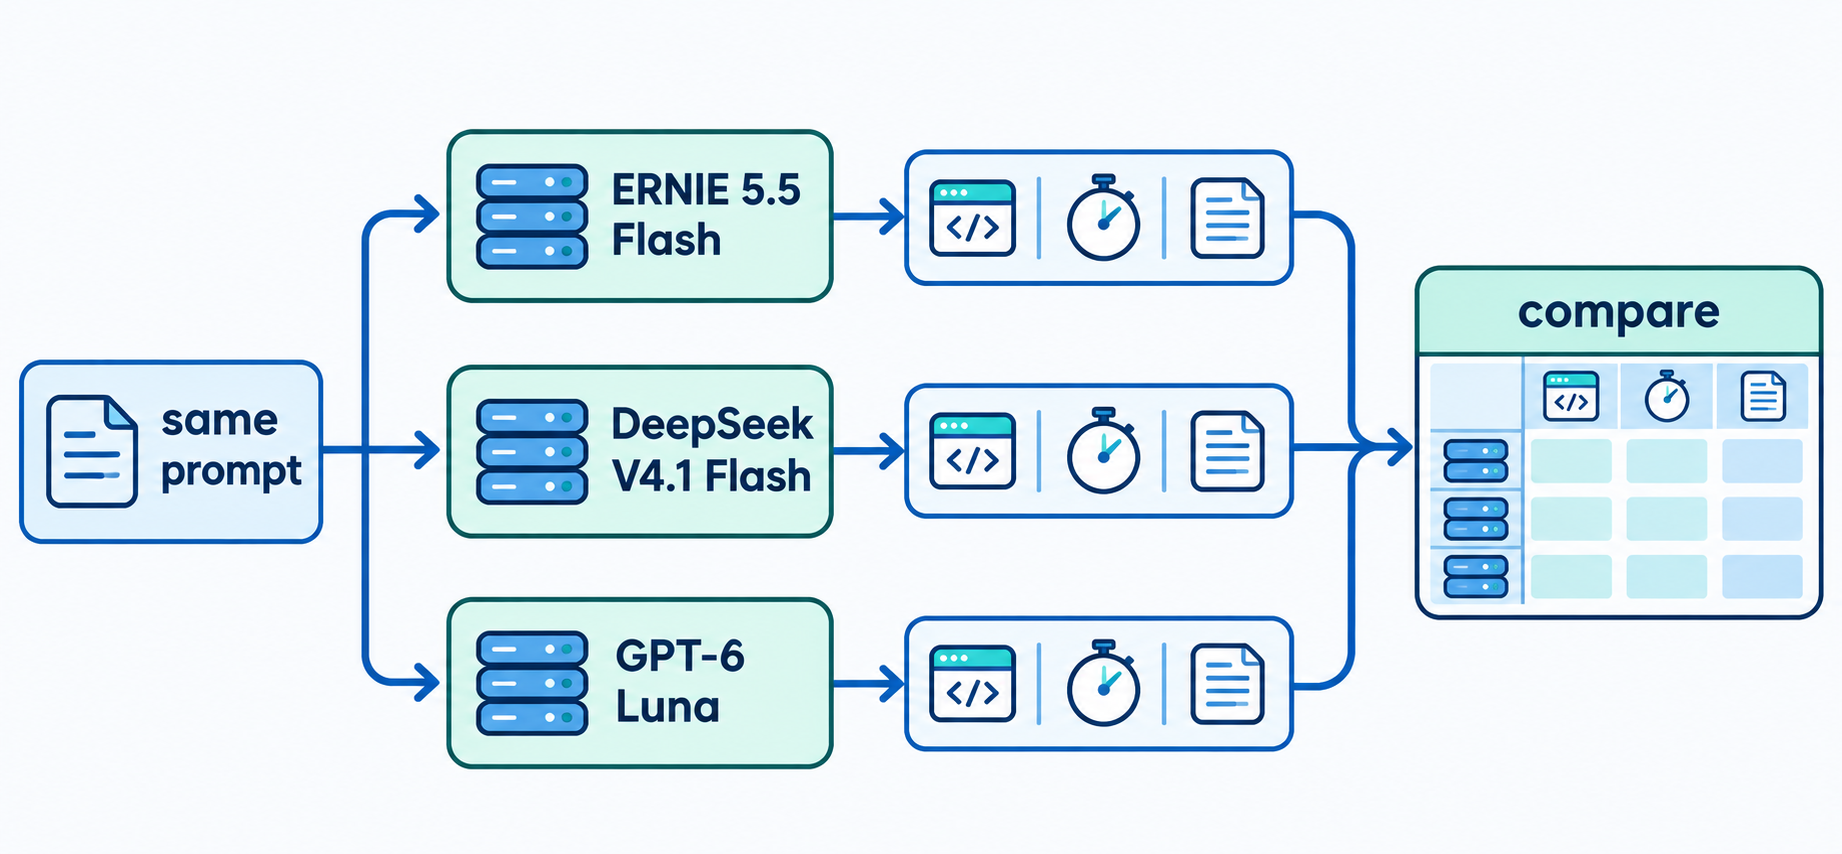
N'affichez pas trois appels API à la main à chaque mise à jour de modèle. Laissez Claude Code, Codex ou Cursor construire un scénario et l'exécuter chez chaque fournisseur avec Apidog CLI. Les trois parlent OpenAI Chat Completions, donc seuls l'URL de base, l'ID du modèle et la clé changent.
Configurez la CLI une fois :
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
Puis donnez à votre agent un seul prompt :
In Apidog project <projectId>, create three environments: ernie-flash
(base URL https://openrouter.ai/api/v1, model baidu/ernie-5.5-flash-preview:free),
deepseek-flash (https://api.deepseek.com, model deepseek-flash) and gpt-6-luna
(https://api.openai.com/v1, model gpt-6-luna). Create one test scenario that POSTs
the same prompt to {{baseUrl}}/chat/completions with model {{model}}, asserts
status 200 and a non-empty choices[0].message.content, and records
usage.completion_tokens. Run it 5 times per environment and give me a table of
pass rate, average response time and output tokens.
L'agent crée les environnements, vérifie le payload du scénario par rapport au schéma, l'écrit et l'exécute :
apidog environment create ernie-flash --project <projectId> --base-url https://openrouter.ai/api/v1 --variables '<json>'
apidog environment create deepseek-flash --project <projectId> --base-url https://api.deepseek.com --variables '<json>'
apidog environment create gpt-6-luna --project <projectId> --base-url https://api.openai.com/v1 --variables '<json>'
apidog cli-schema get test-scenario-create
apidog cli-schema validate test-scenario-create --file scenario.json
apidog test-scenario create --project <projectId> --file scenario.json
apidog test-scenario run <scenarioId> --project <projectId> -e <envId> -n 5 -r cli,json --env-var "apiKey=$OPENROUTER_API_KEY"
Transmettre les clés avec --env-var les tient à l'écart de l'environnement partagé. Répétez l'exécution par environnement avec la clé du fournisseur concerné ; les rapports JSON alimentent votre tableau. La même commande d'exécution avec -r junit s'intègre au CI ; voir le guide CI/CD d'Apidog CLI et la procédure de configuration dans Claude Code. Le plan gratuit d'Apidog couvre jusqu'à 4 utilisateurs, donc une petite équipe peut lancer tout cela sans siège payant.
FAQ
ERNIE 5.5 Flash est-il moins cher que DeepSeek V4.1 Flash ? Pour l'instant, oui : l'endpoint :free d'OpenRouter coûte 0 $ dans ses limites de débit. Baidu n'a pas publié de prix payant que nous puissions vérifier, donc une comparaison payant contre payant n'est pas encore possible.
Lequel a la plus grande fenêtre de contexte ? Ils sont proches. GPT-6 Luna affiche 1 050 000 tokens, ERNIE 5.5 Flash Preview 1 024 000 sur OpenRouter, et DeepSeek V4.1 Flash 1M. Le prix de Luna double sur l'entrée au-delà de 272K tokens.
Puis-je exécuter l'un de ces modèles en local ? DeepSeek V4.1 Flash, oui : poids MIT sur Hugging Face. Les poids d'ERNIE 5.5 Flash Base sont publics, mais le modèle de chat Preview n'est pas encore publié. GPT-6 Luna n'a pas de poids publics.
Lequel est le meilleur pour les agents de code ? Cela dépend de votre environnement de test. DeepSeek V4.1 Flash affiche de bons scores agentiques dans ses propres tests et prend en charge les formats OpenAI et Anthropic. GPT-6 Luna dispose de l'ensemble d'outils hébergés le plus large. ERNIE 5.5 Flash Preview est gratuit à essayer, mais textuel uniquement et toujours en preview.
GPT-6 Luna a-t-elle un niveau API gratuit ? Non. La page du modèle d'OpenAI indique « Not supported » pour le niveau gratuit. L'usage payant commence à 0,10 $ par million de tokens d'entrée.