
L'API ERNIE 5.5 Flash est disponible à deux endroits : sur Baidu Qianfan, où vous appelez ernie-5.5-flash-preview à l'adresse https://qianfan.baidubce.com/v2/chat/completions, et sur OpenRouter, où baidu/ernie-5.5-flash-preview:free coûte 0 $ par token. Les deux respectent le format OpenAI Chat Completions, vous pouvez donc pointer le SDK officiel OpenAI vers l'un ou l'autre en modifiant simplement l'URL de base, la clé et le nom du modèle.
Au programme : les clés, les premières requêtes en curl, Python et JavaScript, le streaming, les tokens de raisonnement, la fenêtre de 1M tokens et les erreurs. Chaque champ et chaque limite provient des pages officielles de Qianfan et OpenRouter, vérifiées le 12 novembre 2026.
Pour le contexte, consultez ce qu'est ERNIE 5.5 Flash, ou le guide de l'API ERNIE 5.1 pour la génération précédente.
Qu'est-ce que l'API ERNIE 5.5 Flash ?
L'API ERNIE 5.5 Flash est le point d'accès hébergé par Baidu pour ERNIE 5.5 Flash Preview, un modèle sparse mixture-of-experts de 280B de paramètres au total, avec 14B actifs par token et un contexte de 1M de tokens. Baidu l'a publié le 11 novembre 2026, comme premier modèle post-entraîné construit sur ERNIE 5.5 Flash Base, et le sert via Qianfan et OpenRouter.
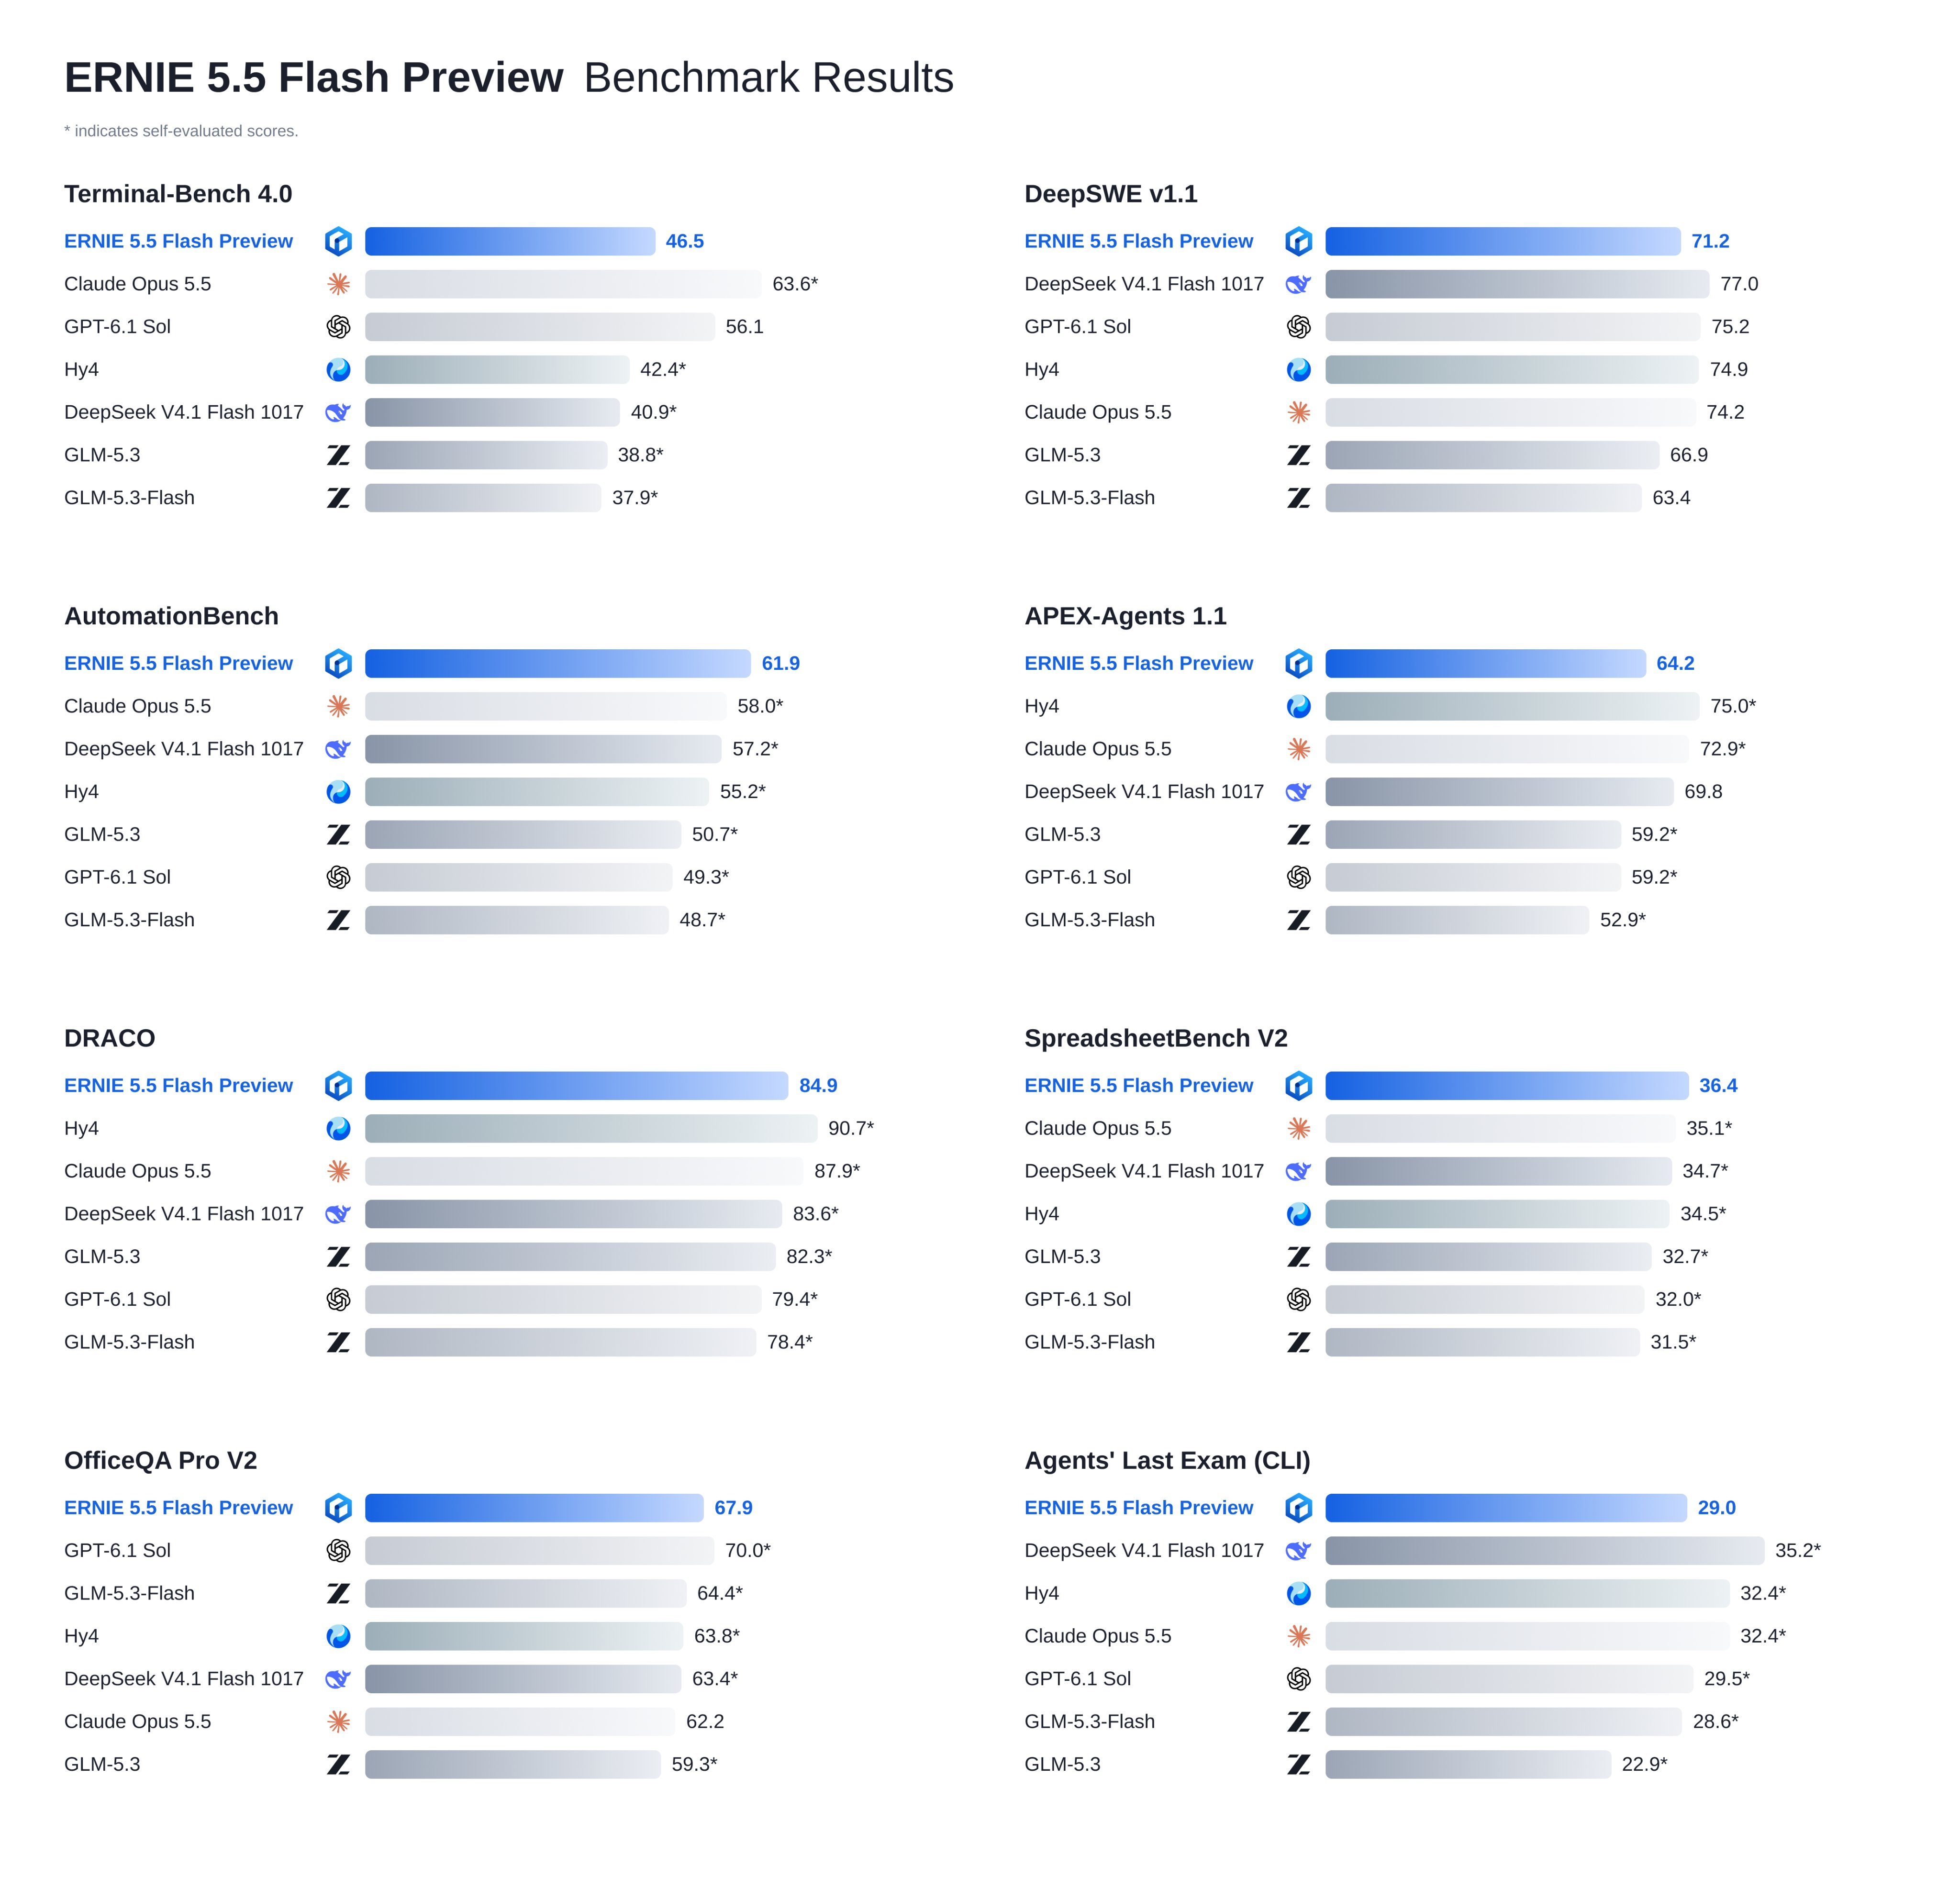
Dans son annonce de sortie, Baidu le positionne pour le code, le travail agentique, la modélisation 3D, les tâches de connaissance et la création de contenu. Le modèle est présenté comme un checkpoint intermédiaire : attendez-vous à des changements de comportement, et les poids seront open-sourcés sous Apache 2.0 « bientôt », sans date précise.
Qianfan vs OpenRouter : quel point d'accès choisir ?
Voici une comparaison des deux routes, basée sur ce que chaque plateforme publie aujourd'hui.
| Baidu Qianfan | OpenRouter | |
|---|---|---|
| URL de base | https://qianfan.baidubce.com/v2 |
https://openrouter.ai/api/v1 |
| ID du modèle | ernie-5.5-flash-preview |
baidu/ernie-5.5-flash-preview:free |
| En-tête d'authentification | Authorization: Bearer <clé API Qianfan> |
Authorization: Bearer <clé OpenRouter> |
| Contexte | 1M en entrée, 1M en sortie | 1 024 000 tokens |
| Prix | Facturé sur votre solde Baidu AI Cloud ; la console affiche le tarif | 0 $ sur la variante :free |
| Limites par défaut | 300 requêtes/min, 3 000 000 tokens/min | 20 requêtes/min ; 50/jour, ou 1 000/jour après 10 $ de crédits |
| Raisonnement | Toujours actif, effort fixé à high |
Contrôlé via l'objet reasoning |
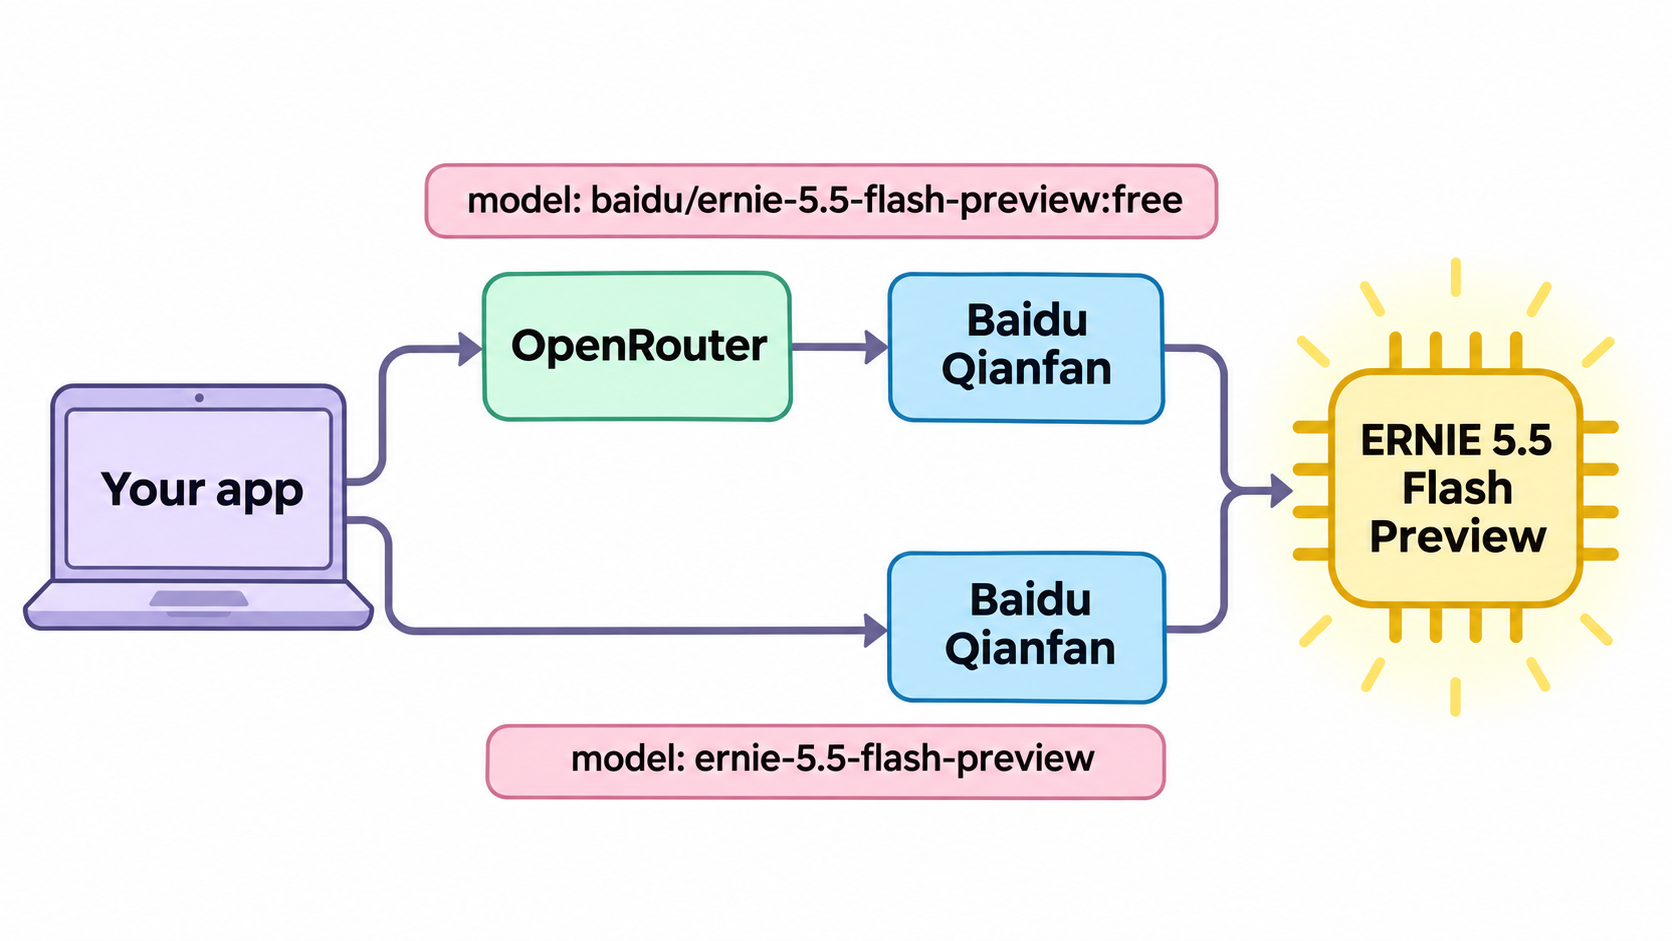
OpenRouter ne liste qu'un seul fournisseur, Baidu Qianfan, donc les deux routes rejoignent le même backend. La vraie différence réside dans les limites : le niveau gratuit d'OpenRouter convient au prototypage et aux évaluations, tandis que les 300 RPM par défaut de Qianfan conviennent à la production. Le guide gratuit d'ERNIE 5.5 Flash détaille davantage les routes à 0 $.
Comment obtenir une clé API ERNIE 5.5 Flash ?
Qianfan
- Connectez-vous à la console Qianfan avec un compte Baidu AI Cloud.
- Ouvrez API Key dans la gestion système et créez une clé. Elle ressemble à
bce-v3/ALTAK-.... - Exportez-la :
export QIANFAN_API_KEY="bce-v3/ALTAK-...".
Qianfan facture les appels sur votre solde Baidu AI Cloud. Un solde négatif renvoie 403 account_overdue, donc rechargez avant vos tests de charge.
OpenRouter
- Créez un compte et une clé sur OpenRouter.
- Exportez-la :
export OPENROUTER_API_KEY="sk-or-v1-...". - Utilisez l'ID de modèle
baidu/ernie-5.5-flash-preview:free.
Envoyez votre première requête ERNIE 5.5 Flash
curl
Qianfan :
curl https://qianfan.baidubce.com/v2/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $QIANFAN_API_KEY" \
  -d '{
    "model": "ernie-5.5-flash-preview",
    "messages": [
      {"role": "system", "content": "You are a concise senior engineer."},
      {"role": "user", "content": "Write a Python function that validates an ISO 8601 date."}
    ]
  }'
OpenRouter :
curl https://openrouter.ai/api/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $OPENROUTER_API_KEY" \
  -d '{
    "model": "baidu/ernie-5.5-flash-preview:free",
    "messages": [
      {"role": "user", "content": "Write a Python function that validates an ISO 8601 date."}
    ]
  }'
Python
Installez le SDK avec pip install openai, puis adaptez l'URL de base selon le fournisseur :
import os
from openai import OpenAI

PROVIDERS = {
    "qianfan": ("https://qianfan.baidubce.com/v2", "QIANFAN_API_KEY", "ernie-5.5-flash-preview"),
    "openrouter": ("https://openrouter.ai/api/v1", "OPENROUTER_API_KEY", "baidu/ernie-5.5-flash-preview:free"),
}

base_url, key_env, model = PROVIDERS["qianfan"]
client = OpenAI(base_url=base_url, api_key=os.environ[key_env])

resp = client.chat.completions.create(
    model=model,
    messages=[{"role": "user", "content": "Explain idempotency keys in two sentences."}],
    max_completion_tokens=4096,
)
print(resp.choices[0].message.content)
print(resp.usage)
JavaScript
import OpenAI from "openai";

const client = new OpenAI({
  baseURL: "https://openrouter.ai/api/v1",
  apiKey: process.env.OPENROUTER_API_KEY,
});

const resp = await client.chat.completions.create({
  model: "baidu/ernie-5.5-flash-preview:free",
  messages: [{ role: "user", content: "List three causes of HTTP 499 errors." }],
});
console.log(resp.choices[0].message.content);
Comment streamer les réponses d'ERNIE 5.5 Flash ?
Ajoutez "stream": true et les deux fournisseurs renvoient des server-sent events qui se terminent par data: [DONE]. Sur Qianfan, ajoutez "stream_options": {"include_usage": true} pour obtenir les compteurs de tokens dans le dernier chunk. Si ce format vous est nouveau, le guide du streaming SSE explique le format d'échange.
stream = client.chat.completions.create(
    model=model,
    messages=[{"role": "user", "content": "Draft a README for a CLI tool."}],
    stream=True,
    stream_options={"include_usage": True},
)
for chunk in stream:
    if chunk.choices:
        delta = chunk.choices[0].delta
        thinking = getattr(delta, "reasoning_content", None)
        if thinking:
            print(f"[thinking] {thinking}", end="", flush=True)
        if delta.content:
            print(delta.content, end="", flush=True)
    if chunk.usage:
        print("\n", chunk.usage)
Privilégiez le streaming par défaut : le modèle raisonne avant de répondre, donc un appel bloquant peut rester silencieux un certain temps.
Comment fonctionnent les tokens de raisonnement selon le fournisseur ?
ERNIE 5.5 Flash Preview est un modèle de raisonnement, et les deux plateformes l'exposent différemment.
Sur Qianfan, la documentation du deep-thinking liste ernie-5.5-flash-preview comme « activable uniquement, non désactivable » pour le paramètre thinking, et sa valeur par défaut reasoning_effort de high « ne peut pas être ajustée ». Impossible donc de désactiver le raisonnement ou de le réduire ici. La chaîne de pensée est renvoyée dans reasoning_content, séparée de content. Qianfan la compte dans max_completion_tokens : une limite trop basse peut donc tronquer la réponse finale et vous laisser avec finish_reason: "length".
Sur OpenRouter, vous contrôlez le raisonnement via l'objet reasoning et lisez la trace dans reasoning_details. Pour masquer la trace de la réponse :
{
  "model": "baidu/ernie-5.5-flash-preview:free",
  "reasoning": { "exclude": true },
  "messages": [{ "role": "user", "content": "Is 2^61 - 1 prime?" }]
}
Dans les conversations multi-tours, OpenRouter vous demande de renvoyer l'intégralité de reasoning_details avec le message de l'assistant afin que le modèle reprenne là où il s'était arrêté. Le nombre de tokens de raisonnement apparaît dans usage.completion_tokens_details.reasoning_tokens.
Conseils pour la fenêtre de contexte de 1M tokens
Un million de tokens représente une base de code de taille moyenne. Quatre habitudes rendent les appels longs prévisibles :
- Budgétez en tokens par minute, pas seulement en requêtes. La valeur par défaut de Qianfan est 3 000 000 TPM : trois prompts complets de 1M tokens en une minute épuisent tout le quota. Surveillez
X-Ratelimit-Remaining-Input-Tokenssur chaque réponse. - Placez le contenu stable en premier. Gardez le prompt système et les documents de référence au début, et la question changeante à la fin, pour que les préfixes répétés puissent profiter du cache. OpenRouter affichait un taux de hits en cache de 90,83 % pour ce modèle le 12 novembre.
- Laissez de la place pour le raisonnement. Définissez
max_completion_tokensassez haut pour couvrir la réflexion et la réponse. - Mesurez avant de croire aux promesses de vitesse. Baidu annonce plus de 200 tokens par seconde. Sur le point d'accès gratuit d'OpenRouter, le débit médian (P50) le 12 novembre était de 79 tokens par seconde, avec une latence P50 de 2,53 secondes.
Pour la sortie structurée, testez rigoureusement avant la mise en production. OpenRouter accepte response_format avec un schéma JSON, mais sa page signalait un taux d'erreur de 21,70 % sur la sortie structurée pour ce modèle sur trois jours, contre 1,01 % pour les appels d'outils. Validez chaque réponse JSON et retentez en cas d'échec d'analyse.
Erreurs et limites de débit de l'API ERNIE 5.5 Flash
Voici les codes que vous verrez le plus souvent, issus de la table des codes d'erreur de Qianfan et de la page des limites d'OpenRouter :
| Statut | Fournisseur | Code ou cause | Solution |
|---|---|---|---|
| 400 | Qianfan | tokens_too_long |
Raccourcissez le prompt sous la limite d'entrée de 1M |
| 401 | Qianfan | invalid_iam_token |
Clé erronée ou expirée, ou préfixe Bearer manquant |
| 401 | Qianfan | invalid_model |
Vérifiez que l'ID du modèle est exactement ernie-5.5-flash-preview |
| 403 | Qianfan | account_overdue |
Solde négatif ; rechargez |
| 429 | Qianfan | rpm_rate_limit_exceeded, tpm_rate_limit_exceeded |
Attendez ; le quota se réinitialise en moins de 60 secondes |
| 402 | OpenRouter | Solde de crédits négatif | Ajoutez des crédits, même pour :free |
| 429 | OpenRouter | Plafond du modèle gratuit (20/min, 50 ou 1 000/jour) | Lisez X-RateLimit-Reset, ou vérifiez GET /api/v1/key |
Sur OpenRouter, GET https://openrouter.ai/api/v1/key renvoie free_model_daily_requests.remaining. Retentez les erreurs 429 avec un backoff exponentiel et du jitter ; ne retentez jamais une erreur 400 ou 401.
Laissez votre agent de code tester les deux points d'accès avec Apidog CLI
Une fois que les deux fournisseurs répondent, vous voulez la preuve qu'ils continuent de répondre correctement : bon statut, bonne structure, latence acceptable. Confiez cela à votre agent de code. Apidog CLI donne à Claude Code, Codex, Cursor ou OpenCode les commandes nécessaires pour importer le point d'accès, enregistrer un environnement par fournisseur et exécuter un scénario de test contre chacun.
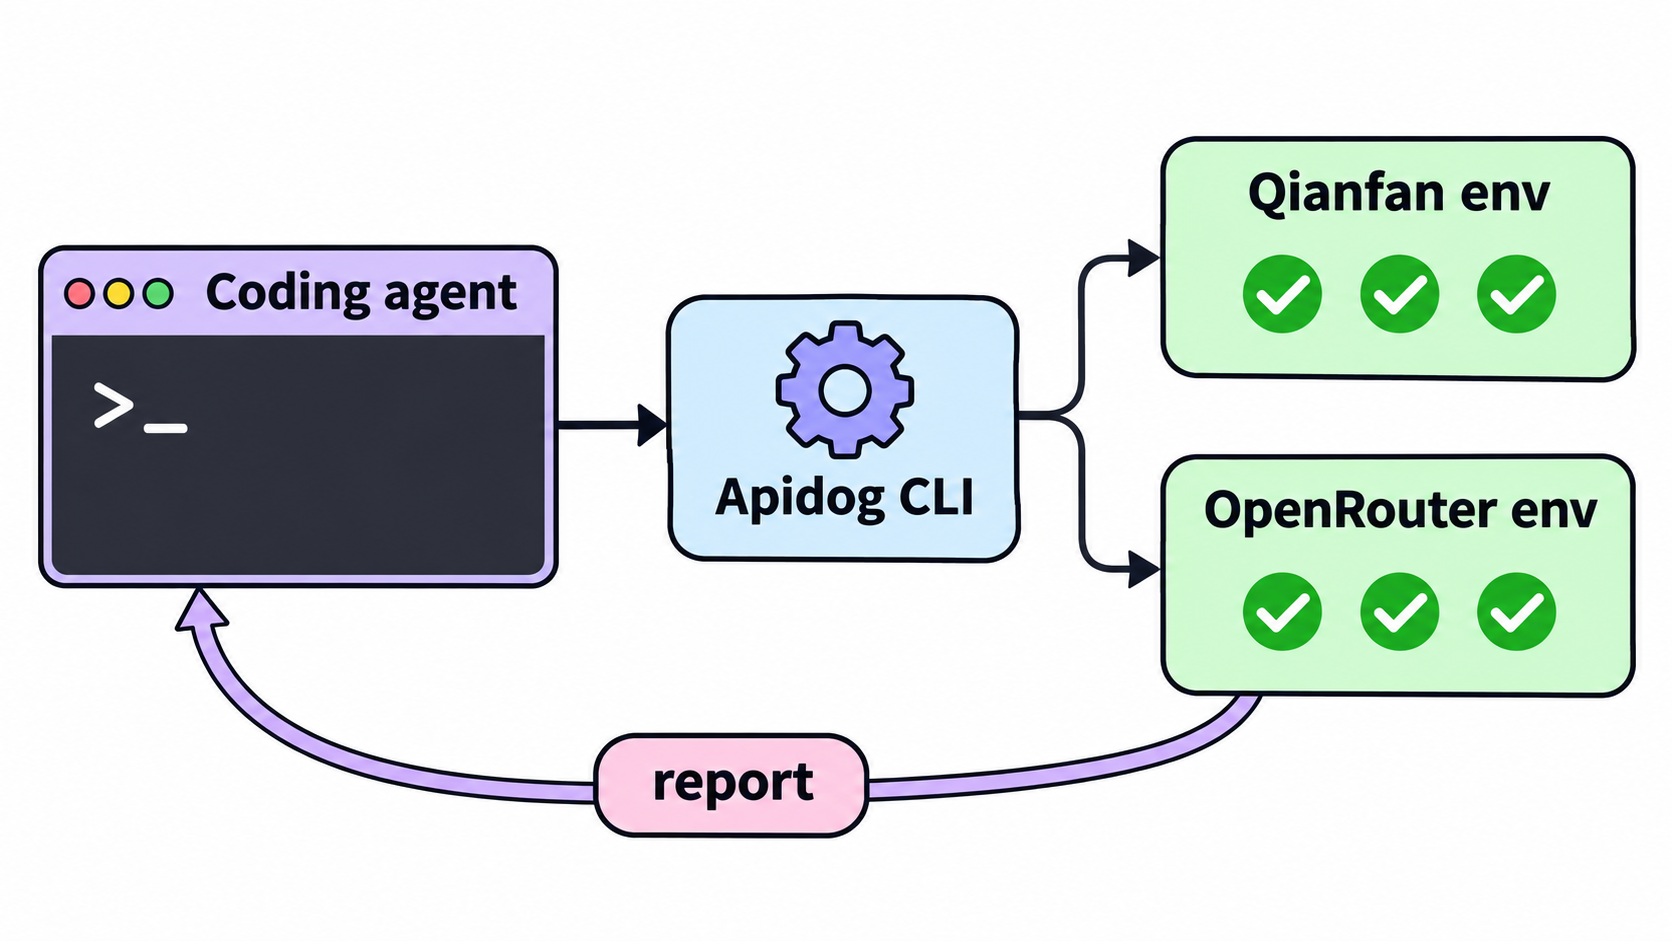
Configurez une seule fois :
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_APIDOG_TOKEN>
apidog skill install
Puis donnez à votre agent un seul prompt :
Write an OpenAPI 3 file for POST /chat/completions that matches the ERNIE 5.5 Flash
request and response shape (model, messages, stream; choices[0].message.content, usage).
Import it into Apidog project <projectId>. Create two environments: "qianfan" with base
URL https://qianfan.baidubce.com/v2 and "openrouter" with https://openrouter.ai/api/v1,
each with a "model" variable. Build one test scenario that sends a short prompt and
asserts status 200, the response schema, and a response time under 30 seconds. Run it
against both environments, passing the API keys as environment variables, and summarize
any failures.
L'agent vérifie chaque schéma, valide ses charges utiles et exécute des commandes comme celles-ci :
apidog import --project <projectId> --format openapi --file ./ernie-5-5-flash.openapi.yaml
apidog environment create qianfan --project <projectId> --base-url https://qianfan.baidubce.com/v2
apidog environment create openrouter --project <projectId> --base-url https://openrouter.ai/api/v1
apidog cli-schema get test-scenario-create
apidog test-scenario create --project <projectId> --name "ERNIE 5.5 Flash smoke" --folder-id <folderId> --priority <priority>
apidog test-scenario import-steps <scenarioId> --project <projectId> --source endpoint --ids <endpointId> --sync manual
apidog run -t <scenarioId> --project <projectId> -e <qianfanEnvId> --env-var "apiKey=$QIANFAN_API_KEY" -r cli,json
apidog run -t <scenarioId> --project <projectId> -e <openrouterEnvId> --env-var "apiKey=$OPENROUTER_API_KEY" -r cli,json
Transmettre les clés avec --env-var les empêche d'être enregistrées dans le projet, et un seul scénario vous offre une lecture comparative des deux routes. La même commande apidog run avec -r junit s'intègre dans un pipeline ; le guide CI/CD d'Apidog CLI présente la configuration, et Apidog CLI dans Claude Code couvre le côté agent. Le plan gratuit d'Apidog couvre jusqu'à 4 utilisateurs.
FAQ
L'API ERNIE 5.5 Flash est-elle gratuite ? Sur OpenRouter, oui : baidu/ernie-5.5-flash-preview:free coûte 0 $ par token, avec des limites de 20 requêtes par minute et 50 par jour, ou 1 000 par jour une fois que vous avez acheté 10 $ de crédits. Qianfan facture les appels sur votre solde Baidu AI Cloud.
Quel est l'ID du modèle pour ERNIE 5.5 Flash ? Utilisez ernie-5.5-flash-preview sur Qianfan et baidu/ernie-5.5-flash-preview:free sur OpenRouter.
Peut-on désactiver le thinking sur Qianfan ? Non. La documentation de Qianfan indique que le thinking ne peut qu'être activé pour ce modèle et que reasoning_effort reste à high. Budgétez les tokens de sortie pour la trace de raisonnement.
L'API ERNIE 5.5 Flash prend-elle en charge les appels d'outils ? Oui. Qianfan liste Function Call et la sortie structurée comme pris en charge, et OpenRouter accepte tools, tool_choice et response_format. Validez la sortie structurée, OpenRouter ayant signalé un taux d'erreur élevé à ce sujet.
Peut-on exécuter ERNIE 5.5 Flash soi-même ? Baidu a publié ERNIE 5.5 Flash Base sur Hugging Face, et les poids de Preview sont promis sous Apache 2.0. Voir exécuter ERNIE 5.5 Flash en local avec vLLM.
Comment se compare-t-il à DeepSeek V4.1 Flash ? Voir ERNIE 5.5 Flash vs DeepSeek V4.1 Flash et le guide de l'API DeepSeek V4.1 Flash.