DeepSeek a publié la fiche modèle de DeepSeek-V4.1-Flash le 10 septembre 2026, et les chiffres sont embarrassants pour les clients de V4-Pro. Le modèle, plus petit et moins cher, obtient des scores supérieurs à ceux du fleuron sur toutes les références de codage et d'agent listées par DeepSeek, coûte 70 à 77 % moins cher par jeton au maximum, et le 14 septembre, il absorbe entièrement V4-Pro : chaque requête deepseek-v4-pro est acheminée vers V4.1-Flash et facturée aux tarifs Flash.
Il ne s'agit pas du compromis habituel petit-contre-grand. C'est une comparaison avec une date limite. Si vous utilisez V4-Pro en production, vous avez quatre jours pour apprendre ce qui change lorsque le réacheminement aura lieu. Si vous utilisez V4-Flash, le changement est déjà intervenu : le nom deepseek-v4-flash est aujourd'hui desservi par V4.1-Flash.
Ci-dessous : les trois modèles sur l'architecture, les benchmarks rapportés par DeepSeek, les prix en USD et le débit, puis un workflow pour exécuter un ensemble de prompts via deepseek-v4-pro et deepseek-flash dans Apidog avant la transition pour comparer les sorties, la latence et les nombres d'utilisation. Pour l'analyse approfondie de l'architecture, lisez d'abord ce qu'est DeepSeek-V4.1-Flash ; pour la liste de contrôle de la migration, consultez le guide de retrait de V4-Pro.
En bref
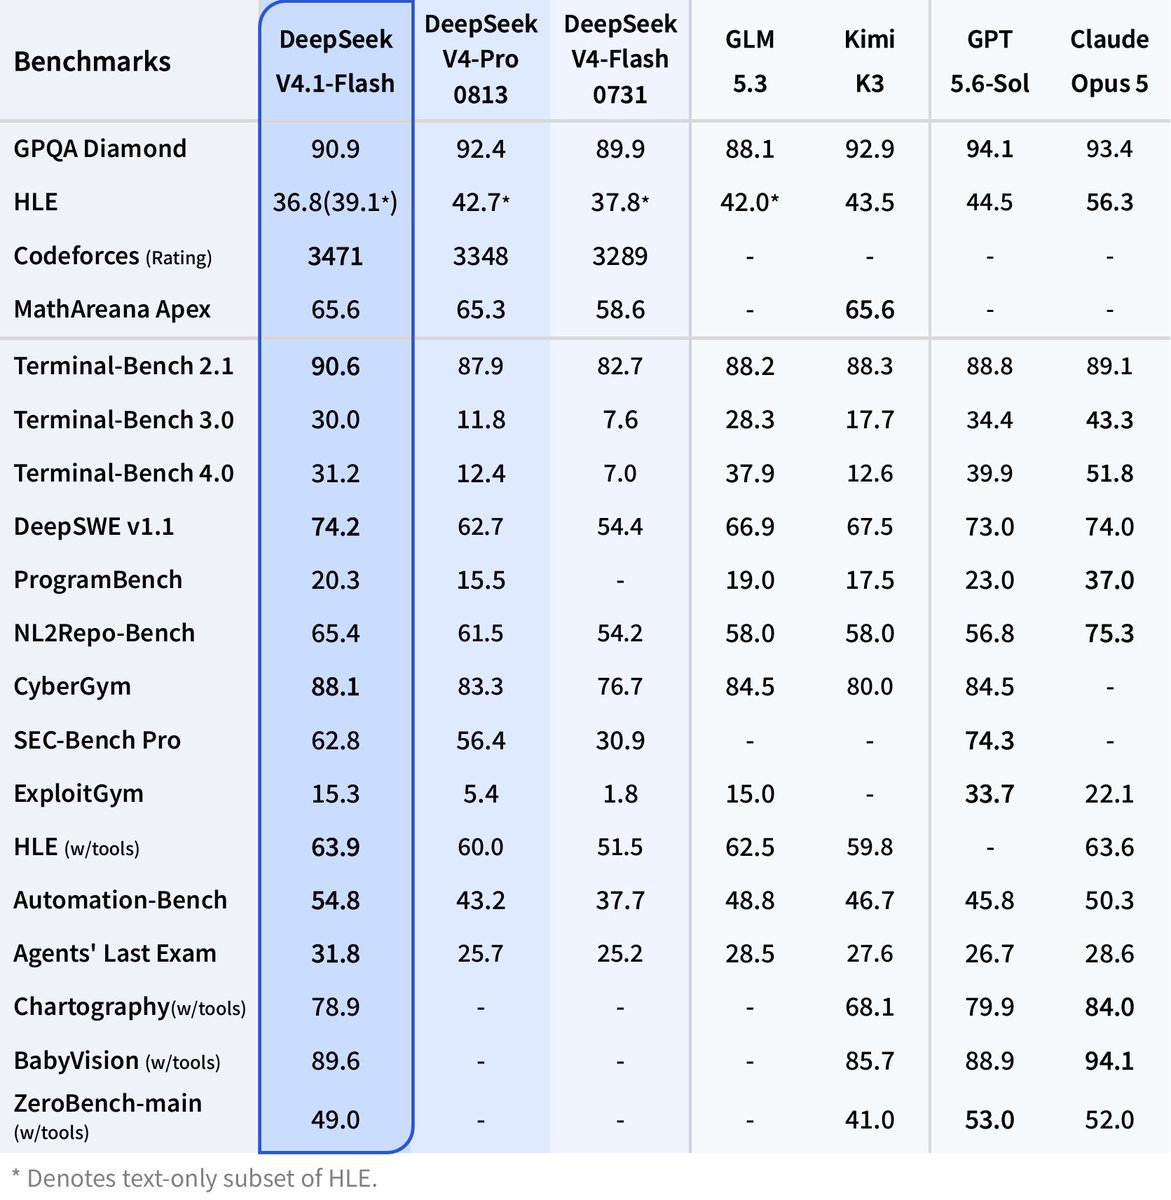
- V4.1-Flash est vainqueur sur les benchmarks propres de DeepSeek. DeepSWE v1.1 est le titre : 74,2 contre 62,7 pour V4-Pro et 54,4 pour V4-Flash.
- C'est le moins cher des trois. Le coût d'entrée maximum (cache-miss) est de 0,30 $ par million de jetons contre 1,32 $ pour V4-Pro et 0,44 $ pour l'ancien V4-Flash.
- Il est conçu pour le débit. 8 milliards de paramètres actifs en préremplissage, un cache KV à 890 octets par jeton, et une limite de concurrence de 2 500.
- Après le 14 septembre, il n'y a qu'un seul choix. Le trafic V4-Pro est réacheminé vers V4.1-Flash. La question est ce que vous gagnez et perdez, pas lequel choisir.
Spécifications côte à côte
La génération V4.1 est une nouvelle architecture, et non un simple ré-entraînement. DeepSeek l'appelle un Encodeur-Décodeur Causal (CED) : 40 couches divisées en 20 encodeurs et 20 décodeurs, avec 384 experts routés plus un expert partagé par couche. La fiche modèle indique que le cœur compte 552 milliards de paramètres (763 milliards avec l'encodeur de vision).
| V4-Flash | V4-Pro | V4.1-Flash | |
|---|---|---|---|
| Génération d'architecture | V4 MoE | V4 MoE | V4.1 Encodeur-Décodeur Causal, 40 couches |
| Paramètres totaux | 284B (liste OpenRouter de la version vision) | Non divulgué ici | 552B cœur, 763B avec encodeur de vision |
| Paramètres actifs | 13B | Non divulgué ici | 8B préremplissage, 16B décodage |
| Fenêtre contextuelle | 1M jetons | 1M jetons | 1M jetons |
| Sortie maximale | 384K jetons | 384K jetons | 384K jetons |
| Vision | Version Vision-Exp séparée | Non divulgué ici | Natif, encodeur DeepSeek-ViT |
| Licence | Non couvert ici | Non couvert ici | MIT, poids sur Hugging Face |
| Limite de concurrence | 2,500 | 500 | 2,500 |
| Statut API | Retiré, alias servi par V4.1-Flash | Réachemine vers V4.1-Flash le 14 sept. | Disponibilité générale depuis le 10 sept., id modèle deepseek-flash |
Le nombre de paramètres actifs scindé est le détail à noter : V4-Flash utilisait 13 milliards pour chaque jeton, tandis que V4.1-Flash dépense 8 milliards en entrée et 16 milliards en sortie, là où réside la qualité.
Benchmarks : d'où viennent les 11,5 points
Chaque chiffre ci-dessous est rapporté par DeepSeek à partir de la fiche modèle. Aucune exécution indépendante n'a été publiée, et l'expression « tests par plusieurs parties » dans l'avis de retrait ne les nomme pas. Traitez-les comme des affirmations du fournisseur et vérifiez-les sur vos propres prompts.
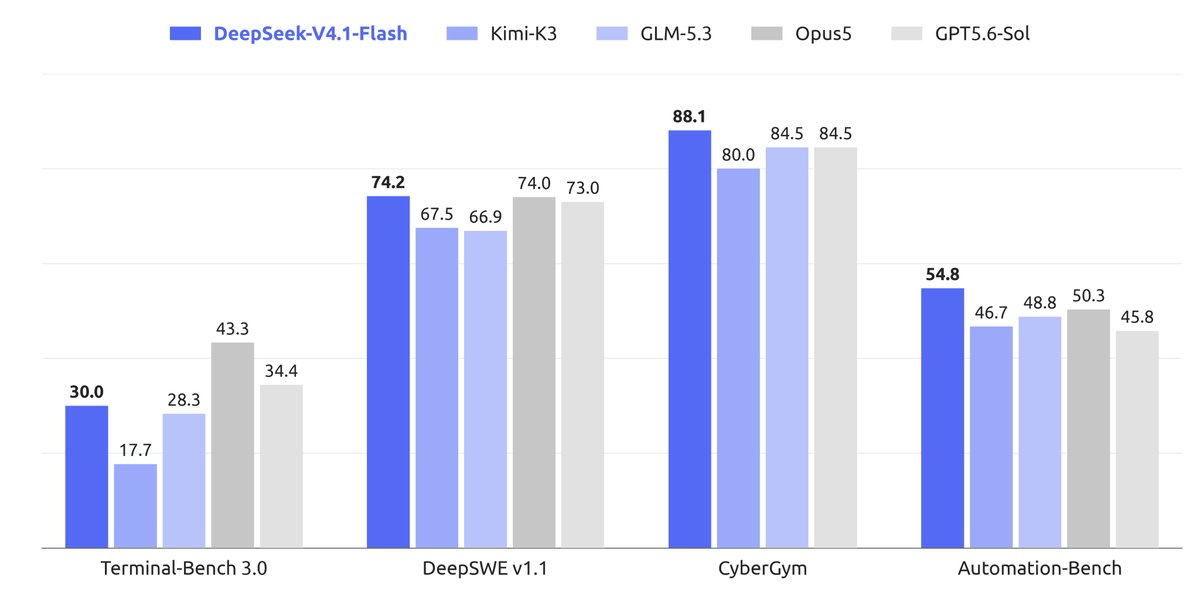
DeepSWE v1.1 (+11,5 par rapport à Pro, +19,8 par rapport à V4-Flash). C'est le chiffre clé, et le seul écart suffisamment grand pour changer les décisions. DeepSWE mesure les tâches d'ingénierie logicielle multi-fichiers, la charge de travail que les agents de codage exécutent toute la journée. Si cela se confirme sur vos dépôts, V4.1-Flash code mieux que le modèle qui coûtait quatre fois plus cher.
Terminal-Bench 2.1 (+2,7). Tâches d'agent pilotées par shell. V4-Flash-0731 avait déjà battu V4-Pro-Preview ici en juillet ; V4.1 étend l'avance de moins de trois points. Réel, mais pas décisif.
HumanEval (+2,6) et GSM8K (+0,4). Les deux sont proches de la saturation : chaque modèle dépasse 90 sur GSM8K, et HumanEval dit peu de choses sur le code de production. Ne donnez pas trop de poids à ces lignes.
MiniMax M3 vs DeepSeek V4 vs Qwen 3.7 présente les chiffres de la génération V4 par rapport à d'autres modèles ouverts ; aucun n'inclut encore V4.1.
Coût : trois modèles, six niveaux de prix
La période de pointe est du lundi au vendredi, de 01h00 à 04h00 et de 06h00 à 10h00 UTC ; tout le reste est en heures creuses à moitié prix. Les tarifs sont par million de jetons à partir de la page de tarification, effectifs au 10 septembre. Les lignes V4-Flash utilisent ses tarifs USD du 21 août 2026 comme colonne « avant ».
| Modèle et niveau | Entrée, cache hit | Entrée, cache miss | Sortie |
|---|---|---|---|
| V4-Flash, heures creuses (tarifs du 21 août) | 0,007 $ | 0,22 $ | 0,66 $ |
| V4-Flash, heures de pointe (tarifs du 21 août) | 0,014 $ | 0,44 $ | 1,32 $ |
| V4-Pro, heures creuses | 0,022 $ | 0,66 $ | 1,98 $ |
| V4-Pro, heures de pointe | 0,044 $ | 1,32 $ | 3,96 $ |
| V4.1-Flash, heures creuses | 0,003 $ | 0,15 $ | 0,60 $ |
| V4.1-Flash, heures de pointe | 0,006 $ | 0,30 $ | 1,20 $ |
Comparé à V4-Flash, V4.1 réduit les entrées en cache-hit d'environ 57 %, les entrées en cache-miss d'environ 32 % et les sorties d'environ 9 %. Comparé à V4-Pro, les réductions sont de 77 % sur les entrées en cache-miss et de 70 % sur les sorties aux heures de pointe.
Un mois de travail. Un agent de codage traite 2 milliards de jetons en entrée par mois avec un taux de cache-hit de 70 % (prompt système et contexte de dépôt réutilisés d'un tour à l'autre) et émet 300 millions de jetons en sortie, le tout en période de pointe.
| V4-Pro, heures de pointe | V4-Flash, heures de pointe | V4.1-Flash, heures de pointe | V4.1-Flash, heures creuses | |
|---|---|---|---|---|
| 1,4B d'entrées cache-hit | 61,60 $ | 19,60 $ | 8,40 $ | 4,20 $ |
| 600M d'entrées cache-miss | 792,00 $ | 264,00 $ | 180,00 $ | 90,00 $ |
| 300M de sorties | 1 188,00 $ | 396,00 $ | 360,00 $ | 180,00 $ |
| Total mensuel | 2 041,60 $ | 679,60 $ | 548,40 $ | 274,20 $ |
C'est 73 % de moins que V4-Pro, et déplacer les tâches par lots en dehors des heures de pointe divise à nouveau le coût par deux. Les jetons de sortie dominent chaque colonne, donc la réduction de 70 % sur les sorties est plus importante que le titre cache-hit. La ventilation des prix de V4.1-Flash couvre le calcul du cache-hit.
Vitesse et débit
DeepSeek ne publie aucun chiffre de jetons par seconde, donc l'histoire du débit repose sur trois faits architecturaux et une anecdote.
- Cache KV à 890 octets par jeton. Le cache KV principal en FP4 place le cache global à environ un quart de l'empreinte de V4-Flash. La note de publication indique que cela représente 1/4 du HBM et 1/8 du stockage SSD de la génération précédente. Un contexte complet d'un million de jetons nécessite environ 0,9 Go de cache.
- 8 milliards de paramètres actifs en préremplissage. Moins de calcul par jeton d'entrée que les 13 milliards de V4-Flash, de sorte que le temps de première réponse sur de grands contextes devrait diminuer.
- Concurrence 2 500 contre 500. Le trafic V4-Pro réacheminé hérite de la limite Flash, un gain de 5x pour les flottes d'agents.
- Rapport d'un utilisateur : « presque 400 t/s ». Un utilisateur de X l'a publié à partir de tests vidéo pendant la bêta ; c'est une anecdote, pas un benchmark. Le fil de discussion de la bêta sur HN est principalement le même enthousiasme.
Mesurez vos propres p50 et p95 avant de faire confiance à quoi que ce soit de cela.
Ce que vous perdez et gagnez après le 14 septembre
Il n'y a pas de « quel modèle devrais-je choisir » après la transition. deepseek-v4-pro devient un alias, donc la présentation honnête est un grand livre.
Vous gagnez : des scores plus élevés sur tous les benchmarks listés, des prix de pointe inférieurs de 70 à 77 %, une concurrence multipliée par 5, une entrée d'image native sans ID de modèle de vision séparé, et un curseur d'effort de raisonnement que DeepSeek décrit comme continuellement contrôlable sur une échelle de 1 à 100.
Vous perdez : la capacité d'épingler un point de contrôle de la génération V4. Les prompts réglés pour le style, la verbosité ou le formatage des appels d'outils de V4-Pro peuvent dériver. La longueur de la sortie et le nombre de jetons de raisonnement peuvent changer, ce qui modifie votre facture d'une manière que le tableau des tarifs ne montre pas. Et le réacheminement se fait selon le calendrier de DeepSeek, pas le vôtre.
Cette deuxième liste explique pourquoi vous devriez comparer avant le 14, et non après.
Différencier V4-Pro et V4.1-Flash dans Apidog avant la transition
Apidog teste la couche API, c'est donc l'endroit idéal pour exécuter un ensemble de prompts via les deux ID de modèle et comparer ce qui en ressort.
- Ajoutez le point de terminaison. Créez un projet et ajoutez
POST https://api.deepseek.com/chat/completions, ou importez une spécification OpenAPI. - Mettez la clé et l'ID du modèle dans les environnements. Stockez
DEEPSEEK_API_KEYet une variableMODEL. Créez deux environnements,v4-proavecMODEL=deepseek-v4-proetv41-flashavecMODEL=deepseek-flash, et référencez-les commeBearer {{DEEPSEEK_API_KEY}}dans l'en-tête et"model": "{{MODEL}}"dans le corps. - Enregistrez vos prompts réels en tant que requêtes. Choisissez 20 à 30 prompts qui représentent la production : votre prompt système, un tour d'appel d'outil, un résumé de contexte long, une édition de code multi-fichier. Enregistrez chacun avec
stream: falseafin que l'objetusageatterrisse dans le corps de la réponse. - Affirmez sur les champs qui modifient votre facture. Créez un scénario de test à partir des requêtes enregistrées et ajoutez des assertions sur
usage.prompt_tokens,usage.completion_tokensetusage.prompt_cache_hit_tokens. Enregistrez le temps de réponse par étape et ajoutez un script de pré-requête qui horodate le nom de l'environnement dans un en-tête afin que les exécutions soient étiquetées. - Exécutez une fois par environnement, puis différencier. Exécutez le scénario sous
v4-pro, puis sousv41-flash. Comparez le nombre de jetons de complétion (le réacheminement modifie votre facture de sortie), la latence par étape et le contenu lui-même pour déceler toute dérive de formatage. - Réexécutez en CI le 14. Exécutez le même scénario avec
apidog-clidans votre pipeline au moment de la transition. Tout ce que le réacheminement a brisé apparaît comme une assertion échouée au lieu d'un ticket de support.
La même comparaison sous forme de script :
import os, time
from openai import OpenAI

client = OpenAI(api_key=os.environ["DEEPSEEK_API_KEY"],
                base_url="https://api.deepseek.com")

prompt = "Rendez les tentatives de paiement dans le service de commande idempotentes. Retournez un diff unifié."

for model in ("deepseek-v4-pro", "deepseek-flash"):
    start = time.perf_counter()
    r = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    print(model, f"{time.perf_counter() - start:.2f}s",
          r.usage.prompt_tokens, r.usage.completion_tokens)
Exécutez-le en période de pointe et en période creuse et conservez les sorties. Téléchargez Apidog pour conserver les différences, les assertions et l'historique d'exécution au même endroit.
FAQ
V4.1-Flash est-il meilleur que V4-Pro pour le codage ? Selon les chiffres rapportés par DeepSeek, oui : 74,2 contre 62,7 sur DeepSWE v1.1 et 90,6 contre 87,9 sur Terminal-Bench 2.1. Pour savoir comment la génération V4 se comparait à Claude pour le codage, consultez DeepSeek V4 vs Claude Opus pour le codage.
Qu'arrive-t-il à mon intégration V4-Pro le 14 septembre ? À partir de 04h00 UTC, chaque requête deepseek-v4-pro sera servie par V4.1-Flash et facturée aux tarifs Flash. Votre code continuera de fonctionner ; le modèle derrière lui changera. Le guide de migration contient la liste de contrôle complète.
Dois-je renommer deepseek-v4-flash en deepseek-flash ? Pas aujourd'hui. deepseek-v4-flash et deepseek-v4-flash-vision-exp sont toujours acceptés et servis par V4.1-Flash. DeepSeek n'a pas donné de date de suppression, alors passez à deepseek-flash la prochaine fois que vous toucherez à la configuration.
V4.1-Flash est-il plus rapide que V4-Pro ? DeepSeek l'affirme et ne publie aucun chiffre. L'architecture soutient cette affirmation : 8 milliards de paramètres actifs en préremplissage et un cache KV d'un quart de la taille de celui de V4-Flash. Mesurez par vous-même.
Puis-je toujours exécuter V4-Pro quelque part ? Pas sur l'API de DeepSeek après le 14. L'historique de la génération V4 se trouve dans Qu'est-ce que DeepSeek V4 ; les poids de V4.1-Flash sont sur Hugging Face sous licence MIT.
La version courte
V4.1-Flash est plus petit, moins cher et mieux noté à la fois, du moins sur le tableau du fournisseur, et ce tableau ne peut pas vous dire s'il est meilleur pour vos prompts. Exécutez les deux ID de modèle avec le même ensemble de prompts dans Apidog cette semaine, conservez les différences, et vous saurez ce qui change le 14 septembre avant vos utilisateurs.