Claude Sonnet 5.5 (claude-sonnet-5-5, lancé le 28 septembre 2026) coûte le même prix que Sonnet 5, soit 2 $ par million de jetons d'entrée et 10 $ par million de jetons de sortie, et utilise le même tokenizer. Il est bien plus puissant, et Anthropic annonce qu'il est 30 %+ plus rapide. Sur le tableau de lancement, Terminal-Bench 4.0 passe de 10,3 % à 70,6 %, CursorBench 4.0 de 34,1 % à 55,5 %, et OSWorld 2.1 de 57,0 % à 80,1 %. Le problème réside dans l'API. Cinq formes de requêtes qui fonctionnaient sur Sonnet 5 renvoient désormais une erreur 400, et un changement modifie la forme de la réponse sans erreur. Verdict : mettez à niveau, mais corrigez d'abord ces six points.
Ci-dessous : chaque changement majeur avec son erreur exacte et son JSON avant/après, puis une liste de contrôle. Pour les spécifications, consultez qu'est-ce que Claude Sonnet 5.5 ; pour le bond précédent, Claude Sonnet 5 vs Sonnet 4.6. Apidog conserve les anciennes et les nouvelles requêtes côte à côte pendant vos tests.
Sonnet 5 vs Sonnet 5.5 en un coup d'œil
| Claude Sonnet 5 | Claude Sonnet 5.5 | |
|---|---|---|
| Prix par M de jetons (entrée / sortie / lecture du cache) | 2 $ / 10 $ / 0,20 $ | 2 $ / 10 $ / 0,20 $ |
| Contexte et sortie | 1M de contexte | 1M de contexte, 128K de sortie |
thinking.type accepté |
adaptive, disabled |
adaptive, between_tools |
display par défaut |
omitted |
omitted |
| Effort | low à max |
Mêmes niveaux, recalibrés ; API par défaut high |
| Requête minimale cachable | 1 024 jetons | 512 jetons |
| Effort par message, messages système en milieu de conversation | Non | Oui |
tool_choice forcé |
Supporté | Erreur 400 |
| Garanties cyber de type Opus | Non | Oui ; les risques cyber élevés basculent sur Sonnet 5 |
| Blocs de réflexion (thinking blocks) | Pas de vérification de conversation | Liés au modèle, à la conversation et au compte |
| Terminal-Bench 4.0 | 10,3 % | 70,6 % |
| CursorBench 4.0 | 34,1 % | 55,5 % |
| FrontierCode 1.1 (Principal) | 42,4 % | 46,2 % (max), 52,1 % (xhigh) |
| GDPval-AA v2.1 (Elo) | 1449 | 1844 |
| OSWorld 2.1 (partiel) | 57,0 % | 80,1 % |
| HLE (avec outils) | 54,9 % | 64,5 % |
| Retrait | Toujours utilisé comme repli cyber | Pas avant le 28 septembre 2027 |
Anthropic a exécuté Terminal-Bench, HLE et OSWorld ; Cursor a exécuté CursorBench, Cognition FrontierCode, et Artificial Analysis GDPval-AA. L'exécution de Terminal-Bench par Artificial Analysis donne 63,6 % contre 14,1 %, donc l'écart se maintient. FrontierCode a deux chiffres pour 5.5 car au maximum, il a plus souvent étendu les sous-agents de révision, et le benchmark pénalise les modifications hors de portée. Voir les benchmarks de Claude Sonnet 5.5.
Les cinq changements majeurs
Chacun renvoie une erreur 400 invalid_request_error pour du code qui fonctionne très bien sur Sonnet 5.
1. thinking: disabled a disparu ; envoyez between_tools
Sonnet 5.5 rejette thinking: {"type": "disabled"} :
"thinking.type.disabled" is not supported for this model. Use "thinking.type.between_tools" for the lowest thinking setting, or "thinking.type.adaptive" and "output_config.effort" to control thinking behavior.
Envoyez between_tools, le réglage le plus bas. Il ignore la réflexion initiale ; les notes de progression entre les appels d'outils arrivent toujours sous forme de blocs thinking, que vous transmettez inchangés. Il ne fonctionne qu'avec un effort low, medium ou high, n'accepte aucun autre champ (display, budget_tokens ou block_binding renvoient un 400), et verrouille l'effort pour la conversation.
// Avant (claude-sonnet-5)
{"model": "claude-sonnet-5", "max_tokens": 16000,
 "thinking": {"type": "disabled"},
 "output_config": {"effort": "xhigh"}}

// Après (claude-sonnet-5-5)
{"model": "claude-sonnet-5-5", "max_tokens": 16000,
 "thinking": {"type": "between_tools"},
 "output_config": {"effort": "high"}}
Si vous avez besoin de xhigh ou max, omettez thinking pour que la réflexion adaptative s'exécute.
2. tool_choice forcé renvoie une erreur 400
Un tool_choice de type any ou tool échoue, y compris sur le point de terminaison de comptage des jetons :
tool_choice: type "tool" and "any" are not supported for this model.
Envoyez auto, marquez l'outil strict: true (chaque objet nécessite additionalProperties: false), et précisez dans la requête quand l'utiliser. Le modèle peut désormais répondre en texte à la place, donc gérez les tours sans appel d'outil.
// Avant (claude-sonnet-5)
"tool_choice": {"type": "tool", "name": "get_weather"}

// Après (claude-sonnet-5-5)
"tools": [{"name": "get_weather",
  "input_schema": {"type": "object",
    "properties": {"location": {"type": "string"}},
    "required": ["location"], "additionalProperties": false},
  "strict": true}],
"tool_choice": {"type": "auto"},
"messages": [{"role": "user",
  "content": "Quel temps fait-il à Paris ? Utilisez l'outil get_weather."}]
La limite est de 20 outils stricts par requête. Sur Amazon Bedrock, les outils stricts ne sont pas disponibles pour Sonnet 5.5 : envoyez auto sans strict et validez l'entrée dans votre code.
3. Les blocs de réflexion (thinking blocks) sont liés au modèle, à la conversation et au compte
Chaque bloc de réflexion de Sonnet 5.5 est signé sur tout ce qui le précède : system, tools et les messages antérieurs. Pour les comptes créés le ou après le 31 août 2026 (00:00 UTC), la relecture d'un bloc après une édition renvoie une erreur 400 sur l'API Claude, Bedrock et Google Cloud :
messages.1.content.0: Invalid `signature` in `thinking` block. The block is bound to a different conversation. Remove the block, or set `thinking.block_binding.prefix_mismatch_behavior` to "drop_block".
Les comptes plus anciens n'appliquent pas cette règle par défaut, donc une exécution propre avec une ancienne clé ne prouve rien. Maintenez les conversations en mode "ajout seulement" et modifiez les instructions ou les outils avec des messages système en milieu de conversation. Si vous devez modifier, envoyez anthropic-beta: thinking-binding-controls-2026-08-01 et supprimez les blocs non concordants :
"thinking": {"type": "adaptive",
  "block_binding": {"prefix_mismatch_behavior": "drop_block"}}
Cela ne fonctionne qu'avec la réflexion adaptative ; avec between_tools, supprimez les blocs de réflexion à partir du tour édité. Sonnet 5.5 lit les blocs de Sonnet 5, Opus 4.8, Haiku 4.5 et antérieurs ; il ignore les blocs d'Opus 5, Opus 5.5, Fable et Mythos, ainsi que les blocs de Sonnet 5.5 provenant d'un autre compte, sans faire échouer la requête. Aucun autre modèle ne lit ses blocs. Voir la réflexion préservée de Claude Fable 5.1.
4. computer_20251124 échoue sur l'API Claude et Google Cloud
Là, l'utilisation de l'ordinateur nécessite le nouveau jeu d'outils. L'erreur commence ainsi :
'claude-sonnet-5-5' does not support tool types: computer_20251124.
// Avant (claude-sonnet-5)
"tools": [{"type": "computer_20251124", ...}]

// Après (claude-sonnet-5-5, API Claude et Google Cloud)
"tools": [{"type": "computer_toolset_20260801"}]
Supprimez l'ancien en-tête bêta d'utilisation de l'ordinateur et mettez à jour votre boucle pour les blocs tool_use membres, les actions par lots et toolset_name sur les résultats. Bedrock accepte toujours computer_20251124 ; computer_20250124 échoue partout.
5. Certains appariements de conseillers sont rejetés
Avec l'outil conseiller (bêta), un exécutant Sonnet 5.5 n'accepte comme conseiller que Opus 5, Opus 5.5, Sonnet 5.5, Fable 5, Fable 5.1, Mythos 5 ou Mythos 5.1. Les conseillers Sonnet 5, Opus 4.8 et Opus 4.7 renvoient désormais une erreur 400. Les conseils arrivent également chiffrés sous forme de bloc advisor_redacted_result, de sorte que le code qui analyse le texte des conseils ne reçoit rien.
Le changement silencieux : le texte entre les appels d'outils se déplace dans les blocs de réflexion
Celui-ci ne fait rien échouer. Sur Sonnet 5, les notes entre les appels d'outils revenaient sous forme de text. Sur Sonnet 5.5, tout ce qui est plus long qu'une ou deux phrases arrive sous forme de bloc thinking de mise à jour de la progression, vide sous le paramètre par défaut display: "omitted". Une interface utilisateur d'agent qui diffuse ces notes devient silencieuse, sans erreur. Trois solutions :
display: "updates"(réflexion adaptative, en-tête bêtathinking-display-updates-2026-08-18) renvoie les mises à jour seules. Sans l'en-tête, c'est rejeté.display: "summarized"mélange les mises à jour avec des résumés de raisonnement.between_toolsrenvoie le texte sans qu'undisplaysoit nécessaire.
// En-tête : anthropic-beta: thinking-display-updates-2026-08-18
"thinking": {"type": "adaptive", "display": "updates"}
Changements de comportement sans modification du code
Ceux-ci ne font pas échouer les requêtes, mais ils modifient la sortie et le coût. Le guide de prompting contient les corrections.
- L'effort est recalibré. Mêmes noms, différentes quantités de réflexion. Réexécutez votre balayage : commencez par
high,mediumpour un codage agentique bien spécifié,mediumoulowpour le chat ; réservezxhighetmaxpour des gains mesurés. - Changer le niveau d'
effortglobal entre les requêtes invalide le cache des requêtes. Utilisez plutôt l'effort bêta par message. - Il réfléchit avant presque chaque réponse à partir de
medium. Diminuez l'effort ; lui demander de moins réfléchir n'est pas fiable. - Il intervient tôt aux niveaux
lowetmediumsur les longues tâches agentiques. - Il ajoute des tests, des documents et des fichiers non demandés, ainsi que des sous-agents de révision aux niveaux
xhighetmax. La requête suggérée par Anthropic a réduit le coût de session àmaxd'environ un tiers. - Plus de refus. C'est le premier Sonnet avec des garanties cyber de type Opus. Un refus est un HTTP 200 avec
stop_reason: "refusal"et une catégoriestop_details; le repli côté serveur bêta sur l'API Claude (fallbacks: "default") retente les refuscyberetfrontier_llmsur Sonnet 5. - Paramètres d'échantillonnage. Une
temperature,top_poutop_knon par défaut renvoie une erreur 400. Anthropic liste cela sous les évolutions de Sonnet 4.6 et antérieurs, vous les avez donc probablement déjà supprimés.
Coût par tâche : même prix, moins de dollars par résultat
Le billet de lancement d'Anthropic indique que Sonnet 5.5 "coûte jusqu'à 30 % de moins par tâche que son prédécesseur" dans leurs tests. Les prix sont identiques, donc l'économie provient d'un nombre réduit de jetons et d'étapes. Ses tableaux par effort montrent un effort plus faible sur 5.5 surpassant la meilleure performance de Sonnet 5 :
| Benchmark (graphiques d'Anthropic) | Sonnet 5.5 | Sonnet 5, meilleure exécution |
|---|---|---|
| Terminal-Bench 4.0 | 28,8 % à moyen, 0,83 $ | 10,3 % à max, 11,62 $ |
| FrontierCode 1.1 | 49,4 % à élevé, 0,42 $ | 42,7 % à xhigh, 10,07 $ |
| CursorBench 4.0 | 35,8 % à bas, 0,50 $ | 34,1 % à max, 7,17 $ |
Les coûts de CursorBench sont des estimations d'Anthropic aux prix catalogue. L'autre côté est max : selon le rapport d'OfficeChai sur les données d'Artificial Analysis, Sonnet 5.5 à max utilise environ 193 000 jetons de sortie par tâche d'indexation, et le coût par tâche est environ 50 % supérieur à Sonnet 5. Les économies se trouvent aux niveaux high et inférieurs ; voir la tarification de Claude Sonnet 5.5.
Liste de contrôle de migration
Remplacez claude-sonnet-5 par claude-sonnet-5-5, puis exécutez les six vérifications du guide de migration d'Anthropic :
- Remplacez
disabledparbetween_tools, avec un efforthighou inférieur. - Remplacez le
tool_choiceforcé parauto,strict: trueet une ligne de prompt (sur Bedrock, validez dans le code). - Gardez l'historique en mode "ajout seulement" ; utilisez des messages système en cours de conversation pour les changements.
- Déplacez l'utilisation de l'ordinateur vers
computer_toolset_20260801sur l'API Claude et Google Cloud. - Choisissez un conseiller supporté et arrêtez d'analyser le texte des conseils.
- Définissez
thinking.displaysi votre interface utilisateur affiche du texte entre les appels d'outils.
Ensuite, réexécutez votre balayage d'effort. Claude Code peut automatiser la migration :
/claude-api migrate this project to claude-sonnet-5-5
L'équivalent pour Opus est la migration de Claude Opus 5.5 vs Opus 5.
Transformez la migration en un test de régression dans Apidog
Dans Apidog, enregistrez trois requêtes vers https://api.anthropic.com/v1/messages dans un même projet, toutes dans le même environnement :
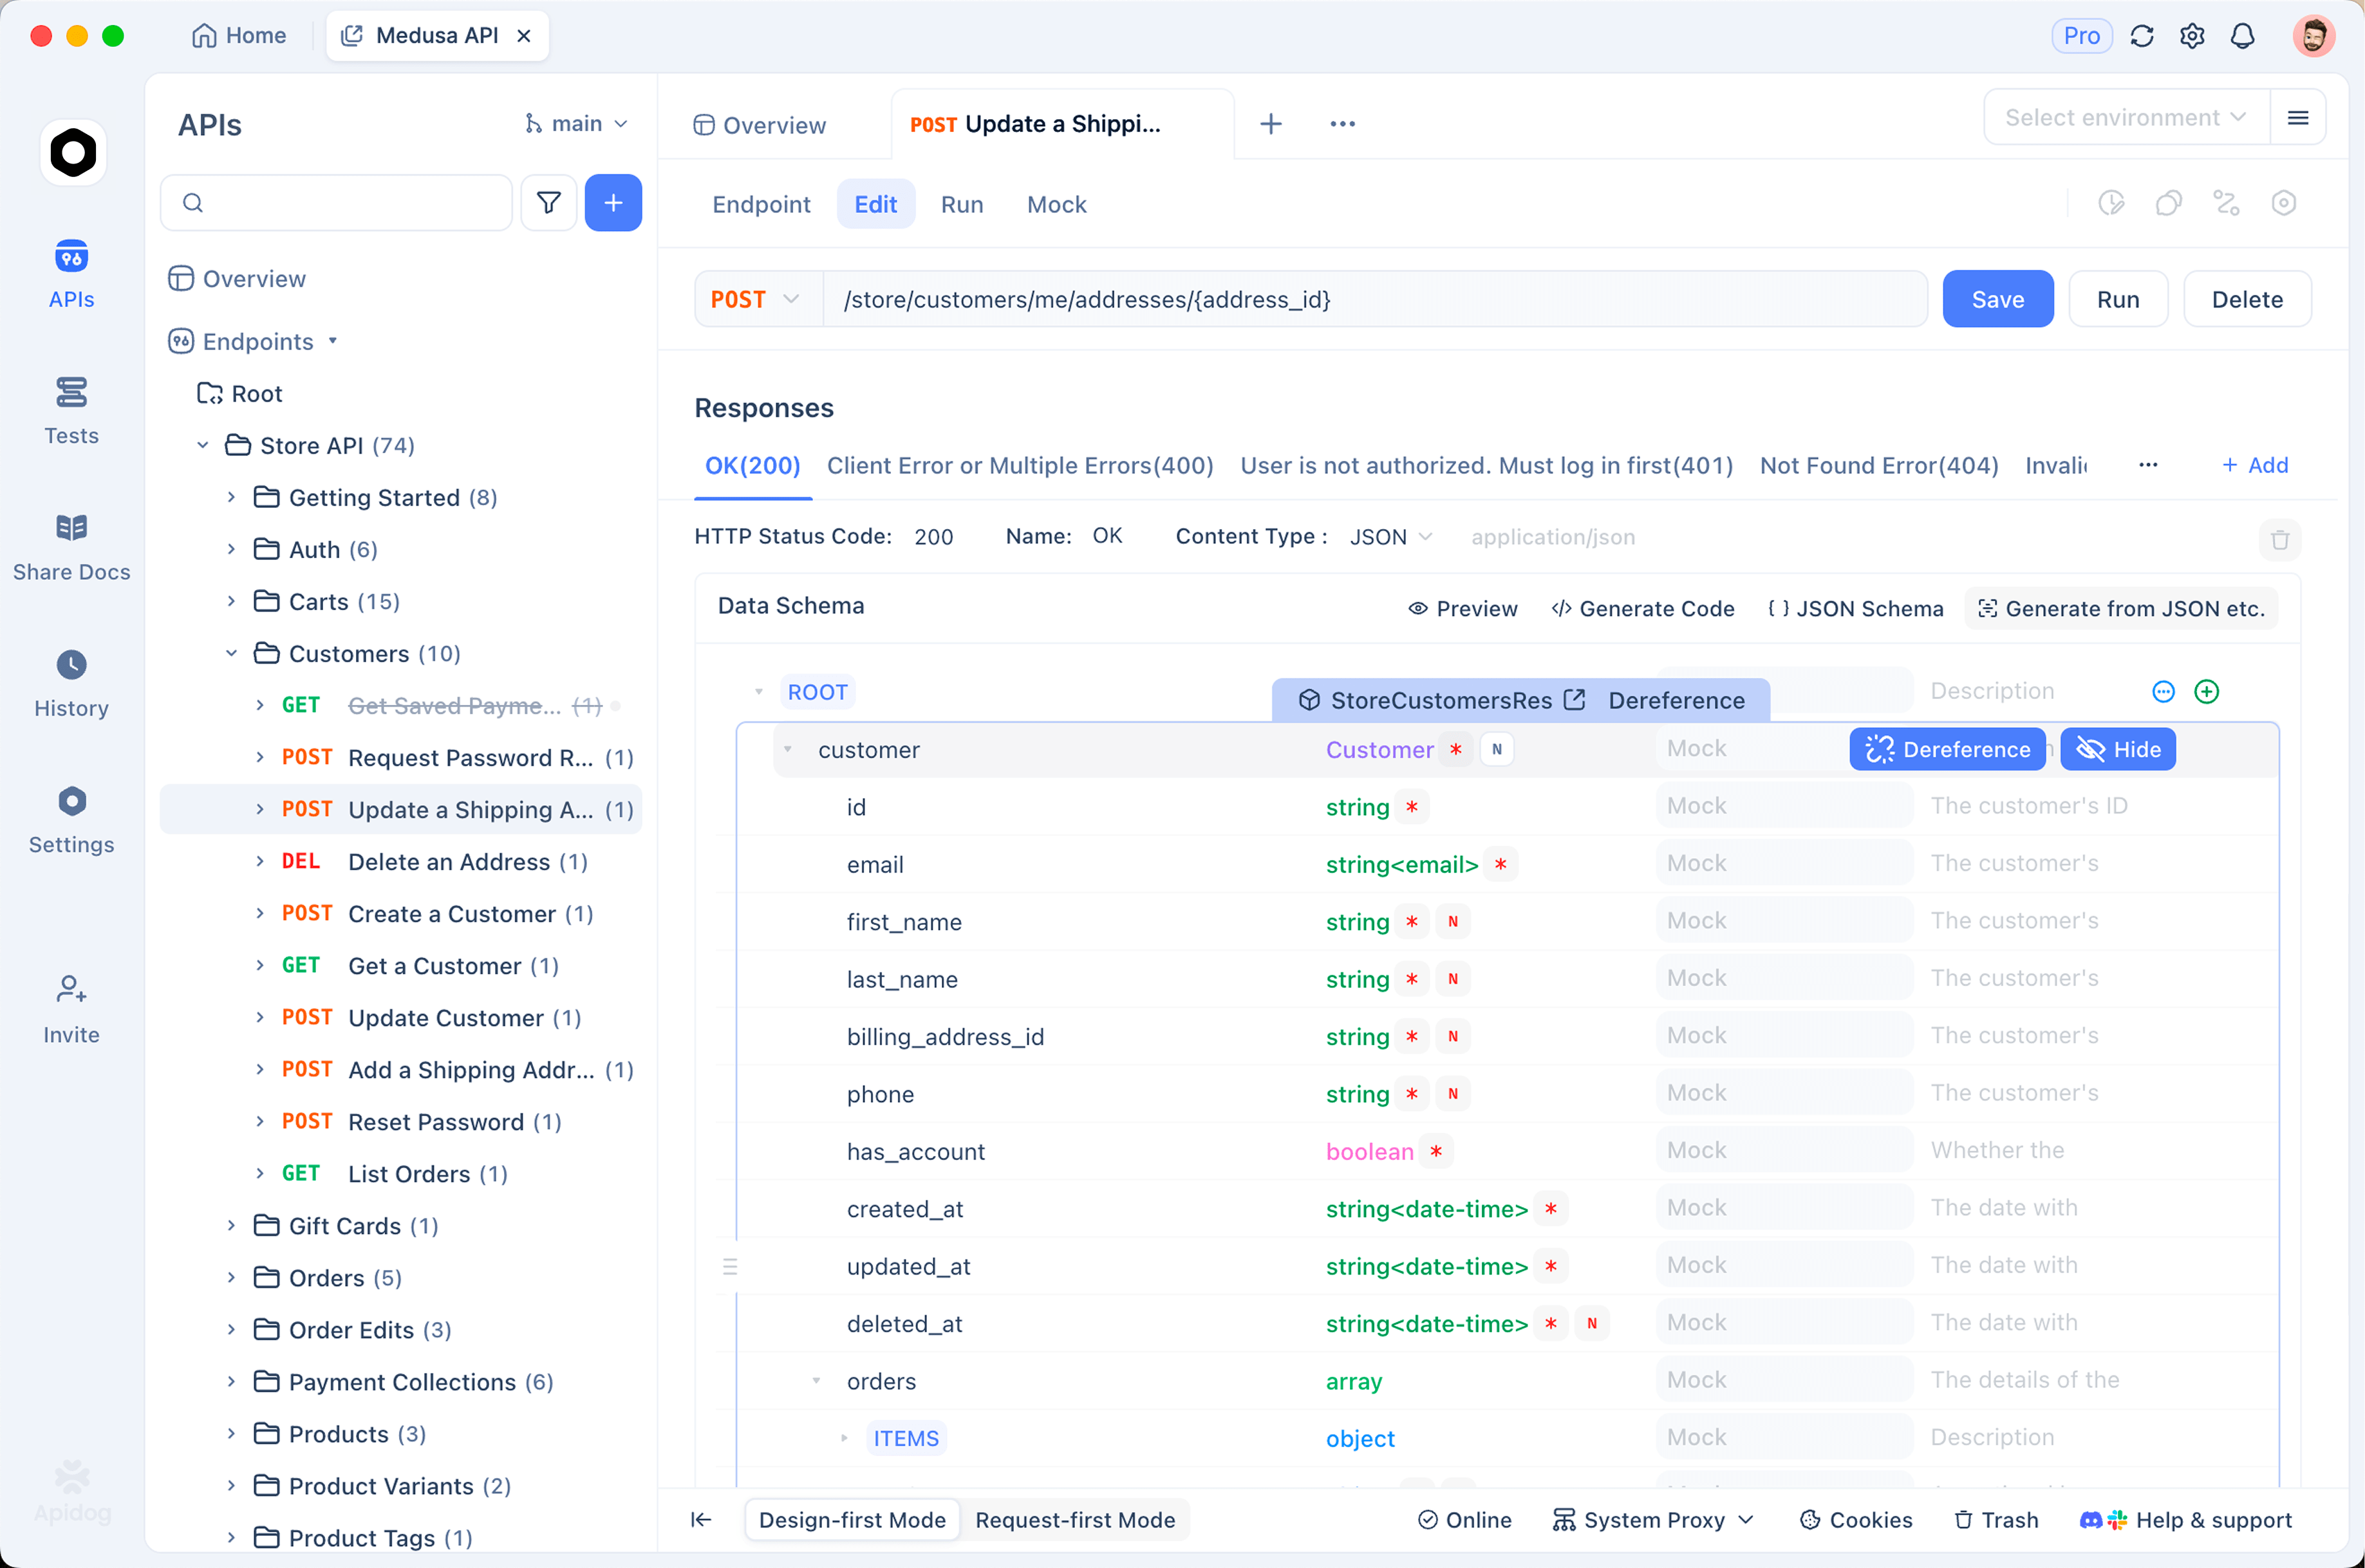
- Référence (Baseline) : votre corps de requête actuel pour Sonnet 5.
- Ancien corps, nouveau modèle : seul le
modelest changé enclaude-sonnet-5-5. Affirmez le statut 400 et un message d'erreur mentionnantbetween_toolsoutool_choice. - Migré : le corps de requête corrigé. Affirmez le statut 200, un
stop_reasonqui n'est pasrefusaloumax_tokens, et un bloctool_usepour les requêtes d'outils.
Conservez ANTHROPIC_API_KEY dans l'environnement et référencez-la comme {{ANTHROPIC_API_KEY}} dans l'en-tête x-api-key. Comparez usage.output_tokens à travers les niveaux d'effort pour obtenir votre propre coût par tâche. Enregistrée comme scénario de test, une régression vers disabled fera échouer l'exécution au lieu de la production. Bases de la requête : comment utiliser l'API Claude Sonnet 5.5.
FAQ
Claude Sonnet 5.5 est-il plus cher que Sonnet 5 ? Non. Les deux coûtent 2 $/10 $ par million de jetons avec 0,20 $ pour les lectures de cache, et le tokenizer est le même.
Pourquoi est-ce que j'obtiens “thinking.type.disabled is not supported” sur Sonnet 5.5 ? disabled a été supprimé. Envoyez thinking: {"type": "between_tools"} avec un effort low, medium ou high, sans aucun autre champ de réflexion.
Les conversations de Sonnet 5 sont-elles transférables à Sonnet 5.5 ? Oui. Sonnet 5.5 lit les blocs de réflexion de Sonnet 5. Revenir en arrière les perd : aucun autre modèle ne lit les blocs de Sonnet 5.5.
Dois-je tout migrer vers Sonnet 5.5 ? Pour la plupart des charges de travail, oui. Surveillez le travail lié à la cyber-sécurité, qui peut revenir à Sonnet 5, et les appels d'outils Bedrock, qui perdent le mode strict. Notre guide sur Claude Sonnet 5 couvre le modèle que vous quittez.
Votre prochaine étape
Enregistrez votre requête Sonnet 5 et sa jumelle 5.5 côte à côte, confirmez l'erreur 400, corrigez-la et déplacez le trafic une fois la correction validée. Téléchargez Apidog pour créer ce test.