
Anthropic a lancé Claude Opus 5 le 24 juillet 2026 et Claude Sonnet 5 le 30 juin 2026. Les deux sont de la génération actuelle. Les deux disposent d'une fenêtre de contexte de 1M et d'une sortie maximale de 128k. Les deux exécutent la pensée adaptative par défaut et exposent un paramètre d'effort. De l'extérieur, ils ressemblent au même modèle à deux prix, ce qui transforme le choix en une pure question de coût.
Cette question est assortie d'une date limite. Sonnet 5 est toujours à son tarif de lancement de 2 $ par million de jetons d'entrée et 10 $ par million de jetons de sortie. Le 1er septembre 2026, il passera au tarif standard de 3 $ / 15 $. Opus 5 est à 5 $ / 25 $ et n'est pas prévu de changer. L'écart entre les niveaux est donc de 2,5x aujourd'hui et d'environ 1,67x à partir de septembre, et ce changement est suffisamment important pour modifier de réelles décisions. Si vous budgétisez une charge de travail qui sera livrée au quatrième trimestre, budgétisez-la avec les chiffres de septembre, pas ceux d'aujourd'hui.
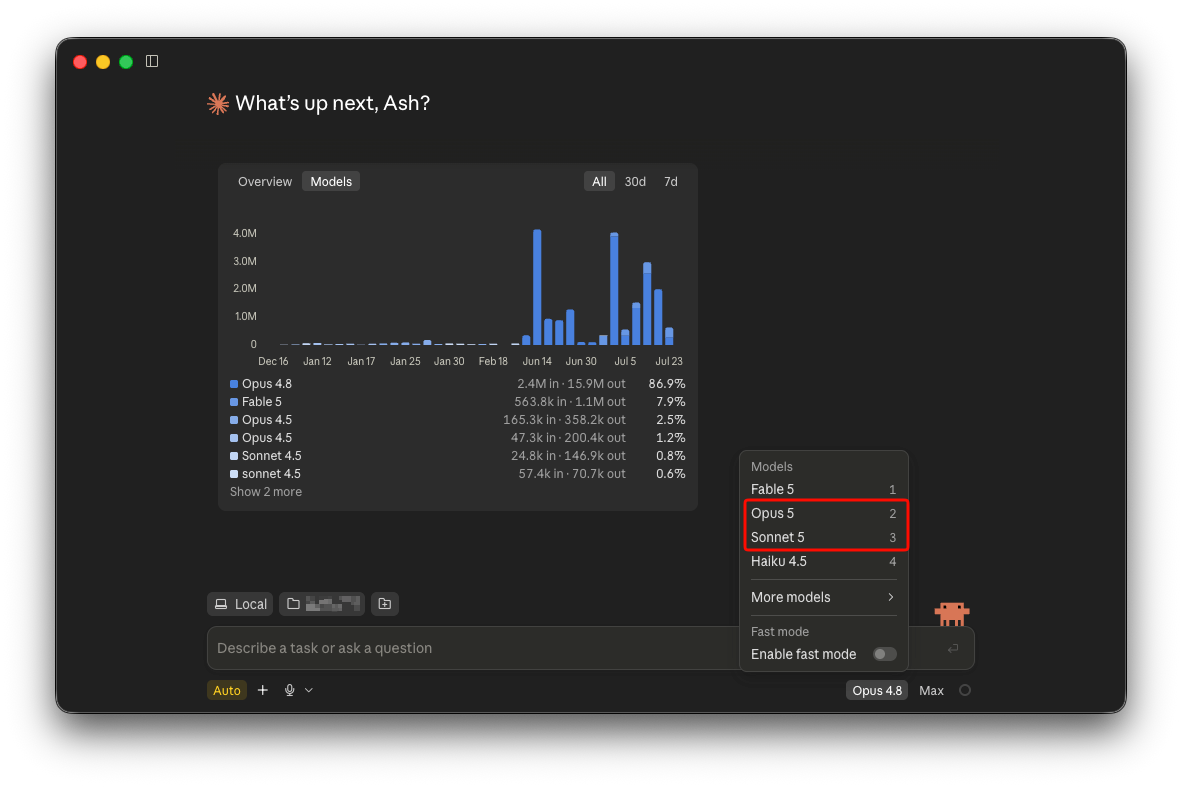
Ce guide compare les deux modèles sur leurs spécifications, le coût réel par tâche (pas le coût par jeton, qui prête à confusion ici), où l'avantage d'Opus 5 en matière de codage agentique vaut la peine d'être payé, et où Sonnet 5 est tout simplement suffisant. Si vous voulez mesurer la différence vous-même au lieu de vous fier à un tableau, vous pouvez exécuter les deux modèles côte à côte dans Apidog et lire les champs usage.
Le tableau des prix, et la date qui le modifie
Voici les tarifs de base publiés sur la page des prix d'Anthropic.
| Modèle | Entrée / MJetons | Sortie / MJetons | Statut |
|---|---|---|---|
| Claude Opus 5 | 5,00 $ | 25,00 $ | Standard |
| Claude Sonnet 5 (jusqu'au 31 août 2026) | 2,00 $ | 10,00 $ | Promotionnel |
| Claude Sonnet 5 (à partir du 1er sept. 2026) | 3,00 $ | 15,00 $ | Standard |
Opus 5 propose également des tarifs à connaître avant de modéliser quoi que ce soit : la mise en cache des prompts à 6,25 $ par MJetons pour une écriture de 5 minutes, 10 $ pour une écriture d'une heure et 0,50 $ pour les accès au cache ; l'API Batch à 2,50 $ / 12,50 $, une réduction fixe de 50 % ; le mode rapide à 10 $ / 50 $ pour une vitesse de sortie 2,5 fois plus rapide (aperçu de recherche, API propriétaire uniquement, non combinable avec le mode batch) ; et un multiplicateur de 1,1x sur chaque catégorie de jetons lorsque vous définissez inference_geo: "us". La ventilation complète avec des exemples concrets se trouve dans le guide de tarification d'Opus 5, et le côté Sonnet est couvert dans le détail de la tarification de Sonnet 5.
Un détail qui surprend : Opus 5 coûte exactement le même prix qu'Opus 4.8. Anthropic n'a pas augmenté le prix d'Opus pour un saut de génération. Ainsi, la décision Opus contre Sonnet que vous avez prise en juillet 2026 est le même calcul que vous faisiez en juin, avec un meilleur Opus d'un côté.
Spécifications : des coques presque identiques
| Spécification | Claude Opus 5 | Claude Sonnet 5 |
|---|---|---|
| ID du modèle | claude-opus-5 |
claude-sonnet-5 |
| Fenêtre de contexte | 1M jetons (par défaut et max) | 1M jetons (par défaut et max) |
| Sortie maximale | 128k (300k sur l'API Batch avec en-tête bêta) | 128k |
| Pensée adaptative | Activée par défaut | Activée par défaut |
| Niveaux d'effort | Cinq, jusqu'à max, par défaut high |
low / medium / high / xhigh |
| Date de connaissance limite | Mai 2026 | Janvier 2026 |
| Niveau de priorité | Non supporté | Non disponible |
| Mise en cache des prompts, utilisation d'outils, traitement par lots, vision | Supporté | Supporté |
| Tokeniseur | Tokeniseur de génération 4.7 | Tokeniseur de génération 4.7 |
Trois de ces lignes sont réellement pertinentes.
L'écart de date de connaissance limite est de quatre mois. Opus 5 est entraîné jusqu'en mai 2026, la date limite la plus récente de tous les modèles Claude actuels ; Sonnet 5 s'arrête en janvier 2026. Si votre charge de travail concerne des versions de bibliothèques ou des modifications d'API du printemps 2026, Opus 5 les connaît. Il s'agit d'un argument de fraîcheur plutôt que de capacité, et la récupération le comble pour l'un ou l'autre modèle.
Aucun des deux niveaux ne vous offre le Niveau de priorité. Cela déconcerte les équipes migrant depuis Opus 4.8, qui le supporte. Si vous dépendez du Niveau de priorité pour les garanties de latence, aucun des modèles de la génération actuelle n'est un remplacement direct. Le guide de migration d'Opus 4.8 vers Opus 5 couvre le reste des changements majeurs.
La ligne du tokeniseur ne constitue pas une différence, et il est important de le savoir. C'est la ligne que les gens s'attendent à voir importante ici, mais ce n'est pas le cas.
Pourquoi le coût par jeton prête encore à confusion ici
Commençons par clarifier une confusion courante. Anthropic documente que Claude 4.7 et les modèles ultérieurs utilisent un tokeniseur plus récent produisant environ 30 % de jetons en plus pour le même texte que le précédent. Opus 5 et Sonnet 5 font tous deux partie de ce groupe. Le chiffre de 30 % est mesuré par rapport à Sonnet 4.6 et aux versions antérieures, et non entre ces deux modèles.
Ainsi, Opus 5 et Sonnet 5 comptent votre texte de la même manière. Un document de 4 000 mots représente le même nombre de jetons d'entrée facturables sur les deux, et les prix par jeton publiés sont directement comparables. Si vous migrez depuis Sonnet 4.6, prévoyez l'augmentation de 30 % ; si vous choisissez entre ces deux modèles, ignorez-le.
Ce qui influe sur le coût par tâche, c'est le volume de sortie. Les propres directives de prompting d'Anthropic pour Opus 5 indiquent que ses réponses visibles par défaut et ses livrables écrits sont plus longs que ceux des modèles Opus précédents, et que la réduction de l'effort diminue la réflexion sans raccourcir de manière fiable la réponse visible. Les jetons de sortie coûtent cinq fois plus cher que les jetons d'entrée sur les deux modèles. Une requête Opus 5 qui écrit 30 % de prose en plus que ce que vous avez demandé représente un coût réel, et la solution se trouve du côté du prompt, pas du prix. Le guide de prompting d'Opus 5 couvre les instructions de concision qui permettent de le réduire.
Le point d'API de comptage de jetons d'Anthropic vous donne le nombre exact de jetons d'entrée pour les deux modèles sur votre propre texte en quelques minutes. Mesurez la sortie sur un échantillon réel de votre charge de travail plutôt que de faire des suppositions.
Voici à quoi ressemble l'arithmétique sur une charge de travail quotidienne concrète : 500k jetons d'entrée et 40k jetons de sortie.
| Scénario | Coût quotidien | Ratio vs Sonnet 5 |
|---|---|---|
| Opus 5 | 3,50 $ | référence |
| Sonnet 5, promotionnel (2 $/10 $) | 1,40 $ | Opus est 2,5x |
| Sonnet 5, standard à partir du 1er sept. (3 $/15 $) | 2,10 $ | Opus est 1,67x |
| Opus 5 écrivant 30 % de sortie en plus que demandé | 3,80 $ | Opus est 1,81x |
Cette dernière ligne est celle sur laquelle il faut s'attarder. Une verbosité que vous n'avez pas demandée peut coûter plus cher que la différence de niveau sur laquelle vous avez tergiversé, et c'est la chose la moins chère à corriger sur cette page.
Et puis il y a le calcul des réessais, c'est là que toute la comparaison est généralement décidée. Au prix standard, une exécution d'Opus 5 coûte 3,50 $ et une exécution de Sonnet 5 coûte 2,10 $. Si Sonnet 5 a besoin d'une deuxième tentative pour une tâche qu'Opus 5 accomplit en une seule, les deux exécutions coûtent 4,20 $ et Sonnet devient l'option coûteuse. Les réessais du modèle et le temps de révision humaine, pas seulement les jetons. Les leviers généraux pour les deux modèles se trouvent dans notre guide pour réduire votre facture d'API Claude.
Quand Opus 5 justifie son prix premium
Les chiffres de lancement d'Opus 5 par Anthropic sont ambitieux. Pour être clair sur leur statut : ce sont des résultats produits par le fournisseur, publiés par Anthropic, et au 25 juillet 2026, aucun d'entre eux n'a été reproduit indépendamment. Lisez-les comme des affirmations avec une source, et non comme des mesures neutres.
- Frontier-Bench v0.1 : Opus 5 surpasse tous les autres modèles et plus que double le score d'Opus 4.8, à un coût par tâche inférieur.
- ARC-AGI 3 : environ 3x le score du deuxième meilleur modèle.
- OSWorld 2.0 : surpasse Fable 5 à environ un tiers du coût.
- CursorBench 3.2 : à moins de 0,5 % du sommet de Fable 5, à moitié prix.
- Zapier AutomationBench : taux de réussite environ 1,5x le modèle suivant le plus performant.
- Science : chimie organique en hausse de 10,2 points et analyse des protéines en hausse de 7,7 points par rapport à Opus 4.8.
Les propres chiffres de lancement de Sonnet 5 sont inférieurs à ceux d'Opus 4.8 : SWE-bench Pro 63,2 % contre 69,2 %, Terminal-Bench 2.1 à 80,4 % contre 82,7 %, et OSWorld-Verified 81,2 % contre 83,4 %. L'argument de Sonnet 5 était qu'il se situait à quelques points d'Opus 4.8 pour les tâches agentiques et l'utilisation d'outils tout en coûtant beaucoup moins cher, ce qui était un argument solide en juin. Opus 5 en modifie la donne : le niveau supérieur à Sonnet est désormais matériellement meilleur que l'Opus 4.8 auquel ces comparaisons de Sonnet étaient faites. L'attribution complète et les mises en garde se trouvent dans l'analyse des benchmarks d'Opus 5 et le billet sur les benchmarks de Sonnet 5.
En pratique, Opus 5 prend l'avantage lorsque la tâche présente une ou plusieurs de ces propriétés :
- Codage agentique à long terme. Refactorisations multi-fichiers, migrations et boucles qui s'exécutent sur des dizaines d'appels d'outils. Les erreurs se cumulent dans les boucles d'agents, et un modèle qui échoue moins souvent par étape vaut plus que ce que son écart de prix ne le suggère.
- La tâche est coûteuse si elle est mal exécutée. Migrations de production, code lié à la sécurité, tout ce qu'un humain doit examiner attentivement. Le temps de révision coûte plus cher par heure que l'un ou l'autre modèle par jour.
- Utilisation d'ordinateur et automatisation de bureau. OSWorld 2.0 est le benchmark sur lequel Anthropic s'est le plus appuyé ici.
- Raisonnement scientifique et analytique complexe, où les deltas de chimie et d'analyse des protéines sont les gains les plus clairs de l'ensemble de lancement, ou travail nécessitant des connaissances de mai 2026 que vous ne pouvez pas fournir par récupération.
Quand Sonnet 5 est tout simplement suffisant
La réponse honnête pour la plupart du trafic de production est Sonnet 5. Le fait qu'Opus 5 soit meilleur ne rend pas Sonnet 5 insuffisant, et payer pour une capacité que vous ne pouvez pas détecter dans votre sortie n'est pas une stratégie.
Sonnet 5 est le bon choix lorsque :
- Le volume est élevé et chaque appel est petit. Classification, extraction, résumé, étiquetage, routage. Le plafond de qualité pour ces tâches est suffisamment bas pour que les deux modèles l'atteignent.
- La sortie est de toute façon validée automatiquement. Si une vérification de schéma ou une suite de tests détecte les échecs à moindre coût, un taux d'échec légèrement plus élevé est un taux d'échec bon marché.
- La latence compte plus que la profondeur, ou vous êtes encore en phase de prototypage. Développez sur Sonnet 5, puis mesurez si Opus 5 change quoi que ce soit avant de payer pour cela.
Il existe également une voie gratuite à connaître : Sonnet 5 est le modèle par défaut du plan gratuit de Claude, vous pouvez donc vérifier sa sortie sur vos prompts réels avant d'écrire une ligne de code. Opus 5 est désormais le modèle le plus performant disponible pour les abonnés Pro et le modèle par défaut pour Max, donc les niveaux grand public y ont également accès. Notre guide d'accès gratuit à Opus 5 présente les voies honnêtes.
Tableau de décision par charge de travail
| Charge de travail | Choix | Pourquoi |
|---|---|---|
| Refactorisation multi-fichiers ou migration dans une boucle d'agent | Opus 5 | Les erreurs cumulées font de la fiabilité par étape le coût dominant |
| Classification ou extraction à grand volume | Sonnet 5 | Les deux atteignent le plafond de qualité ; le prix l'emporte |
| Chat client avec récupération | Sonnet 5 | La récupération comble l'écart de date limite ; la latence est importante |
| Utilisation d'ordinateur ou automatisation de bureau | Opus 5 | L'écart d'OSWorld 2.0 d'Anthropic est la revendication agentique la plus claire |
| Traitement par lots de documents pendant la nuit | Sonnet 5, ou Opus 5 sur l'API Batch | Le traitement par lots avec 50 % de réduction peut placer Opus 5 près du tarif standard de Sonnet |
| Audit de sécurité ou code critique pour la production | Opus 5 | Le coût d'une erreur l'emporte sur l'écart de jetons |
| Analyse scientifique ou quantitative | Opus 5 | Les deltas en chimie et en analyse des protéines sont les gains les plus importants |
| Prototypage et outils internes | Sonnet 5 | Mesurez avant de mettre à niveau |
| Tout ce qui nécessite des connaissances du printemps 2026 sans récupération | Opus 5 | Date limite de mai 2026 contre janvier 2026 |
| UX interactive sensible à la latence | Sonnet 5 | Ou Opus 5 en mode rapide à 10 $/50 $ si la profondeur est non négociable |
Remarquez la ligne de l'API Batch. Opus 5 en mode batch coûte 2,50 $ / 12,50 $, ce qui le place en dessous du tarif standard de Sonnet 5 de septembre (3 $ / 15 $) pour l'entrée et légèrement au-dessus pour la sortie. Si votre travail tolère le traitement asynchrone, la question du niveau peut se dissoudre entièrement.
Ce que ni l'un ni l'autre modèle n'est
Opus 5 n'est pas le sommet de la pile Claude, et il est important de le dire clairement plutôt que de laisser la couverture de lancement impliquer le contraire. Fable 5 reste le modèle le plus performant et le plus largement diffusé d'Anthropic, à 10 $ / 50 $. Et Opus 5 est toujours derrière Mythos 5 en matière d'exploitation de la cybersécurité et de recherche en biologie autonome, ce qui est la propre déclaration d'Anthropic, et non une critique externe.
Le cadrage précis pour Opus 5 est une capacité de classe frontière à la moitié du prix frontière, avec un plafond désigné au-dessus. Si votre charge de travail atteint ce plafond, la vraie comparaison n'est pas Opus 5 contre Sonnet 5 du tout ; consultez plutôt Opus 5 vs Fable 5.
Faites la comparaison vous-même dans Apidog
Les benchmarks sont la charge de travail de quelqu'un d'autre. La comparaison qui compte, ce sont vos prompts, vos outils, vos critères d'acceptation. Les deux modèles se trouvent derrière le même endpoint Messages, donc les tester l'un contre l'autre est une question de changer une seule chaîne de caractères.
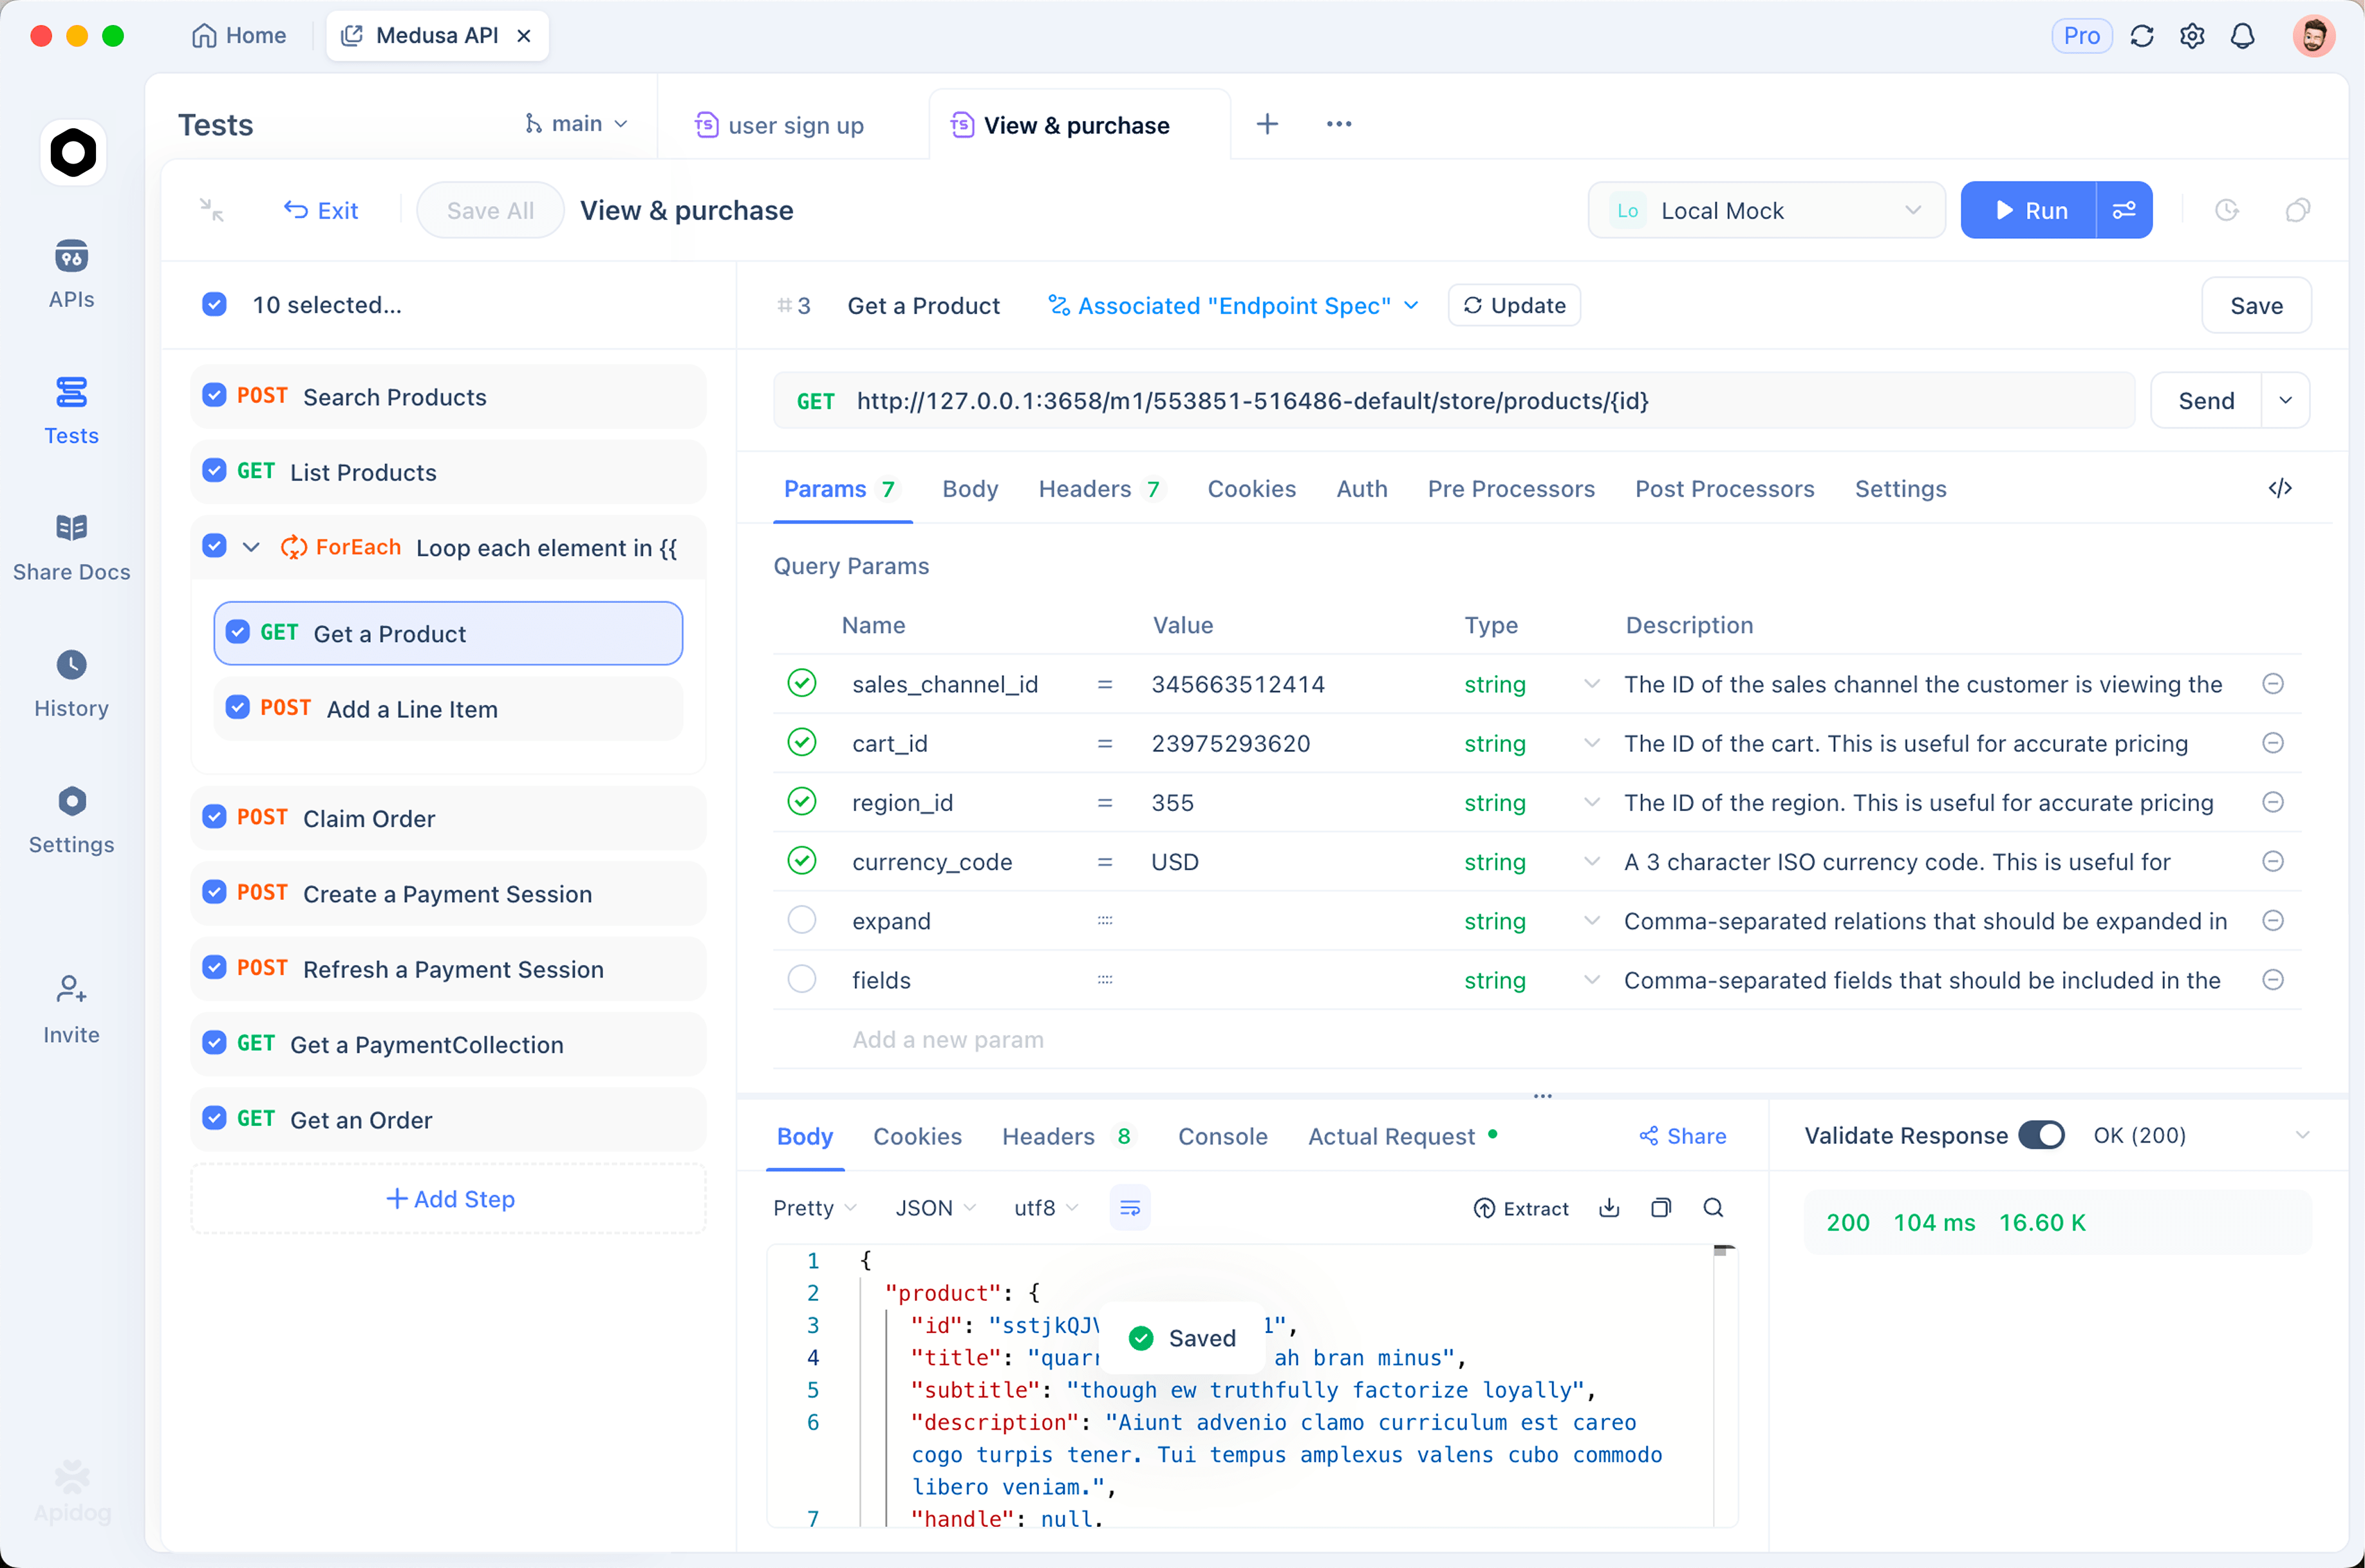
Configurez-le dans Apidog comme suit :
- Créez une requête vers le endpoint Messages d'Anthropic et stockez la clé API comme variable d'environnement plutôt que de la coller dans le corps.
- Enregistrez deux variantes partageant le même prompt, une avec
"model": "claude-opus-5"et une avec"model": "claude-sonnet-5". - Lisez l'objet
usagesur chaque réponse. Les nombres réels de jetons d'entrée, de sortie et mis en cache par modèle sont la seule entrée fiable pour un modèle de coût. - Ajoutez des assertions sur la forme de la réponse afin qu'un refus ou une réponse tronquée échoue bruyamment au lieu de silencieusement.
- Répétez la requête Opus 5 à différents niveaux
output_config.effortet comparez le coût à la qualité. Opus 5 est par défaut àhigh, et ses niveauxlowetmediumsont significativement plus puissants que sur les modèles Opus précédents, donc un balayage trouve souvent un réglage moins cher qui passe toujours. Le guide du paramètre d'effort couvre la méthode.
curl https://api.anthropic.com/v1/messages \
  --header "x-api-key: $ANTHROPIC_API_KEY" \
  --header "anthropic-version: 2023-06-01" \
  --header "content-type: application/json" \
  --data '{
    "model": "claude-opus-5",
    "max_tokens": 4096,
    "messages": [
      {"role": "user", "content": "Refactor this handler to use async I/O."}
    ]
  }'
Deux pièges lors de vos tests. La pensée adaptative est activée par défaut sur les deux modèles, et max_tokens plafonne la pensée et la réponse ensemble, donc un budget qui fonctionnait sur un ancien modèle peut tronquer. Et sur Opus 5, combiner thinking: {type: "disabled"} avec un effort xhigh ou max renvoie une erreur 400. Téléchargez Apidog pour exécuter les deux côte à côte, et consultez le guide de l'API Opus 5 pour le flux de requête complet.
FAQ
Claude Opus 5 vaut-il 2,5 fois le prix de Sonnet 5 ? Pour le codage agentique à long terme, l'utilisation d'ordinateurs et les tâches coûteuses en cas d'erreur, oui. Pour la classification, l'extraction et le chat à grand volume, généralement non. Et le multiple n'est que de 2,5x jusqu'au 1er septembre 2026, après quoi le tarif standard de Sonnet 5 de 3 $ / 15 $ le rendra environ 1,67x.
Quand la tarification de Claude Sonnet 5 change-t-elle ? Le tarif promotionnel de 2 $ / 10 $ est valable jusqu'au 31 août 2026. À partir du 1er septembre 2026, il passe à 3 $ / 15 $. Opus 5 reste à 5 $ / 25 $.
Opus 5 et Sonnet 5 tokenisent-ils le texte différemment ? Non. Les deux utilisent le tokeniseur de génération 4.7, donc un texte identique produit des nombres de jetons d'entrée identiques et les prix par jeton sont directement comparables. L'augmentation d'environ 30 % des jetons documentée par Anthropic est mesurée par rapport à Sonnet 4.6 et aux modèles antérieurs, ce qui est pertinent si vous passez de l'un de ceux-ci, mais pas si vous choisissez entre ces deux modèles. Comparez de toute façon le coût par tâche accomplie, car la longueur de la sortie et les réessais influent davantage sur la facture que l'écart de prix affiché.
Puis-je passer d'Opus 5 à Sonnet 5 sans modifier le code ? Principalement. Les deux utilisent la pensée adaptative par défaut et rejettent les paramètres d'échantillonnage non-par défaut. Les différences à surveiller sont les niveaux d'effort (Opus 5 expose un niveau max et par défaut high) et l'erreur 400 spécifique à Opus lorsque la pensée est désactivée à xhigh ou max.
Quel modèle Anthropic recommande-t-il par défaut ? La documentation d'Anthropic indique désormais de commencer par Claude Opus 5 si vous n'êtes pas sûr. Il s'agit d'une recommandation, pas d'une analyse de coût. Commencez par là, puis mesurez si Sonnet 5 vous donne le même résultat pour moins cher. L'ancienne comparaison Sonnet 5 vs Opus 4.8 reste un contexte utile sur la façon dont les niveaux se comportent les uns par rapport aux autres.
Pour les spécifications complètes, les attributions de benchmarks et la matrice de disponibilité, commencez par ce qu'est Claude Opus 5, et lisez le billet de lancement d'Opus 5 d'Anthropic et l'aperçu des modèles pour les sources primaires.