
Anthropic a lancé Claude Opus 5 le 24 juillet 2026, et la question que chaque équipe s'est posée en moins d'une heure était la même : si Opus 5 s'approche de Fable 5 pour la moitié du prix, pourquoi continuerait-on à payer pour Fable 5 ?
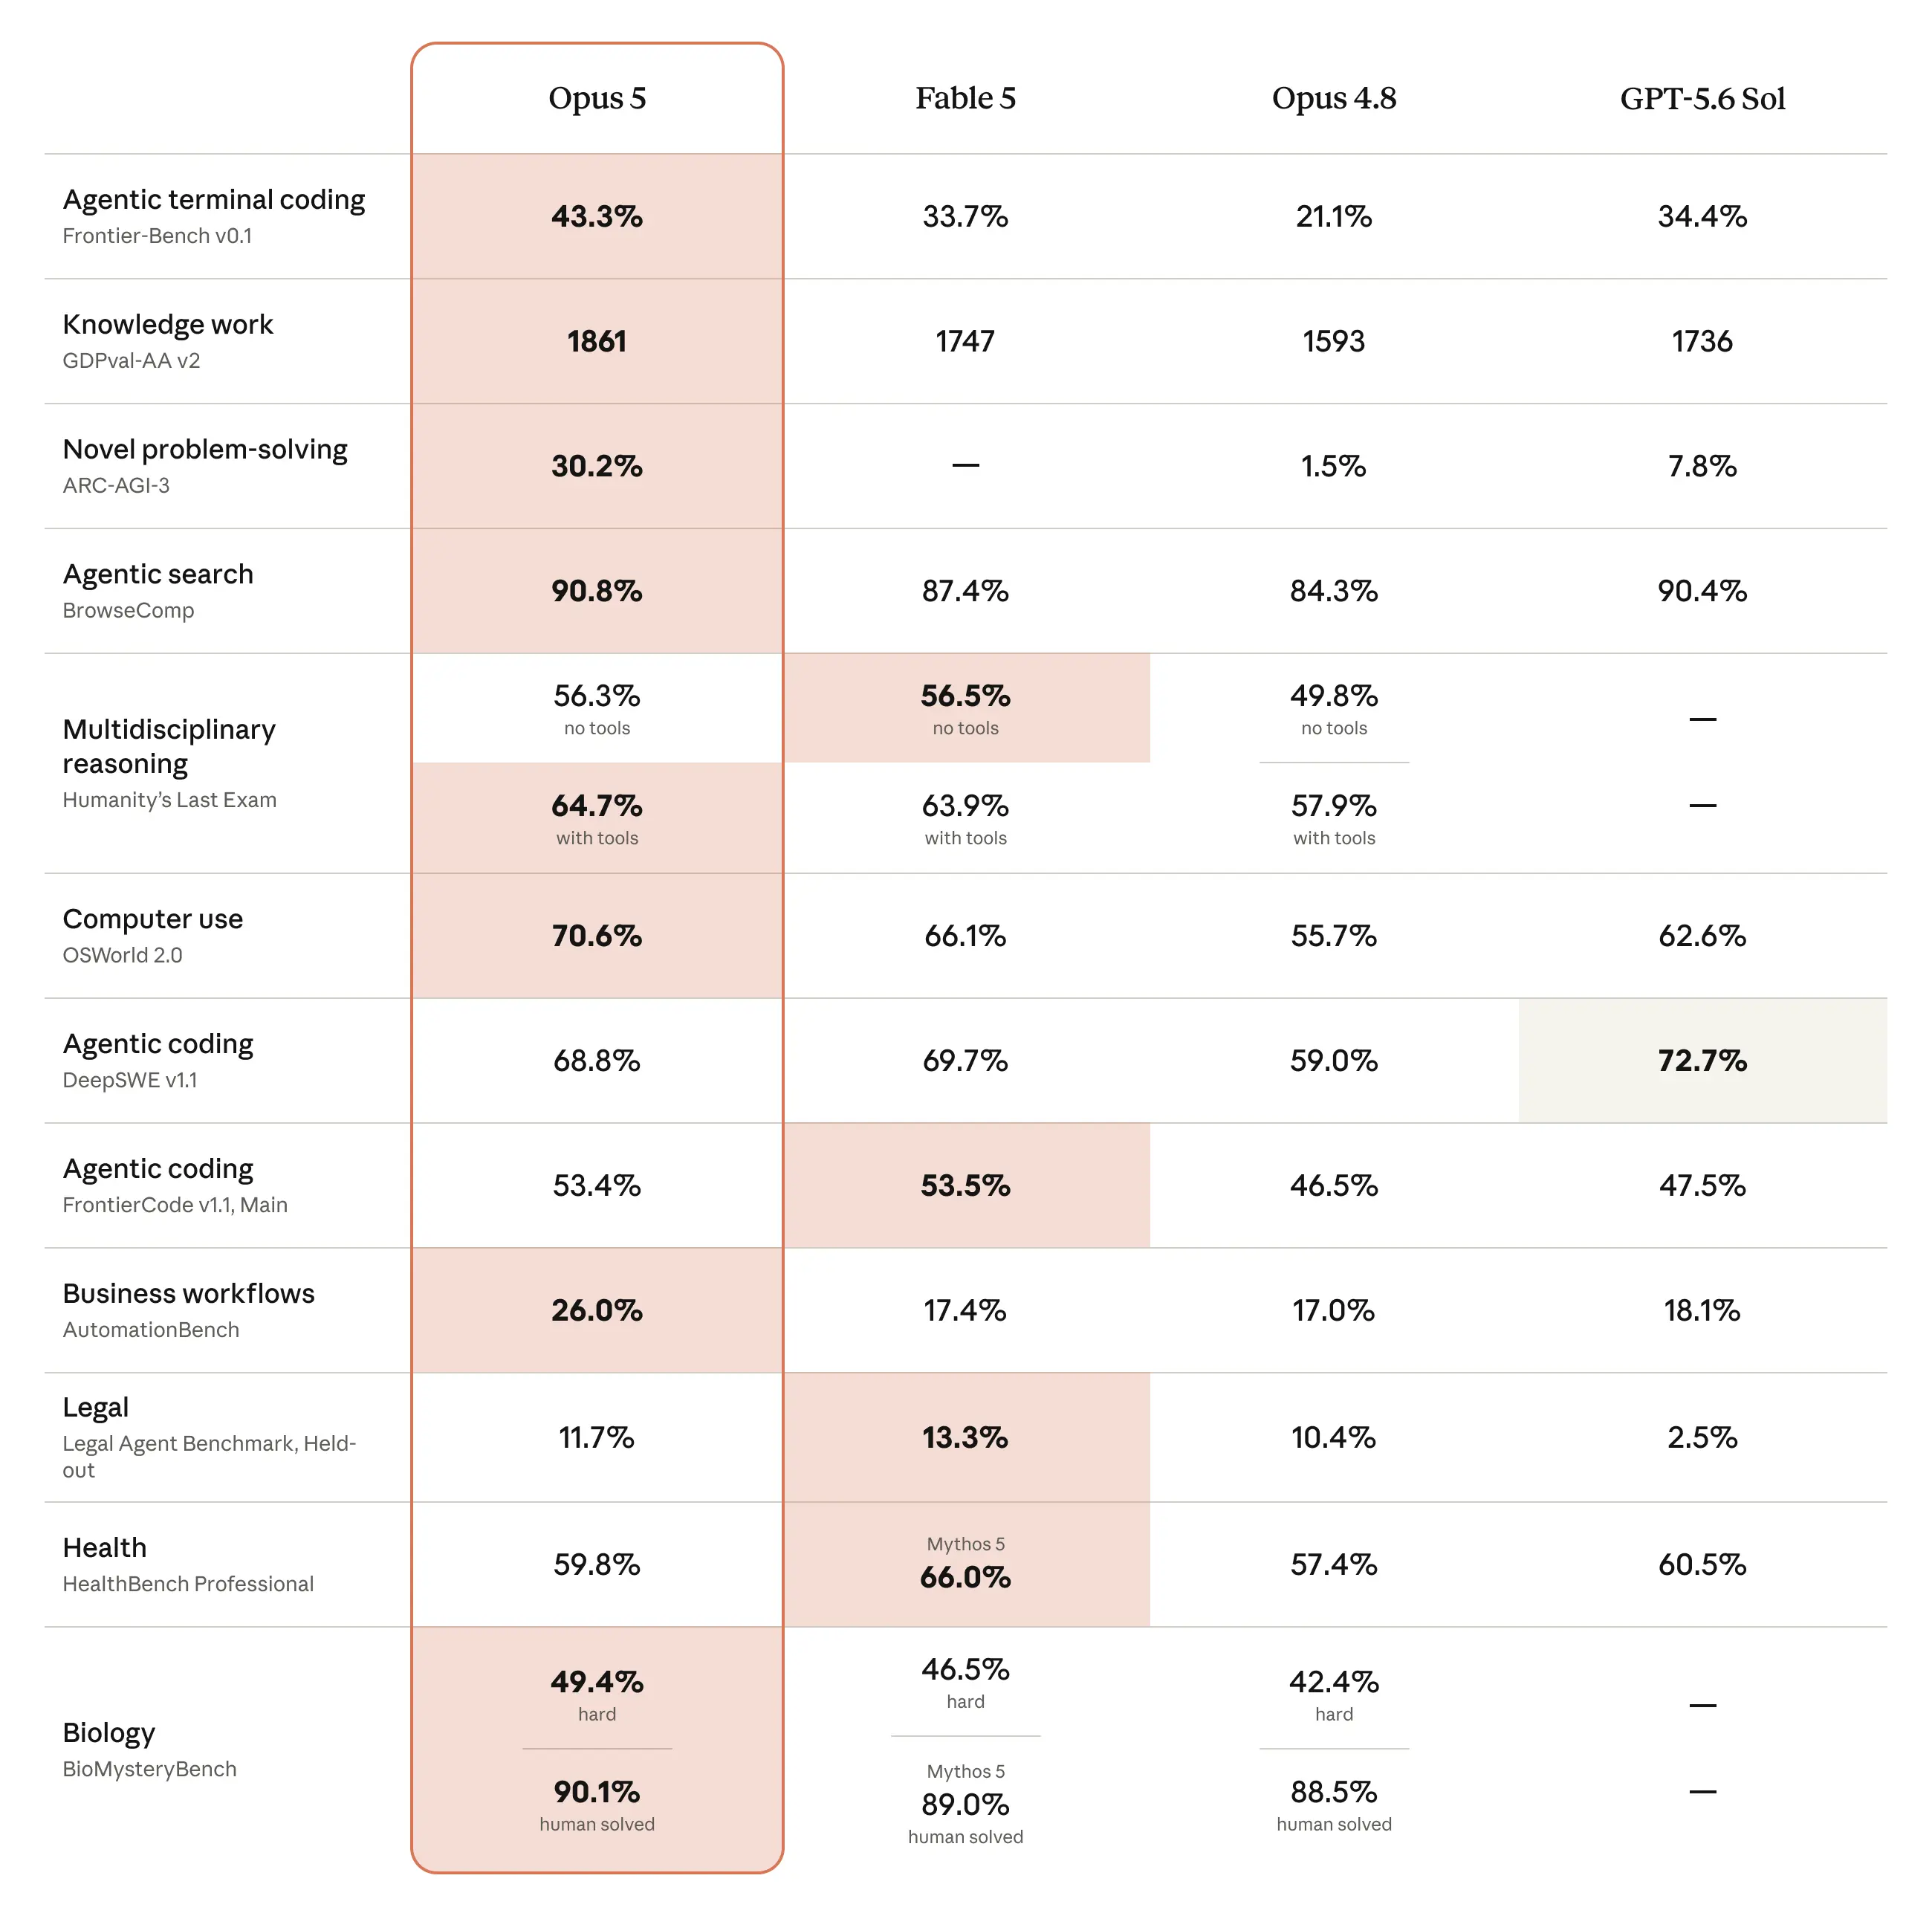
Les chiffres sont simples. Opus 5 coûte 5 $ par million de jetons d'entrée et 25 $ par million de jetons de sortie. Fable 5 coûte 10 $ et 50 $ : un écart exact de 2x des deux côtés, sans petites lignes sur les niveaux ou les minimums. Les propres affirmations d'Anthropic indiquent qu'Opus 5 atteint 0,5 % du pic de Fable 5 sur CursorBench 3.2 et surpasse Fable 5 sur OSWorld 2.0 pour un tiers du coût.
Si vous souhaitez effectuer la comparaison vous-même, vous pouvez envoyer la même invite aux deux identifiants de modèle depuis Apidog et comparer les réponses et le nombre de jetons côte à côte.
Les deux modèles en un coup d'œil
| Claude Opus 5 | Claude Fable 5 | |
|---|---|---|
| ID du modèle API | claude-opus-5 |
claude-fable-5 |
| Prix d'entrée | 5 $ / MTok | 10 $ / MTok |
| Prix de sortie | 25 $ / MTok | 50 $ / MTok |
| Fenêtre contextuelle | 1M jetons (par défaut et max) | 1M jetons |
| Sortie maximale | 128k (300k en lot avec un en-tête bêta) | 128k |
| Date de mise à jour des connaissances | Mai 2026 | Janvier 2026 |
| Positionnement | Recommandation par défaut d'Anthropic | Modèle le plus performant largement diffusé |
| Réflexion | Adaptative, activée par défaut, contrôlable via l'effort | Toujours activée |
| Lancé | 24 juillet 2026 | Début juin 2026 |
Deux lignes méritent un examen approfondi avant tout le reste.
La ligne de la date de mise à jour va à l'encontre du récit habituel selon lequel "le nouveau niveau est moins cher, l'ancien est plus intelligent". Opus 5 connaît le monde jusqu'en mai 2026. Fable 5 s'arrête en janvier 2026, la même date limite que Sonnet 5. Quatre mois de versions de packages, de versions de frameworks et de modifications d'API sont inclus dans les données d'entraînement d'Opus 5 et en dehors de celles de Fable 5. Si votre travail touche des bibliothèques en constante évolution, le modèle le moins cher est aussi le plus récent.
La ligne de positionnement va dans l'autre sens. Anthropic décrit toujours Fable 5 comme son modèle le plus performant largement diffusé, et n'a pas transféré cette étiquette à Opus 5. Opus 5 est la recommandation par défaut, ce qui est une affirmation différente : c'est vers lui que vous devriez vous tourner lorsque vous êtes incertain, pas lorsque la tâche est à la limite de ce que n'importe quel modèle peut faire.
Pour la fiche technique complète du nouveau modèle, consultez notre explication de Claude Opus 5. Pour les détails de lancement de Fable 5, voir ce qu'est Claude Fable 5.
Ce qu'Anthropic affirme réellement
Voici les affirmations de lancement qui portent sur cette comparaison, telles qu'Anthropic les présente.
| Benchmark | Revendication d'Anthropic pour Opus 5 |
|---|---|
| CursorBench 3.2 | À 0,5 % du pic de Fable 5, pour la moitié du prix |
| OSWorld 2.0 (utilisation informatique) | Surpasse Fable 5 pour un tiers du coût |
| Frontier-Bench v0.1 | Surpasse tous les autres modèles ; plus que double le score d'Opus 4.8 |
| ARC-AGI 3 | Environ 3x le modèle suivant le plus performant |
| Zapier AutomationBench | Taux de réussite environ 1,5x le modèle suivant le plus performant |
| Chimie organique | +10,2 points par rapport à Opus 4.8 |
| Analyse des protéines | +7,7 points par rapport à Opus 4.8 |
Maintenant, la mise en garde, car elle est la clé de tout. Chacun de ces chiffres est géré par le fournisseur. Anthropic a conçu la configuration d'évaluation, choisi les paramètres d'effort et publié les résultats. Au 25 juillet 2026, aucun n'a été reproduit de manière indépendante. Ce n'est pas une accusation de mauvaise foi ; c'est l'état normal d'un lancement au deuxième jour. Mais "à 0,5 % du pic de Fable 5" décrit un banc d'essai spécifique avec une configuration spécifique, et l'écart que vous mesurez sur vos propres tâches peut être plus grand ou plus petit.
L'affirmation d'OSWorld est la plus intéressante des deux chiffres en tête-à-tête, car c'est celle où Opus 5 est censé battre Fable 5 plutôt que de l'approcher. Les tâches d'utilisation informatique récompensent la persistance et la récupération plutôt que la profondeur de raisonnement brute, ce qui correspond à un modèle optimisé pour les boucles d'agent. L'affirmation de CursorBench est la plus douce : "à 0,5 % du pic de Fable 5" signifie que Fable 5 détient toujours le pic.
Nous détaillons chaque chiffre, y compris ce que chaque benchmark mesure et ne mesure pas, dans notre analyse approfondie des benchmarks d'Opus 5. Les chiffres de lancement de Fable 5 sont dans le billet sur les benchmarks de Fable 5.
L'argument en faveur d'Opus 5
L'écart de prix est constant et il se cumule. À 5 $/25 $ contre 10 $/50 $, une charge de travail coûtant 3 000 $ par mois sur Fable 5 coûte 1 500 $ sur Opus 5 pour un volume de jetons identique. Aucun seuil ou engagement ne le réduit.
Les leviers de coût s'ajoutent à la division par deux. Le taux d'API Batch d'Opus 5 est de 2,50 $/12,50 $, soit une réduction supplémentaire de 50 %. Les accès au cache et les rafraîchissements coûtent 0,50 $ par million, et le minimum de mise en cache des invites est tombé à 512 jetons (contre 1 024 sur Opus 4.8), de sorte que les courtes invites système qui étaient auparavant trop petites pour être mises en cache le sont maintenant sans modification de code. Le surcoût lié aux invites système d'utilisation d'outils est également plus faible : 286 jetons avec tool_choice réglé sur auto ou none, contre 290 sur Opus 4.8 et 675 sur Opus 4.7. Ensemble, ces éléments réduisent une facture réelle. Notre analyse détaillée des prix d'Opus 5 contient le tableau complet, et réduire votre facture API Claude couvre les leviers généraux.
Vous pouvez augmenter la dépense quand une tâche le mérite. Le paramètre output_config.effort d'Opus 5 est par défaut à high et les niveaux ont été recalibrés au lancement, avec low et medium significativement plus puissants que sur les modèles Opus précédents. Cela vous donne un cadran plutôt qu'un taux fixe : classification bon marché à low, codage agentique difficile à xhigh. Le guide du paramètre d'effort explique l'étendue à exécuter au lieu de reprendre d'anciens paramètres.
C'est le modèle le plus récent, de quatre mois.
C'est là que vont les valeurs par défaut. Opus 5 est la nouvelle valeur par défaut pour les abonnés Max et le modèle le plus performant disponible pour les utilisateurs Pro, et il est livré sur l'API Claude, claude.ai, Claude Code, Claude Cowork, Amazon Bedrock, Claude Platform sur AWS, Google Cloud, Microsoft Foundry et GitHub Copilot. La vue d'ensemble des modèles d'Anthropic indique clairement que si vous ne savez pas quel modèle utiliser, commencez par Opus 5.
L'argument en faveur de Fable 5
Défendre le modèle coûteux est un travail plus difficile, alors soyons spécifiques plutôt que polis.
La désignation de capacité n'a pas changé. Anthropic aurait pu couronner Opus 5 comme son modèle le plus performant largement diffusé le jour du lancement. Il ne l'a pas fait. Lorsqu'un fournisseur conserve un superlatif pour le modèle plus ancien et plus cher tout en livrant un modèle moins cher dont il est fièrement fier, c'est un signal concernant le sommet de la courbe de capacité, et non une erreur marketing. Pour les problèmes les plus difficiles, ceux où une seule exécution échouée coûte plus qu'un mois de dépenses API, Fable 5 est toujours le modèle qu'Anthropic indique. Son annonce de lancement est la référence pour ce positionnement.
La réflexion toujours active élimine un mode de défaillance. Fable 5 réfléchit à chaque requête : la comparaison de modèles d'Anthropic liste sa réflexion adaptative comme "toujours active", et c'est le seul modèle actuel décrit de cette façon. Opus 5 vous permet de désactiver la réflexion, et les propres directives d'invite d'Anthropic documentent ce qui se passe lorsque vous le faites : les appels d'outils sont parfois écrits en texte brut au lieu d'être exécutés (et ce texte divulgué empoisonne alors les tours ultérieurs dans une boucle d'agent), et des balises XML internes apparaissent parfois dans la sortie visible. La solution recommandée par Anthropic est de maintenir la réflexion activée et de contrôler les coûts avec un effort moindre à la place. Un modèle qui ne vous offre jamais le "footgun" ne peut pas être tiré par celui-ci.
La flexibilité d'Opus 5 a des arêtes vives. La combinaison de thinking: {type: "disabled"} avec un effort xhigh ou max renvoie une erreur 400, appliquée par requête. La réflexion s'exécute désormais par défaut lorsque vous omettez le champ thinking, de sorte que les budgets max_tokens dimensionnés pour une charge de travail sans réflexion peuvent être tronqués. Opus 5 délègue également plus facilement aux sous-agents et produit des réponses par défaut plus longues, ce qui augmente discrètement les coûts si vous ne les contraignez pas. Fable 5 ne présente aucune de ces surfaces de migration. Si vous migrez, notre guide de migration d'Opus 4.8 vers Opus 5 contient tous les changements majeurs.
Les coûts de basculement ne sont pas nuls. Vos évaluations, invites, paramètres d'effort et modèle de coûts sont calibrés par rapport au modèle que vous utilisez aujourd'hui. "La moitié du prix" est une déclaration par jeton, pas une déclaration de coût de projet. Si la migration prend deux ingénieurs une semaine et que la charge de travail est faible, l'arithmétique ne fonctionne pas. La comparaison Fable 5 vs Opus 4.8 couvre ce que le niveau Fable offre généralement par rapport au niveau Opus, et la tarification de Fable 5 couvre sa structure de coûts.
À quoi ressemble l'écart de prix dans des requêtes réelles
Les multiplicateurs sont faciles à approuver et difficiles à ressentir. Voici une tâche de codage agentique : 200 000 jetons d'entrée (un grand contexte de référentiel plus un long historique d'appels d'outils) et 20 000 jetons de sortie.
| Opus 5 | Fable 5 | |
|---|---|---|
| Entrée (200k) | 1,00 $ | 2,00 $ |
| Sortie (20k) | 0,50 $ | 1,00 $ |
| Par tâche | 1,50 $ | 3,00 $ |
| 500 tâches/mois | 750 $ | 1 500 $ |
| 5 000 tâches/mois | 7 500 $ | 15 000 $ |
Pour 500 tâches par mois, l'écart est de 750 $. C'est dans le bruit de la plupart des budgets d'ingénierie, et si Fable 5 fait économiser à votre équipe une exécution échouée par mois, il se rentabilise. Pour 5 000 tâches par mois, l'écart est de 90 000 $ par an, ce qui est une discussion sur les effectifs.
Ainsi, la règle de décision concerne le volume, et non le modèle le plus intelligent. En dessous de quelques centaines de tâches difficiles par mois, choisissez en fonction de la capacité et ignorez le prix. Au-dessus de quelques milliers, vous avez besoin de preuves que Fable 5 est meilleur sur votre charge de travail, et non sur le banc d'essai d'Anthropic.
Un autre calcul : le mode rapide d'Opus 5 (vitesse de sortie 2,5x, un aperçu de recherche uniquement sur l'API propriétaire) est tarifé à 10 $/50 $, exactement le tarif de base de Fable 5. Si la latence est la contrainte plutôt que la capacité, vous pouvez dépenser l'argent de Fable 5 pour un Opus 5 plus rapide au lieu d'un Fable 5 plus lent. Notez que inference_geo: "us" ajoute un multiplicateur de 1,1x sur chaque catégorie de jetons sur Opus 5, modifiant ces chiffres de 10 %.
Un cadre de décision par charge de travail
| Votre charge de travail | Choisir | Pourquoi |
|---|---|---|
| Codage agentique, grand volume | Opus 5 | Anthropic rapporte une performance à 0,5 % près sur CursorBench pour la moitié du coût ; le volume transforme l'écart en argent réel |
| Utilisation informatique et automatisation de navigateur | Opus 5 | Le seul benchmark où Anthropic affirme qu'Opus 5 bat Fable 5 sans équivoque |
| Travail impliquant des bibliothèques post-janvier 2026 | Opus 5 | Date de mise à jour mai 2026 contre janvier 2026 |
| Trafic de production sensible aux coûts | Opus 5 | Moitié prix, plus le mode lot, minimum de cache de 512 jetons, et effort low/medium |
| Exécutions uniques de raisonnement à enjeux élevés | Fable 5 | Toujours le modèle le plus performant largement diffusé d'Anthropic ; le coût par exécution est sans importance à faible volume |
| Sessions autonomes à long terme où un échec en cours d'exécution est coûteux | Fable 5 | Réflexion toujours active, pas d'artefacts de réflexion désactivée, pas de nouvelle surface de migration |
| Déjà stable sur Fable 5, faible volume | Fable 5 | Le coût de migration dépasse les économies |
| Exploitation de cybersécurité ou recherche en biologie autonome | Aucun des deux, voir ci-dessous | Les deux sont derrière Mythos 5 sur ces points |
Le modèle : Opus 5 l'emporte sur l'économie de débit, Fable 5 l'emporte sur le risque de queue. Si vous exécutez de nombreuses tâches et pouvez tolérer un résultat occasionnellement plus faible, diviser votre facture par deux est la solution évidente. Si vous exécutez peu de tâches et qu'un seul mauvais résultat est coûteux, la différence de prix n'est pas ce que vous devriez optimiser.
Effectuer la comparaison sur votre propre charge de travail
Les benchmarks des fournisseurs vous disent ce qui s'est passé sur les tâches de quelqu'un d'autre. Le chiffre qui décidera pour vous vient de votre propre ensemble d'évaluation, et l'obtenir prend un après-midi. Les deux modèles se trouvent derrière le même endpoint Messages, donc la comparaison est un simple changement de chaîne :
curl https://api.anthropic.com/v1/messages \
  --header "x-api-key: $ANTHROPIC_API_KEY" \
  --header "anthropic-version: 2023-06-01" \
  --header "content-type: application/json" \
  --data '{
    "model": "claude-opus-5",
    "max_tokens": 8192,
    "output_config": {"effort": "high"},
    "messages": [
      {"role": "user", "content": "Refactor this handler and explain the tradeoffs."}
    ]
  }'
Échangez claude-opus-5 contre claude-fable-5 et vous obtenez l'autre côté du test. Une configuration pratique dans Apidog ressemble à ceci :
- Stockez la clé API comme variable d'environnement afin qu'elle ne se trouve jamais dans le corps d'une requête, et créez un environnement par modèle avec l'ID du modèle comme variable.
- Enregistrez la requête dans une collection et exécutez le même scénario sur les deux environnements, de sorte que la seule chose qui change est la chaîne du modèle.
- Lisez les champs
usagesur chaque réponse. Comparez les jetons d'entrée, de sortie et de lecture du cache ; c'est là que la différence de coût réelle apparaît, car Opus 5 a tendance à produire des réponses par défaut plus longues. - Inspectez le flux SSE et les charges utiles des appels d'outils lorsque vous comparez le comportement agentique. Le fait qu'un modèle ait exécuté un outil ou ait écrit l'appel en texte est visible dans le flux d'événements bruts.
- Répétez l'exécution d'Opus 5 avec un effort
low,medium,highetxhigh. La vraie question n'est généralement pas "Opus 5 ou Fable 5" mais "quel niveau d'effort sur Opus 5 correspond à la sortie de Fable 5 pour laquelle je paie".
L'étape cinq est celle que la plupart des équipes ignorent et celle qui décide de l'argent. Téléchargez Apidog pour configurer les environnements, ou suivez la procédure de requête complète dans notre guide API d'Opus 5. La page de tarification d'Anthropic contient les tarifs officiels pour les deux modèles.
Le plafond honnête
Aucun des modèles de cette comparaison ne représente le sommet de la pile d'Anthropic.
Fable 5 reste le modèle le plus performant largement diffusé selon la désignation d'Anthropic, et Opus 5 n'a pas hérité de cette étiquette. Et au-dessus de ces deux modèles, sur deux axes de capacité spécifiques, se trouve Mythos 5 : Anthropic affirme qu'Opus 5 est toujours en deçà de Mythos 5 en matière d'exploitation de cybersécurité et de recherche en biologie autonome. Mythos 5 est le frère sans classificateur, diffusé à Fable 5 dans le cadre d'un programme limité plutôt qu'au grand public, ce n'est donc pas une option pour la plupart des équipes ; notre comparaison Fable 5 vs Mythos 5 couvre l'éligibilité.
Le résumé précis d'Opus 5 est donc plus restreint que les titres : une capacité de pointe pour la moitié du prix de pointe, avec un plafond nommé au-dessus. C'est un excellent produit. Ce n'est pas "le meilleur modèle coûte désormais deux fois moins cher", et quiconque vous vend cette version omet la partie où Anthropic lui-même a conservé la couronne de la capacité sur le modèle plus cher.
FAQ
Claude Opus 5 est-il meilleur que Fable 5 ? Selon les propres benchmarks d'Anthropic, Opus 5 surpasse Fable 5 sur les tâches d'utilisation informatique d'OSWorld 2.0 et atteint 0,5 % du pic de Fable 5 sur CursorBench 3.2, le tout pour une fraction du coût. Ces chiffres sont fournis par le fournisseur et non reproduits au 25 juillet 2026. Anthropic désigne toujours Fable 5 comme son modèle le plus performant largement diffusé, donc sur les tâches les plus difficiles, Fable 5 conserve l'avantage.
Combien Opus 5 est-il moins cher que Fable 5 ? Exactement la moitié des deux côtés : 5 $/25 $ par million de jetons d'entrée/sortie contre 10 $/50 $. Le taux d'API Batch d'Opus 5 de 2,50 $/12,50 $ élargit encore l'écart pour le travail non urgent.
Quel modèle a la date de mise à jour des connaissances la plus récente ? Opus 5, de quatre mois. Sa date limite fiable est mai 2026 ; celle de Fable 5 est janvier 2026.
Devrais-je migrer ma charge de travail Fable 5 vers Opus 5 ? Calculez d'abord le volume. En dessous de quelques centaines de tâches difficiles par mois, les économies justifient rarement le travail de migration. Au-dessus de quelques milliers, elles le font clairement, à condition que votre propre ensemble d'évaluation confirme que la qualité est maintenue.
Quel est l'ID du modèle pour chacun ? claude-opus-5 et claude-fable-5, tous deux sans suffixe de date. Sur Amazon Bedrock, Opus 5 est anthropic.claude-opus-5.
Y a-t-il quelque chose qu'Opus 5 prend en charge et que Fable 5 ne prend pas en charge ? Opus 5 expose le paramètre output_config.effort avec des niveaux recalibrés, accepte les messages système en cours de conversation, prend en charge le mode rapide à 10 $/50 $, et met en cache des invites aussi courtes que 512 jetons. Un écart dans l'autre sens : le niveau de priorité (Priority Tier) n'est pas pris en charge sur Opus 5, bien qu'Opus 4.8 le conserve.
La réponse courte
La moitié du prix en vaut la peine pour la plupart des équipes, et la raison est le volume plutôt que la capacité. Les chiffres d'Anthropic placent Opus 5 suffisamment proche en codage agentique et en avance sur l'utilisation informatique pour que l'économie de 2x se transforme en un budget réel pour des milliers de tâches par mois. Ajoutez la date de mise à jour de mai 2026 et le cadran d'effort, et la réponse par défaut est Opus 5.
Gardez Fable 5 lorsque la tâche se situe à la limite de ce que n'importe quel modèle peut faire, lorsqu'une seule exécution échouée coûte plus que la différence de prix, ou lorsque votre volume est suffisamment faible pour que le travail de migration l'emporte sur les économies. Et traitez chaque benchmark ici pour ce qu'il est : une mesure propre au fournisseur, sur un banc d'essai propre au fournisseur, en attente de reproduction. Votre ensemble d'évaluation est le facteur décisif.