
Anthropic a livré Claude Opus 5.5 le 22 septembre 2026. Pour quiconque appelle l'API Claude, la mise à niveau tient en une chaîne : claude-opus-5 devient claude-opus-5-5.
Ce qui se cache derrière cette chaîne, c'est un coût par token inférieur de 20 % dans les deux sens, une limite d'une réponse unique à 128 000 tokens en sortie, une production annoncée 30 % plus rapide, et une conception lui permettant de rester sur une même tâche pendant 18 heures ou plus. Rien de tout cela n'est sans conséquences pour le code que vous avez calibré sur Opus 5.
C'est le deuxième saut de migration sur cette ligne de modèles et il ne ressemble en rien au premier. Opus 4.8 vers Opus 5 était une migration de correction : les valeurs par défaut avaient bougé sous du code fonctionnel, et une combinaison de requête auparavant valide s'est mise à renvoyer un 400 franc. Ce saut-ci est une migration de budget et d'enveloppe opérationnelle. Le travail consiste à re-mesurer des chiffres que vous avez déjà mesurés une fois, parce que chacun d'entre eux a changé. Opus 5.5 est également arrivé le même jour que deux nouveaux modèles d'OpenAI, ce qui est une autre histoire.
Le diff, dans les seules cellules que nous pouvons sourcer
| Ligne | Opus 5 | Opus 5.5 | Changement |
|---|---|---|---|
| Id du modèle | claude-opus-5 |
claude-opus-5-5 |
une chaîne |
| Entrée, par million de tokens | 5,00 $ | 4,00 $ | 20 % de moins |
| Sortie, par million de tokens | 25,00 $ | 20,00 $ | 20 % de moins |
| Écriture de cache, par million | voir la page du fournisseur | 5,00 $ | inconnu |
| Lecture de cache, par million | voir la page du fournisseur | 0,20 $ | inconnu |
| Mode rapide, par million | voir la page du fournisseur | 8,00 $ en entrée, 40,00 $ en sortie | inconnu |
| Tokens de sortie maximum | voir la page du fournisseur | 128 000 | inconnu |
| Fenêtre de contexte | voir la page du fournisseur | 1 000 000 | inconnu |
Les cellules vides sont délibérées. Anthropic a publié le côté Opus 5.5 sur sa page modèle et nous n'allons pas reconstruire le côté Opus 5 de mémoire, parce qu'un chiffre erroné dans un modèle de coûts est pire qu'un chiffre manquant. Récupérez ces cinq lignes sur la page tarifaire d'Anthropic avant de bâtir une estimation d'économies dessus.
1. Le changement d'id est réel, les 20 % sont réels, les 40 % demandent à être lus
Changez la chaîne et vous payez 20 % de moins par token dans les deux sens. Cette partie relève de l'arithmétique : de 5 $ à 4 $ en entrée, de 25 $ à 20 $ en sortie, la même réduction des deux côtés.
Anthropic indique aussi qu'Opus 5.5 coûte 40 % de moins à exploiter qu'Opus 5. Ces deux chiffres ne sont pas en contradiction, mais ce ne sont pas non plus la même affirmation. Une réduction de 20 % par token ne peut pas produire à elle seule une baisse de facture de 40 %. L'autre moitié doit venir du fait que le modèle utilise moins de tokens pour accomplir le même travail, et l'efficacité en tokens dépend de la charge de travail d'une manière qui n'a rien à voir avec une grille tarifaire.
Traitez donc les 40 % comme une raison de re-mesurer plutôt que comme un chiffre à inscrire dans une prévision. Rejouez un échantillon représentatif du trafic réel de la semaine dernière contre les deux ids de modèle avec des prompts et des réglages identiques, comparez les blocs usage plutôt que votre impression à leur sujet, et multipliez les nombres réels de tokens par les nouveaux tarifs. Votre réponse se situera quelque part entre 20 % et 40 %, et l'endroit où elle se situe vous dit quelque chose d'utile sur la part de votre prompt qui n'a jamais été nécessaire.
2. La ligne du cache est le plus grand changement de prix du tableau
Les lectures de cache sur Opus 5.5 coûtent 0,20 $ par million de tokens contre 4,00 $ pour de l'entrée fraîche, soit une remise de 95 %. Les écritures de cache coûtent 5,00 $ par million, une prime de 1,00 $ par rapport aux 4,00 $ que vous auriez payés pour envoyer ces tokens sans cache.
Cette prime s'amortit dès la première réutilisation, et largement. Écrire un préfixe coûte 1,00 $ par million de plus que de ne pas le mettre en cache. Chaque lecture ultérieure de ce préfixe économise 3,80 $ par million. Vous atteignez le seuil de rentabilité à environ un quart d'une relecture, ce qui signifie en pratique : si le préfixe est réutilisé ne serait-ce qu'une fois, le mettre en cache était la bonne décision.
Voici la forme que cela prend sur un prompt système de 200 000 tokens, ce qui est une taille normale une fois que vous y collez un ensemble de specs OpenAPI :
| Schéma | Coût pour 10 appels |
|---|---|
| Entrée fraîche à chaque appel, 4,00 $/M | 8,00 $ |
| Une écriture à 5,00 $/M, puis 9 lectures à 0,20 $/M | 1,36 $ |
Mêmes prompts, même modèle, 83 % de moins. La requête qui vous mène à la deuxième ligne marque le préfixe explicitement :
{
  "model": "claude-opus-5-5",
  "max_tokens": 4096,
  "system": [
    {
      "type": "text",
      "text": "<votre ensemble de specs de 200k tokens>",
      "cache_control": {"type": "ephemeral"}
    }
  ],
  "messages": [
    {"role": "user", "content": "Quels endpoints ont changé entre la v2 et la v3 ?"}
  ]
}
Lisez ensuite la réponse pour confirmer que vous avez obtenu un hit, car un cache que vous croyez avoir et que vous n'avez pas est le plus coûteux de tous :
"usage": {
  "input_tokens": 41,
  "cache_creation_input_tokens": 204800,
  "cache_read_input_tokens": 0,
  "output_tokens": 612
}
Au premier appel, cache_creation_input_tokens porte la charge. À chaque appel suivant, ce nombre devrait tomber à zéro et cache_read_input_tokens devrait prendre le relais. Si ce n'est pas le cas, quelque chose en amont modifie votre préfixe, généralement un horodatage, un id de requête ou une liste d'outils réordonnée. Enregistrer un appel dans Apidog et le déclencher deux fois est le moyen le plus rapide de voir lequel des deux champs bouge. Le calcul complet, y compris quand un contexte de 1M vaut la peine d'être mis en cache, se trouve dans le calcul de coût du cache de prompts d'Opus 5.5.
3. Une réponse de 128 000 tokens est un problème de client avant d'être un problème de modèle
Opus 5.5 renverra jusqu'à 128 000 tokens en sortie dans une seule réponse. À 20 $ par million, cela fait 2,56 $ pour un seul appel poussé au maximum, ce qui vaut la peine d'être su avant que quelqu'un règle max_tokens au plafond dans une boucle de retry.
Le problème plus important, c'est tout ce qui se trouve entre le modèle et votre code :
- Délais d'attente de lecture HTTP. Une réponse aussi longue prend des minutes, pas des secondes. Les délais d'attente par défaut des clients dans la plupart des SDK et des proxys inverses sont plus courts que cela.
- Tampons des proxys et passerelles. Une passerelle qui met en tampon le corps complet avant de le transmettre retient des mégaoctets par requête en vol, et certaines couperont simplement la connexion.
- Appels non-streaming. Sans streaming, vous attendez tout le temps sans rien à montrer et sans rien à point de contrôle.
- JSON tronqué. Atteindre
max_tokensau milieu d'un objet produit du JSON invalide, pas un objet partiel que vous pouvez récupérer. Vérifiezstop_reasonavant d'analyser.
Augmenter max_tokens parce que le plafond a été relevé, c'est la moitié facile. Faire en sorte que votre chaîne de délais d'attente, vos tampons et votre parseur s'accordent avec le nouveau plafond, c'est la moitié qui provoque l'incident.
4. Une sortie plus rapide ne signifie pas une attente plus courte
Anthropic indique qu'Opus 5.5 produit une sortie 30 % plus rapide qu'Opus 5. La vitesse de sortie n'est qu'un terme dans la latence que vous servez réellement. Le temps jusqu'au premier token, les retries et la mise en file d'attente se situent à côté, et un modèle qui streame plus vite peut quand même sembler plus lent s'il réfléchit plus longtemps avant que le premier token n'arrive.
Mesurez-le donc. Déclenchez un ensemble fixe de prompts représentatifs contre les deux ids de modèle depuis la même position réseau, et enregistrez séparément le p50 et le p95 pour le temps jusqu'au premier token et pour le temps total. La latence moyenne masque le cas qui vous vaut une alerte.
Si vous conservez des scénarios de test d'API dans Apidog, c'est une petite tâche : clonez une requête enregistrée, changez l'id du modèle, lancez les deux selon un planning, et lisez la série temporelle des temps de réponse plutôt qu'un chronomètre. L'essentiel est d'entamer la migration avec un chiffre « avant », car une fois le basculement effectué, il n'y a aucun moyen d'en obtenir un.
5. Le mode rapide est exactement le double du tarif catalogue
Le mode rapide sur Opus 5.5 coûte 8,00 $ par million en entrée et 40,00 $ par million en sortie. Placés à côté des 4,00 $ et 20,00 $ standard, la règle tarifaire est facile à retenir : le mode rapide est un simple x2 des deux côtés.
Cela transforme la décision en arithmétique plutôt qu'en jugement : si la latence sur une route donnée vaut la peine de doubler la facture de tokens de cette route, utilisez-le là, et sinon, ne le faites pas. La répartition habituelle consiste à utiliser le mode rapide sur les chemins interactifs et les tarifs standard pour le travail par lots et en arrière-plan.
6. Traitez le tableau de benchmarks comme une raison de tester, pas comme un résultat
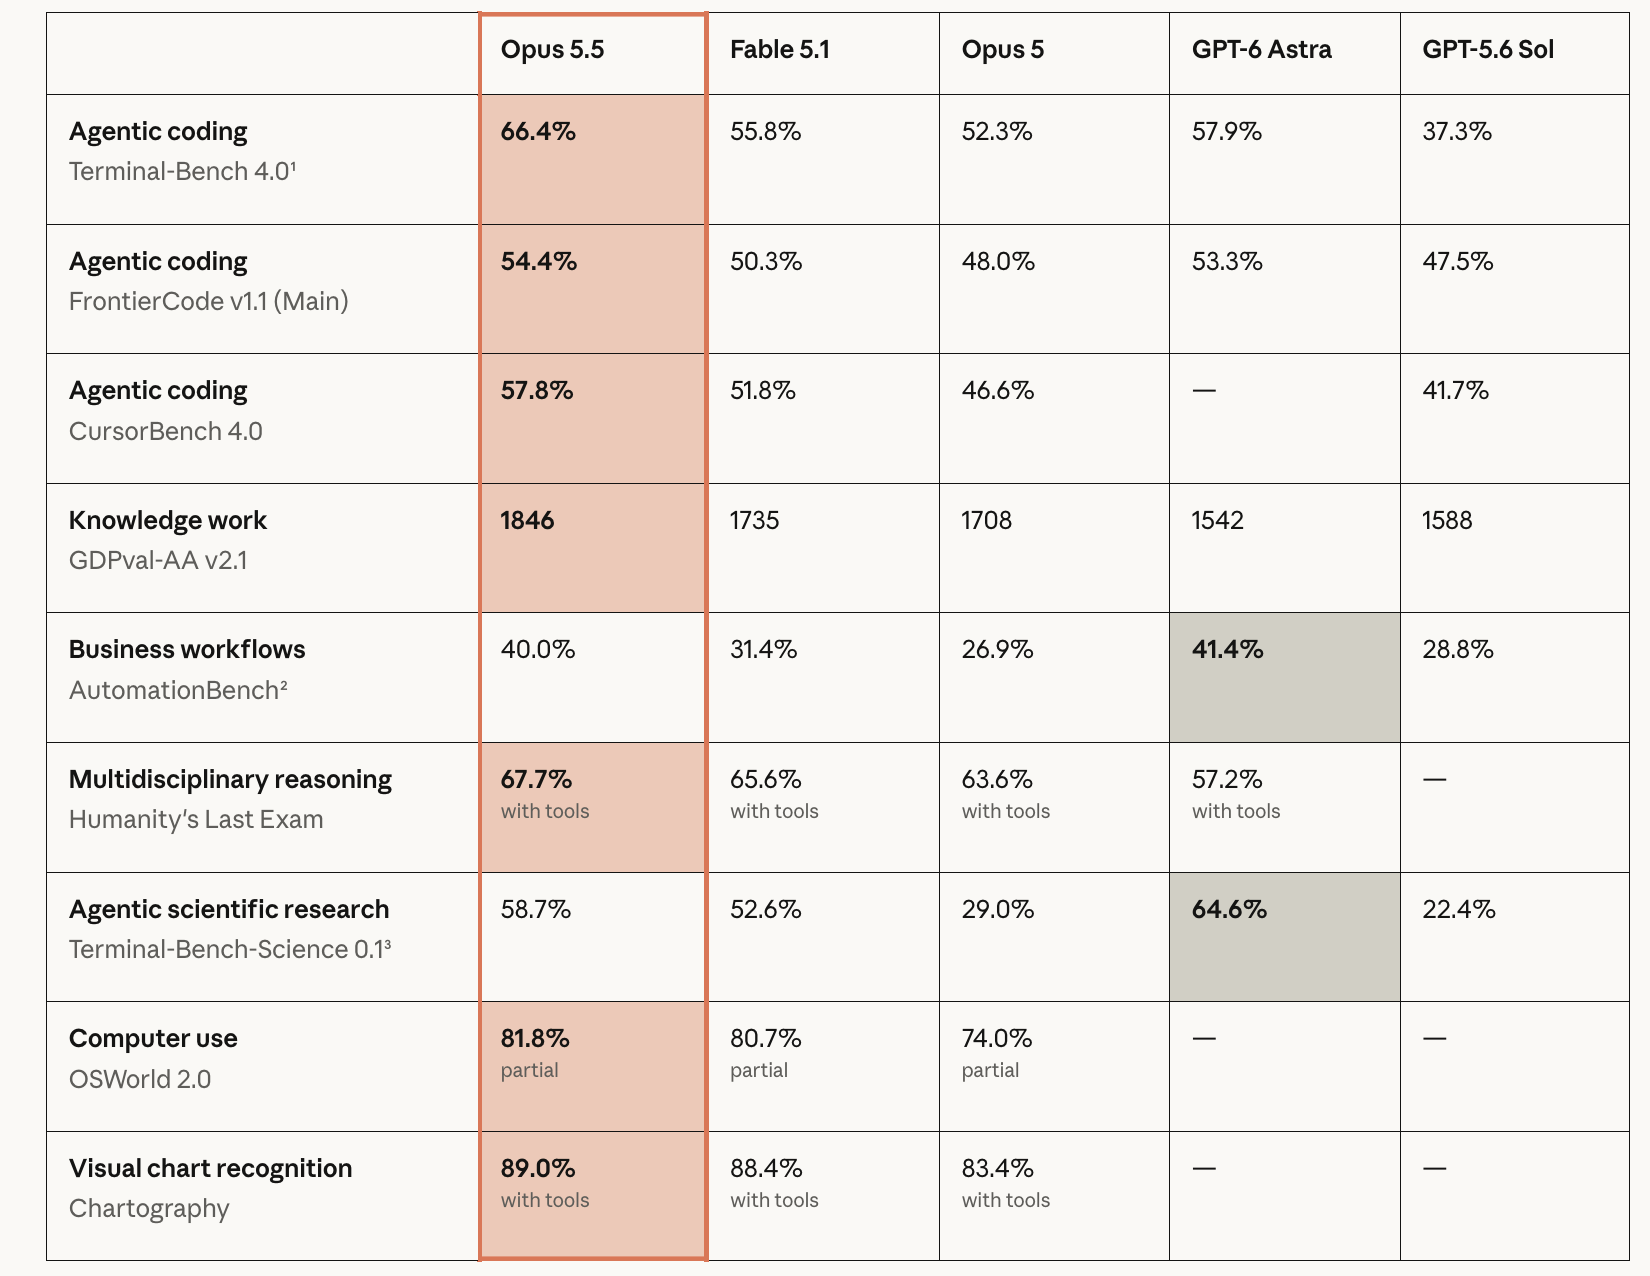
Les chiffres publiés par Anthropic pour Opus 5.5 sont solides : Terminal-Bench 4.0 à 66,4 %, FrontierCode v1.1 à 54,4 %, CursorBench 4.0 à 57,8 %, GDPval-AA v2.1 à 1846 Elo, AutomationBench à 40,0 %, Humanity's Last Exam à 67,7 % avec outils, OSWorld 2.0 à 81,8 %, et Chartography à 89,0 %. Artificial Analysis, un tiers plutôt que l'un ou l'autre des fournisseurs, le place premier sur 212 modèles dans son indice avec un score de 58.
Deux autres affirmations du fournisseur importent sur le plan opérationnel plutôt que concurrentiel. Opus 5.5 est conçu pour rester sur une seule tâche pendant 18 heures ou plus, ce qui casse beaucoup d'hypothèses ordinaires sur les délais d'attente, les retries et la reprise. Et Anthropic rapporte 85 % de tentatives réussies de contournement de frontières en moins, ce qui est une propriété testable de vos propres endpoints plutôt qu'une propriété que vous héritez.
Aucun de ces éléments ne vous dit si Opus 5.5 est meilleur sur vos prompts. Faites tourner votre propre ensemble d'évaluations sur les deux ids avant de basculer la production, pour la même raison que vous ne livreriez pas une mise à niveau de base de données sur les chiffres de benchmark du fournisseur.
Liste de contrôle de migration
- Remplacez
claude-opus-5parclaude-opus-5-5dans un seul service, pas dans tous. - Lisez le guide de migration d'Anthropic pour ce saut avant de supposer que la surface des paramètres est inchangée. Le saut de 4.8 à 5 a déplacé des valeurs par défaut en silence, alors vérifiez plutôt que d'inférer.
- Rejouez un échantillon de trafic réel contre les deux ids et comparez les blocs
usage. - Recalculez votre dépense mensuelle à 4 $ et 20 $, et séparément à 5 $ pour les écritures de cache et 0,20 $ pour les lectures de cache.
- Confirmez les hits de cache dans
cache_read_input_tokensplutôt que de faire confiance à la stabilité du préfixe. - Augmentez vos délais d'attente de lecture HTTP et vérifiez les tampons de passerelle avant que quiconque ne règle
max_tokensprès de 128 000. - Enregistrez la latence p50 et p95 sur les deux ids avant de basculer.
- Décidez du mode rapide route par route, à x2 du tarif catalogue.
- Relancez votre propre ensemble d'évaluations. Les benchmarks du fournisseur sont la raison de tester, pas le test.
Opus 5.5 est une version moins chère, plus rapide et plus endurante d'un modèle que vous appelez déjà. Le risque de migration n'est pas que le changement de chaîne échoue. C'est que vous reportiez un modèle de coûts, un délai d'attente et une valeur de max_tokens qui étaient tous dimensionnés pour un autre modèle.
FAQ
claude-opus-5-5 est-il un remplacement direct de claude-opus-5 ? Ne le considérez comme tel qu'après avoir consulté le guide de migration d'Anthropic pour ce saut. Le changement d'id est une modification d'une ligne, mais le saut précédent sur cette ligne a déplacé des valeurs par défaut sans changer la forme des requêtes, alors la vérification est une assurance à peu de frais.
Combien Opus 5.5 est-il moins cher ? 20 % de moins par token dans les deux sens, de 5 $ à 4 $ en entrée et de 25 $ à 20 $ en sortie. Anthropic énonce séparément une réduction de 40 % du coût d'exploitation, ce qui implique des gains d'efficacité en tokens en plus de la baisse tarifaire. Mesurez votre propre charge de travail pour voir où vous vous situez entre les deux.
Combien coûte la mise en cache des prompts sur Opus 5.5 ? Les écritures sont à 5,00 $ par million de tokens et les lectures à 0,20 $ par million, contre 4,00 $ pour de l'entrée sans cache. Une seule réutilisation d'un préfixe mis en cache couvre largement la prime d'écriture.
La limite de sortie de 128 000 tokens change-t-elle quelque chose dans mon client ? Généralement oui. Vérifiez vos délais d'attente de lecture HTTP, la mise en tampon de votre passerelle, et si vous utilisez le streaming. Vérifiez aussi stop_reason avant d'analyser, car atteindre le plafond au milieu d'un objet produit du JSON invalide plutôt qu'un objet tronqué.