
Pour Claude Fable 5.2 vs Opus 5.5, commencez avec Opus 5.5 pour le codage quotidien et le travail sur les connaissances. Essayez Fable 5.2 lorsque le raisonnement complexe, les migrations ambiguës ou les projets d'agents de longue durée dépassent les capacités de votre référence Opus. Comparez les niveaux d'effort et le coût par résultat accepté avant de basculer l'intégralité de votre charge de travail.
Cette recommandation s'appuie sur l'annonce de Fable 5.2 par Anthropic, vérifiée le 10 novembre 2026. Il s'agit d'une comparaison fondée sur des sources ; nous n'avons pas réalisé de benchmark comparatif indépendant. Notre précédente comparaison entre Opus 5 et Fable 5 couvre la génération antérieure. Les tarifs, valeurs par défaut et éléments de preuve présentés ci-dessous s'appliquent à ces versions plus récentes.
Claude Fable 5.2 vs Opus 5.5 en un coup d'œil
| Critère de décision | Claude Fable 5.2 | Claude Opus 5.5 |
|---|---|---|
| Rôle initial | Raisonnement exigeant et travail d'agent de longue durée | Choix par défaut pour la plupart des charges de travail |
| Identifiant du modèle via l'API Claude | claude-fable-5-2 |
claude-opus-5-5 |
| Entrée standard, par million de tokens | 8 $ | 4 $ |
| Sortie standard, par million de tokens | 40 $ | 20 $ |
| Effort par défaut via l'API | Élevé | Moyen |
| Fenêtre de contexte | 1 M de tokens | 1 M de tokens |
| Sortie maximale | 128 K tokens | 128 K tokens |
| Étiquette de latence comparative | Modérée | Modérée |
Source : la vue d'ensemble actuelle des modèles Claude. Les deux modèles acceptent du texte et des images, produisent du texte, prennent en charge les outils et utilisent la pensée adaptative toujours active. Une fenêtre de contexte plus grande ne les distingue donc pas. C'est leur capacité à accomplir votre tâche spécifique qui fait la différence.
Les tarifs standard des tokens de Fable sont le double de ceux d'Opus. Cela fait d'Opus le point de départ logique lorsque les deux modèles satisfont vos critères d'acceptation à volume de tokens équivalent. Cela ne détermine pas lequel affiche la facture la plus basse lorsque la profondeur de raisonnement, les tentatives répétées et les appels d'outils diffèrent.
Quelles tâches de codage justifient de passer à Fable 5.2 ?
Utilisez Opus pour les modifications bornées avec des vérifications claires. Testez Fable lorsque l'agent doit découvrir le problème, coordonner plusieurs modifications interdépendantes ou se remettre d'une approche qui échoue. Ces recommandations de charge de travail sont déduites du positionnement et des résultats d'Anthropic, et non de garanties mesurées pour votre dépôt.
| Votre tâche | Choix de départ | Éléments justifiant une escalade |
|---|---|---|
| Ajouter un endpoint documenté | Opus 5.5 | Échecs répétés de contrat ou d'intégration |
| Mettre à jour les tests après un petit refactoring | Opus 5.5 | L'agent n'arrive pas à identifier l'invariant modifié |
| Déboguer une défaillance intermittente entre services | Opus, puis Fable | Opus applique des corrections répétées sans tester d'autres causes possibles |
| Migrer un service avec des dépendances mal définies | Comparer les deux | Fable réalise davantage de modifications acceptées dans le budget imparti |
| Coordonner un projet technique de longue durée | Essayer Fable | Une meilleure planification résiste à l'exécution et à la revue |
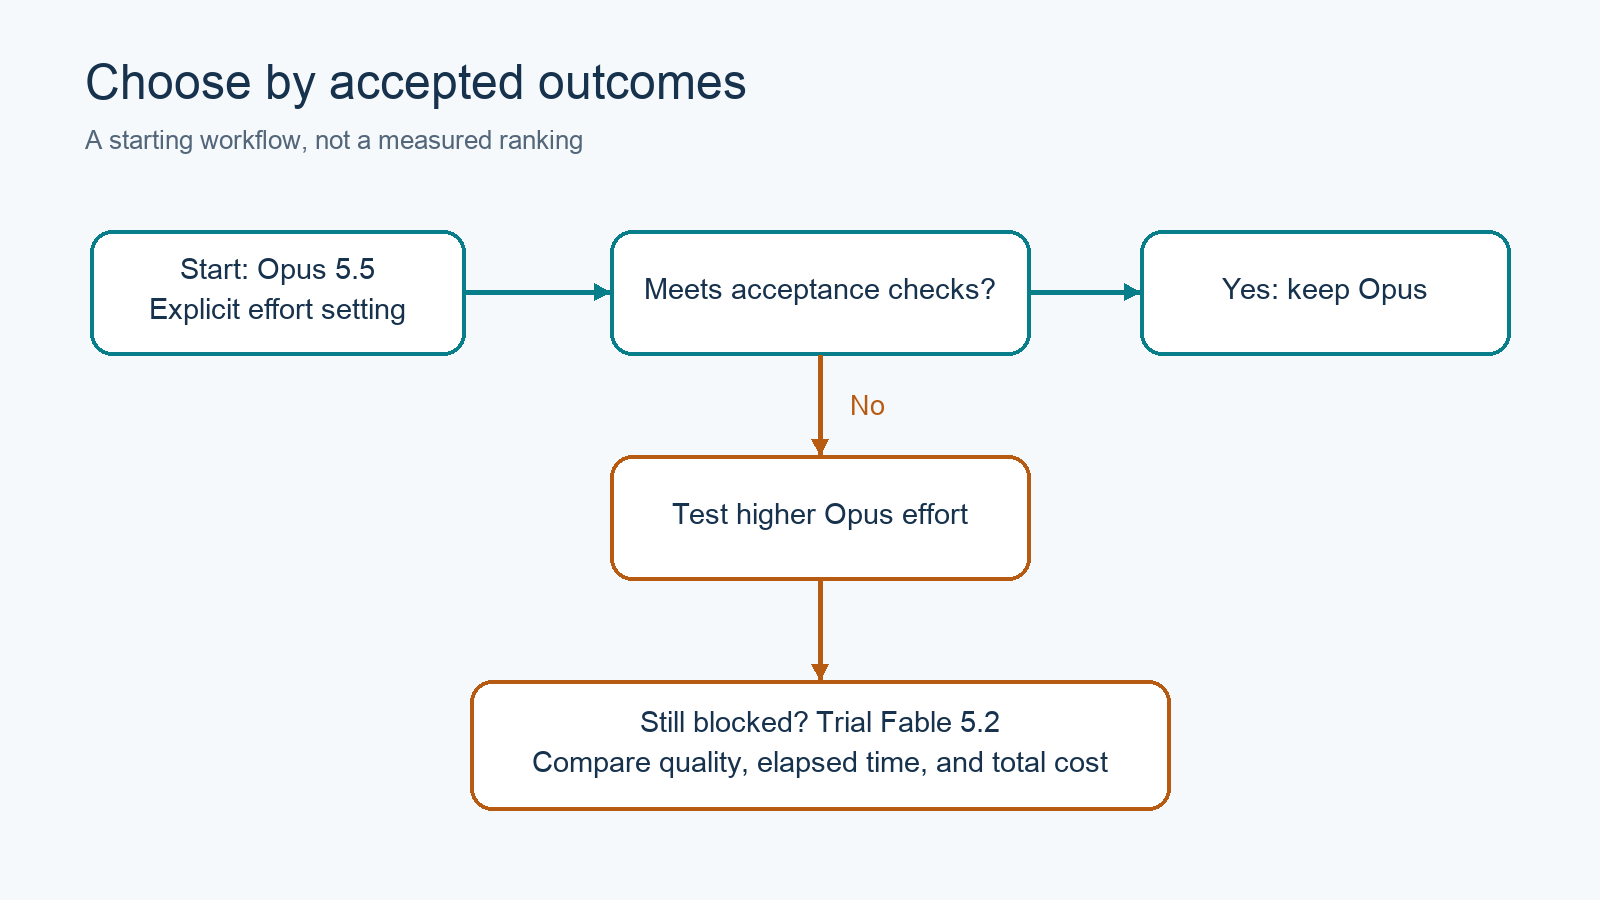
Escalade sélective : conservez les tâches routinières sur votre modèle de référence et confiez le travail difficile au modèle qui passe vos vérifications.
Prenons l'exemple d'un webhook de paiement qui traite par intermittère un événement en double. Si la correction requise est déjà spécifiée, Opus a affaire à une tâche de codage bornée. Si l'agent doit reconstituer la concurrence à travers les tentatives, le stockage et les services en aval, l'investigation est un bien meilleur candidat pour un essai avec Fable.
Donnez à l'un ou l'autre modèle les mêmes preuves d'incident et les mêmes contraintes. Un modèle plus cher ne peut compenser des journaux manquants, des dépendances inaccessibles ou un test d'acceptation qui récompense le mauvais comportement.
Que montrent les benchmarks d'Anthropic ?
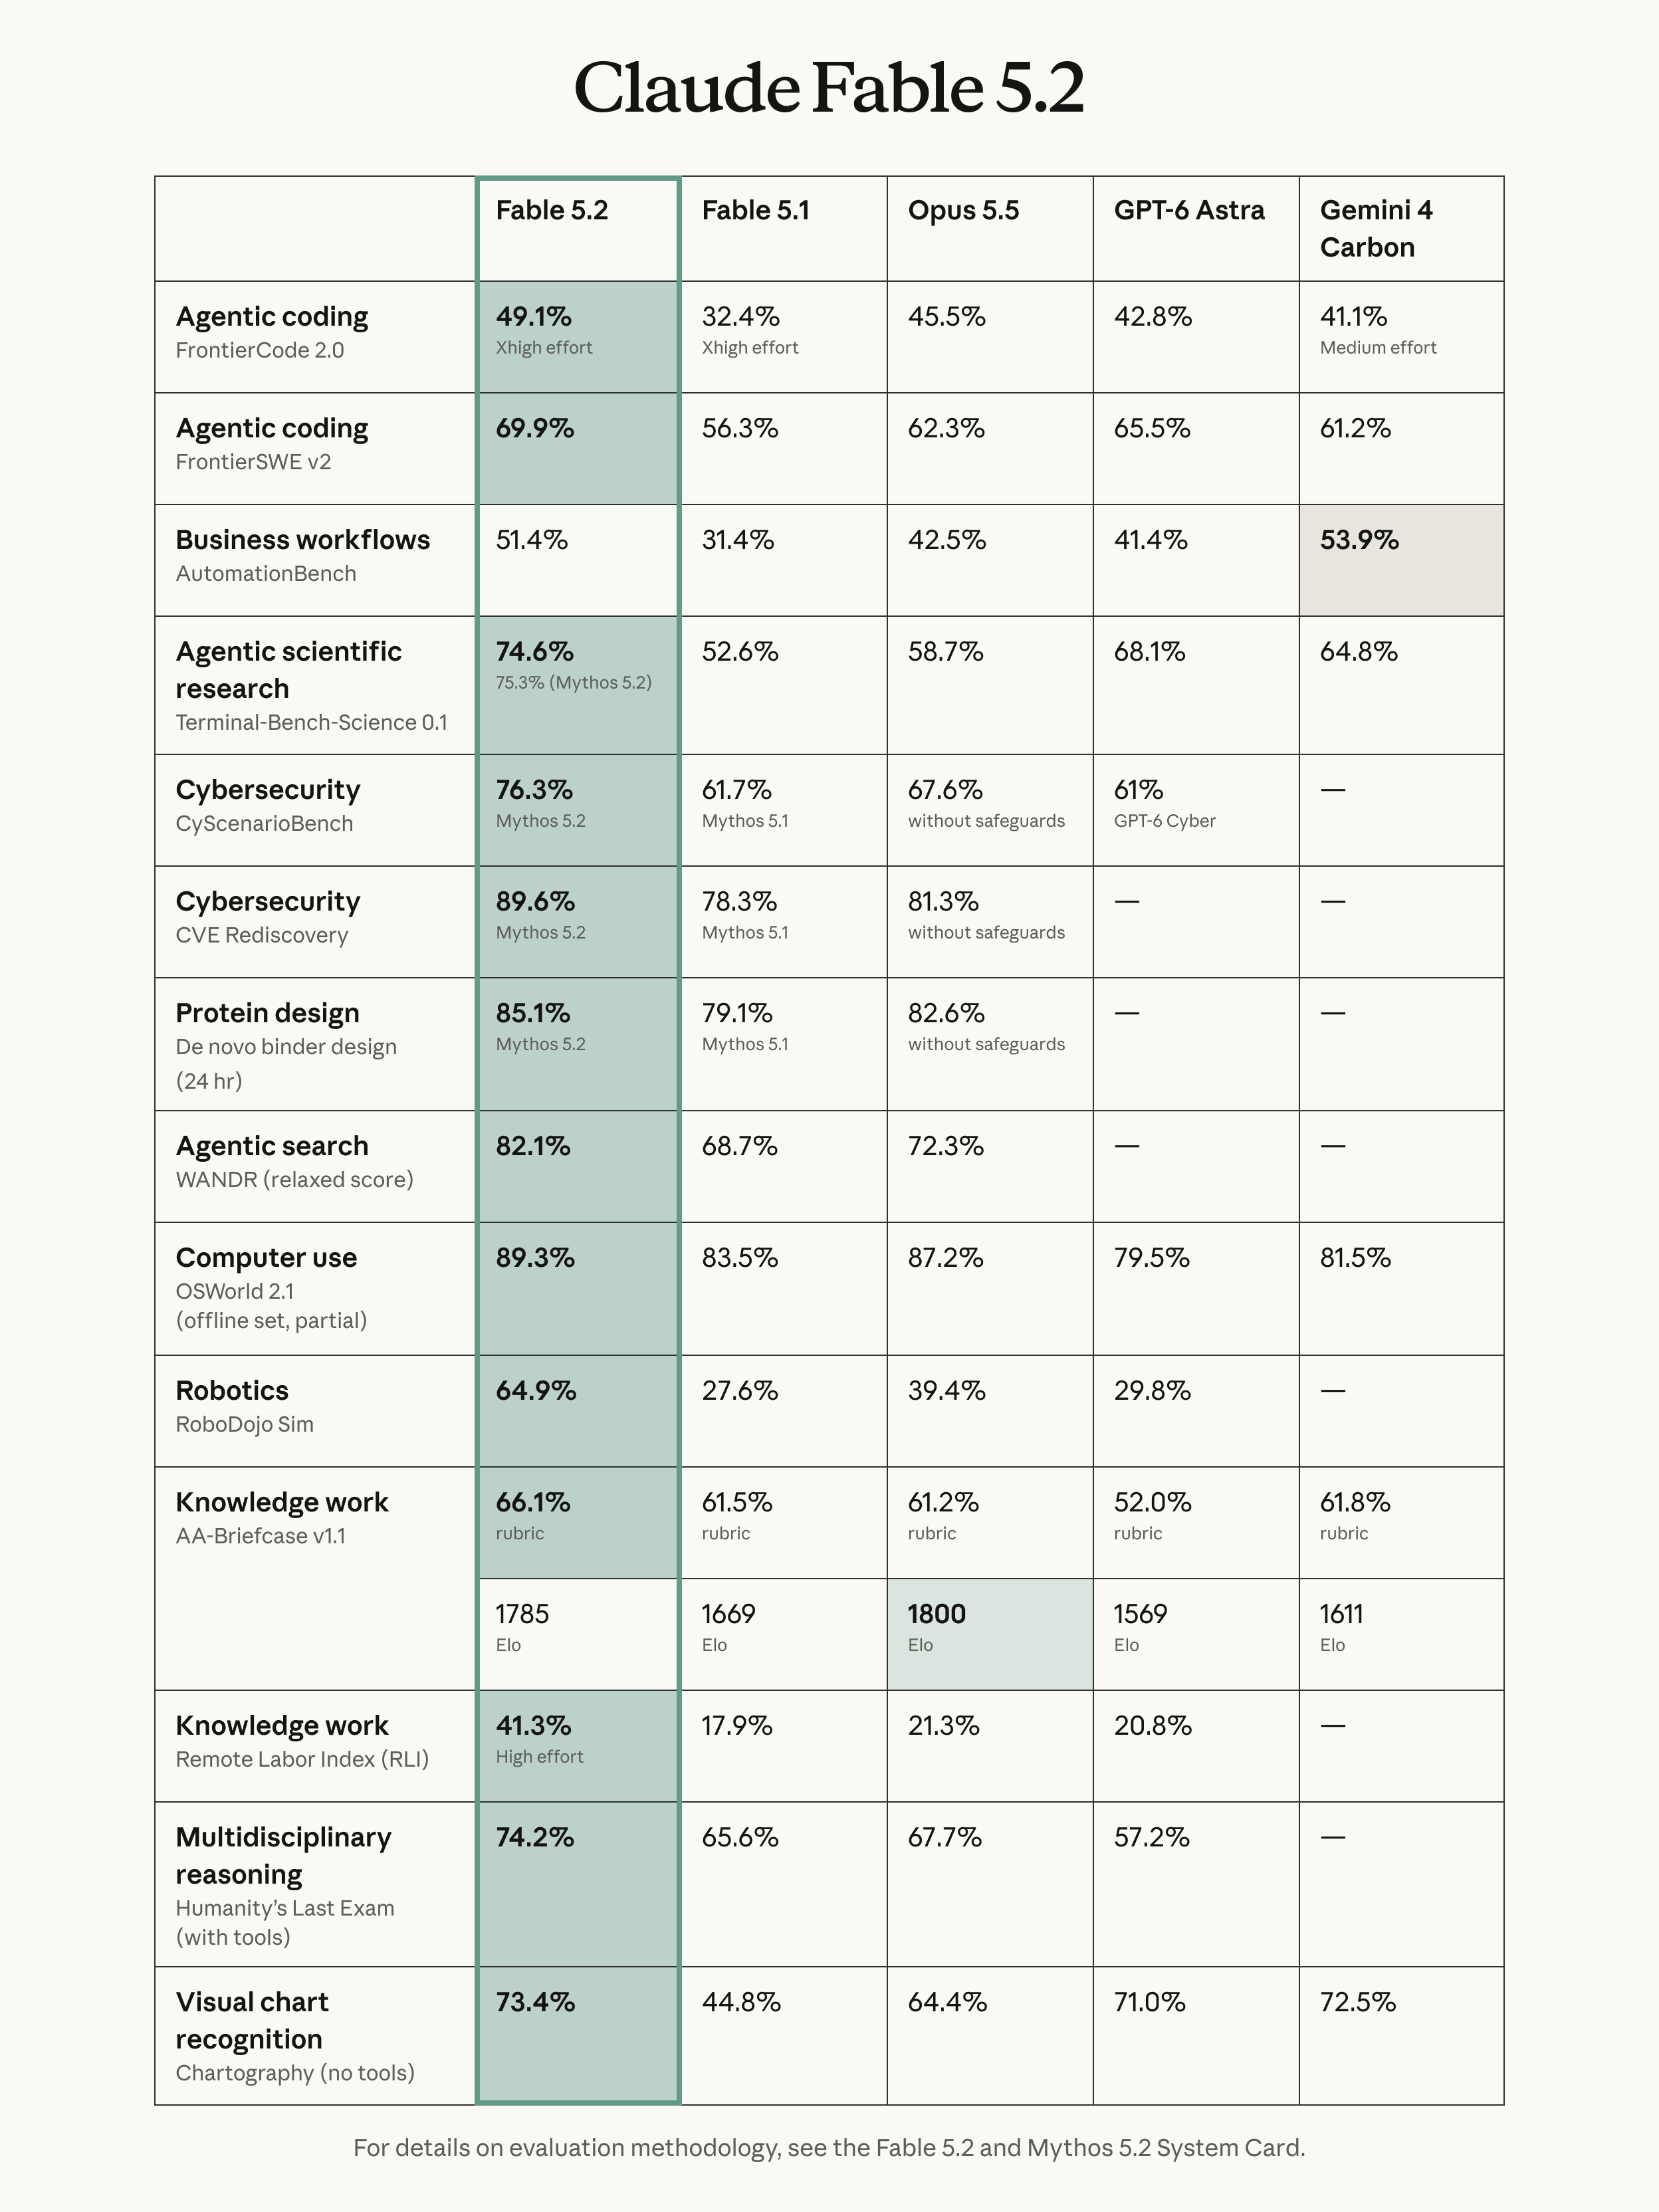
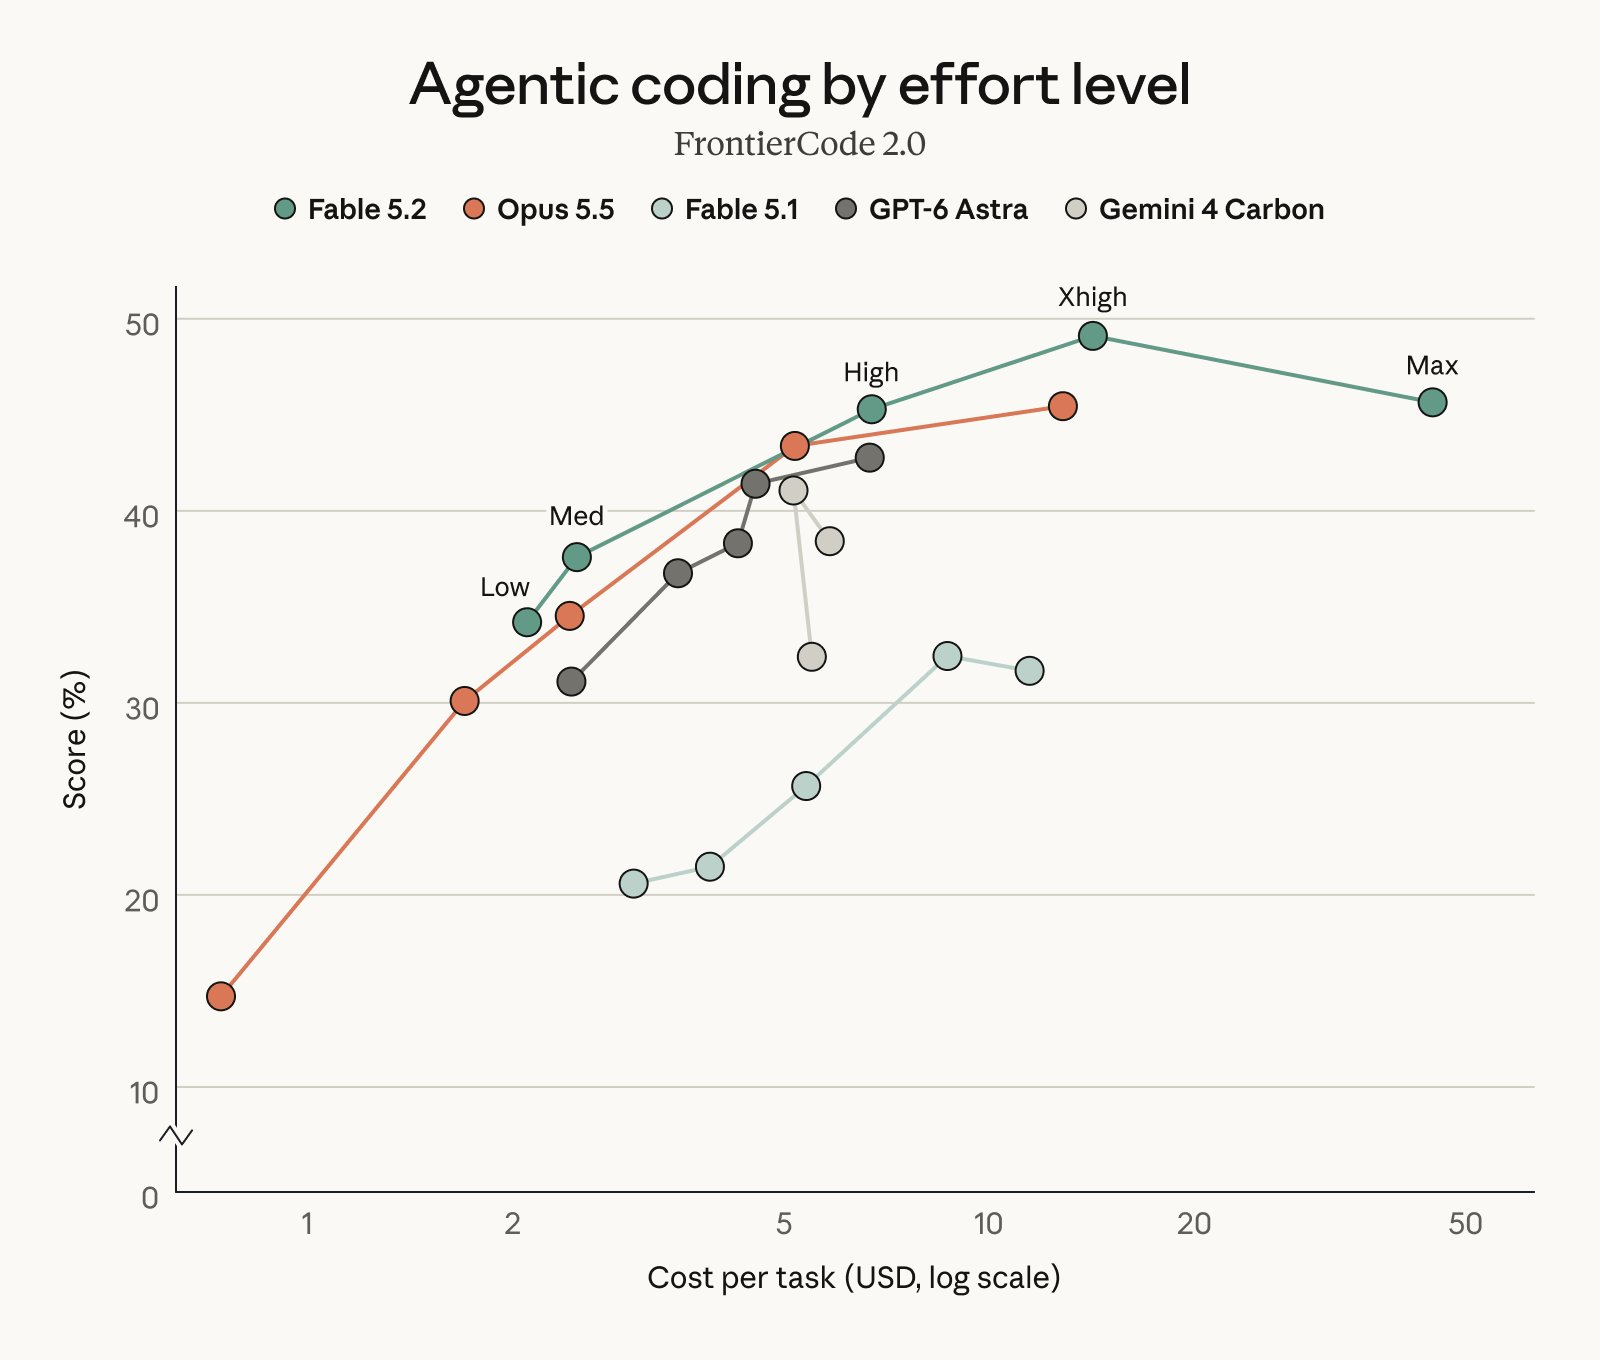
Anthropic fait état de scores supérieurs pour Fable 5.2 sur plusieurs évaluations de codage et de raisonnement. Le signal pratique le plus fort est son résultat effort-coût : Fable en mode Élevé frôle Opus en mode Max sur FrontierCode 2.0, à un coût par tâche environ deux fois moindre selon les premiers tests d'Anthropic.
| Évaluation rapportée par le fournisseur | Fable 5.2 | Opus 5.5 |
|---|---|---|
| FrontierCode 2.0, codage agentique | 49,1 % en Xhigh | 45,5 % |
| FrontierSWE v2, codage agentique | 69,9 % | 62,3 % |
| WANDR, recherche agentique, score relâché | 82,1 % | 72,3 % |
| OSWorld 2.1, ensemble hors ligne partiel | 89,3 % | 87,2 % |
Ces chiffres proviennent de l'annonce, qui précise que les scores utilisent le niveau d'effort le plus élevé disponible sauf indication contraire. Ils décrivent les conditions d'évaluation d'Anthropic, et non les réglages par défaut ni un taux de réussite attendu sur vos tickets.
La comparaison des coûts est encore plus restreinte. Fable en mode Élevé obtient 45,3 %, contre 45,5 % pour le meilleur score d'Opus. Cela justifie de tester la configuration la moins chère pour cette évaluation. Cela ne signifie pas que chaque flux de travail Fable coûte deux fois moins cher qu'Opus.
Évitez de transformer un pourcentage de benchmark en prévision de productivité. Un score de codage ne mesure pas votre file de revues, votre risque de déploiement ni le temps passé à réparer une migration incorrecte. Ne comptez pas non plus les résultats en cybersécurité et en biologie exclusifs à Mythos dans le tableau de scores de Fable : l'annonce identifie un modèle sous-jacent partagé, mais avec des protections et un accès différents.
Les niveaux d'effort changent la donne
Définissez explicitement le niveau d'effort lorsque vous comparez les modèles. Les valeurs par défaut de l'API sont Élevé pour Fable 5.2 et Moyen pour Opus 5.5. L'annonce d'Anthropic décrit par ailleurs Moyen comme valeur par défaut dans les applications Claude et Claude Code. Notez le produit et le réglage plutôt que de supposer qu'une même valeur par défaut s'applique partout.
La documentation sur l'effort définit low, medium, high, xhigh et max pour les deux modèles. L'effort influence le texte de la réponse, les arguments des outils et la réflexion. C'est un signal comportemental, pas un plafond de dépenses strict.
Commencez avec votre configuration Opus habituelle. Si elle s'avère insuffisante, comparez un effort Opus plus élevé avec Fable en mode Moyen ou Élevé. Réservez les essais en Xhigh et Max aux tâches où le raisonnement supplémentaire présente un bénéfice plausible et où vous pouvez tolérer la dépense.
Une comparaison à effort égal répond à une question : comment ces modèles se comportent-ils sous le même réglage nommé ? Une comparaison à coût équivalent en répond à une autre : quelle configuration produit le meilleur résultat acceptable pour votre budget ? L'une ne remplace pas l'autre.
Latence : mesurez la tâche complète
Les deux modèles portent une étiquette de latence comparative « Modérée » dans la vue d'ensemble d'Anthropic. Cette étiquette ne désigne pas de vainqueur universel. Mesurez le temps nécessaire pour obtenir un résultat relu, outils et tentatives inclus, plutôt que de considérer la vitesse de génération comme la vitesse de l'ensemble de votre flux de développement.
Anthropic indique que Fable 5.2 génère le rendu jusqu'à 30 % plus vite que Fable 5.1. Cette comparaison concerne son prédécesseur, et non Opus 5.5. Son mode rapide optionnel offre une vitesse de génération de tokens jusqu'à 2,5 fois supérieure — là encore, une affirmation du fournisseur plutôt qu'une réduction mesurée de la durée de vos tâches.
Une tâche dominée par la compilation ou une base de données lente ne s'accélérera pas au même rythme qu'une génération de tokens plus rapide. À l'inverse, un agent qui évite deux approches infructueuses peut terminer plus tôt tout en générant des tokens plus lentement. Suivez ces aspects séparément avant de payer un supplément pour la vitesse.
Comparez le coût par résultat accepté
Utilisez la dépense totale du flux de travail divisée par les résultats acceptés comme indicateur de décision. Les prix des tokens déterminent le tarif, mais le volume de tokens, le cache, les tentatives échouées, les outils et la revue déterminent ce que vous achetez. Le calcul suivant est illustratif et ne mesure pas le comportement de l'un ou l'autre modèle.
Supposons qu'une requête consomme 100 000 tokens d'entrée non mis en cache et 10 000 tokens de sortie, avec un routage global standard et sans frais d'outils supplémentaires :
| Configuration | Coût d'entrée | Coût de sortie | Total |
|---|---|---|---|
| Opus 5.5 standard | 0,40 $ | 0,20 $ | 0,60 $ |
| Fable 5.2 standard | 0,80 $ | 0,40 $ | 1,20 $ |
| Opus 5.5 rapide | 0,80 $ | 0,40 $ | 1,20 $ |
| Fable 5.2 rapide | 1,60 $ | 0,80 $ | 2,40 $ |
Les tarifs ont été vérifiés auprès de la documentation tarifaire d'Anthropic le 10 novembre 2026. Les quotas d'abonnement sont distincts de ces tarifs API. Les fournisseurs de cloud, le cache, les options de résidence des données et d'autres fonctionnalités peuvent modifier la facture.
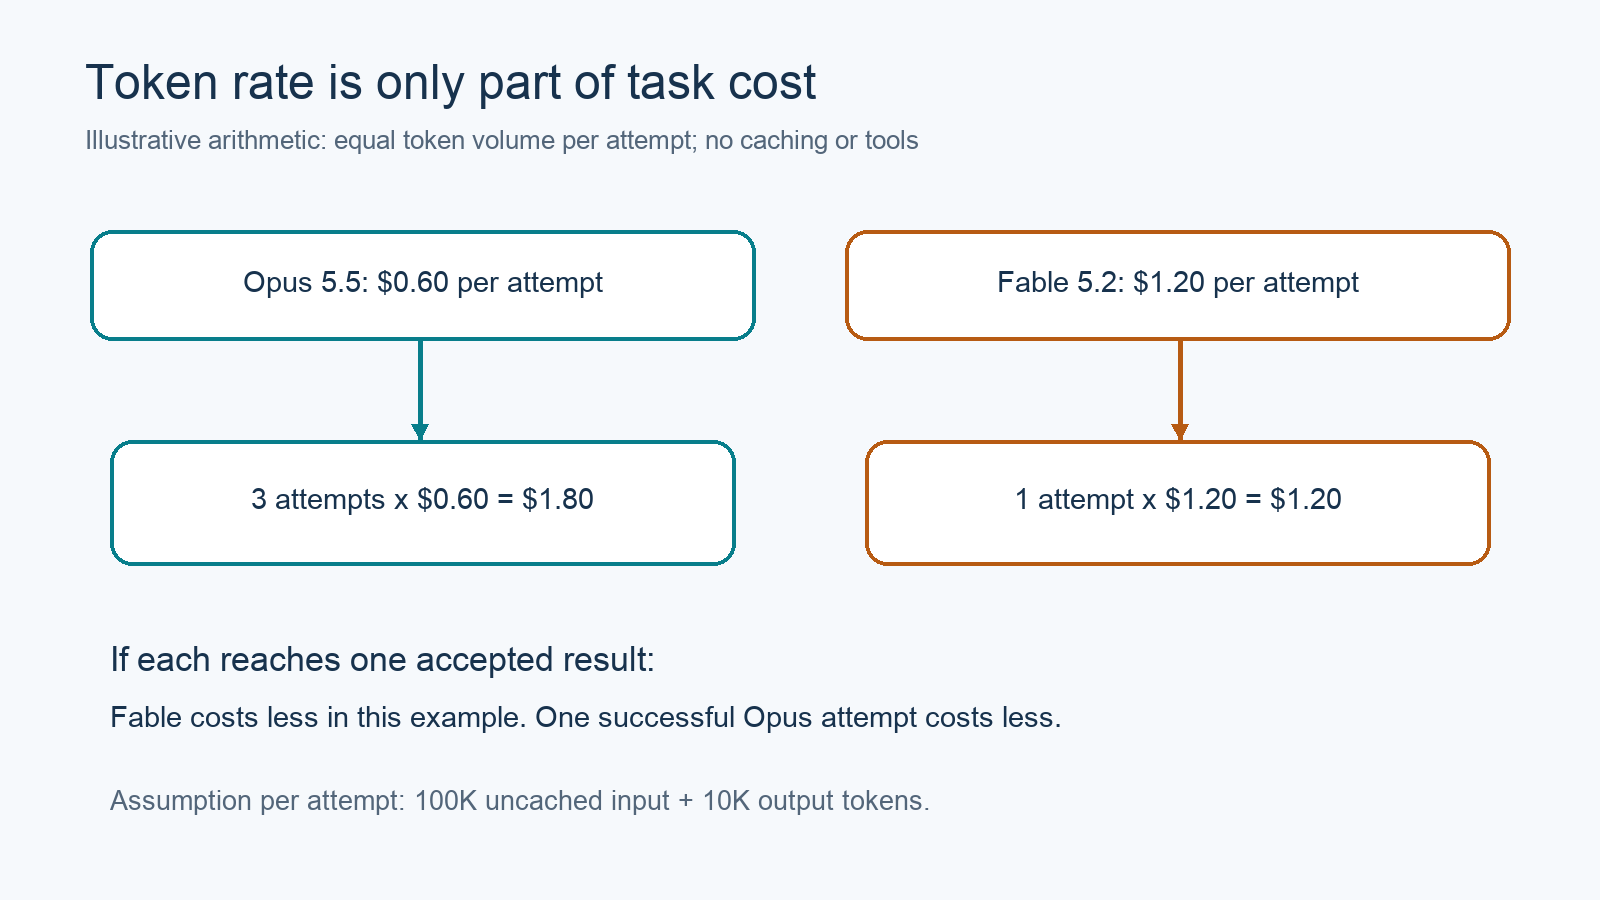
Comparez toutes les tentatives nécessaires pour obtenir un résultat réussi, tentatives répétées et revues comprises.
Dans cet exemple simplifié, trois tentatives Opus de volume identique coûtent 1,80 $ ; une tentative Fable coûte 1,20 $. Fable n'est donc moins cher que s'il atteint le résultat accepté en une seule tentative. Une seule tentative Opus réussie reste moins onéreuse. En réalité, les tentatives répétées consomment souvent des volumes différents ; utilisez donc l'usage enregistré plutôt que de multiplier une moyenne estimée.
Metenez le temps de revue technique au même niveau que la dépense API. Un correctif qui passe les tests mais nécessite une correction substantielle n'a pas franchi la même barre qu'un correctif prêt pour la revue.
Laissez votre agent de codage vérifier l'API avec Apidog CLI
Utilisez Apidog CLI pour que votre agent de codage crée et exécute des vérifications API reproductibles. Ces vérifications peuvent révéler des régressions de requêtes ou de réponses lorsque vous changez de modèle. Elles ne permettent pas de déterminer si les modifications apportées au dépôt par un agent sont correctes ; conservez les tests du dépôt et la revue humaine en complément.
Configurez la CLI, puis laissez votre agent consulter le guide d'installation officiel :
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_APIDOG_TOKEN>
Donnez ce prompt à Claude Code ou à l'agent de votre choix :
Read https://apidog.com/apidog-cli-installation-guide.md.
In project <PROJECT_ID>, create a test case for our Claude Messages
request. Compare claude-opus-5-5 and claude-fable-5-2 using the same
prompt and explicit medium effort. Keep API credentials in private
variables. Assert the expected status and response structure, record
usage and elapsed time, and summarize failures. Don't claim these
checks measure coding quality. Validate every write payload first.
L'agent vérifie le schéma, choisit une catégorie de cas de test valide, construit case.json, puis exécute des commandes telles que celles-ci. Les options ont été vérifiées à partir de l'aide de la CLI 2.2.12 installée :
apidog test-case category --project <PROJECT_ID>
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <PROJECT_ID> --file case.json
apidog run --test-case <CASE_ID> --project <PROJECT_ID> \
  -e <ENVIRONMENT_ID> -r cli,json
Remplacez les espaces réservés par les ressources de votre projet. Il s'agit d'un modèle de flux de travail, et non d'une comparaison de modèles exécutée. Suivez le guide Apidog CLI dans Claude Code ou le guide d'intégration Codex pour la configuration de l'agent.
FAQ
Fable 5.2 est-il meilleur qu'Opus 5.5 pour tout le codage ?
Non. Anthropic recommande Opus 5.5 pour la plupart des tâches de codage et de travail sur les connaissances. Fable mérite d'être testé lorsque le travail difficile dépasse cette référence. Ses scores de benchmark plus élevés rapportés par le fournisseur ne garantissent pas un meilleur résultat sur chaque tâche.
Fable 5.2 coûte-t-il deux fois plus cher ?
Ses tarifs standard de tokens d'entrée et de sortie sont le double de ceux d'Opus 5.5. Le coût total d'une tâche peut varier, car les configurations consomment des tokens différents et nécessitent des nombres de tentatives différents.
Faut-il toujours utiliser l'effort maximum ?
Non. Comparez les réglages à vos vérifications d'acceptation et à votre budget. Un effort plus élevé autorise plus de dépenses en tokens ; il ne garantit pas d'amélioration utile pour une tâche bornée.
Fable 5.2 est-il plus rapide qu'Opus 5.5 ?
Les sources examinées ici n'établissent pas de vainqueur universel en termes de latence comparée. Les deux modèles portent une étiquette de latence « Modérée ». Mesurez votre flux de travail réel et considérez le mode rapide comme une configuration distincte.
Apidog peut-il déterminer quel modèle écrit un meilleur code ?
Apidog CLI peut aider votre agent à exécuter des vérifications API et à collecter des preuves de réponses. La qualité du code nécessite toujours des tests du dépôt et une revue. Utilisez ces résultats acceptés pour décider quel modèle et quel niveau d'effort justifient leur coût.