Claude Fable 5.1 coûte 10 $ et 50 $ par million de jetons. Claude Opus 5 coûte 5 $ et 25 $. Les propres documents d'Anthropic vous disent de commencer avec Opus 5 et de ne passer à Fable 5.1 que "si vos évaluations sur Claude Opus 5 à un niveau d'effort plus élevé restent insuffisantes". C'est une règle testable, et cette comparaison est construite autour d'elle : là où les chiffres d'Anthropic montrent Fable 5.1 devançant clairement Opus 5, là où ils montrent quelques points que l'ajustement de l'invite pourrait combler, et là où le calcul des prix devient intéressant car les lectures de cache de Fable 5.1 sont la moitié de celles d'Opus 5.
bouton
Les sources sont le billet de lancement d'Anthropic, la page du modèle Fable 5.1 et la page des tarifs. Pour un aperçu de chaque modèle, consultez ce qu'est Claude Fable 5.1 et ce qu'est Claude Opus 5.
Comparaison côte à côte
| Claude Fable 5.1 | Claude Opus 5 | |
|---|---|---|
| ID du modèle | claude-fable-5-1 |
claude-opus-5 |
| Lancé le | 1er septembre 2026 | 24 juillet 2026 |
| Positionnement | Raisonnement exigeant et travail d'agent à long terme | Codage agentique complexe et travail d'entreprise ; le défaut recommandé |
| Entrée / sortie | 10 $ / 50 $ | 5 $ / 25 $ |
| Lecture du cache | 0,25 $ | 0,50 $ |
| Écriture du cache (5m / 1h) | 12,50 $ / 20 $ | 6,25 $ / 10 $ |
| Lot | 5 $ / 25 $ | 2,50 $ / 12,50 $ |
| Mode rapide | Non | Oui (10 $ / 50 $) |
| Niveau de priorité | Non | Non |
| Contexte / sortie max. | 1M / 128K | 1M / 128K (300K en lot avec bêta) |
| Date limite de connaissance | Juin 2026 | Mai 2026 |
| Latence comparative | Plus lent | Modérée |
| Réflexion | Toujours activée ; disabled renvoie 400 |
Activée par défaut ; disabled autorisé à high ou moins |
tool_choice forcé |
400 | Accepté |
| Classifieurs de sécurité | cyber, bio, frontier_llm, reasoning_extraction, general_harms | cyber uniquement |
| Rétention de données zéro | Non disponible sauf autorisation | Disponible |
| Effort par message (bêta) | Oui | Oui |
| Vérification de l'édition d'historique | Oui | Non |
Ce que disent les benchmarks
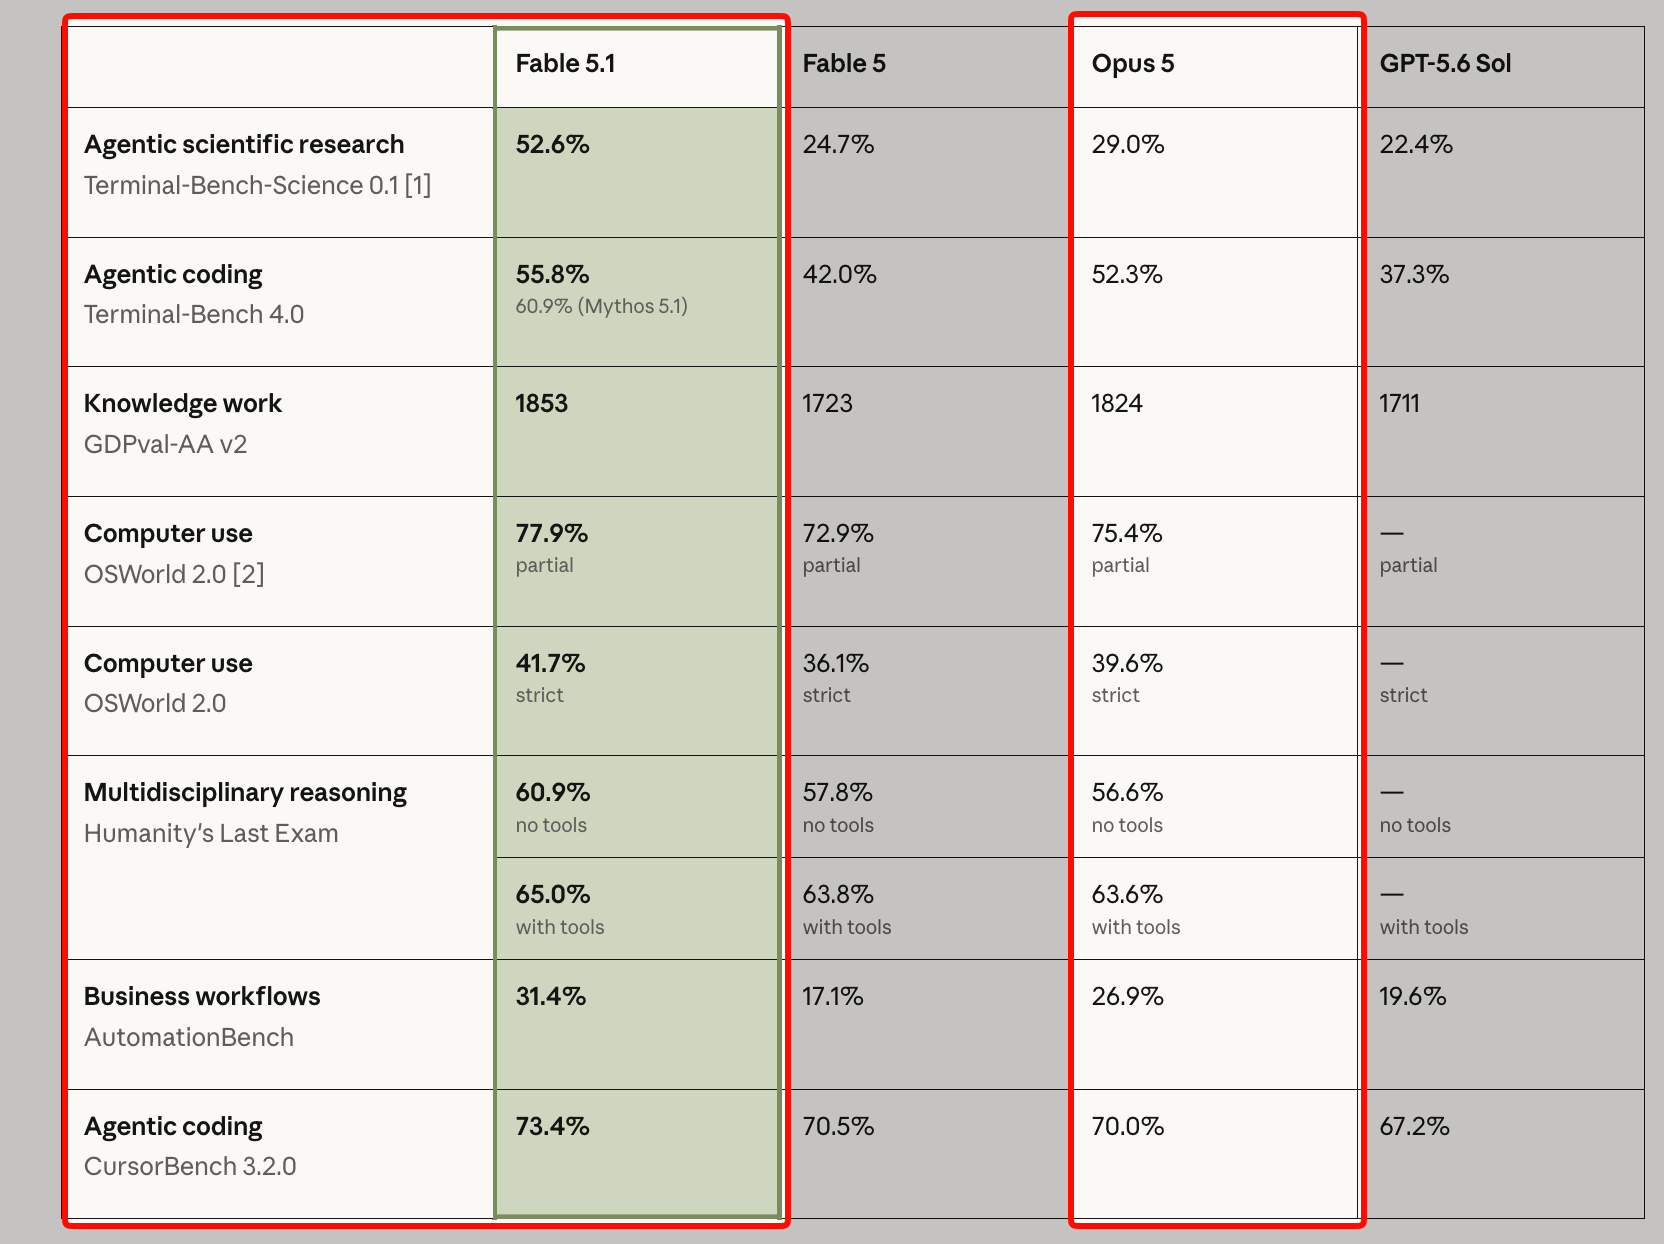
Tous les chiffres sont ceux d'Anthropic, exécutés par Anthropic, sans reproduction indépendante à ce jour.
| Benchmark | Fable 5.1 | Opus 5 | Écart |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52,6% | 29,0% | +23,6 |
| AutomationBench | 31,4% | 26,9% | +4,5 |
| Examen final de l'Humanité (sans outils) | 60,9% | 56,6% | +4,3 |
| Terminal-Bench 4.0 | 55,8% | 52,3% | +3,5 |
| CursorBench 3.2.0 | 73,4% | 70,0% | +3,4 |
| OSWorld 2.0 (partiel) | 77,9% | 75,4% | +2,5 |
| OSWorld 2.0 (strict) | 41,7% | 39,6% | +2,1 |
| Examen final de l'Humanité (avec outils) | 65,0% | 63,6% | +1,4 |
| GDPval-AA v2 | 1853 | 1824 | +29 Elo |
Lisez ce tableau comme deux histoires. Sur Terminal-Bench-Science, Fable 5.1 double presque Opus 5, et il s'agit d'un benchmark de recherche à long terme, lourd en outils, où le modèle exécute des expériences dans un terminal pendant une longue période. Sur tout le reste, l'écart est entre un et cinq points. Un écart de cinq points sur AutomationBench est significatif. Un écart de 1,4 point sur l'Examen final de l'Humanité avec des outils, ou 29 Elo sur GDPval, est dans la fourchette où votre invite et votre paramètre d'effort modifient davantage le résultat que le choix du modèle.
L'autre donnée à retenir : Opus 5 a été lancé en juillet à 52,3% sur Terminal-Bench 4.0, devant les 42,0% de Fable 5. Fable 5.1 a repris la tête à 55,8%, mais de 3,5 points, pas de 13,8. L'avantage du niveau Fable sur le niveau Opus en matière de codage agentique est réel et plus étroit qu'il ne l'était en juin. La comparaison Opus 5 vs Fable 5 a capturé l'état antérieur de cette course.
Le calcul des prix n'est pas simplement un doublement
Sans cache, Fable 5.1 est exactement le double d'Opus 5 sur chaque ligne. Mais les lectures de cache s'inversent : 0,25 $ sur Fable 5.1 contre 0,50 $ sur Opus 5. Le multiplicateur effectif dépend donc de la quantité de votre entrée qui est un préfixe mis en cache.
Prenons un tour d'agent avec 150 000 jetons mis en cache, 1 000 jetons d'entrée non mis en cache et 800 jetons de sortie. Opus 5 : 5(0.001) + 0.5(0.15) + 25(0.0008) = 0,005 $ + 0,075 $ + 0,02 $ = 0,10 $. Fable 5.1 : 10(0.001) + 0.25(0.15) + 50(0.0008) = 0,01 $ + 0,0375 $ + 0,04 $ = 0,0875 $. Sur ce tour, Fable 5.1 est moins cher.
Maintenant, prenons une révision de code avec 30 000 jetons d'entrée non mis en cache et 4 000 jetons de sortie. Opus 5 : 0,15 $ + 0,10 $ = 0,25 $. Fable 5.1 : 0,30 $ + 0,20 $ = 0,50 $. Exactement le double.
Le point de croisement : le coût par tour de Fable 5.1 est inférieur à celui d'Opus 5 lorsque les jetons d'entrée mis en cache dépassent environ 20 fois la somme des jetons d'entrée non mis en cache et 5 fois les jetons de sortie. Pour les boucles d'agent très préfixées, cette condition est courante. Pour tout ce qui est lourd en sortie, cela n'arrive jamais. Les écritures de cache sont également doublées sur Fable 5.1, donc une session qui réinitialise souvent son cache perd l'avantage. La répartition des prix de Fable 5.1 et la répartition des prix d'Opus 5 contiennent les tableaux complets.
Où Opus 5 l'emporte haut la main
Tout ce que vous pouvez exécuter avec la réflexion désactivée. Opus 5 accepte thinking: {"type": "disabled"} à un effort high ou inférieur. Fable 5.1 ne le fait jamais. Pour la classification, l'extraction et les réponses courtes, Opus 5 avec la réflexion désactivée (ou à un effort low) est à la fois moins cher et plus rapide.
Mode rapide. Opus 5 dispose d'un mode rapide en prévisualisation de recherche à une vitesse de sortie jusqu'à 2,5x pour 10 $ et 50 $. Fable 5.1 n'a pas d'équivalent. Si le temps de réponse est plus important que les quelques derniers points de benchmark, c'est décisif.
Latence en général. Anthropic répertorie Fable 5.1 comme "plus lent" et Opus 5 comme "modéré". Des tours uniques de Fable 5.1 sur des tâches difficiles à un effort élevé peuvent prendre plusieurs minutes.
Rétention de données zéro. Opus 5 est disponible sous ZDR. Fable 5.1 est un modèle couvert et renvoie une erreur 400 sauf si Anthropic autorise expressément l'accès ZDR.
Moins de refus. Opus 5 exécute uniquement des classifieurs de cybersécurité. Fable 5.1 exécute l'ensemble complet de Fable : cyber, bio, développement de LLM de pointe, extraction de raisonnement et nuisances générales. Une charge de travail bénigne en sciences de la vie ou en ML qui ne déclenche jamais Opus 5 peut déclencher Fable 5.1, et lorsque c'est le cas, la cible de repli est de toute façon Opus 5.
Utilisation forcée d'outils. Opus 5 accepte toujours tool_choice any et tool. Fable 5.1 renvoie une erreur 400. Si votre intégration repose sur des appels forcés, Opus 5 vous épargne la réécriture.
Pas de vérification d'édition d'historique. Opus 5 ne se soucie pas si vous modifiez des tours précédents. Fable 5.1 invalide les blocs de réflexion ultérieurs lorsque vous le faites. Un harnais qui compacte côté client ou injecte des rappels par tour fonctionne sur Opus 5 aujourd'hui et nécessite un audit avant Fable 5.1.
Où Fable 5.1 l'emporte haut la main
Recherche à long terme et agents de terminal. Le résultat de 52,6% contre 29,0% sur Terminal-Bench-Science est le plus grand écart unique dans le tableau d'Anthropic. Si vos agents exécutent des expériences, poursuivent des recherches web en plusieurs étapes ou opèrent pendant des heures, c'est pour cette charge de travail que le modèle a été conçu.
Automatisation des flux de travail métier. 31,4% contre 26,9% sur AutomationBench est un véritable écart sur un benchmark qui modélise des tâches de bout en bout à travers les applications.
Agents lourds en préfixe mis en cache. Couvert ci-dessus : la lecture de cache à 0,25 $ rend Fable 5.1 moins cher par tour sur les boucles dominées par les préfixes.
Date limite de connaissance. Juin 2026 contre mai 2026. Un mois, mais c'est le plus récent de tous les modèles Claude.
Vision sur documents denses. Anthropic cite l'amélioration de la lecture des graphiques, des dossiers et des tableaux imbriqués dans les PDF, en particulier avec les outils de recadrage et de zoom, comme un domaine de gain pour Fable 5.1. Opus 5 n'est pas comparé sur un benchmark de vision publié, il faut donc traiter cela comme une affirmation à tester.
Quand Opus 5 à xhigh échoue. C'est la règle d'Anthropic, et c'est la bonne. Si une tâche échoue à votre évaluation sur Opus 5 à xhigh, essayez Fable 5.1 à high avant d'essayer quoi que ce soit d'autre.
L'effort modifie la comparaison
Les deux modèles exposent cinq niveaux d'effort, et Anthropic fait une affirmation spécifique concernant Fable 5.1 à l'extrémité inférieure : à un effort low, il est "souvent compétitif avec les modèles Claude Opus et Claude Sonnet en termes de coût par tâche tout en obtenant des scores plus élevés". Cela recadre le choix. Au lieu d'Opus 5 à high contre Fable 5.1 à high, la comparaison équitable pour le travail de routine pourrait être Opus 5 à high contre Fable 5.1 à low ou medium. Le nombre de jetons de sortie à un effort inférieur est plus petit, ce qui compense le prix 2x par jeton.
L'inverse est également vrai. Les gains de Fable 5.1 sur Fable 5 sont les plus importants à xhigh et max, ce qui signifie que le plafond de capacité au-dessus d'Opus 5 est le plus élevé aux niveaux d'effort qui coûtent également le plus de temps. Balayez les deux modèles sur l'effort dans vos propres évaluations avant de conclure quoi que ce soit des tableaux de lancement. Le guide d'effort d'Opus 5 couvre les cinq niveaux ; la sémantique est la même sur Fable 5.1.
Un cadre de décision
- Commencez sur Opus 5 à
high. La recommandation par défaut d'Anthropic, moitié prix, moins de classifieurs, ZDR disponible. - Augmentez Opus 5 à
xhighpour les tâches qui échouent. Moins cher que de changer de modèle. - Déplacez les tâches qui échouent toujours vers Fable 5.1 à
high. Par route, pas globalement. Gardez Opus 5 sur tout ce qui passe. - Vérifiez le profil de cache de ce que vous avez déplacé. S'il s'agit d'une boucle lourde en préfixe, Fable 5.1 pourrait s'avérer moins cher par tour qu'Opus 5.
- Auditez le harnais avant l'étape 3. Les
tool_choiceforcés et les éditions d'historique échouent sur Fable 5.1. Le guide de migration contient la liste de contrôle.
Exécution de la comparaison dans Apidog
Construisez une collection avec vos invites de production et model comme variable d'environnement. Exécutez-la contre claude-opus-5 à high, puis à nouveau à xhigh, puis contre claude-fable-5-1 à high et low. Pour chaque exécution, enregistrez la réponse, usage.output_tokens et usage.cache_read_input_tokens lors d'un envoi répété. Multipliez par les taux de chaque modèle dans un script post-réponse et vous obtenez le coût par tâche par modèle par effort dans un tableau. Apidog conserve chaque exécution sous forme d'historique, de sorte que la comparaison survit au prochain lancement de modèle. Téléchargez Apidog pour le configurer.
FAQ
Claude Fable 5.1 est-il meilleur qu'Opus 5 ? Sur chaque benchmark publié par Anthropic, oui, avec des marges allant de 1,4 points à 23,6 points. Le grand écart se situe sur Terminal-Bench-Science ; la plupart des autres sont inférieurs à cinq points. Ce sont des résultats fournis par le fournisseur.
Fable 5.1 vaut-il le double du prix d'Opus 5 ? Pour la recherche à long terme et les agents de terminal, l'automatisation des processus métier, et les boucles d'agents à préfixes lourds (où des lectures de cache moins chères peuvent le rendre moins coûteux par tour), souvent oui. Pour les travaux à forte production, sensibles à la latence ou de classification, non. La propre règle d'Anthropic : ne passer au niveau supérieur que si Opus 5 à un effort plus élevé échoue à vos évaluations.
Lequel est le plus rapide, Fable 5.1 ou Opus 5 ? Opus 5. Anthropic le classe comme ayant une latence "modérée" contre "plus lente" pour Fable 5.1, et Opus 5 dispose d'un mode rapide jusqu'à 2,5x la vitesse de sortie. Fable 5.1 n'en a pas.
Opus 5 a-t-il les mêmes classifieurs de sécurité que Fable 5.1 ? Non. Opus 5 exécute uniquement des classifieurs cyber. Fable 5.1 ajoute la bio, le LLM de pointe, l'extraction de raisonnement et les nuisances générales. Lorsque Fable 5.1 refuse, Opus 5 est l'une des deux cibles de repli autorisées.
Puis-je utiliser Fable 5.1 avec une rétention de données zéro comme Opus 5 ? Non. Fable 5.1 nécessite une rétention de 30 jours et est un modèle couvert. Opus 5 est disponible sous ZDR.
Une conversation peut-elle passer d'Opus 5 à Fable 5.1 ? Vers le haut, oui : Fable 5.1 lit les blocs de réflexion d'Opus 5. Vers le bas, l'API supprime les blocs de réflexion de Fable 5.1 avant qu'Opus 5 ne les voie, sans facturation, et Opus 5 replanifie ce tour.