
Réponse rapide : La Claude Batch API traite les requêtes de la Messages API de manière asynchrone avec une réduction de 50 % sur les tokens d'entrée et de sortie. Vous soumettez jusqu'à 100 000 requêtes (ou 256 Mo) en un seul appel, interrogez le service jusqu'à la fin du lot, puis lisez les résultats indexés par votre propre custom_id. La plupart des lots se terminent en moins d'une heure, et le plafond absolu est de 24 heures.
Vous avez 40 000 tickets de support à classer, ou un catalogue produit à réécrire, ou un mois de transcriptions à résumer. Rien de tout cela n'est urgent. Chacun de ces appels est toujours facturé au plein tarif lorsque vous les lancez un par un, et vous passez l'après-midi à surveiller les réessais contre votre limite de débit.
La Claude Batch API existe exactement pour ce type de travail. Vous remettez à Anthropic une liste de requêtes, vous partez, et vous revenez à un fichier de résultats qui a coûté la moitié de ce que les mêmes appels auraient coûté en synchrone. Aucune file d'attente à gérer, aucun réglage de concurrence, aucune logique de backoff.
Ce guide couvre ce que fait le point de terminaison batch, ce qu'il coûte, comment soumettre et collecter une tâche, et comment laisser votre agent de codage tout tester avec Apidog CLI avant de le pointer vers des données réelles.
Qu'est-ce que la Claude Batch API ?
La Claude Batch API est un point de terminaison asynchrone à /v1/messages/batches qui accepte de nombreuses requêtes de la Messages API en une seule soumission et renvoie leurs résultats une fois le traitement terminé. Elle échange de la latence contre une réduction de 50 %. Anthropic la documente sous batch processing.
Les contraintes à prendre en compte lors de la conception :
- Taille : jusqu'à 100 000 requêtes ou 256 Mo par lot, selon ce qui est atteint en premier.
- Délai : la plupart des lots se terminent en moins d'une heure ; 24 heures est le maximum avant que les requêtes inachevées expirent.
- Rétention : les résultats restent disponibles pendant 29 jours après la création du lot.
- Parité de fonctionnalités : la vision, l'utilisation d'outils, les invites système et la mise en cache des invites fonctionnent tous dans un lot.
- Ordre : les résultats reviennent dans n'importe quel ordre, vous les indexez donc par
custom_idet jamais par position.
C'est ce dernier point qui pose problème aux gens. Un lot est un sac, pas une file d'attente.
Combien coûte la Claude Batch API
La réduction est de 50 % à plat sur les tokens d'entrée et de sortie, appliquée au modèle nommé par chaque requête. Vous pouvez mélanger des modèles dans un même lot, de sorte qu'un classificateur bon marché et un résumeur coûteux peuvent voyager ensemble.
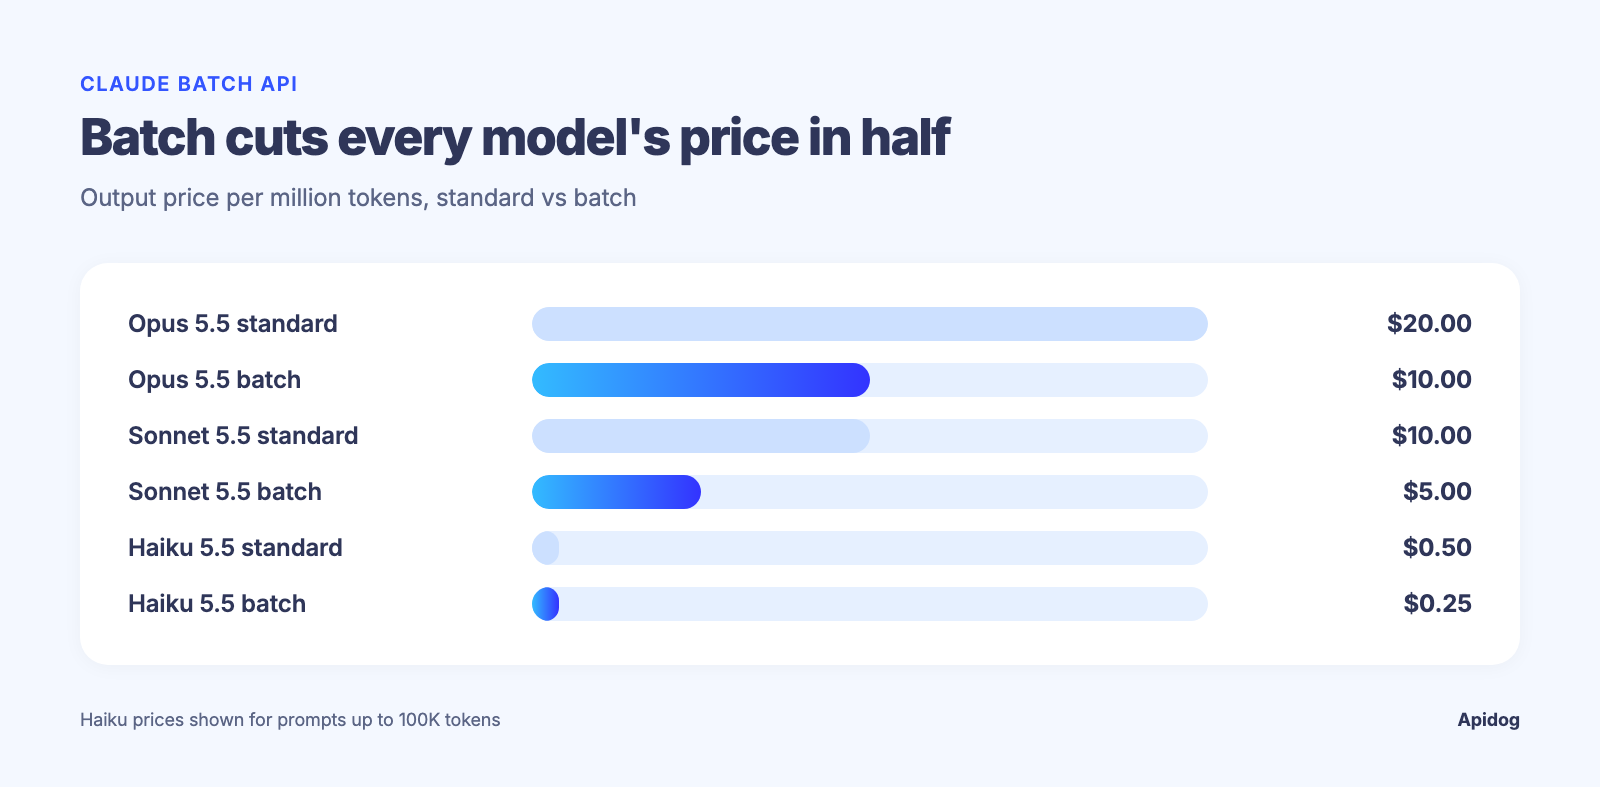
| Modèle | Entrée / sortie standard par MTok | Entrée / sortie batch par MTok |
|---|---|---|
| Claude Opus 5.5 | $4.00 / $20.00 | $2.00 / $10.00 |
| Claude Sonnet 5.5 | $2.00 / $10.00 | $1.00 / $5.00 |
| Claude Haiku 5.5 (invites jusqu'à 100K) | $0.10 / $0.50 | $0.05 / $0.25 |
| Claude Haiku 5.5 (invites de plus de 100K) | $0.50 / $2.50 | $0.25 / $1.25 |
Lisez attentivement les lignes Haiku. Haiku 5.5 facture selon la taille de l'invite, donc une invite dépassant 100 000 tokens est facturée 5 fois le tarif des invites courtes, réduction batch ou non. Prévoyez le travail Haiku à long contexte à 0,25 $ / 1,25 $, et non à 0,05 $ / 0,25 $. Consultez la page de tarification d'Anthropic avant de construire une prévision sur ces chiffres, et lisez notre analyse de où va les dépenses de la Claude API si la facture est la raison de votre présence ici.
La tarification batch se cumule également avec la mise en cache des invites, et c'est là que se trouvent les véritables économies. Plus d'informations ci-dessous.
Soumettez votre premier lot
Installez le SDK Python officiel et construisez une liste de requêtes. Chacune porte un custom_id que vous choisissez et un objet params qui ressemble exactement à un appel normal à messages.create().
import anthropic
from anthropic.types.message_create_params import MessageCreateParamsNonStreaming
from anthropic.types.messages.batch_create_params import Request

client = anthropic.Anthropic()

tickets = [
    "Card declined three times, support chat timed out.",
    "Love the new dashboard, the export button is hidden though.",
    "Webhook stopped firing after the 2.4 upgrade.",
]

batch = client.messages.batches.create(
    requests=[
        Request(
            custom_id=f"ticket-{i}",
            params=MessageCreateParamsNonStreaming(
                model="claude-haiku-5-5",
                max_tokens=1024,
                output_config={"effort": "low"},
                messages=[{
                    "role": "user",
                    "content": f"Label this ticket billing, bug, or praise. One word.\n\n{text}",
                }],
            ),
        )
        for i, text in enumerate(tickets)
    ]
)

print(batch.id, batch.processing_status)
Faites en sorte que custom_id ait du sens. Une clé primaire de base de données ou un chemin de fichier vous évite une jointure plus tard, et c'est la seule chose qui relie un résultat à son entrée.
Si vous préférez le HTTP brut, la même charge utile est envoyée à POST https://api.anthropic.com/v1/messages/batches avec vos en-têtes x-api-key et anthropic-version. La référence de création d'un lot de messages contient le schéma complet.
Interrogez le lot et collectez les résultats
Récupérez le lot jusqu'à ce que processing_status affiche ended, puis diffusez les résultats. Chaque résultat porte le custom_id que vous avez défini et un result.type valant succeeded, errored, canceled ou expired.
import time

while True:
    batch = client.messages.batches.retrieve(batch.id)
    if batch.processing_status == "ended":
        break
    print("still working:", batch.request_counts.processing)
    time.sleep(30)

labels, retry = {}, []
for result in client.messages.batches.results(batch.id):
    if result.result.type == "succeeded":
        msg = result.result.message
        labels[result.custom_id] = next(b.text for b in msg.content if b.type == "text")
    elif result.result.type == "errored":
        retry.append(result.custom_id)

print(f"{len(labels)} labeled, {len(retry)} need another pass")
Deux modes de défaillance méritent un traitement distinct. Une erreur invalid_request signifie que le corps de la requête était incorrect, corrigez-le donc avant de resoumettre. Tout le reste est côté serveur et peut être réessayé tel quel. Un résultat expired signifie que la fenêtre de 24 heures s'est fermée avant l'exécution de cette requête, et vous resoumettez celles-là aussi.
Interrogez selon un minuteur de 30 à 60 secondes. Marteler le point de terminaison de récupération chaque seconde ne vous apporte rien et compte dans vos limites de débit de la Claude API.
Cumulez la tarification batch avec la mise en cache des invites
Le plus grand gain vient de la combinaison des deux réductions. Si chaque requête de votre lot partage un long préfixe — un guide de style, une taxonomie, un contrat de 40 pages — marquez ce préfixe avec cache_control et envoyez le même préfixe marqué sur les 10 000 requêtes.
shared_system = [
    {"type": "text", "text": "You are a support triage analyst."},
    {
        "type": "text",
        "text": taxonomy_document,          # thousands of tokens, identical every time
        "cache_control": {"type": "ephemeral"},
    },
]
Mettez ce bloc system sur chaque Request du lot. Toute requête dont le préfixe correspond octet par octet à une entrée de cache active est facturée au tarif de lecture du cache pour ce préfixe, et la réduction batch de 50 % s'applique aussi bien aux lectures qu'aux écritures du cache. Ne prévoyez pas un taux de succès parfait : un lot traite ses requêtes de manière concurrente plutôt que dans l'ordre, donc les succès de cache au sein d'un même lot sont donnés au mieux. Le guide de mise en cache des invites d'Anthropic couvre les règles de préfixe : tout octet qui change avant votre point de rupture invalide tout ce qui suit, alors gardez les horodatages et le texte propre à chaque élément après le bloc mis en cache.
Laissez Claude Code tester le point de terminaison avec Apidog CLI
Avant de dépenser de l'argent sur 100 000 requêtes réelles, vous voulez un test de régression sur le cycle de vie du lot : créer, récupérer, résultats. L'écrire à la main dans une interface graphique est lent. Laissez plutôt votre agent de codage le faire avec Apidog CLI.
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install   # pick Claude Code when prompted
Puis une seule invite à Claude Code :
In Apidog project 4820193, create a test case for POST https://api.anthropic.com/v1/messages/batches
that submits two Haiku 5.5 requests with custom_id ticket-0 and ticket-1, asserts the response
has an id and processing_status, then polls GET /v1/messages/batches/{id} until processing_status
is ended. Run it against the anthropic-staging environment and summarize failures.
L'agent lit le schéma de la charge utile, valide son propre JSON, puis crée et exécute le cas :
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file batch-case.json
apidog test-case create --project 4820193 --file batch-case.json
apidog run --test-case 77214 --project 4820193 -e 992301 -r cli,json
Votre clé API reste dans une variable d'environnement Apidog, de sorte qu'elle n'atterrit jamais dans une invite ni dans un dépôt. Remplacez le rapporteur par -r junit et la même commande s'exécute dans la CI à chaque fusion, ce qui correspond à la configuration de notre guide de pipeline Apidog CLI. Si vous n'avez pas encore connecté le CLI à votre agent, commencez par utiliser Apidog CLI dans Claude Code.
Quand le batch n'est pas le bon choix
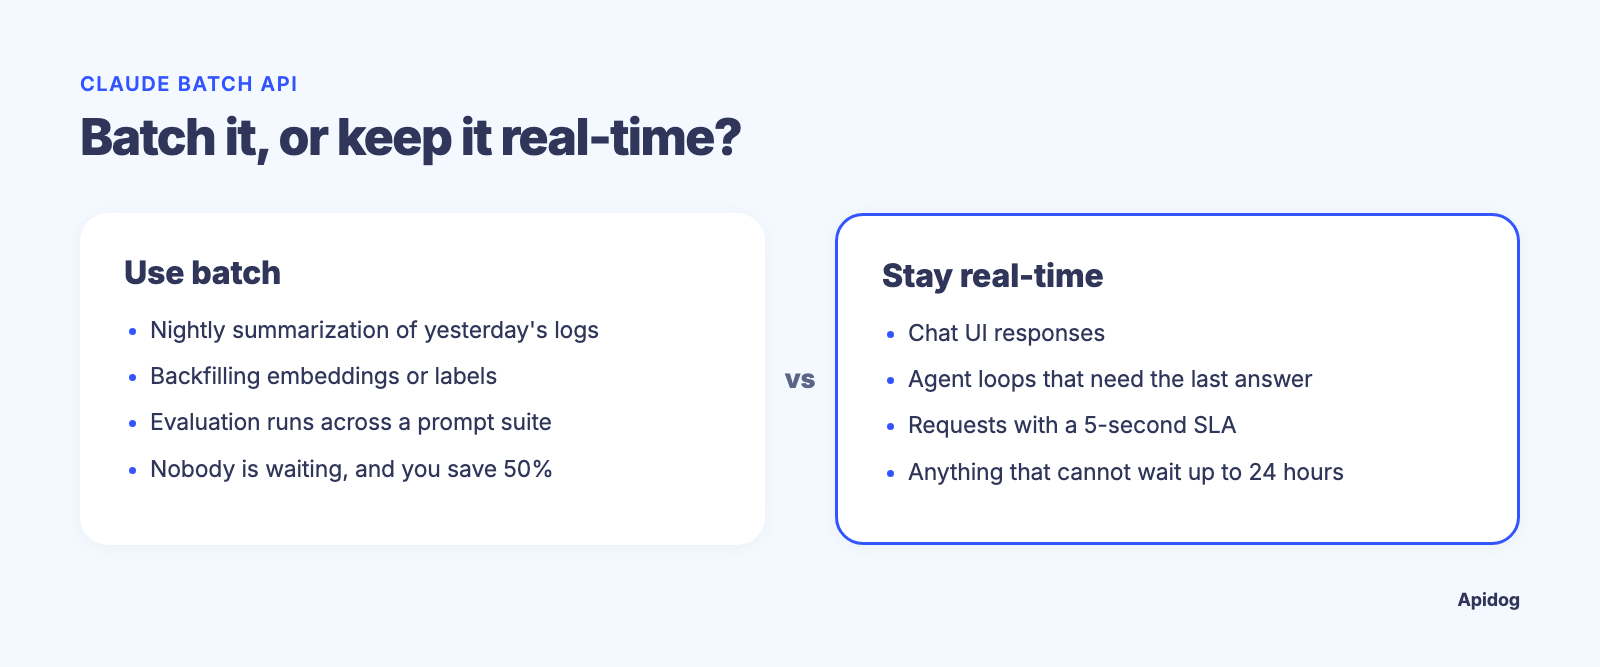
| Charge de travail | Utiliser le batch ? | Pourquoi |
|---|---|---|
| Résumé nocturne des journaux de la veille | Oui | Personne n'attend ; 50 % de réduction |
| Remplissage d'embeddings ou d'étiquettes sur un corpus | Oui | Correspond au plafond de 100 000 requêtes |
| Exécutions d'évaluation sur une suite d'invites | Oui | Les résultats indexés par custom_id correspondent aux ID de test |
| Réponses d'interface de chat | Non | Les utilisateurs n'attendront pas une heure |
| Une boucle d'agent qui a besoin de la dernière réponse pour choisir l'étape suivante | Non | Les requêtes d'un lot ne peuvent pas se voir entre elles |
| Une requête qui doit respecter un SLA de 5 secondes | Non | Aucune garantie de latence en dessous de 24 heures |
Quelques éléments ne s'appliquent pas non plus. Le mode rapide n'est pas disponible sur la Batch API, les replis de refus côté serveur y sont rejetés, et sur Claude Opus 5.5 et Claude Sonnet 5.5, un tool_choice forcé à any ou tool renvoie une erreur 400 dans un lot exactement comme lors d'un appel normal. Utilisez plutôt tool_choice: auto avec strict: true.
Si vous exploitez une infrastructure multi-fournisseurs, le même modèle existe ailleurs : consultez l'OpenAI Batch API et le mode batch de l'API Gemini. Les formes diffèrent, l'économie non.
FAQ
Qu'est-ce que la Claude Batch API ?
C'est un point de terminaison asynchrone qui exécute des requêtes standard de la Messages API en masse à 50 % des prix normaux des tokens. Vous soumettez une liste de requêtes avec vos propres ID, interrogez jusqu'à la fin du lot, et lisez les résultats dans les 29 jours.
Combien coûte la Claude Batch API ?
La moitié du tarif standard sur l'entrée et la sortie. Sur Claude Sonnet 5.5, cela représente 1,00 $ par million de tokens d'entrée et 5,00 $ par million de tokens de sortie, contre 2,00 $ et 10,00 $ en synchrone.
Combien de temps prend un lot Claude ?
La plupart des lots se terminent en moins d'une heure. Le maximum est de 24 heures, après quoi toute requête non traitée renvoie un résultat expired et vous la resoumettez.
Puis-je utiliser la mise en cache des invites dans un lot ?
Oui, et les réductions se cumulent. Marquez un préfixe partagé avec cache_control, répétez ce préfixe identique dans chaque requête, et les lectures en cache sont facturées à une fraction du prix d'entrée en plus de la réduction batch.
Que se passe-t-il lorsqu'une requête d'un lot échoue ?
Seule cette requête échoue. Son résultat porte type: "errored" avec un objet d'erreur ; tout le reste réussit toujours. Les erreurs de validation nécessitent une charge utile corrigée, les erreurs serveur peuvent être réessayées sans modification.
Puis-je annuler un lot en cours d'exécution ?
Oui. client.messages.batches.cancel(batch_id) fait passer le lot à canceling. Les requêtes déjà terminées conservent leurs résultats ; les autres reviennent en canceled.
La Batch API prend-elle en charge les outils et les images ?
Oui. Chaque fonctionnalité de la Messages API fonctionne dans un lot, y compris la vision, les définitions d'outils et les invites système. Les exceptions sont le mode rapide, les replis côté serveur et le choix d'outil forcé sur les modèles 5.5.
Pour conclure
Le traitement par lots est la deuxième plus grande économie gratuite sur la Claude API après la mise en cache des invites, et il ne coûte rien en qualité : mêmes modèles, mêmes fonctionnalités, moitié prix, payé en latence que vous n'utilisiez probablement pas. Indexez vos résultats par custom_id, mettez en cache le préfixe partagé, et traitez expired comme une nouvelle tentative plutôt qu'un échec.
Testez le cycle de vie avant de le mettre à l'échelle. Installez Apidog CLI, pointez votre agent de codage vers les points de terminaison batch, et gardez le cas de test généré en cours d'exécution dans la CI afin qu'un changement de schéma ne vous surprenne jamais à 100 000 requêtes. Le plan gratuit couvre 4 utilisateurs, et vous pouvez télécharger Apidog et faire tourner le premier cas en quelques minutes.