
La Chain of Recall est une méthode permettant de doter un agent IA persistant d'une mémoire sans saturer sa fenêtre de contexte. Chaque Trigger, Thread et Worker se voit attribuer un identifiant stable. Le contexte ne conserve que des identifiants, de courts résumés et les messages adjacents, tandis que l'agent parcourt les liens entre ces identifiants pour récupérer des informations plus anciennes en quelques sauts.
Le terme est issu de l'essai de conception de DeepSeek Harness, « Exploring Super-agent Design », publié le 01/11/2026. Une précision importante avant d'aller plus loin : cet essai décrit une architecture et non une fonctionnalité prête à l'emploi. Certains de ses composants figurent dans un plugin prototype, dsh-superagent-prototype, que les auteurs qualifient de « produit non officiel de DeepSeek ». Il n'existe pas d'interrupteur pour activer la Chain of Recall : il s'agit d'un patron d'architecture qu'il vous appartient de construire.
Le problème de la fenêtre de contexte pour les agents persistants
Un agent persistant finit inévitablement par se heurter à la limite de sa fenêtre de contexte, car le flux de travail ne s'interrompt jamais. Un super-agent surveillant le chat, GitHub et la CI voit passer des centaines d'événements par jour : la fenêtre qui contenait l'activité d'hier ne peut pas également stocker celle d'aujourd'hui.
Les solutions classiques ont toutes leurs inconvénients :
- Tout conserver. La fenêtre se remplit et la facture en jetons grimpe à chaque interaction.
- Résumer les échanges passés. Un résumé élimine souvent le message d'erreur précis ou le numéro de PR dont vous aurez besoin plus tard.
- Rechercher par similarité sémantique. Cela fonctionne jusqu'au jour où l'information recherchée ne ressemble pas textuellement à votre requête.
Le guide d'Anthropic sur l'ingénierie de contexte pour les agents IA aborde le contexte comme une ressource limitée qu'il faut soigneusement orchestrer. La Chain of Recall constitue une réponse concrète à ce besoin de sélection, et notre guide sur le fonctionnement de la mémoire des agents IA détaille l'ensemble des approches envisageables.
« Inline » vs « spill » : le contexte vu comme un cache
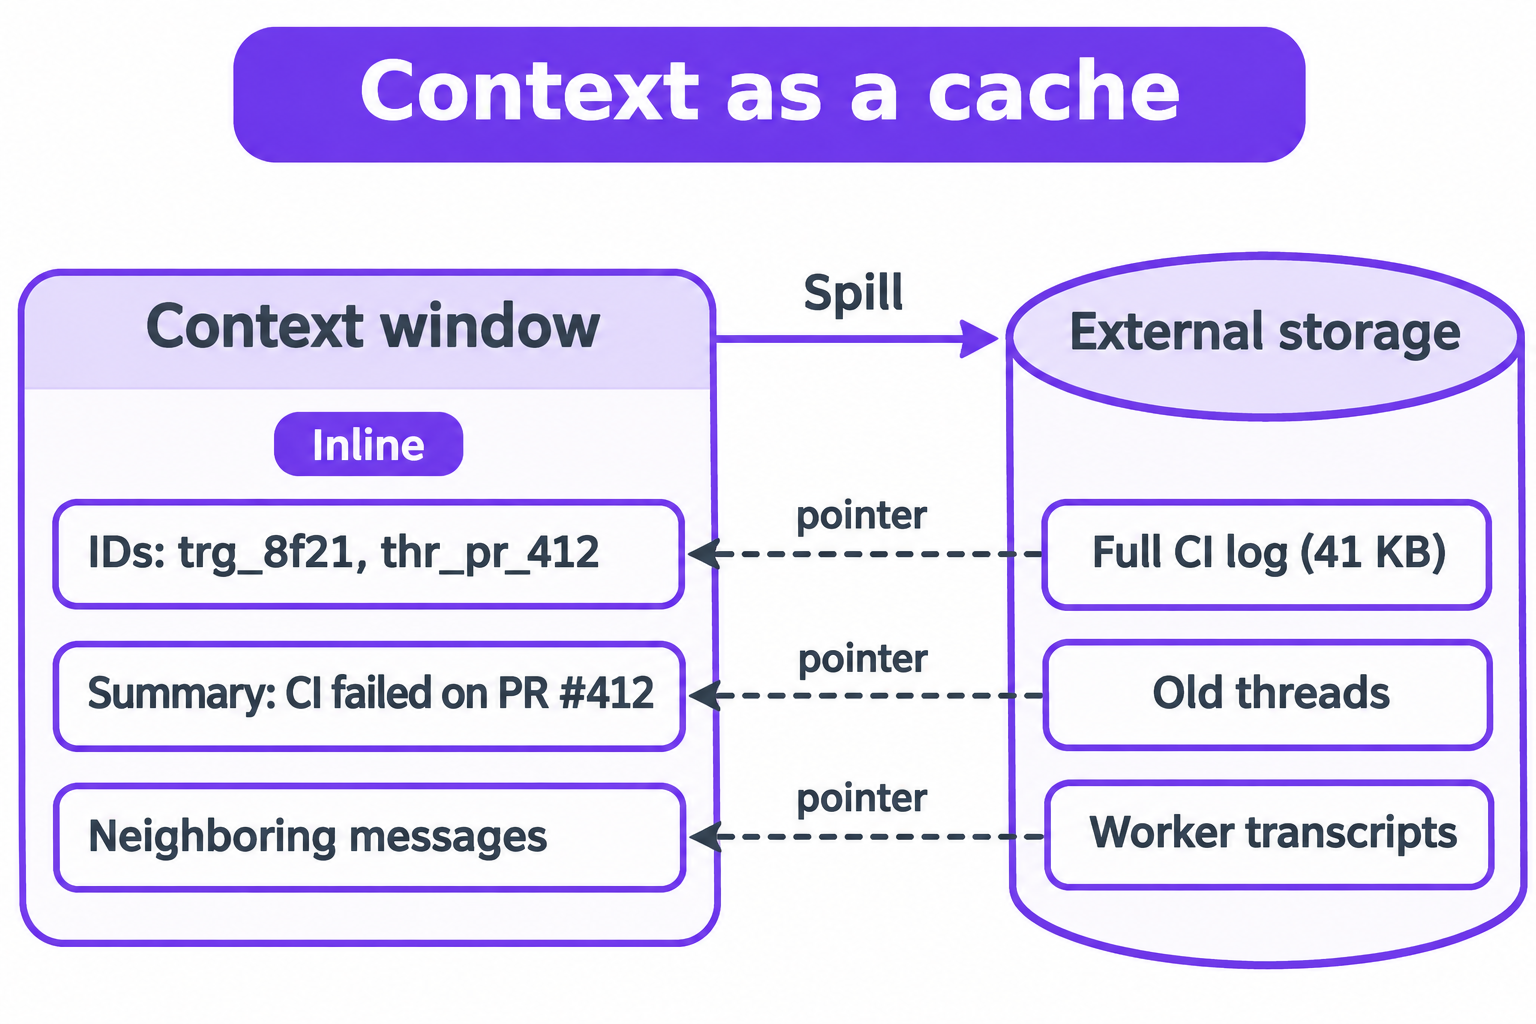
L'essai traite la fenêtre de contexte comme un cache articulé autour de deux opérations :
- Intégrer (« Inline ») ce dont l'agent aura très probablement besoin immédiatement : identifiants, courts résumés et messages adjacents.
- Délester (« Spill ») tout le reste : tronquer les données volumineuses en ne laissant qu'un pointeur que l'agent pourra suivre ultérieurement.
Un élément délesté n'est pas supprimé : seul son pointeur subsiste dans le prompt.
Voici à quoi cela ressemble pour un échec de CI arrivant au niveau du Router. Cette structure est donnée à titre indicatif et ne reproduit pas le code interne de DeepSeek :
{
  "trigger_id": "trg_8f21",
  "source": "github.check_run",
  "thread_id": "thr_pr_412",
  "summary": "CI failed on PR #412: 3 of 118 tests red in payments/",
  "neighbours": ["trg_8f1c: review comment asking for retry logic"],
  "spilled": {
    "full_log": "GET /triggers/trg_8f21/payload (41 KB, truncated)"
  }
}
Si le résumé d'une ligne suffit, l'agent ne paie jamais le coût en jetons du journal de 41 Ko. Dans le cas contraire, il récupère le log complet grâce à son ID.
Identifiants stables et graphe de références
La Chain of Recall fonctionne parce que les identifiants ne changent jamais. Dans la conception proposée par l'essai, trois types d'objets en sont dotés :
| Objet | Description | Exemple d'ID |
|---|---|---|
| Trigger | Un événement entrant : message de chat, webhook, callback de CI | trg_8f21 |
| Thread | Une série d'événements liés sur une PR, un sujet de messagerie ou un fil d'e-mails | thr_pr_412 |
| Worker | Une session d'agent isolée prenant en charge une tâche précise | wkr_77a0 |
Un Trigger appartient à un Thread, un Thread est rattaché à un ou plusieurs Workers, et le compte-rendu d'un Worker cite les Triggers sur lesquels il est intervenu. Ces liens forment un graphe de références, et ce graphe constitue la mémoire de l'agent.
Le rappel s'effectue en suivant les liens saut par saut, et non en rechargeant tout l'historique ou en cherchant des similarités textuelles. Notre guide complémentaire sur la conception d'un super-agent détaille le rôle respectif des Triggers, Threads et Workers dans l'architecture globale Router et Worker.
Exemple d'un rappel multi-sauts pas à pas
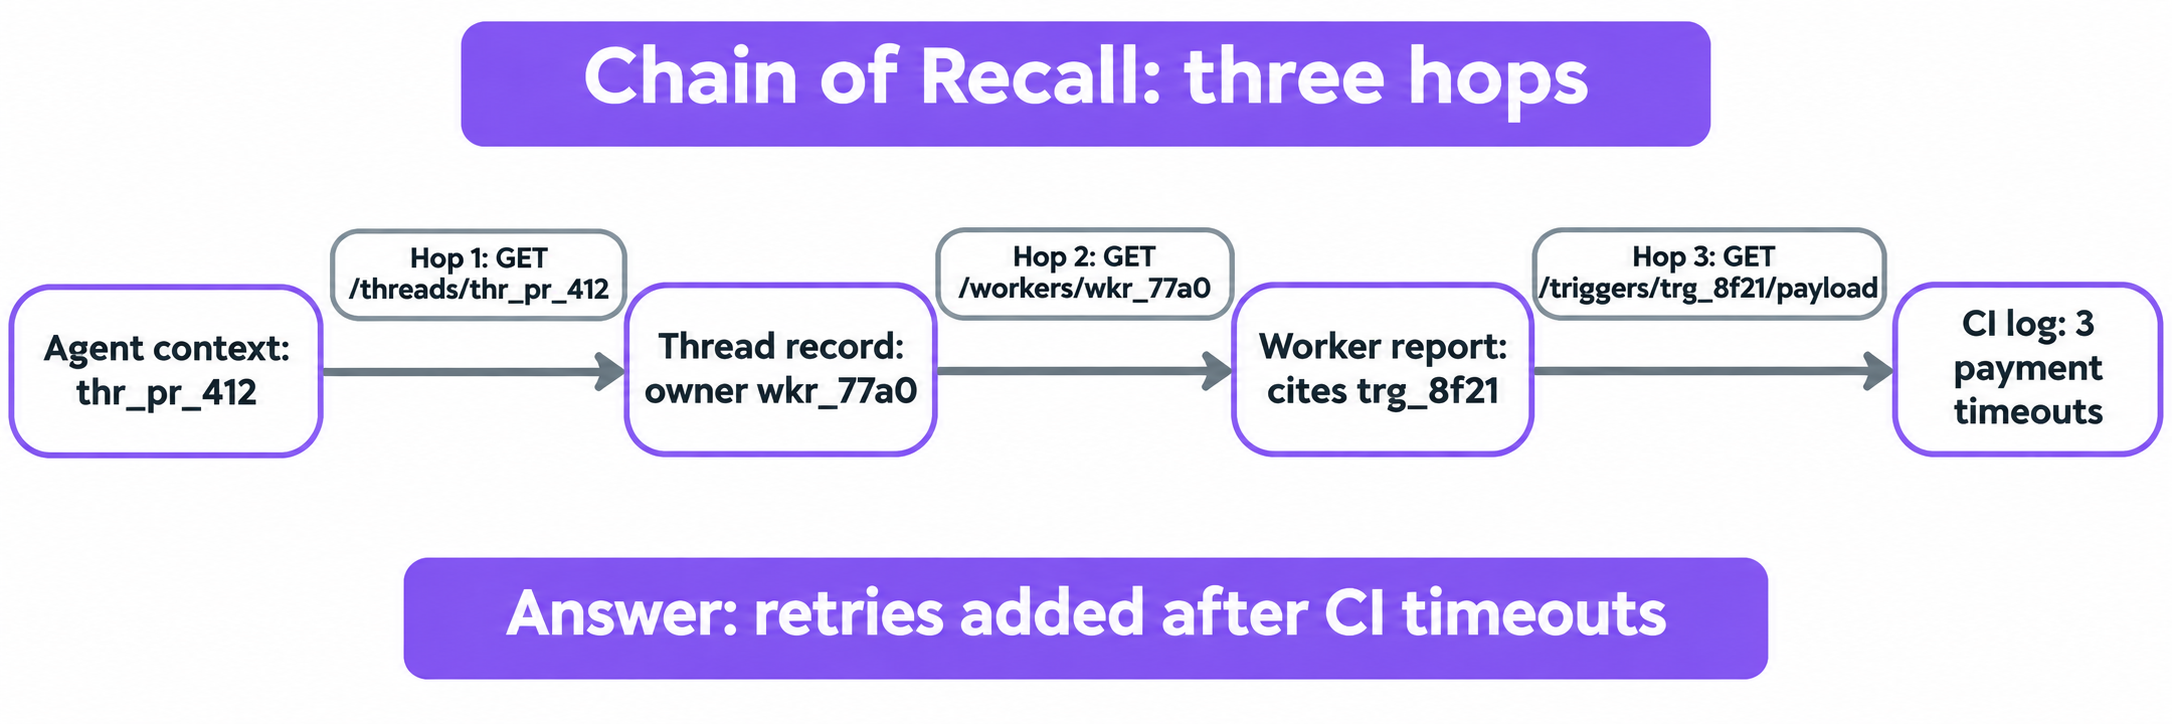
Supposons qu'un collègue demande au Router le vendredi : « Pourquoi avons-nous ajouté une logique de retry au client de paiement ? ». La discussion initiale a eu lieu le mardi et a été délestée depuis longtemps. Voici le cheminement :
- Saut 1 : trouver le Thread. Le contexte du Router contient encore une entrée d'index d'une ligne :
thr_pr_412: payments retry PR, merged Wed. Il effectue l'appelGET /threads/thr_pr_412. - Saut 2 : identifier le Worker. L'enregistrement du Thread liste
owner_workers: ["wkr_77a0"]. Le Router appelleGET /workers/wkr_77a0et consulte son rapport final. - Saut 3 : déterminer la cause. Le rapport cite
trg_8f21, l'échec de la CI. Le Router récupère la charge utile de ce Trigger et analyse les erreurs de timeout dans les logs. - Réponse. « La CI sur la PR #412 a échoué mardi en raison de 3 timeouts sur les paiements. Le Worker wkr_77a0 a ajouté des retries avec backoff et la PR a été fusionnée mercredi. »
Trois requêtes ciblées et exactes. Aucune supposition n'a été faite, et aucune donnée superflue n'a encombré le prompt pendant trois jours.
Chain of Recall vs mémoire vectorielle et résumés
La Chain of Recall ne remplace pas les autres techniques de mémoire : elle répond à une question différente. La recherche vectorielle, popularisée par la publication originale sur la génération augmentée par récupération (RAG), cherche ce qui « ressemble à ceci ». La Chain of Recall cherche ce qui « est lié à ceci ».
| Chain of Recall | Mémoire vectorielle (RAG) | Résumés glissants | Serveurs MCP de mémoire | |
|---|---|---|---|---|
| Mécanisme de rappel | Suit les liens d'identifiants stables | Recherche de similarité sur des embeddings | Lit un historique compressé | Appelle un outil de mémoire exposé par le serveur |
| Précision | Enregistrement exact par ID | Approximative, classée par score | Avec perte d'informations par conception | Dépend de la base de données du serveur |
| Idéal pour | Historiques d'événements : PR, tickets, exécutions CI | Vastes corpus documentaires, questions ouvertes | Sessions courtes, continuité de conversation | Faits partagés entre plusieurs outils et sessions |
| Prérequis | Identifiants immuables, API de récupération par ID | Modèle d'embedding et base indexée | Passe de génération de résumés | Serveur MCP opérationnel |
| Point faible | Incapable de trouver ce qui n'est pas relié | Passe à côté de faits formulés différemment | Perte de détails | Un service de plus à administrer et sécuriser |
En pratique, vous combinerez ces approches : un index vectoriel retrouve l'ID du Thread de départ, puis la Chain of Recall navigue vers les faits précis. La hiérarchie de mémoire inspirée des systèmes d'exploitation décrite dans l'article sur MemGPT repose sur une logique très proche. Si vous préférez démarrer avec une solution prête à l'emploi, consultez notre guide pour ajouter une mémoire persistante aux agents IA avec MCP.
Deux limites méritent d'être soulignées. L'essai classe la mémoire à long terme parmi les problèmes ouverts et ne prétend pas que la Chain of Recall le résout. De plus, dans son expérimentation, la suppression du transfert direct de Thread a fait passer le volume de jetons lus dans le cache de 23,2 M à 31,8 M par exécution, soit environ 37 % d'augmentation : il s'agit du coût lié à l'absence d'une fonctionnalité, et non d'une économie apportée par la Chain of Recall en elle-même.
Les garanties indispensables pour les API sous-jacentes
Chaque saut du parcours correspond à un appel d'API. Si une seule requête renvoie un enregistrement différent ou n'aboutit pas, la chaîne se rompt et l'agent se retrouve bloqué ou contraint d'inventer une réponse. Les API sous-jacentes à la Chain of Recall doivent donc honorer quatre engagements contractuels :
- Immuabilité stricte des identifiants. Un ID renvoyé aujourd'hui doit désigner exactement le même objet le mois prochain. Aucune réutilisation après suppression, aucune renumérotation après migration.
- Récupération par ID rapide et exacte.
GET /threads/{id}renvoie cet unique enregistrement. L'API n'effectue aucune recherche et ne retourne aucun résultat approchant. - Signalement explicite des ID inconnus. Un identifiant manquant retourne une erreur
404 Not Found, comme définie par la norme RFC 9110, accompagnée d'un corps d'erreur explicite. Renvoyer un code200avec un objet vide laisse croire à l'agent qu'un souvenir existe alors qu'il n'en est rien. - Pagination sans omission via curseur. L'appel
GET /threads/{id}/events?cursor=parcourt un long Thread dans l'ordre chronologique. Chaque événement doit apparaître une seule fois sans saut, et le curseur doit rester valide même si de nouveaux événements surviennent.
Ces contrats ont tendance à se rompre insidieusement lors de refactorisations : ils doivent donc faire l'objet de tests automatisés. Les réponses des outils doivent également rester concises, un aspect que notre guide sur les réponses d'outils d'agents et la fenêtre de contexte analyse en profondeur.
Faites tester les API de rappel par votre agent de code avec Apidog CLI
La Chain of Recall n'est fiable que si ses endpoints de récupération par ID le sont, et un agent de développement peut écrire et exécuter ces vérifications à votre place. Apidog CLI fournit à l'agent les commandes nécessaires pour définir les endpoints, créer les cas de test et les exécuter directement depuis le terminal.
Configurez-le une première fois :
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Transmettez ensuite cette consigne à Claude Code, Codex ou à l'agent que vous utilisez :
In Apidog project <projectId>, define three endpoints for our agent memory
service: GET /threads/{id}, GET /threads/{id}/events?cursor=, and
GET /workers/{id}. Then create test cases that check:
1. A thread_id returned by GET /threads/{id} resolves to the same record
   on a second call, and each owner worker ID resolves via GET /workers/{id}.
2. An unknown thread ID and an unknown worker ID both return 404.
3. Paging GET /threads/{id}/events with the cursor returns every event
   once, in order, with no gaps.
Run them against the staging environment and summarize any failures.
L'agent consulte le schéma de chaque payload, valide son JSON avant toute écriture, puis génère et lance les scénarios de test :
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file thread-get.json
apidog endpoint create --project <projectId> --file thread-get.json

apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file id-resolves.json
apidog test-case create --project <projectId> --file id-resolves.json

apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
Le rapporteur cli affiche les réussites et échecs de chaque assertion dans le terminal, tandis que le rapport json fournit à l'agent un fichier lisible pour identifier quel saut a échoué. Si un ID cesse d'être résolu après une migration, vous le constaterez dans le rapport avant même que votre agent ne commence à répondre sur la base d'une chaîne brisée. Pour exécuter ces mêmes contrôles à chaque fusion (merge), basculez le format de rapport vers -r junit ; notre tutoriel sur l'intégration d'Apidog CLI dans Claude Code illustre la boucle complète de l'agent.
Quand utiliser la Chain of Recall
Adoptez la Chain of Recall lorsque la mémoire de votre agent est un historique d'événements discrets et reliables entre eux : PR, tickets, exécutions CI, fils d'assistance, déploiements. Ces objets possèdent déjà des identifiants naturels, et les questions qu'on leur pose (« Pourquoi avons-nous fait cela ? », « Que s'est-il passé après ? ») portent directement sur des liens de causalité.
Privilégiez la recherche vectorielle pour les documents non structurés et les questions ouvertes, et les résumés pour les sessions courtes où la perte de granularité est sans conséquence.
La Chain of Recall provient d'un essai technique et d'un prototype : une idée limpide et éprouvable, pas un produit commercial. Pour découvrir l'outil à l'origine de cette réflexion, commencez par notre article sur ce qu'est DeepSeek Harness.
FAQ
La Chain of Recall est-elle une fonctionnalité de DeepSeek que je peux activer ? Non. Il s'agit d'un terme issu de l'essai sur les super-agents de DeepSeek Harness, et certaines parties figurent dans un plugin prototype que les auteurs qualifient de produit non officiel de DeepSeek. C'est un modèle d'architecture que vous devez concevoir vous-même.
Quelle est la différence entre « inline » et « spill » ? « Inline » conserve les identifiants, de courts résumés et les messages adjacents dans le prompt. « Spill » tronque le reste et laisse un pointeur que l'agent peut récupérer par ID au besoin.
La Chain of Recall remplace-t-elle le RAG ? Non. Le RAG recherche du contenu par similarité ; la Chain of Recall suit des liens d'identifiants exacts. De nombreux agents combinent les deux approches.
La Chain of Recall a-t-elle permis de réduire les jetons de 37 % ? Non. Le chiffre de 37 % concerne le transfert direct de Thread (« Thread pass-through ») : sa désactivation a augmenté les jetons lus dans le cache de 23,2 M à 31,8 M par exécution dans l'expérience de l'essai. L'essai ne fait état d'aucune économie de jetons imputable à la Chain of Recall elle-même.
Que doit renvoyer une API de récupération par ID pour un identifiant inconnu ? Une erreur 404 Not Found avec un corps de réponse explicite. Renvoyer un code 200 avec un objet vide laisse croire à l'agent qu'un souvenir existe, ce qui corrompt silencieusement la chaîne de rappel.
Comment m'assurer que les API de mémoire de mon agent restent stables ? Écrivez des tests automatisés vérifiant qu'un ID retourné par un appel est résolu lors du suivant, que les ID inconnus renvoient une 404 et que la pagination par curseur s'opère sans rupture. Un agent de développement peut concevoir et exécuter ces vérifications avec Apidog CLI à chaque fusion.