
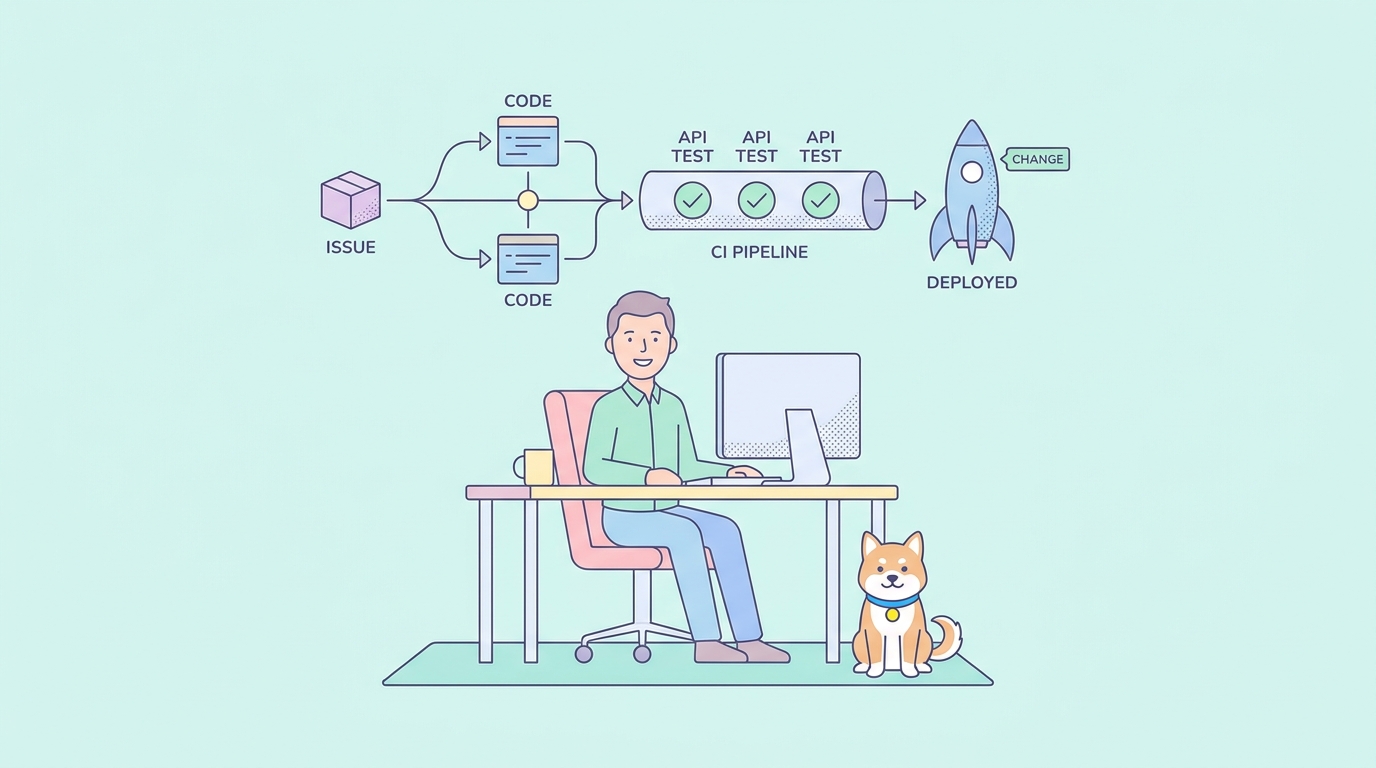
Le diagramme de Gergely Orosz sur l'usine logicielle interne d'OpenAI a fait le tour cette semaine : un développeur dépose un résultat, Codex écrit le code, une flotte d'agents réviseurs spécialisés débattent des risques, et un agent surveille le déploiement en regardant des tableaux de bord qu'il a lui-même construits. C'est aussi, pour les parties qui importent le plus aux ingénieurs d'OpenAI, une description d'outils internes que vous ne pouvez pas installer.
Perf Factory, Sevbot et le déploiement agentique avec des tableaux de bord auto-construits fonctionnent sur la propre pile d'observabilité d'OpenAI et ne font pas partie du produit Codex que vous pouvez acheter. Ce que vous pouvez construire cette semaine, c'est une boucle plus petite qui fait toujours un travail réel : un développeur définit le résultat comme une tâche, Codex travaille sur la branche, l'intégration continue vérifie que le changement se comporte réellement, un ou deux agents réviseurs l'examinent, et un humain approuve tout ce qui est risqué avant qu'il ne soit déployé derrière un drapeau de fonctionnalité. Le tout repose sur un détail que le diagramme original omet : "CI passe" ne signifie quelque chose que si la CI vérifie les bonnes choses. Pour une API, cela signifie tester l'API, pas seulement le code qui l'appelle.
Ce que le diagramme montre correctement (et ce que vous ne pouvez pas copier)
La partie publique de l'article de Pragmatic Engineer décrit une boucle principale où Codex "effectue une série de modifications de code jusqu'à ce qu'il atteigne son objectif, puis vérifie que le logiciel fonctionne comme il le devrait". Les zones à faible risque peuvent être auto-approuvées ; les modifications à risque plus élevé reçoivent une révision plus approfondie par l'IA ou une approbation humaine obligatoire. Cette structure, proposer, vérifier, réviser par niveau de risque, est portable. Les équipes l'ont approximée avec des bots de pull request et des portes CI pendant des années ; les agents ne font que rendre la boucle plus rapide et moins supervisée.
Ce qui n'est pas portable, c'est le mécanisme interne qui l'entoure. Perf Factory trie les alertes et les tableaux de bord pour trouver les régressions de latence et proposer des corrections. Sevbot enquête sur les incidents et répond aux questions dans Slack, bien qu'il n'exécute pas lui-même les mesures d'atténuation. Le déploiement agentique surveille un changement en production et construit sa propre surveillance en utilisant la pile de télémétrie interne d'OpenAI. Aucun de ces trois éléments n'est livré dans le produit externe Codex. Ce qui a été livré, c'est l'application de bureau, la commande /goal pour les tâches de longue durée, et les plugins de rôle et les compétences que vous configurez vous-même. La page produit Codex d'OpenAI couvre ce qui est réellement disponible.
La boucle en cinq étapes que vous pouvez exécuter cette semaine
Une version réduite ressemble à ceci :
- Un développeur dépose le résultat sous forme de tâche. Pas une liste de tâches, mais une description de l'état final : "les commandes peuvent inclure un code de réduction optionnel qui réduit le total". Transmettre cette même tâche GitHub à un Agent dans Sharkly est l'intégration livrée : la tâche devient un objectif (Task), et le résultat revient comme une pull request plutôt que comme un ticket séparé à concilier. C'est actuellement gratuit pour les organisations jusqu'à 10 personnes.
- Codex travaille sur la branche avec
/goal. Comme expliqué dans comment la commande/goalpilote les exécutions autonomes de Codex et Claude Code, vous donnez un objectif à l'agent et le laissez itérer par lui-même jusqu'à ce que l'objectif soit atteint. - La CI exécute la construction, les tests unitaires et les scénarios de test d'API. C'est l'étape que la plupart des équipes sautent ou construisent à moitié.
- Un ou deux agents réviseurs vérifient le diff, et un humain examine tout ce qui dépasse un faible risque. Les outils de révision de code par IA peuvent détecter beaucoup de choses avant qu'un humain n'ouvre la PR. Dans Sharkly, c'est là que "Prêt pour la publication" fait le travail : un humain doit faire passer la tâche de ce statut avant que quoi que ce soit n'atteigne "Terminé", et un agent réviseur séparé peut siéger dans la même équipe que celui qui a écrit le code.
- Déployer derrière un drapeau de fonctionnalité, afin qu'une mauvaise fusion soit un simple basculement, et non un incident.
L'étape 3 est celle où la boucle fonctionne ou vous ment.
Pourquoi la CI doit tester l'API, pas seulement le code
La propre fonctionnalité de révision de Codex, couverte dans comment fonctionne la révision de code de Codex, lit le diff et signale les problèmes évidents. Elle n'exécute pas votre service et ne vérifie pas ce qu'il renvoie. Les tests unitaires, si l'agent les a écrits ou conservés, vérifient principalement que le code fait ce que le code entend, ce qui n'est pas la même chose que de vérifier que l'API fait ce que le contrat promet. Un agent modifiant un gestionnaire peut passer tous les tests unitaires tout en cassant silencieusement la réponse dont dépend chaque client.
Supposons que vous gériez une API de commandes. POST /api/orders crée une commande et renvoie son enregistrement ; GET /api/orders/{id} en récupère une par ID. Vous maintenez une spécification OpenAPI pour les deux, et vous avez construit des scénarios de test Apidog contre celle-ci : créer une commande, la récupérer, et vérifier quatre choses qu'un test unitaire ne fera généralement pas :
- Codes de statut.
POST /api/ordersrenvoie201, pas200ou une500silencieuse sur un cas limite de validation. - Schéma de réponse par rapport à la spécification OpenAPI. Le champ
total_amountreste un nombre,statusreste l'une des valeurs d'énumération que vous avez définies, et aucun champ dont dépendent les clients ne disparaît discrètement ou n'est renommé. - Échecs d'authentification. Une requête sans jeton valide renvoie
401, pas un 200 avec un corps vide, ce qui est une régression étonnamment courante. - Un seuil de latence. Le scénario affirme que la réponse revient en dessous d'une limite définie, de sorte qu'un changement qui ajoute un appel de base de données non groupé à l'intérieur du gestionnaire est détecté avant qu'un client ne le remarque.
Ce sont exactement les vérifications qu'une refactorisation au niveau du gestionnaire peut silencieusement casser alors que chaque test unitaire passe toujours, car les tests unitaires simulent généralement la limite que le scénario d'API exerce réellement.
Intégration dans le pipeline
Vous exécutez déjà la version CLI de ces scénarios localement si vous avez suivi comment utiliser l'CLI Apidog dans Codex. La même commande s'exécute en CI. Une tâche GitHub Actions qui construit, exécute les tests unitaires, puis exécute le scénario Apidog ressemble à ceci :
name: CI

on:
  pull_request:
  push:
    branches: [main]

jobs:
  build-test-verify:
    runs-on: ubuntu-latest
    steps:
      - name: Check out repository
        uses: actions/checkout@v4

      - name: Set up Node.js
        uses: actions/setup-node@v4
        with:
          node-version: '20'

      - name: Install dependencies
        run: npm ci

      - name: Build and run unit tests
        run: npm run build && npm test

      - name: Install Apidog CLI
        run: npm install -g apidog-cli

      - name: Run orders API test scenario
        env:
          APIDOG_ACCESS_TOKEN: ${{ secrets.APIDOG_ACCESS_TOKEN }}
        run: |
          apidog run \
            --access-token $APIDOG_ACCESS_TOKEN \
            -t 88214 \
            -e 3301 \
            -r cli,junit

      - name: Upload Apidog reports
        if: always()
        uses: actions/upload-artifact@v4
        with:
          name: apidog-reports
          path: apidog-reports/
Les valeurs -t et -e sont vos identifiants réels de scénario et d'environnement d'Apidog, et non des espaces réservés que vous inventez. La référence de la commande apidog run couvre tous les drapeaux, et les rapports de test CLI Apidog expliquent la sortie JUnit que la tâche télécharge. apidog run se termine avec un code de sortie non nul en cas d'assertion échouée, de sorte que GitHub Actions marque la tâche comme échouée de la même manière que pour un test unitaire échoué.
À quoi ressemble le prompt de l'agent
L'intérêt de /goal est que vous décrivez le résultat et la condition de sortie, et Codex itère sans que vous n'approuviez chaque étape. Pour l'exemple du code de réduction, un prompt raisonnable est :
/goal Ajouter un champ `discount_code` optionnel à POST /api/orders. Le valider
contre le service de promotions et appliquer la réduction au `total_amount` dans
la réponse. Ne pas renommer ni supprimer aucun champ de réponse existant. Exécuter
`npm test` et `apidog run --access-token $APIDOG_ACCESS_TOKEN -t 88214 -e 3301
-r cli` avant de terminer. Les deux doivent sortir avec le code 0. Si l'exécution Apidog échoue, lire
l'assertion échouée et corriger le gestionnaire, pas le test.
Cette dernière ligne est importante. Un agent sous pression pour faire passer un contrôle au vert éditera parfois l'assertion au lieu du bug. Lui dire explicitement quel côté de la boucle corriger maintient le scénario de test comme source de vérité, et non comme un obstacle à contourner.
Quand l'agent rompt le contrat
Codex ajoute le champ de réduction, et ce faisant, renomme total_amount en totalAmount car c'est la convention dans un fichier qu'il a lu à proximité. Les tests unitaires passent toujours ; ils vérifient le calcul de la réduction, pas le nom du champ. La construction réussit. Ensuite, le scénario Apidog s'exécute en CI, valide la réponse par rapport à la spécification OpenAPI, et échoue : la spécification dit total_amount, la réponse a maintenant totalAmount, et l'assertion de schéma le détecte immédiatement.
La CI signale une sortie non nulle et pointe vers l'assertion de schéma défaillante dans la sortie JUnit. Codex lit l'échec, voit que le renommage en est la cause, et le rétablit tout en conservant la logique de réduction. Le scénario passe, la construction passe au vert, et la pull request passe en revue avec une garantie réelle derrière le mot "réussite". Sans la vérification au niveau de l'API, ce renommage serait déployé, et chaque client analysant total_amount serait cassé lors de la prochaine version.
Hiérarchisation des risques que vous pouvez ancrer dans la spécification
Au lieu d'un vague sentiment de ce qui constitue un faible risque, liez votre classification des risques à la différence OpenAPI. Un changement qui ajoute un champ optionnel avec une valeur par défaut est un candidat pour la fusion automatique une fois que les tests sont passés. Un changement qui supprime un champ, en renomme un, ou modifie un code de statut n'est jamais à faible risque, peu importe l'apparence du reste du diff. Cette seule règle capture la plupart de ce qu'un agent de révision spécialisé signalerait de toute façon. Aiguillez tout ce que la règle signale vers un réviseur humain ou une deuxième passe d'un outil de révision de code par IA avant la fusion.
Déployer derrière un drapeau, pas dans le vide
Une fois qu'une modification a passé la CI et la révision, déployez-la derrière un drapeau de fonctionnalité plutôt que directement à tous les utilisateurs. C'est le substitut bon marché de l'étape de déploiement agentique d'OpenAI : aucun agent ne surveille le déploiement ou ne construit ses propres tableaux de bord. Un drapeau qui démarre à 5% du trafic et une personne qui vérifie les taux d'erreur avant de le passer à 100% vous apporte la majeure partie de la sécurité sans aucun des outils internes. Si quelque chose ne va pas, vous désactivez le drapeau au lieu de revenir en arrière sur une fusion sous pression.
Un échafaudage qui existe déjà
Vous n'avez pas besoin de câbler les cinq étapes à partir de zéro. orchflows est un projet open-source qui est apparu dans les réponses au fil d'Orosz : une commande /software-factory sous licence MIT pour Claude Code et Codex, construite autour d'un petit nombre de compétences réutilisables. C'est un échafaudage de départ, pas un remplacement pour les étapes de CI et de révision ci-dessus ; vous le pointez toujours vers vos propres scénarios de test et règles de risque.
Ce qu'il faut éviter de construire
N'essayez pas de reproduire Perf Factory, Sevbot ou le déploiement agentique avec des tableaux de bord auto-construits. Ce sont des systèmes internes d'OpenAI connectés à une télémétrie que la plupart des équipes n'utilisent pas. Les humains chez OpenAI définissent toujours les résultats, approuvent les changements à haut risque, autorisent les atténuations d'incidents et assurent la permanence ; comme l'a dit OpenAI, "la permanence n'est pas une chose du passé". Copiez les parties de la boucle qui relèvent simplement d'une bonne discipline d'ingénierie : vérifiez avant de fusionner, classez les risques en fonction de ce qui a réellement changé, et gardez un humain sur tout ce qui n'est pas manifestement sûr.
Mettez la boucle en marche
Commencez par l'étape de CI ; elle rend toutes les autres étapes fiables. Construisez votre scénario de test d'API de commandes dans Apidog, couvrant les codes de statut, le schéma, l'authentification et un budget de latence. Intégrez-le dans votre pipeline avec la CLI, pointez /goal vers un problème réel, et laissez Codex itérer contre une vérification qui affirme réellement le comportement de l'API au lieu de se fier à la parole de l'agent. Téléchargez Apidog pour construire le premier scénario, puis ajoutez les étapes de révision et de drapeau une fois que la boucle aura fait ses preuves.