
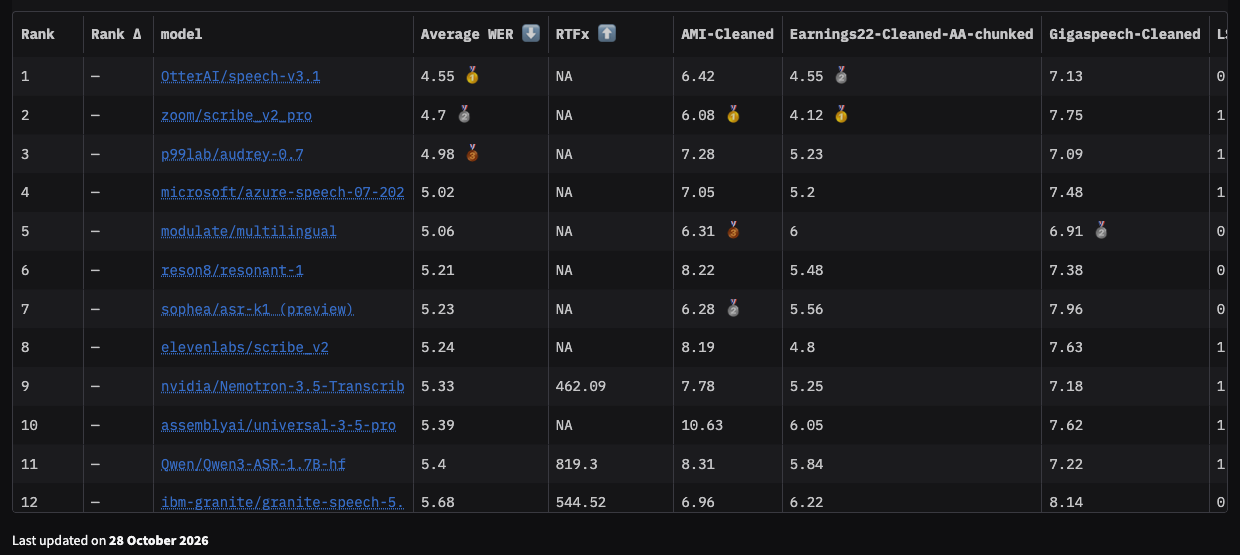
Le meilleur modèle open source de transcription vocale en octobre 2026 est Nemotron 3.5 Transcribe de NVIDIA, publié le 28 octobre. Dans le classement Open ASR de Hugging Face mis à jour le jour même, il affiche un taux d’erreur de mots moyen de 5,33 % et se classe 9e sur 61 modèles. Les huit modèles qui le précèdent sont des API commerciales fermées. whisper-large-v3 d’OpenAI, encore la valeur par défaut dans de nombreux tutoriels, occupe la 41e place avec 7,16 %.
Voici les neuf modèles de reconnaissance vocale à poids ouverts qui méritent d’être considérés actuellement, classés selon ce classement, avec leur vitesse, leurs points forts et la tâche à laquelle chacun convient. Chaque chiffre de WER et de vitesse provient du classement tel que consulté le 29 octobre 2026.
Si vous choisissez plutôt entre des API hébergées, lisez notre guide de l’API Nemotron 3.5 Transcribe et le guide de l’API Whisper.
Comment nous les avons classés
Le classement Open ASR évalue chaque modèle sur les mêmes ensembles de test en anglais : réunions (AMI), appels de résultats financiers (Earnings22), podcasts et YouTube (GigaSpeech), livres audio (LibriSpeech), appels financiers (SPGISpeech), parole bruitée (URGENT24), audio conversationnel (Voice Arena Monsoon), discours parlementaires (VoxPopuli), et deux ensembles privés. La métrique de classement est le WER moyen, où plus bas est mieux.
Nous indiquons aussi RTFx, la mesure de vitesse du classement : secondes d’audio transcrites par seconde de calcul. Plus la valeur est élevée, plus c’est rapide. Les API fermées affichent « NA » car elles ne peuvent pas être chronométrées sur le même matériel.
Nous avons considéré un modèle comme open-weight lorsque son checkpoint est téléchargeable et que le classement indique un RTFx pour lui. Vérifiez chaque licence avant toute utilisation commerciale.
Le classement en un coup d’œil
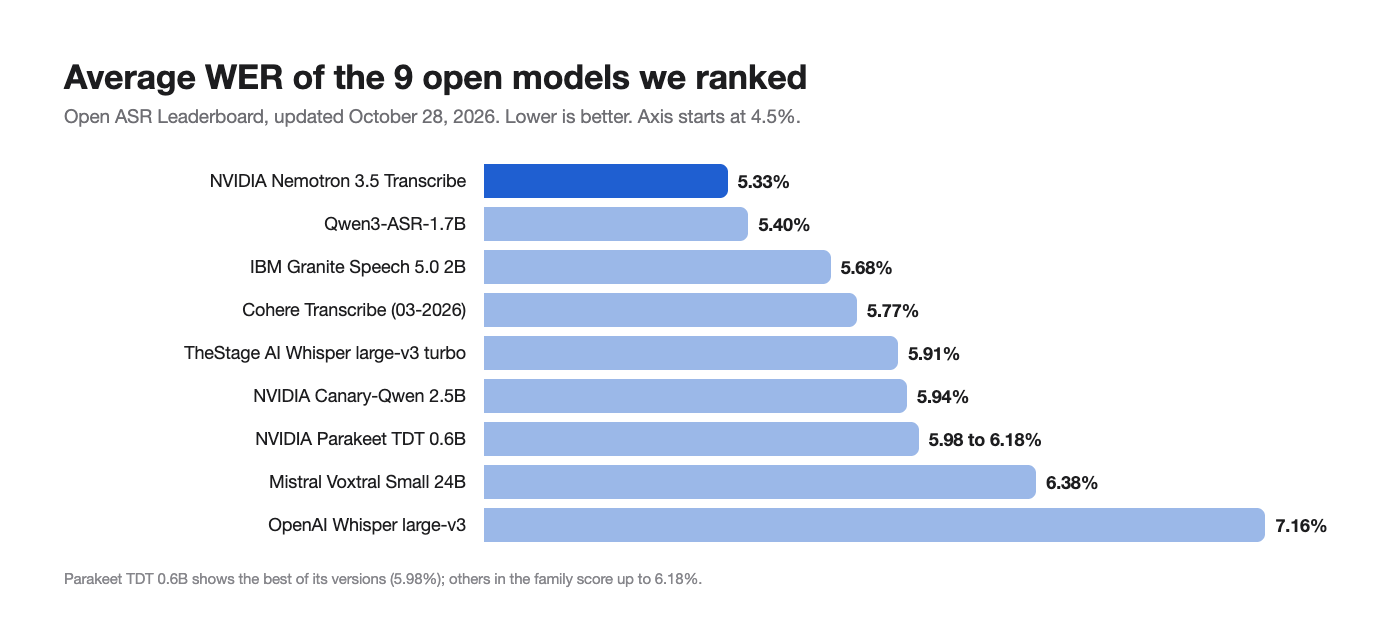
| Rang (open) | Modèle | WER moyen | RTFx | Classement global |
|---|---|---|---|---|
| 1 | NVIDIA Nemotron 3.5 Transcribe 30B-A4B | 5,33 % | 462 | 9 |
| 2 | Qwen3-ASR-1.7B | 5,40 % | 819 | 11 |
| 3 | IBM Granite Speech 5.0 2B | 5,68 % | 545 | 12 |
| 4 | Cohere Transcribe (03-2026) | 5,77 % | 902 | 14 |
| 5 | TheStage AI Whisper large-v3 turbo | 5,91 % | 1 177 | 17 |
| 6 | NVIDIA Canary-Qwen 2.5B | 5,94 % | 862 | 21 |
| 7 | NVIDIA Parakeet TDT 0.6B (versions) | 5,98 % à 6,18 % | non comparé | 24 à 31 |
| 8 | Mistral Voxtral Small 24B | 6,38 % | non comparé | 35 |
| 9 | OpenAI Whisper large-v3 | 7,16 % | non comparé | 41 |
Pour contexte, les meilleures API fermées du même classement : Otter speech-v3.1 à 4,55 %, Zoom Scribe v2 Pro à 4,70 %, ElevenLabs Scribe v2 à 5,24 %, AssemblyAI Universal-3.5 Pro à 5,39 % et OpenAI gpt-transcribe à 5,96 %. Nemotron 3.5 Transcribe surpasse AssemblyAI et le modèle hébergé d’OpenAI tout en étant gratuit à télécharger.
1. NVIDIA Nemotron 3.5 Transcribe : meilleur globalement
WER 5,33 %, RTFx 462, licence OpenMDW-1.1
Le nouveau modèle de NVIDIA n’est pas un réseau ASR classique. C’est un modèle de langage augmenté pour la parole : un encodeur ASR de 600 M de paramètres et un encodeur de locuteur alimentent un LLM hybride Mamba-2 et Transformer à mélange d’experts, avec 34 B de paramètres au total et environ 4,3 B de paramètres actifs. C’est ce design qui lui permet de faire plus que transcrire.
Pourquoi il arrive en tête :
- 40 langues, dont 13 jugées « de premier plan »
- Fichiers d’une heure en une seule passe, avec un contexte de 65 536 tokens
- Attribution des locuteurs (jusqu’à huit locuteurs) et horodatages des mots à partir d’un seul modèle
- Prompts : formulation verbatim ou nettoyée, termes de contexte pour le jargon, traduction
- Précision sur les formats longs : WER moyen de 10,98 % sur les ensembles de formats longs du classement, contre 13,37 % pour Parakeet-TDT-0.6B-v3, selon la fiche du modèle
- Réunions : cpWER moyen de 15,80 % sur les ensembles multi-locuteurs, devant le pipeline DiCoW plus DiariZen à 16,83 %
Compromis : il nécessite un gros GPU (un H100 80 Go en BF16, ou une RTX 5090 avec des poids NVFP4), il ne fonctionne pas en streaming, et la réponse aux questions audio n’est disponible qu’en anglais.
Choisissez-le pour : les réunions, les podcasts, les appels de résultats, les archives multilingues et tout usage où les étiquettes de locuteur ou les fichiers d’une heure comptent. Commencez par les options gratuites ou exécutez-le localement.
2. Qwen3-ASR-1.7B : meilleure précision par dollar de GPU
WER 5,40 %, RTFx 819
Qwen3-ASR-1.7B d’Alibaba n’est qu’à 0,07 point derrière Nemotron sur la moyenne anglaise, tout en étant environ 1,8 fois plus rapide sur le matériel du classement, à partir d’un modèle vingt fois plus petit en taille totale. Dans la propre comparaison multilingue à sept langues de NVIDIA, Nemotron mène plus nettement : WER moyen de 4,62 % contre 6,49 %.
Choisissez-le pour : la transcription par lots à dominante anglaise sur des GPU plus petits, lorsque vous n’avez pas besoin d’attribution des locuteurs intégrée. Si vous utilisez déjà les modèles multimodaux de Qwen, consultez notre guide sur Qwen3.5-Omni.
3. IBM Granite Speech 5.0 2B : meilleur sur l’audio de réunion pour sa taille
WER 5,68 %, RTFx 545
Granite Speech 5.0 d’IBM affiche un WER de 6,96 % sur les enregistrements de réunions AMI, le meilleur score AMI parmi les six meilleurs modèles ouverts ici et meilleur que les 7,78 % de Nemotron sur ce jeu. Son point faible est SPGISpeech, les appels financiers, à 3,36 %.
Choisissez-le pour : les équipes d’entreprise qui standardisent sur la pile Granite d’IBM, et la transcription de réunions sur des GPU de milieu de gamme.
4. Cohere Transcribe : rapide et précis
WER 5,77 %, RTFx 902
Le modèle de transcription de mars 2026 de Cohere Labs associe un score de précision ouvert parmi les cinq meilleurs à l’une des vitesses les plus élevées de cette liste. Il est plus performant sur LibriSpeech (0,97 % clean, 2,05 % other) et plus faible sur VoxPopuli à 5,38 %.
Choisissez-le pour : les pipelines anglais à gros volume où le débit compte autant que la précision.
5. TheStage AI Whisper large-v3 turbo : le plus rapide du haut du classement
WER 5,91 %, RTFx 1 177
Il s’agit d’une version optimisée de Whisper large-v3 turbo par TheStage AI, et c’est le modèle le plus rapide de notre liste. Il obtient 1,62 % sur SPGISpeech, le troisième meilleur score sur cet ensemble parmi les 61 modèles. Cela montre à quel point la famille Whisper a encore de la vie lorsqu’on l’optimise.
Choisissez-le pour : les équipes disposant de code Whisper existant qui veulent une amélioration de vitesse et de précision sans changer leurs intégrations.
6. NVIDIA Canary-Qwen 2.5B : l’ancien fleuron de NVIDIA
WER 5,94 %, RTFx 862
Canary-Qwen était le précédent modèle parole-plus-LLM de NVIDIA, et Nemotron 3.5 Transcribe le remplace au sommet. Il reste rapide, et son score de 1,70 % sur SPGISpeech est excellent. Sur le test preference-ASR de NVIDIA, Nemotron obtient 7,56 % contre 8,16 % pour Canary-Qwen.
Choisissez-le pour : les déploiements NeMo existants qui ne peuvent pas encore passer à un GPU de 80 Go.
7. NVIDIA Parakeet TDT 0.6B : la plus petite option sérieuse
WER de 5,98 % à 6,18 % selon les versions
Parakeet TDT a plusieurs versions de 0,6 B de paramètres dans le classement, toutes à environ 0,2 point les unes des autres. Avec 600 M de paramètres, c’est le plus petit modèle ici qui reste proche de 6 % de WER, ce qui lui permet de tourner sur des GPU modestes. Sa faiblesse est l’audio de format long, où Nemotron le dépasse de plus de deux points.
Choisissez-le pour : les appareils en périphérie, les GPU bon marché et les clips courts comme les commandes vocales ou des extraits d’appels.
8. Mistral Voxtral Small 24B : parole plus un LLM performant
WER 6,38 %
Voxtral Small associe une entrée vocale à un modèle de langage Mistral de 24 B, donc comme Nemotron, il peut répondre à des questions sur l’audio, pas seulement le transcrire. Il est en retrait par rapport aux cinq premiers sur le WER pur. Notre comparatif Voxtral vs Whisper couvre en détail sa version précédente.
Choisissez-le pour : les assistants vocaux et les questions-réponses audio où le modèle de langage compte plus que le dernier point de WER.
9. OpenAI Whisper large-v3 : la référence de base
WER 7,16 %, 41e au classement global
Whisper large-v3 est encore le modèle ouvert le plus largement déployé, avec le plus grand écosystème de wrappers, de fine-tunes et de tutoriels. En termes de précision, il est désormais derrière tous les autres modèles de cette liste. Si vous l’utilisez en production, passer à l’un des six premiers est l’amélioration de qualité la moins coûteuse disponible.
Choisissez-le pour : les prototypes qui dépendent d’outils spécifiques à Whisper, ou comme référence à dépasser.
Lequel choisir ?
| Votre tâche | Choisissez |
|---|---|
| Réunions avec plusieurs locuteurs | Nemotron 3.5 Transcribe |
| Podcasts ou appels d’une heure en une seule passe | Nemotron 3.5 Transcribe |
| Archives multilingues | Nemotron 3.5 Transcribe |
| Tâches par lots en anglais sur des GPU plus petits | Qwen3-ASR-1.7B |
| Débit maximal | TheStage Whisper large-v3 turbo ou Cohere Transcribe |
| Matériel edge ou à faible coût | Parakeet TDT 0.6B |
| Questions-réponses audio plus transcription | Nemotron 3.5 Transcribe ou Voxtral Small |
| Code Whisper existant, changement minimal | TheStage Whisper large-v3 turbo |
Une mise en garde : les moyennes du classement masquent les écarts entre domaines. Nemotron est le meilleur globalement, mais Granite le bat sur AMI et plusieurs modèles le battent sur LibriSpeech. Testez les deux ou trois premiers sur 50 à 100 de vos propres enregistrements avant de vous engager.
Évaluez les candidats avec votre agent de codage et Apidog CLI
La façon la plus rapide de mener ce comparatif est de laisser votre agent de codage s’en charger. Servez deux ou trois modèles derrière des endpoints /v1/audio/transcriptions de style OpenAI (SGLang-Omni sert Nemotron de cette manière), puis demandez à l’agent de construire et d’exécuter les mêmes vérifications sur chacun avec Apidog CLI.
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Ensuite, donnez un seul prompt à votre agent :
In Apidog project <id>, create one environment per speech server (nemotron, qwen3-asr,
whisper) with its baseUrl. Create test cases that POST each file in samples/ to
{{baseUrl}}/v1/audio/transcriptions, assert status 200 and non-empty text, and save the
transcript to a variable. Run the cases against each environment and give me a table
of failures and response times per server.
L’agent lit le schéma, valide sa charge utile, écrit les cas et les exécute par environnement :
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
Évaluez les transcriptions enregistrées par rapport à votre texte de référence avec n’importe quel script WER, et conservez l’exécution de l’environnement gagnant dans la CI avec -r junit. Voir Apidog CLI dans Claude Code et Apidog CLI dans un pipeline CI/CD.
FAQ
Quel est le modèle open source de transcription vocale le plus précis ? NVIDIA Nemotron 3.5 Transcribe, avec un WER moyen de 5,33 % dans le classement Open ASR du 28 octobre 2026.
Whisper est-il encore bon ? Il fonctionne, mais whisper-large-v3 se classe 41e avec 7,16 %. Les versions optimisées de Whisper comme large-v3 turbo de TheStage obtiennent 5,91 %.
Quel modèle ouvert est le plus rapide ? Parmi les modèles présentés ici, Whisper large-v3 turbo de TheStage AI, avec un RTFx de 1 177.
Les modèles ouverts surpassent-ils désormais les API payantes ? Certains. Nemotron 3.5 Transcribe surpasse AssemblyAI Universal-3.5 Pro (5,39 %) et OpenAI gpt-transcribe (5,96 %). Otter, Zoom et ElevenLabs restent globalement en tête. Pour les options hébergées, consultez notre sélection d’API de transcription vocale.
Lequel prend en charge la diarisation des locuteurs ? Nemotron 3.5 Transcribe le fait dans le même modèle, avec jusqu’à huit locuteurs. La plupart des autres nécessitent une étape de diarisation séparée.
Le verdict
Pour la plupart des équipes fin 2026, commencez par Nemotron 3.5 Transcribe si vous disposez d’un GPU de 80 Go ou si vous pouvez payer 0,12 $ de l’heure sur une API hébergée. Choisissez Qwen3-ASR-1.7B lorsque le budget GPU est serré, et Parakeet lorsque le matériel l’est encore plus. Quel que soit votre choix, testez-le sur votre propre audio et laissez votre agent maintenir les vérifications Apidog pour que le modèle choisi reste performant après chaque mise à niveau.