
Le meilleur LLM pour les agents de navigateur en octobre 2026 est Claude Opus 5.5 si vous voulez le taux de réussite publié le plus élevé, et Claude Sonnet 5.5 si vous voulez quasiment le même score à moitié prix. Pour les budgets serrés, Claude Haiku 5.5 et Gemini 3.8 Flash coûtent une fraction par étape. Pour les poids ouverts, Holo4 de H Company est le choix. Chaque chiffre ci-dessous provient de la page du fournisseur lui-même, consultée le 27 octobre 2026.
Réponse rapide : le meilleur modèle pour l'usage navigateur par tâche
| Tâche | Choix | Pourquoi | Prix pour 1 M de tokens (entrée / sortie) |
|---|---|---|---|
| Meilleur score | Claude Opus 5.5 | 81,8 % sur OSWorld 2.1 (score partiel), ensemble d'outils navigateur natif | 4 $ / 20 $ |
| Meilleur rapport qualité-prix | Claude Sonnet 5.5 | 80,1 % sur OSWorld 2.1 à la moitié du prix d'Opus | 2 $ / 10 $ |
| Meilleur choix économique | Claude Haiku 5.5 | 72,4 % sur le sous-ensemble hors ligne d'OSWorld 2.1 | 0,10 $ / 0,50 $ (prompts jusqu'à 100K) |
| Meilleur à poids ouverts | Holo4 35B-A3B | Poids Apache 2.0, 80,8 % sur OSWorld à 0,05 $ par tâche (harnais de H) | 0,30 $ / 2,00 $ sur l'API de H |
| Meilleur pour la navigation pilotée par code | GPT-6 Astra | OpenAI recommande l'exécution de code (Playwright) plutôt que le clic | 10 $ / 50 $ |
| Meilleur mode DOM économique | GPT-6.1 Terra | Prend en charge computer_use, contexte de 1,05 M, entrée texte et image |
1 $ / 5 $ |
Un avertissement : les fournisseurs évaluent sur différentes versions d'OSWorld, sous-ensembles et harnais, donc considérez chaque chiffre comme l'affirmation de ce fournisseur, et non comme un classement commun.
Comment les agents de navigateur utilisent un modèle
Un agent de navigateur est une boucle : le modèle examine la page, choisit une action, votre code l'exécute, et le nouvel état de la page revient au modèle. Une tâche humaine de 2 minutes peut prendre 30 à 60 boucles.
Les modèles voient la page de l'une des deux manières suivantes :
- Mode capture d'écran. Le modèle reçoit une image et renvoie des coordonnées de pixels à cliquer. Cela fonctionne sur les applications canvas, les cartes et les bureaux à distance, mais chaque étape coûte des tokens d'image.
- Mode DOM ou arbre d'accessibilité. Le modèle reçoit une liste textuelle d'éléments avec des références comme
[ref_2]et clique par référence. Il résiste aux changements de mise en page et coûte moins de tokens sur les pages riches en texte.
La plupart des ensembles d'outils actuels mélangent les deux. L'outil d'utilisation du navigateur d'Anthropic (browser_toolset_20260801, GA) fournit 31 outils membres : read_page et find renvoient l'arbre d'accessibilité, tandis que screenshot et zoom sont la solution de repli pour le canvas, la vidéo et les iframes d'origine croisée. Le guide d'utilisation de l'ordinateur d'OpenAI propose un BrowserToolset qui lit le texte de la page et appelle des fonctions de pilote. L'outil d'utilisation de l'ordinateur de Google est basé sur des captures d'écran et couvre le navigateur, le mobile et le bureau.
Pourquoi les étapes multiplient le coût
Chaque étape renvoie toute la conversation, donc l'étape 30 transporte la définition de l'ensemble d'outils, vos instructions et 29 étapes d'historique. Deux coûts fixes établissent le plancher :
- Surcoût de l'ensemble d'outils. Déclarer l'ensemble d'outils navigateur d'Anthropic ajoute environ 6 600 tokens d'entrée à chaque requête, selon la page de tarification d'Anthropic.
- Captures d'écran. Claude facture une image à raison d'un token visuel par zone de 28×28 pixels. Une capture d'écran de 1280×800 correspond à 46 × 29 = 1 334 tokens.
Notes modèle par modèle
Claude Opus 5.5
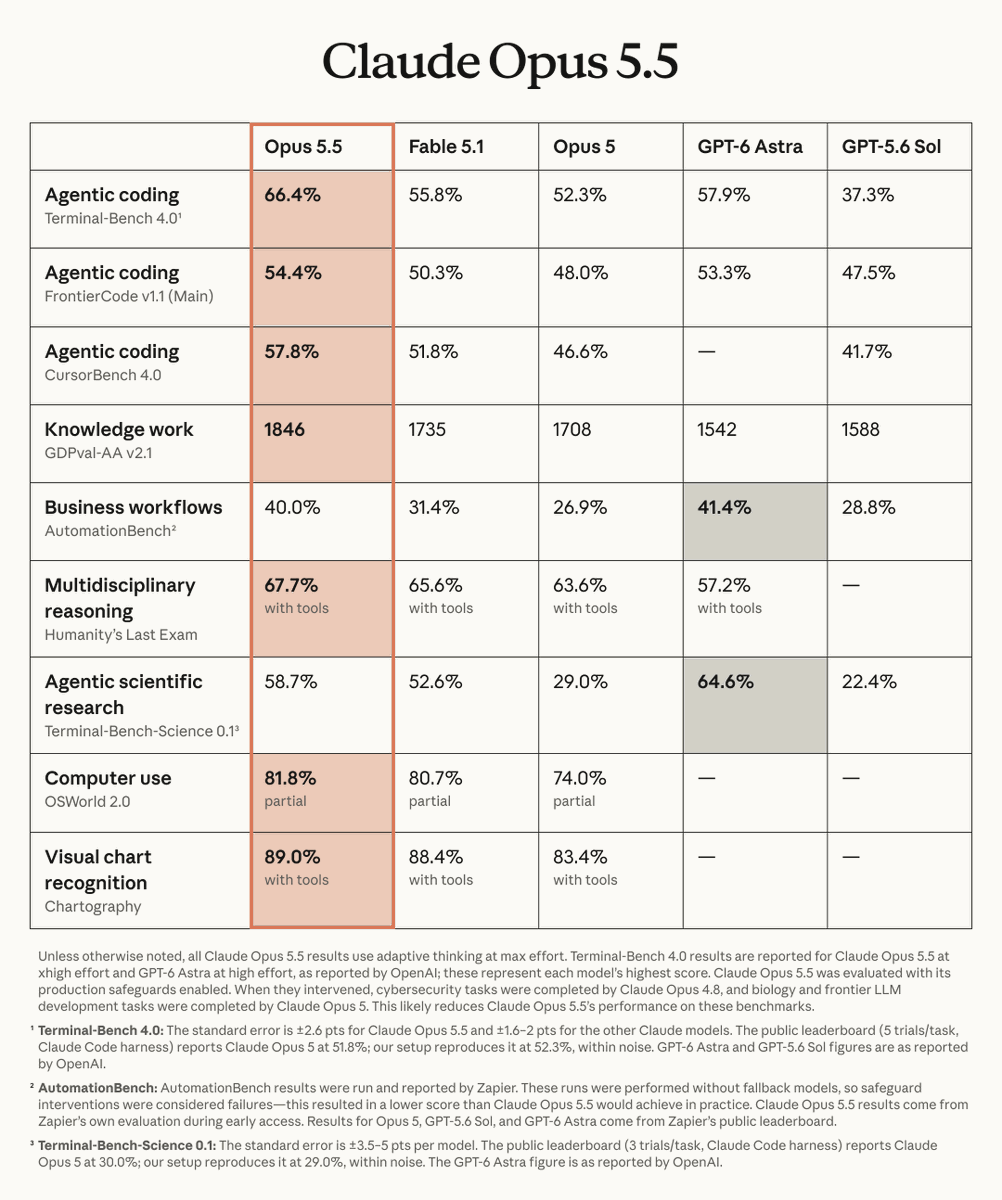
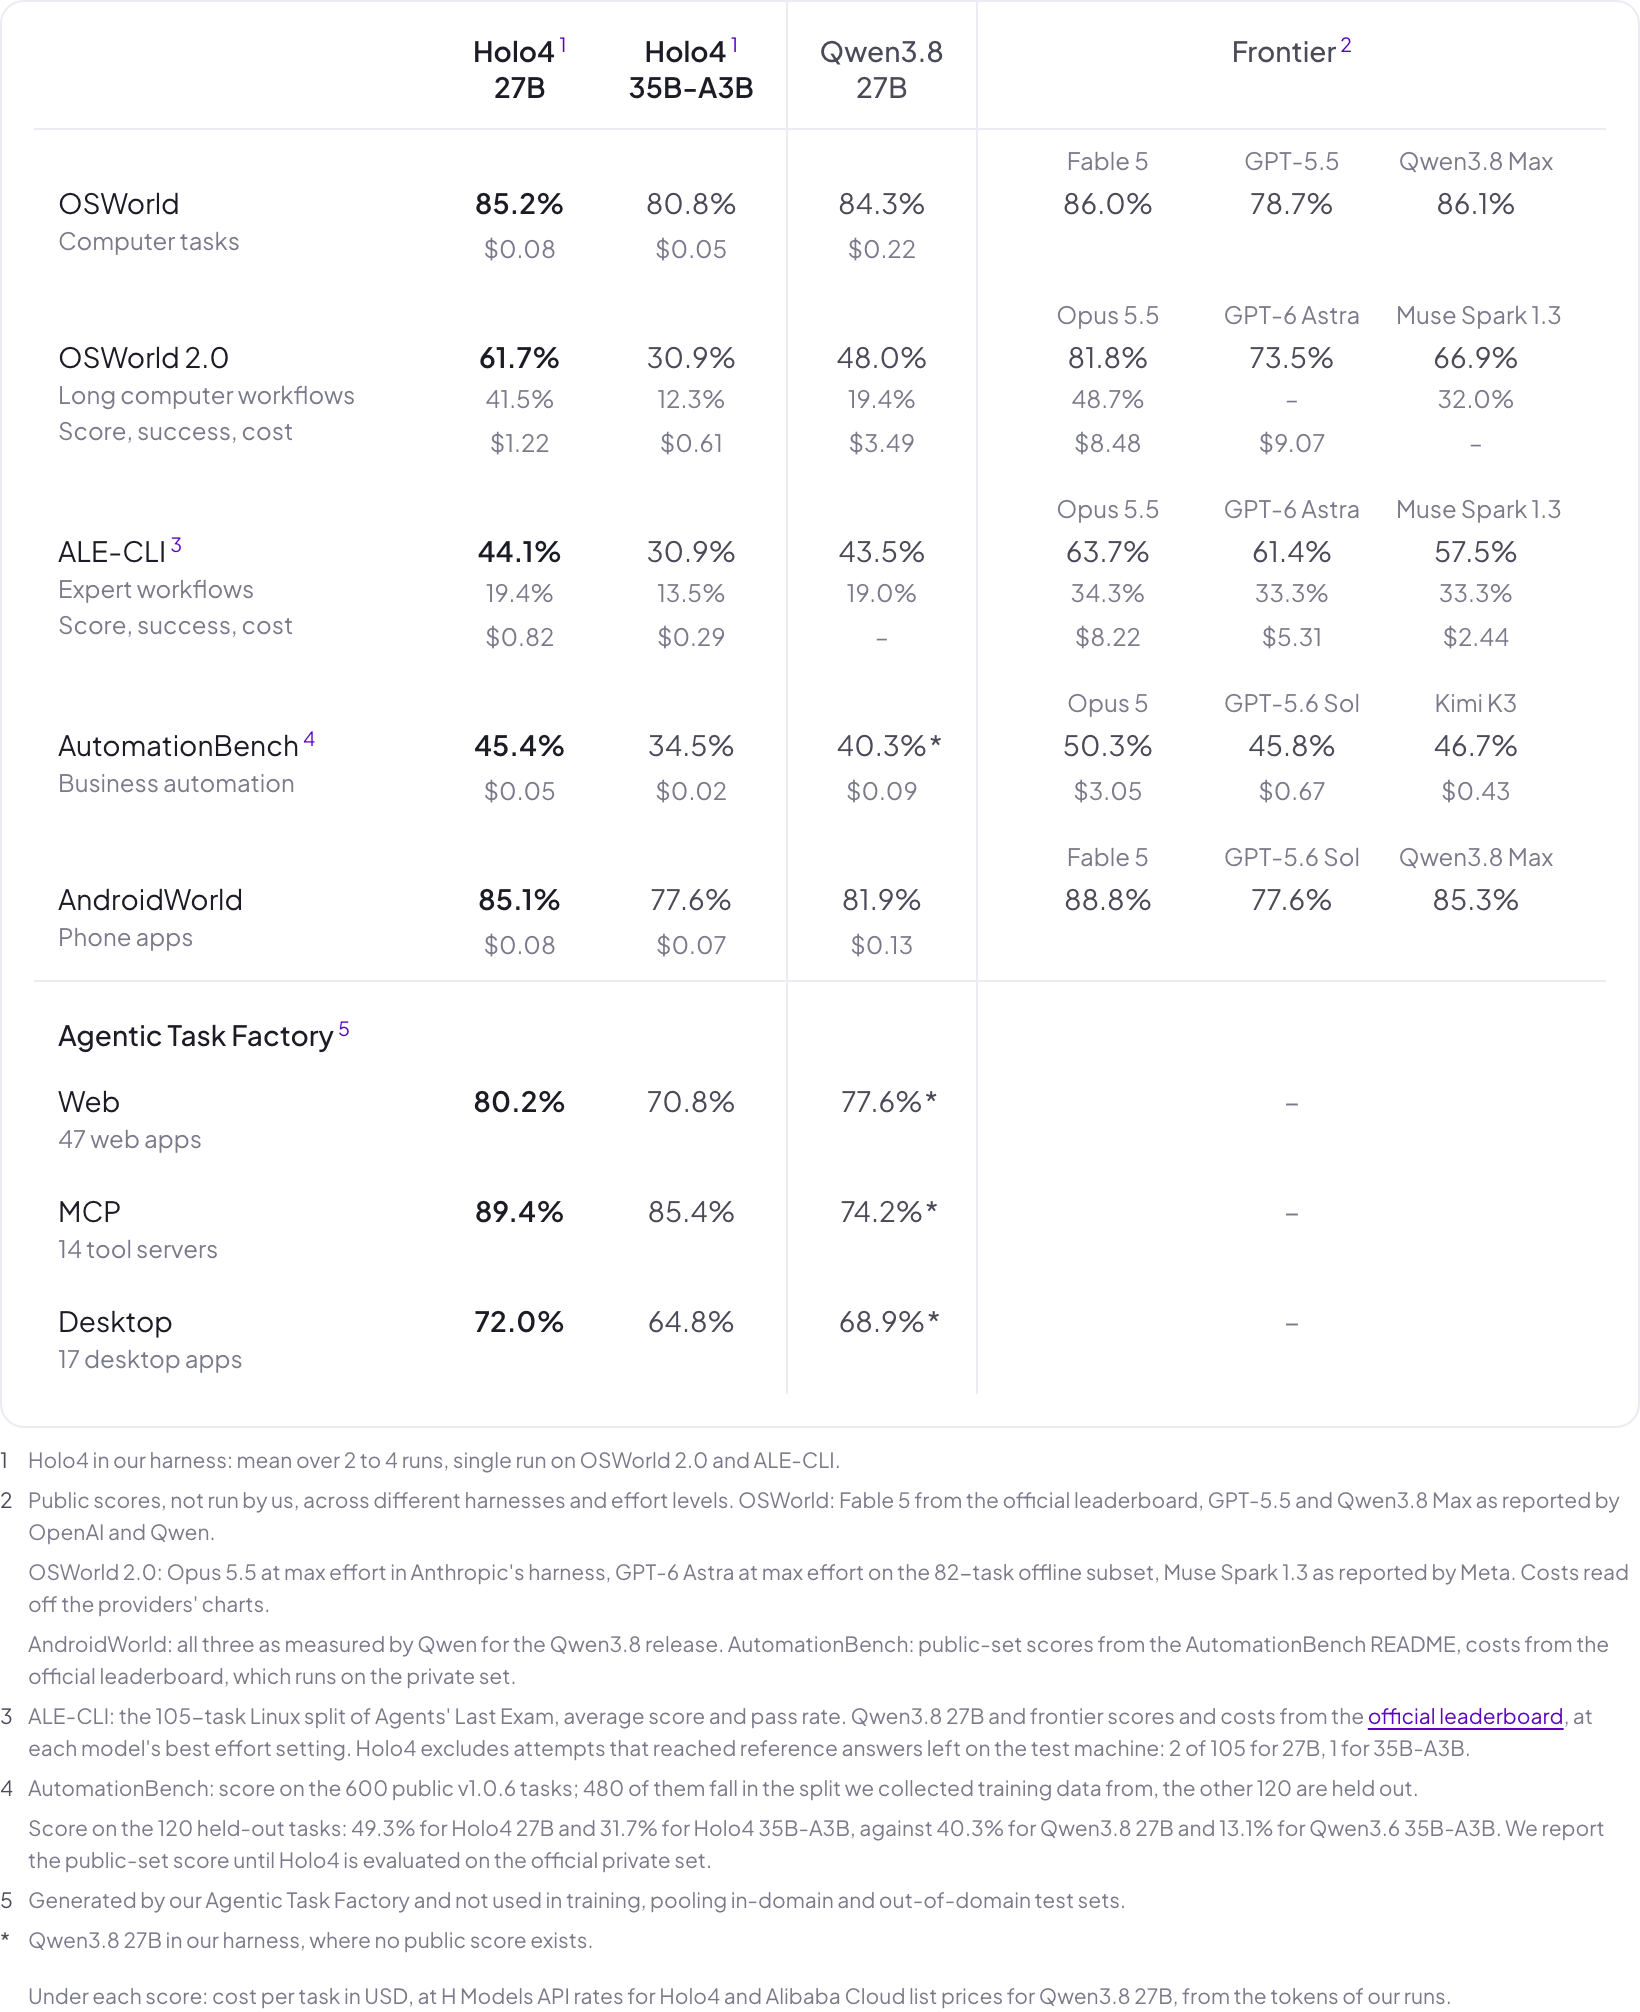
Anthropic a publié Opus 5.5 le 22 septembre 2026 et annonce 81,8 % sur OSWorld 2.1 (score partiel), devant Claude Fable 5.1 à 80,7 %. Fable 5.1 coûte 10 $ / 50 $, donc Opus 5.5 le dépasse sur ce benchmark à 40 % du prix. Le billet de H Company sur Holo4 place Opus 5.5 à 81,8 % sur les longs flux de travail d'OSWorld 2.0 à 8,48 $ par tâche, les coûts étant lus sur les graphiques des fournisseurs.
Il égale également Fable 5.1 pour le taux de réussite d'injection de prompt le plus bas sur le benchmark de Gray Swan, ce qui compte lorsque votre agent lit des pages non fiables.
Claude Sonnet 5.5
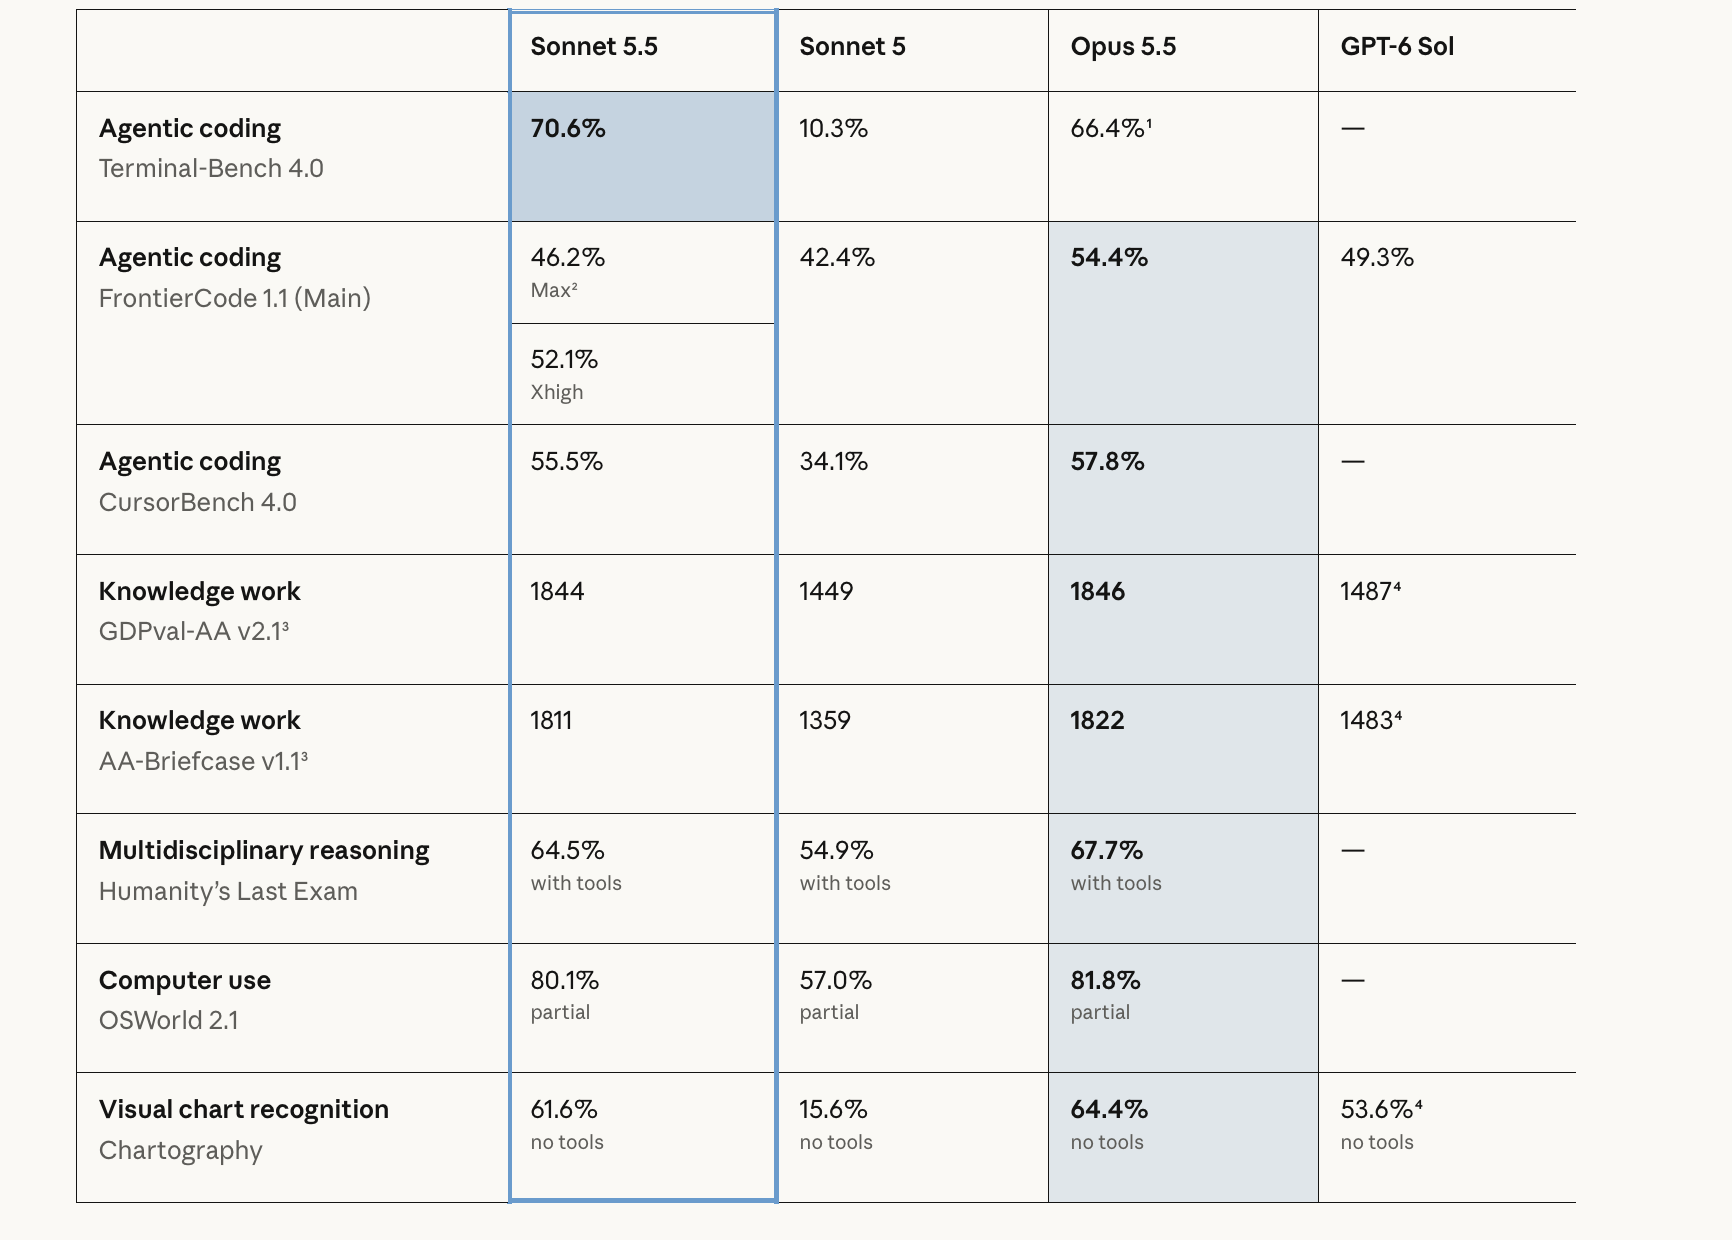
Sonnet 5.5 (28 septembre 2026) obtient 80,1 % sur OSWorld 2.1, soit 1,7 point derrière Opus, à 2 $ / 10 $. Les lectures en cache coûtent 0,10 $ par million de tokens, et les boucles d'agent sont principalement des lectures en cache. Pour la plupart des agents de navigateur en production, c'est le choix par défaut. Si vous pilotez le navigateur depuis Claude Code, consultez comment utiliser Claude Code pour l'automatisation du navigateur.
Claude Haiku 5.5
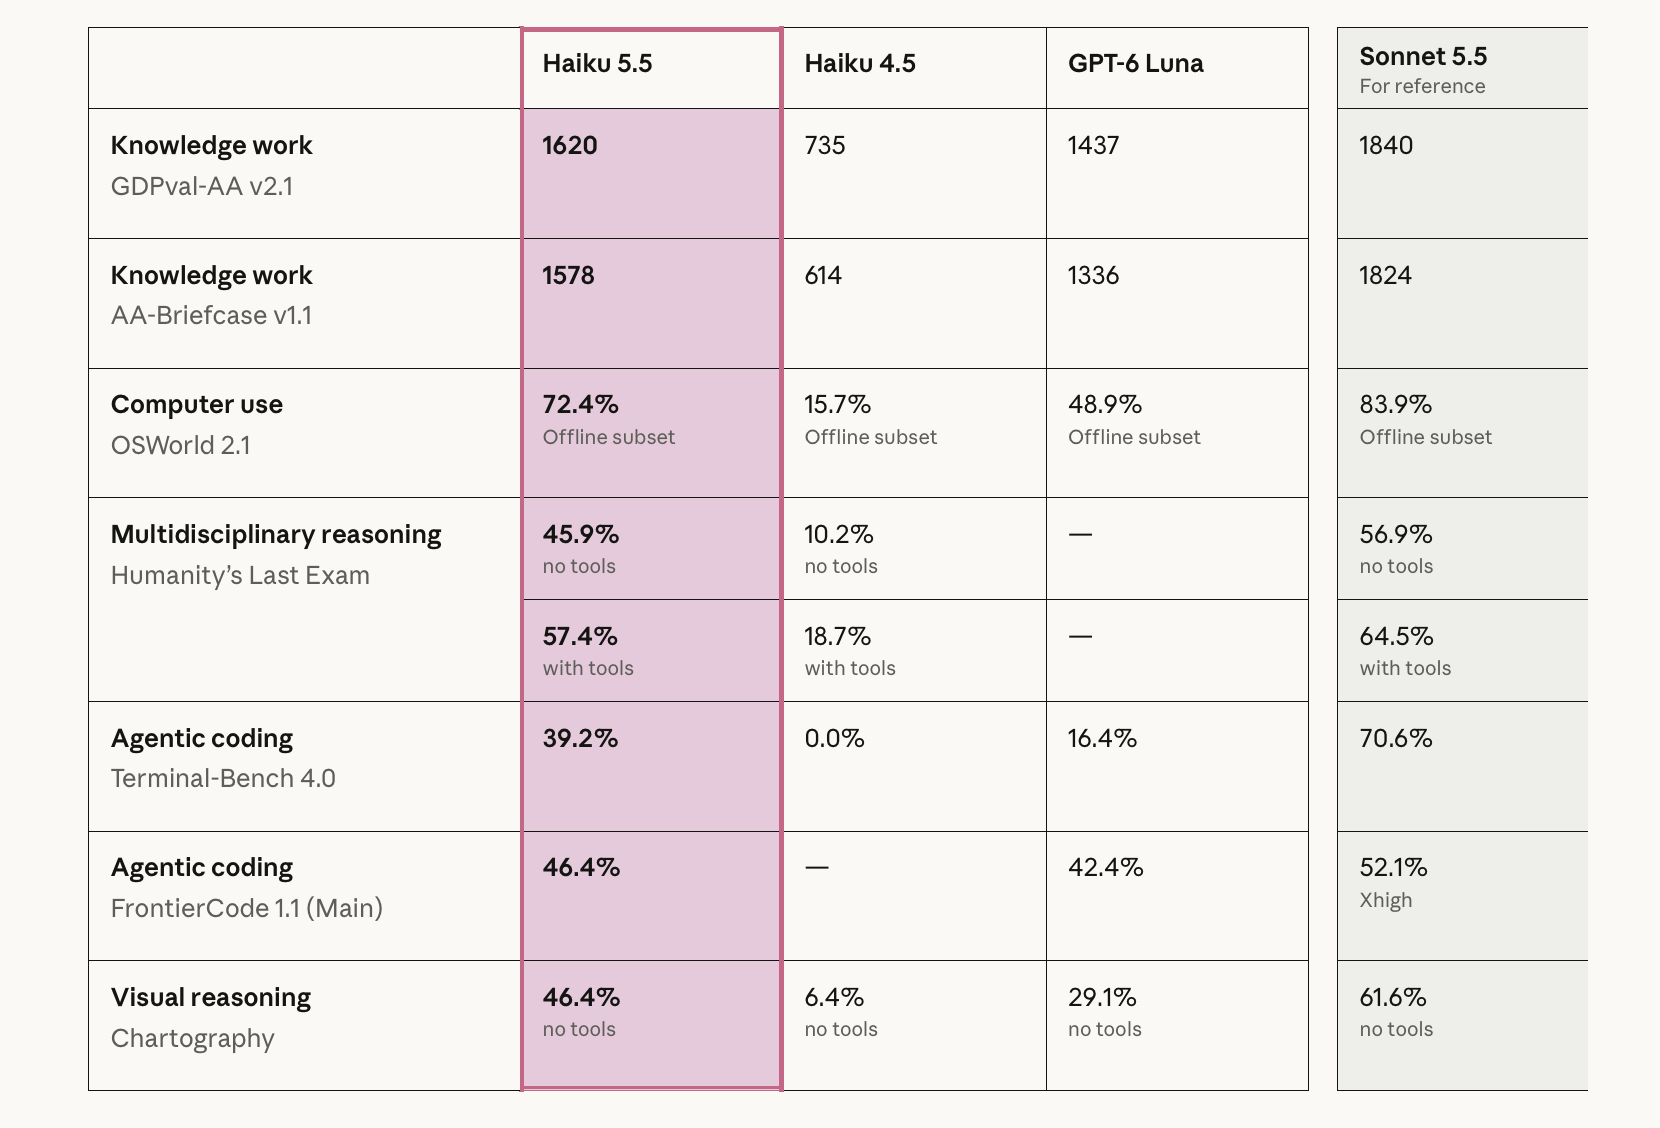
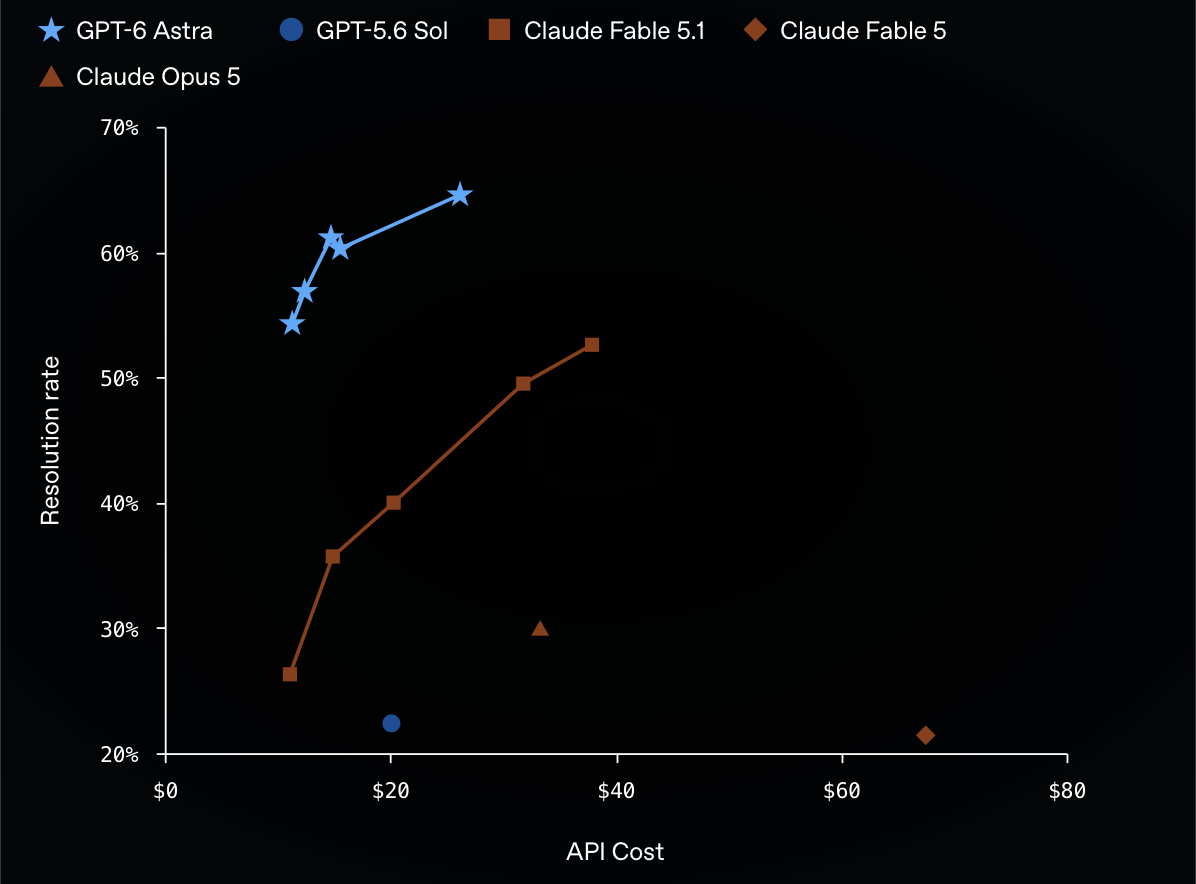
Haiku 5.5 (7 octobre 2026) obtient 72,4 % sur le sous-ensemble hors ligne d'OSWorld 2.1, où Anthropic liste GPT-6 Luna à 48,9 %. La tarification est à deux niveaux : 0,10 $ / 0,50 $ pour les prompts jusqu'à 100 000 tokens, puis 0,50 $ / 2,50 $ au-delà. Les longues sessions qui conservent chaque capture d'écran dans l'historique dépassent rapidement les 100K, donc élaguez les anciennes captures d'écran pour rester dans le niveau économique.
GPT-6 Astra
La fiche modèle de Gemini 4 Argon de Google liste GPT-6 Astra à 72,6 % sur le sous-ensemble hors ligne d'OSWorld 2.0 (score partiel). Astra coûte 10 $ / 50 $ avec une fenêtre de contexte de 1,05 M. Le guide d'OpenAI indique que pour Astra, il recommande l'exécution de code : le modèle écrit du code Playwright ou PyAutoGUI au lieu de cliquer étape par étape. Cela convient au scraping répétitif et au travail sur formulaires. Notre article sur l'utilisation de l'ordinateur par GPT-6 Astra explique quand lui confier plutôt une spécification.
GPT-6.1 Terra et Sol
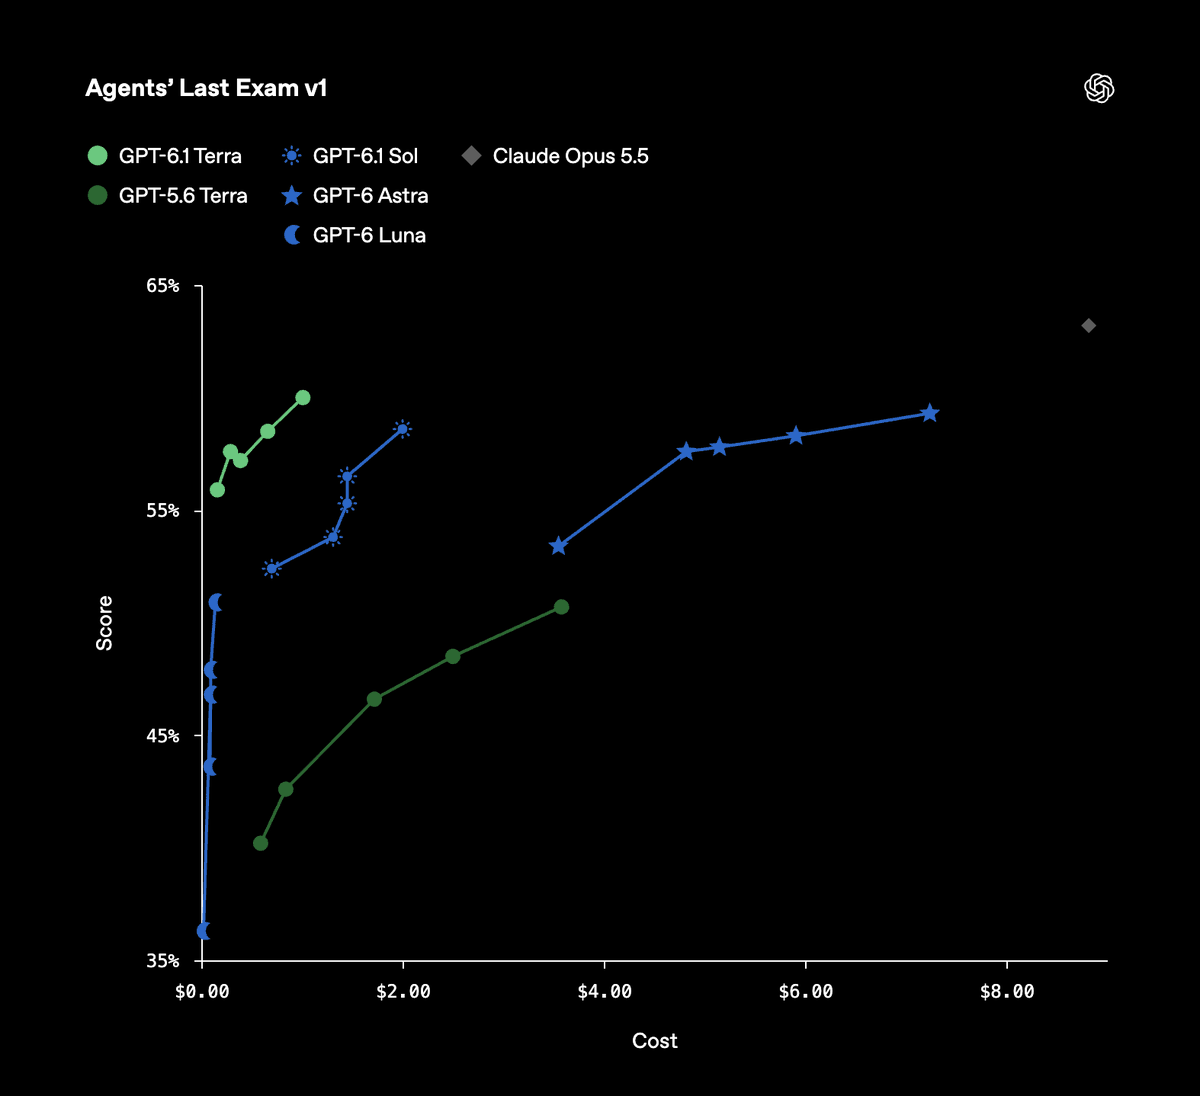
La page des modèles d'OpenAI liste computer_use comme outil pris en charge pour GPT-6.1 Terra (1 $ / 5 $, entrée en cache 0,05 $) et les exemples du guide d'utilisation de l'ordinateur utilisent GPT-6.1 Sol (2 $ / 10 $). OpenAI ne publie aucun score de navigateur ou OSWorld pour l'un ou l'autre sur ces pages. Terra est une valeur sûre pour le mode DOM, mais évaluez-le sur vos propres tâches.
Gemini 4 Argon et Gemini 3.8 Flash
Gemini 4 Argon est passé en GA le 13 octobre 2026. Sa fiche modèle indique 69,2 % sur le sous-ensemble hors ligne d'OSWorld 2.0 et 39,5 % sur Agent's Last Exam (utilisation de l'ordinateur), au-dessus des 34,2 % d'Astra et des 38,2 % d'Opus 5.5. L'utilisation de l'ordinateur sur Argon est encore en Preview. La tarification est de 2 $ / 10 $ jusqu'au 30 novembre 2026, puis de 4 $ / 20 $.
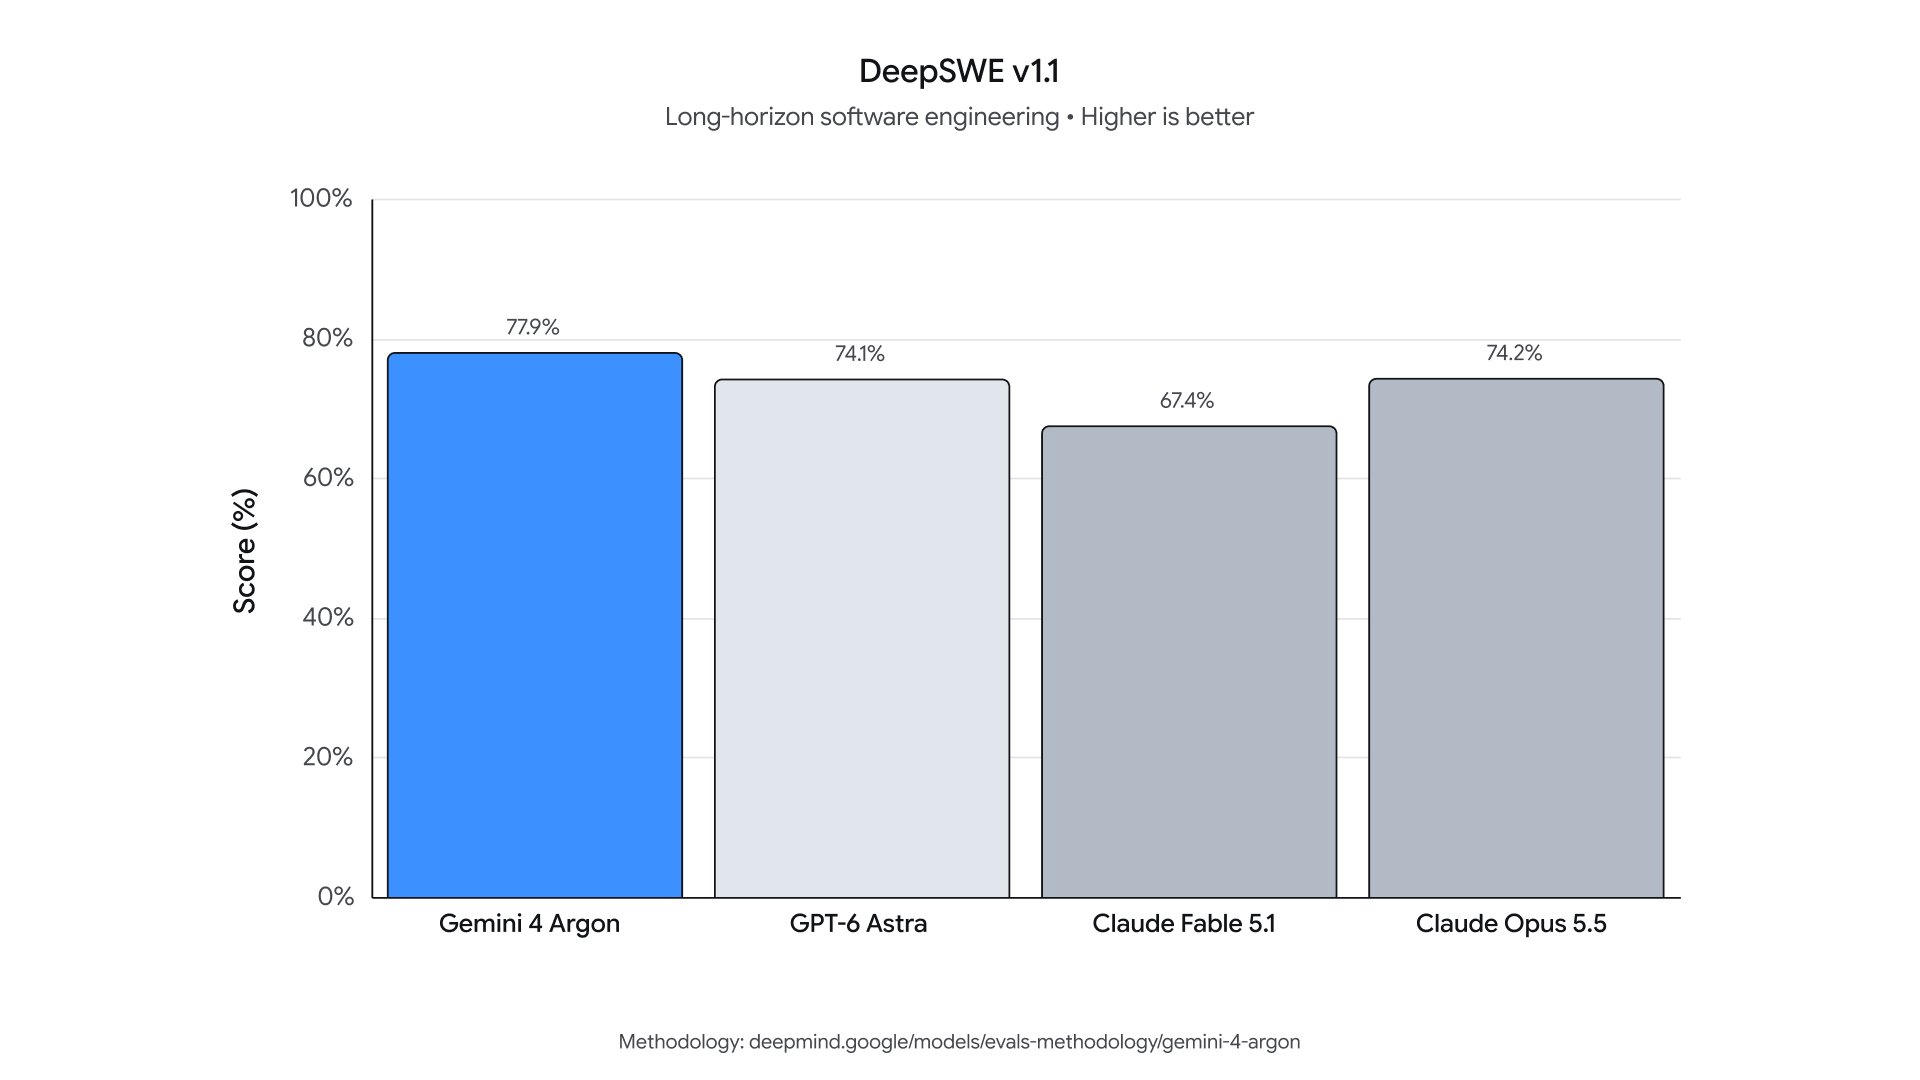
La page d'utilisation de l'ordinateur de Google recommande gemini-3.8-flash (0,75 $ / 3,75 $ jusqu'au 31 décembre 2026) mais ne fournit aucun benchmark pour ce modèle. Gemini 2.5 Computer Use n'apparaît plus sur cette page, nous l'avons donc retiré.
Holo4 (poids ouverts)
H Company a publié Holo4 le 28 septembre 2026, en remplacement de Holo3. Sur son propre harnais, Holo4 27B obtient 85,2 % sur OSWorld à 0,08 $ par tâche et 61,7 % sur les longs flux de travail d'OSWorld 2.0 à 1,22 $ par tâche. Le 35B-A3B obtient 80,8 % et 30,9 % sur les deux mêmes, à 0,05 $ et 0,61 $. H indique que les poids du 35B-A3B sont sous Apache 2.0 ; vérifiez la licence du 27B sur sa fiche modèle avant de le livrer commercialement. Les deux tournent sur l'API de H à 0,40 $ / 3,00 $ (27B) et 0,30 $ / 2,00 $ (35B-A3B). Notre article sur Holo3 couvre l'API de la génération précédente.
Kimi K3.1 Pro, DeepSeek V4.1 Flash et Qwen 3.7 Plus
- Kimi K3.1 Pro accepte les images et la vidéo avec un contexte de 1 M, selon le démarrage rapide de Moonshot. Son score BrowseComp de lancement mesure la recherche web, pas le fait de cliquer à travers les pages, et aucun score d'utilisation de l'ordinateur n'est publié. Vérifiez le prix sur la page de tarification de Kimi.
- DeepSeek V4.1 Flash (
deepseek-flash) prend désormais en charge l'entrée d'images à 0,15 $ / 0,60 $ en heures creuses et 0,30 $ / 1,20 $ en heures pleines, selon la page de tarification de DeepSeek. Aucun benchmark de navigateur n'est publié. C'est l'option la moins chère ici pour le mode DOM. - Qwen 3.7 Plus rapporte 79,0 sur ScreenSpot Pro, un test d'ancrage sur capture d'écran. Consultez notre guide de l'agent d'utilisation de l'ordinateur Qwen 3.7 Plus.
Ce que mesurent les équipes des frameworks
Le guide des modèles de Browser Use (BU Bench V1, mis à jour le 11 juin 2026) montre le côté vitesse : Claude Fable 5 a atteint 80,0 % mais a mis en moyenne 6 minutes 53 secondes et environ 5,80 $ par tâche. Les modèles 5.5 n'y figurent pas encore. Pour le choix du framework lui-même, consultez Browser Use Cloud, Stagehand et le serveur MCP Puppeteer.
Coût par tâche : un exemple concret
Supposons une tâche de 30 étapes sur Claude avec l'ensemble d'outils navigateur. Chaque étape ajoute une capture d'écran de 1 334 tokens plus environ 450 tokens de texte d'action et de résultats d'outils, et le modèle écrit environ 300 tokens de sortie.
- Entrée de l'étape n ≈ 6 600 + n × 1 784 tokens
- Entrée totale sur 30 étapes ≈ 198 000 + 1 784 × 465 ≈ 1,03 M tokens
- Sortie totale ≈ 9 000 tokens
| Modèle | Sans mise en cache | Avec mise en cache des prompts (environ 95 % de lectures en cache) |
|---|---|---|
| Claude Opus 5.5 | environ 4,30 $ | environ 0,68 $ |
| Claude Sonnet 5.5 | environ 2,15 $ | environ 0,34 $ |
| Claude Haiku 5.5 | environ 0,11 $ | environ 0,02 $ |
Ce sont des chiffres illustratifs issus des prix catalogue d'Anthropic, et non des exécutions mesurées. Deux conclusions tiennent quand même : la mise en cache réduit la facture de plus de 80 %, et supprimer les anciennes captures d'écran de l'historique permet d'économiser plus que de passer à un modèle moins cher.
Comment choisir
- Commencez par Sonnet 5.5. Il obtient un score à moins de 2 points du leader à moitié prix.
- Passez à Opus 5.5 uniquement si votre taux de réussite sur des tâches réelles est le goulot d'étranglement.
- Redescendez vers Haiku 5.5 ou Gemini 3.8 Flash pour les flux courts, répétitifs et à fort volume. Mesurez d'abord.
- Utilisez Holo4 si les données ne peuvent pas quitter votre infrastructure.
- Utilisez GPT-6 Astra avec exécution de code lorsque la tâche est un script répétable, et non de l'exploration.
- Évitez complètement le navigateur lorsque le site dispose d'une API. Un appel d'API est une seule requête au lieu de 30 étapes. Notre comparaison entre utilisation de l'ordinateur et API structurées montre quand chacune gagne, et la liste des outils d'automatisation du navigateur couvre le reste.
Laissez plutôt votre agent de codage tester l'API avec Apidog CLI
Les agents de navigateur sont le chemin lent et coûteux. Lorsque la page sur laquelle votre agent clique sans cesse est adossée à une API JSON, la solution la moins chère est de trouver cette API une fois et de la tester directement. L'ensemble d'outils navigateur de Claude dispose même d'un membre optionnel read_network qui liste les requêtes effectuées par une page.
Laissez votre agent de codage le faire avec Apidog CLI. Configurez-le une fois :
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
Donnez ensuite un prompt à votre agent :
Export a HAR of the checkout flow you just ran in the browser. Import it into
Apidog project <id>, create a test case for POST /api/cart/items that asserts
a 200 status and a numeric cartTotal, then run it against the staging
environment and summarize any failures.
L'agent importe le trafic, lit le schéma de la charge utile, le valide, écrit le cas de test et l'exécute :
apidog import --project <id> --format har --file checkout.har
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
Remplacez -r cli,json par -r junit et la même commande s'exécute dans la CI ; consultez le guide Pipeline CI/CD avec Apidog CLI. Si Claude Code est votre agent, Apidog CLI dans Claude Code détaille la configuration. Le plan gratuit d'Apidog couvre jusqu'à 4 utilisateurs.
FAQ
Quel est le meilleur LLM pour les agents de navigateur actuellement ? Claude Opus 5.5 a le score OSWorld 2.1 le plus élevé rapporté par un fournisseur (81,8 %). Claude Sonnet 5.5 est le meilleur choix par défaut pour la plupart des équipes à 80,1 % et à moitié prix.
Quel modèle est le meilleur pour l'utilisation de l'ordinateur avec un budget limité ? Claude Haiku 5.5 à 0,10 $ / 0,50 $ obtient 72,4 % sur le sous-ensemble hors ligne d'OSWorld 2.1 d'Anthropic. Gardez les prompts sous 100 000 tokens pour rester dans son niveau économique.
Existe-t-il un bon modèle à poids ouverts pour les agents de navigateur ? Oui. Holo4 35B-A3B est livré avec des poids Apache 2.0 et obtient 80,8 % sur OSWorld dans le harnais de H Company. Holo4 27B obtient un score plus élevé, mais vérifiez d'abord sa licence.
Mode capture d'écran ou mode DOM ? Utilisez l'arbre d'accessibilité ou le DOM lorsque la page en dispose. C'est moins cher et cela résiste aux changements de mise en page. Revenez aux captures d'écran pour le canvas, les cartes, la vidéo et les bureaux à distance.
Puis-je comparer les scores OSWorld entre fournisseurs ? Seulement de manière approximative. Les fournisseurs rapportent OSWorld 2.0, OSWorld 2.1, des sous-ensembles hors ligne et des scores partiels avec différents harnais. Exécutez vos propres 20 à 50 tâches réelles avant de vous engager.
Gemini 2.5 Computer Use est-il toujours disponible ? Il n'apparaît plus sur la page d'utilisation de l'ordinateur de Google depuis le 27 octobre 2026. Google liste à la place Gemini 4 Argon, Gemini 3.8 Flash, Gemini 3.5 Flash-Lite et Gemini 3 Flash Preview.