En bref : Les appels d'outils asynchrones pour les agents IA divisent un appel bloquant run() en un contrat simple : start() renvoie immédiatement un identifiant de tâche (handle), status() indique la progression, stop() annule l'opération, et le résultat revient plus tard sous la forme d'un événement que l'agent lit lors de son tour suivant. L'agent continue d'échanger et de recevoir de nouvelles instructions pendant que les tâches longues s'exécutent.
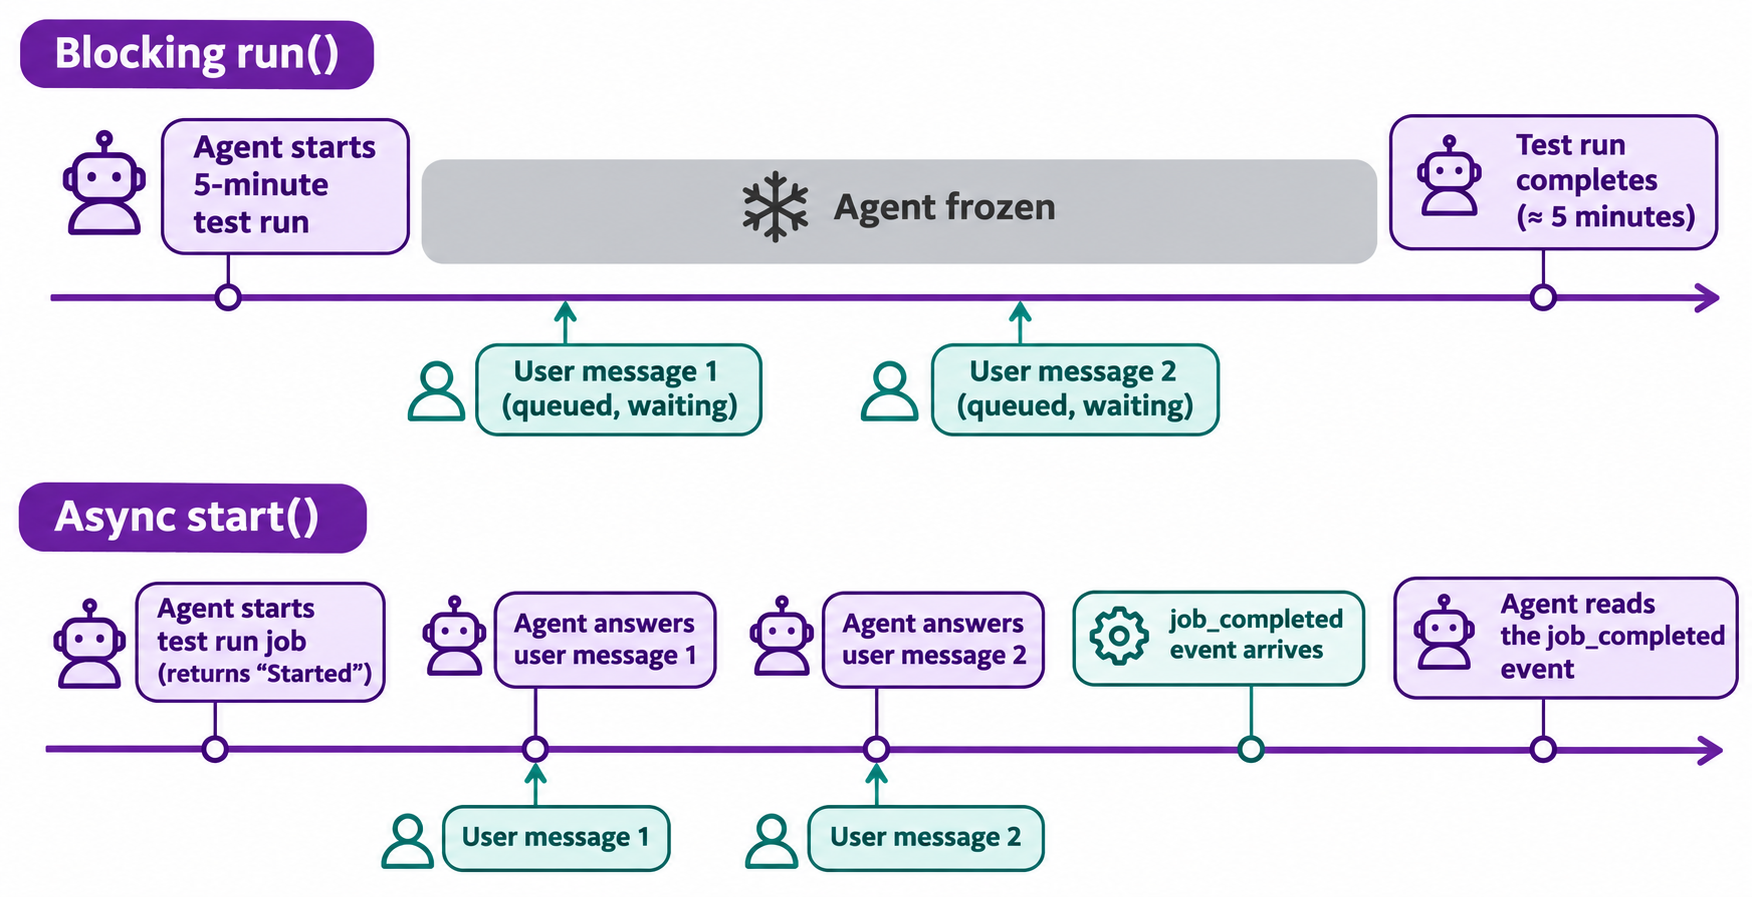
Aujourd'hui, la plupart des agents appellent un outil et attendent. Posez une deuxième question pendant l'exécution d'une suite de tests de 6 minutes, et elle reste bloquée dans une file d'attente. Cela ne pose aucun problème pour une requête de 200 ms, mais devient vite insupportable pour un déploiement ou du web scraping.
Un article récent de l'équipe DeepSeek Harness, « Exploring Super-agent Design », qualifie cette solution de « full-duplex » : remplacer l'appel bloquant run() par start() et stop(). Ce guide s'intéresse au fonctionnement côté boucle de l'agent : le contrat d'outil, la remontée des résultats, l'annulation et l'API requise par chaque outil. Pour les aspects HTTP liés à un appel lent unique, consultez AI Agents and Long-Running API Calls: Polling vs Webhooks.
Que sont les appels d'outils asynchrones dans une boucle d'agent ?
Un appel d'outil asynchrone est une invocation d'outil qui renvoie un identifiant (handle) plutôt qu'un résultat direct. La boucle de l'agent enregistre cet identifiant, termine son tour et reste disponible pour l'utilisateur. Une fois le traitement terminé, le runtime injecte un événement d'achèvement dans la conversation, et le modèle le lit lors de son tour suivant, exactement comme n'importe quel autre message.
Toute la différence réside dans l'entité qui attend : avec run(), le modèle attend ; avec start(), c'est le runtime qui s'en charge.
run() bloquant |
start() asynchrone |
|
|---|---|---|
| Ce qui est renvoyé | Résultat final | Job id, « Started » |
| Agent pendant l'exécution | Bloqué | Discute, planifie, lance d'autres tâches |
| Nouveau message utilisateur | Mis en file d'attente jusqu'au retour de l'outil | Traité immédiatement |
| Annulation | Interrompt tout le tour | stop(job_id) |
L'article de DeepSeek présente cette approche comme un choix d'architecture et non comme une option prête à l'emploi. Il indique que le mode full-duplex est implémenté dans DeepSeek Harness sans être activé par défaut, et que certains composants figurent dans un plugin prototype nommé dsh-superagent-prototype, dont les auteurs précisent qu'il ne s'agit pas d'un produit officiel de DeepSeek. Considérez-le comme un modèle de conception dont il faut s'inspirer. Pour plus de contexte, découvrez ce qu'est DeepSeek Harness ainsi que l'article complémentaire expliquant comment concevoir un super-agent.
Le problème du blocage : quand un seul outil lent paralyse l'agent
Imaginez un agent de programmation auquel on demande d'exécuter la suite de tests (5 minutes) tout en répondant à une question sur un import défaillant. Avec des appels bloquants, votre question attend derrière les tests, alors même qu'elle n'en dépend absolument pas. Trois problèmes majeurs se posent alors :
- La latence s'accumule. Chaque outil lent répercute l'intégralité de sa durée sur toutes les opérations suivantes.
- Les instructions deviennent obsolètes. Vous précisez au bout de deux minutes « finalement, ignore les tests e2e ». L'agent ne peut pas prendre en compte votre consigne avant la fin de l'exécution.
- Les délais d'expiration (timeouts) frappent. Les passerelles interrompent les connexions maintenues ouvertes pendant plusieurs minutes ; ainsi, un long
run()peut échouer alors même que la tâche sous-jacente a réussi.
L'article qualifie la propriété recherchée de « productive » : l'agent est capable d'accepter l'instruction suivante avant même que la précédente ne soit terminée. Les outils asynchrones sont précisément ce qui permet d'y parvenir.
start, status, stop : le contrat d'outil asynchrone
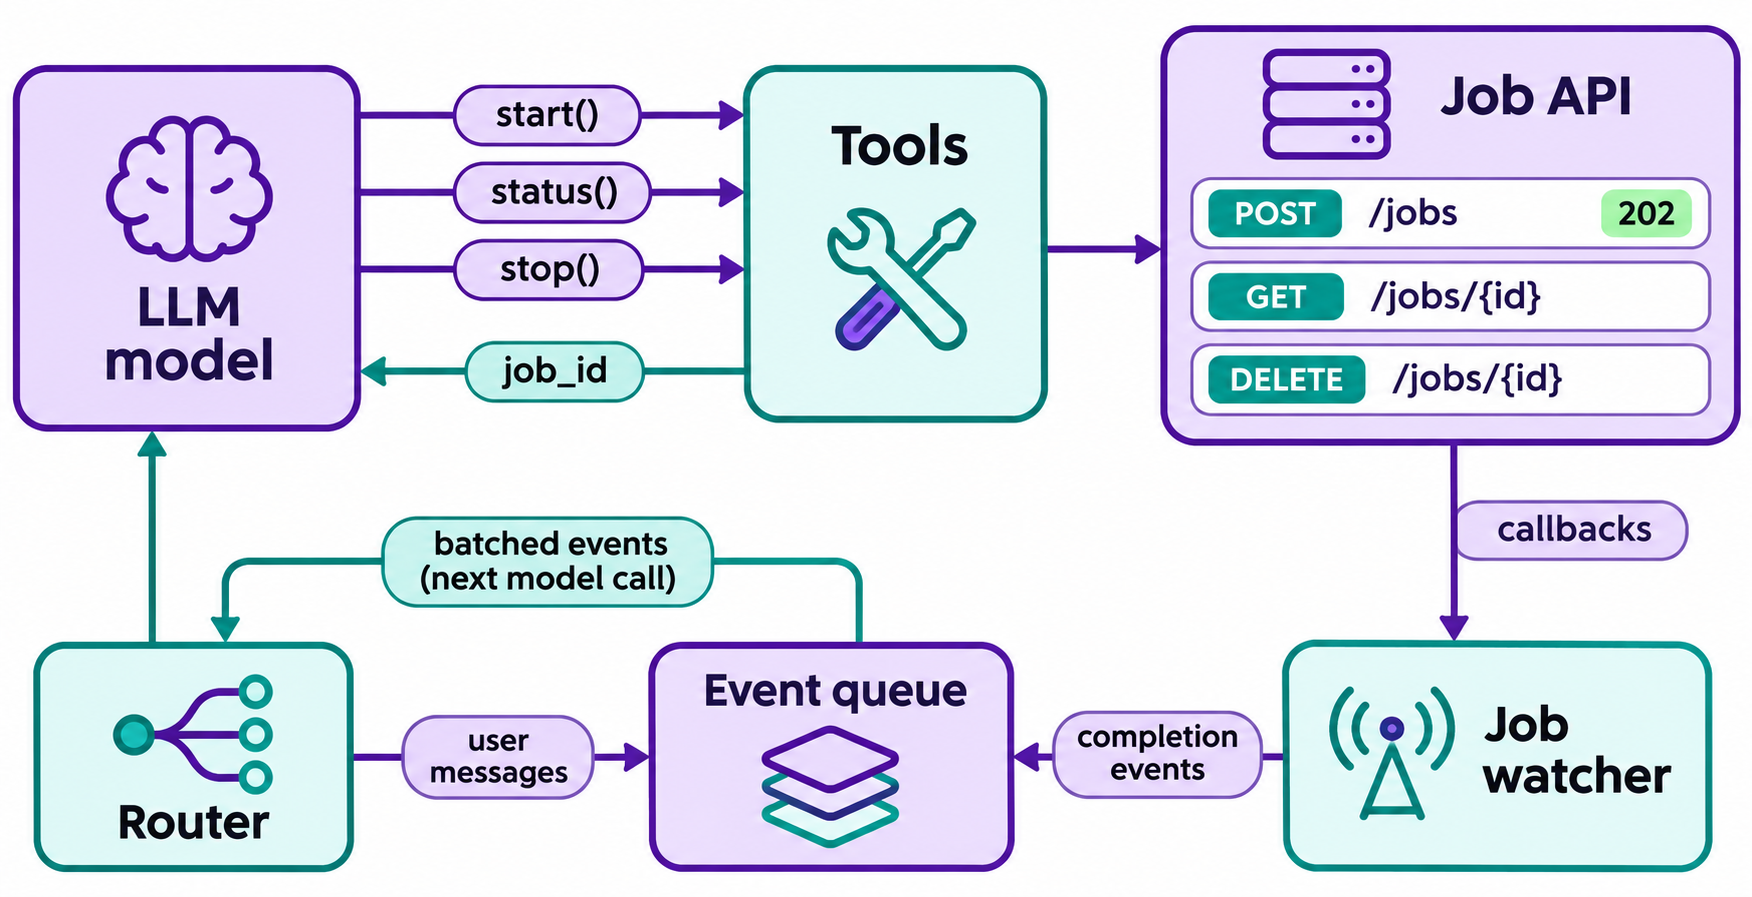
Fournissez au modèle trois outils distincts au lieu d'un seul pour chaque fonctionnalité à exécution longue, avec des formats de retour très concis.
{
  "name": "start_test_run",
  "description": "Start the test suite. Returns immediately with a job_id. The result arrives later as a job_completed event; do not wait for it.",
  "input_schema": {
    "type": "object",
    "properties": {
      "suite": { "type": "string", "enum": ["unit", "e2e", "all"] },
      "idempotency_key": { "type": "string" }
    },
    "required": ["suite", "idempotency_key"]
  }
}
start_test_run renvoie {"job_id": "job_8f2", "status": "queued"} et rien d'autre. get_job_status(job_id) renvoie queued, running, done ou failed, accompagné d'une brève indication de progression. stop_job(job_id) demande l'annulation et renvoie l'état atteint.
Deux règles permettent de canaliser le modèle : précisez « do not wait » dans la description, faute de quoi il interrogera get_job_status en boucle rapprochée, et ne renvoyez jamais de données métier depuis start, sous peine d'obliger le modèle à deviner la structure de la réponse reçue.
Comment les résultats réintègrent la boucle
L'interrogation active (polling) par le modèle doit rester une solution de repli, et non la norme. Une architecture plus robuste consiste à laisser le runtime surveiller les tâches et pousser un événement d'achèvement dans la conversation sous forme de nouveau message :
[event] job_completed job_id=job_8f2 tool=start_test_run status=done
summary: 412 passed, 3 failed (auth/session.test.ts)
details: get_job_result(job_8f2)
Gardez cet événement court et placez la charge utile complète derrière un outil de récupération dédié, afin d'éviter qu'un journal de 40 000 lignes ne vienne saturer la fenêtre de contexte.
Pensez ensuite au traitement par lots (batching). L'article de DeepSeek décrit un routeur qui rassemble les déclencheurs survenus pendant un tour pour les fusionner lors de l'appel suivant du modèle — avec des entrées longues et des sorties courtes intégrées au pré-remplissage (prefill). Lors de leur expérimentation, le nombre de déclencheurs est passé de 1 à 40 par minute, la taille moyenne des lots a progressé de 1,0 à 2,8, et le temps par décision a chuté de 6,4 s à 1,6 s. Il s'agit des résultats obtenus dans leurs propres tests et non d'un benchmark universel, mais un appel unique traitant trois événements s'avère bien plus efficace que trois appels distincts traitant un seul événement chacun. La règle est simple : pendant que le modèle génère une réponse, mettez en file d'attente les événements et les messages de l'utilisateur ; dès que le tour se termine, transmettez-les ensemble dans leur ordre d'arrivée.
Ordonnancement, annulation et clés d'idempotence
Ordonnancement. Les tâches peuvent se terminer dans n'importe quel ordre. Si la tâche B dépend de la tâche A, rendez cette dépendance explicite : lancez B uniquement après avoir reçu l'événement d'achèvement de A, ou configurez l'API pour qu'elle accepte un paramètre depends_on.
Annulation. L'action stop est une demande, pas une garantie absolue. Renvoyez l'état final réel (cancelled, ou done si l'opération s'est achevée entre-temps) et laissez le modèle le restituer fidèlement. L'extension Tasks de MCP adopte la même approche : sa documentation qualifie l'annulation de coopérative, ce qui signifie qu'une tâche peut tout de même atteindre un état terminal autre que cancelled.
Clés d'idempotence. Les modèles effectuent des tentatives de réessai, de sorte qu'une perte de réponse peut provoquer un second appel à start. Exigez une clé idempotency_key pour chaque appel à start et configurez l'API pour qu'elle renvoie la tâche existante si elle reçoit à nouveau la même clé. Sans ce mécanisme, une commande telle que « lancer la migration » risque de s'exécuter deux fois.
Résultats partiels. Donnez accès aux résultats intermédiaires (par exemple, les 50 premières pages explorées) via get_job_result(job_id, cursor) plutôt que d'attendre la fin complète du traitement.
Croissance du contexte. Résumez les tâches terminées en une seule ligne dès que le modèle les a prises en compte.
Délais d'expiration (timeouts). Définissez une date limite pour chaque tâche et émettez un événement job_timed_out dès qu'elle est dépassée.
À quoi doit ressembler l'API sous-jacente
Un outil asynchrone ne vaut que par l'API de gestion des tâches qui le sous-tend : réceptionner le travail, renvoyer un identifiant et permettre à l'appelant d'en vérifier l'état. La norme RFC 9110 définit le code 202 Accepted en indiquant que « la requête a été acceptée pour traitement, mais le traitement n'est pas encore terminé », et la documentation MDN sur le code 202 en détaille l'usage pratique.
Voici une API de tâches minimale pour un outil start() :
| Appel | Réponse | Utilisé par |
|---|---|---|
POST /jobs (avec l'en-tête Idempotency-Key) |
202 + {"job_id", "status":"queued"} + Location: /jobs/{id} |
start |
GET /jobs/{id} |
200 + queued, running, done ou failed |
status, observateur de tâches |
GET /jobs/{id}/result |
200 avec le résultat, ou 409 si non terminé |
outil de récupération |
DELETE /jobs/{id} |
202 annulation demandée, puis 404 ou 409 lors des appels ultérieurs |
stop |
| URL de rappel (callback) optionnelle | POST vers l'appelant à la fin du traitement |
observateur de tâches |
Ce callback permet au runtime de pousser directement des événements au lieu d'interroger l'API en continu. Si vous hésitez entre ces deux approches, retrouvez les compromis détaillés dans notre article sur webhooks vs polling, ainsi que la dimension orientée événements dans qu'est-ce qu'AsyncAPI.
Si vos outils prennent en charge MCP, un standard existe désormais pour cela. La spécification MCP (version 2026-07-28) propose l'extension optionnelle Tasks : un serveur peut répondre à tools/call avec un objet CreateTaskResult contenant un taskId, le client interroge tasks/get (ou écoute notifications/tasks), et tasks/cancel sollicite un arrêt. Les statuts prévus sont working, input_required, completed, failed et cancelled. Le client comme le serveur doivent activer cette extension, et la prise en charge par les hôtes varie : vérifiez donc les capacités de votre client avant d'en faire une dépendance critique.
Laissez votre agent de programmation concevoir et tester l'API de tâches avec Apidog CLI
L'API de gestion des tâches est le composant que vous pouvez valider avant même qu'un agent ne l'utilise. Transmettez la conception et les tests à votre agent de développement et laissez-le piloter Apidog CLI. Vous rédigez un prompt unique ; l'agent se charge de générer la spécification, les cas de test et de les exécuter.
La configuration ne requiert que trois commandes :
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Donnez ensuite un prompt unique à votre agent :
In Apidog project <projectId>, design the job API a start() tool needs:
POST /jobs returns 202 with job_id, GET /jobs/{id} returns queued|running|done|failed,
DELETE /jobs/{id} cancels. Create the endpoints, then create test cases that assert:
202 and a job_id on create, a status that reaches done within 60 seconds,
the same job_id when the Idempotency-Key repeats, and 409 or 404 on GET result after cancel.
Run them against the staging environment <envId> and summarize failures.
L'agent lit la structure de chaque charge utile depuis la CLI, la valide, puis procède à la création et à l'exécution :
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file post-jobs.json
apidog endpoint create --project <projectId> --file post-jobs.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case-create-202.json
apidog test-case create --project <projectId> --file case-create-202.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
Le rapporteur cli affiche les réussites et les échecs par assertion directement dans le terminal, tandis que le rapport json fournit à l'agent une structure exploitable à relire et à interpréter. Exécutez la même commande en intégration continue (CI) avec -r junit une fois les tests validés ; le guide du workflow agent avec Apidog CLI détaille ce cycle, et l'article Apidog CLI dans Claude Code explique la configuration de l'agent. Le forfait gratuit d'Apidog permet d'accueillir jusqu'à 4 utilisateurs.
Quand utiliser des outils asynchrones (et quand s'en passer)
Privilégiez l'asynchrone quand :
- Un outil prend régulièrement plus de quelques secondes (compilations, suites de tests, exploration web, rendus, déploiements).
- Les utilisateurs interagissent avec l'agent pendant que le travail s'exécute.
Restez sur du bloquant quand :
- L'appel répond en une ou deux secondes au maximum.
- L'étape suivante ne peut de toute façon pas démarrer sans ce résultat.
- Vous ne disposez pas d'une véritable API de gestion des tâches en arrière-plan. Un faux outil asynchrone qui bloque en interne n'apporte que de la complexité inutile.
Une règle empirique : gardez les lectures en mode bloquant, et passez les écritures et calculs lourds en mode asynchrone.
FAQ
Quelle est la différence entre appels d'outils asynchrones et appels d'outils parallèles ? Les appels parallèles exécutent plusieurs outils simultanément au cours d'un même tour, et le modèle attend malgré tout la fin de chacun d'eux. Les appels asynchrones retournent immédiatement la main et se terminent au fil des tours suivants, permettant au modèle de poursuivre la conversation pendant leur exécution.
Faut-il nécessairement MCP pour créer des outils asynchrones ? Non. N'importe quel outil renvoyant un identifiant de tâche, associé à un runtime injectant des événements d'achèvement, fera l'affaire. L'extension optionnelle Tasks de MCP vient simplement standardiser les identifiants, l'interrogation et les appels d'annulation lorsque votre client et votre serveur la prennent tous deux en charge.
Comment l'agent sait-il qu'une tâche est terminée ? C'est le runtime qui l'en informe. Un observateur de tâches (job watcher) interroge l'API de tâches ou reçoit un callback, puis insère un bref événement d'achèvement dans la conversation. Le modèle en prend connaissance lors de son tour suivant.
Que se passe-t-il si l'utilisateur annule en cours d'exécution ? L'agent appelle stop(job_id), l'API enregistre la demande et la tâche renvoie son état final réel. Si le travail s'est terminé avant la prise en compte de l'annulation, l'agent doit l'indiquer en toute transparence au lieu d'affirmer que l'opération a été interrompue.
Le mode full-duplex de DeepSeek est-il une option que l'on peut activer directement ? Pas sous la forme d'une fonctionnalité produit. L'article précise qu'il est implémenté dans DeepSeek Harness mais désactivé par défaut, et que le plugin associé est un prototype dont les auteurs soulignent qu'il ne constitue pas un produit officiel DeepSeek. Servez-vous-en plutôt comme d'une architecture de référence.