
Réponse rapide : les générateurs de vidéos IA sans restrictions au sens strict n'existent que sur votre propre matériel : les modèles à poids ouverts comme Wan2.2, HunyuanVideo-1.5 et LTX-2 fonctionnent sans filtre côté serveur. Chaque service hébergé applique une politique de contenu. Si vous voulez moins de refus par faux positifs sans GPU, une plateforme multi-modèles comme A2E vous permet de changer de modèle quand l'un rejette une requête inoffensive.
« Sans restrictions » dans ce guide signifie liberté créative : moins de refus sur des requêtes légitimes comme un court-métrage d'horreur, une scène de guerre, une cascade ou une vidéo explicative médicale. Cela ne signifie pas contenu explicite, et cela ne signifie jamais utiliser le visage ou la voix d'une personne réelle sans son consentement. Il s'agit du pendant vidéo de notre guide sur les générateurs d'images IA sans restrictions.
Ce que signifie « sans restrictions » pour les générateurs de vidéos IA
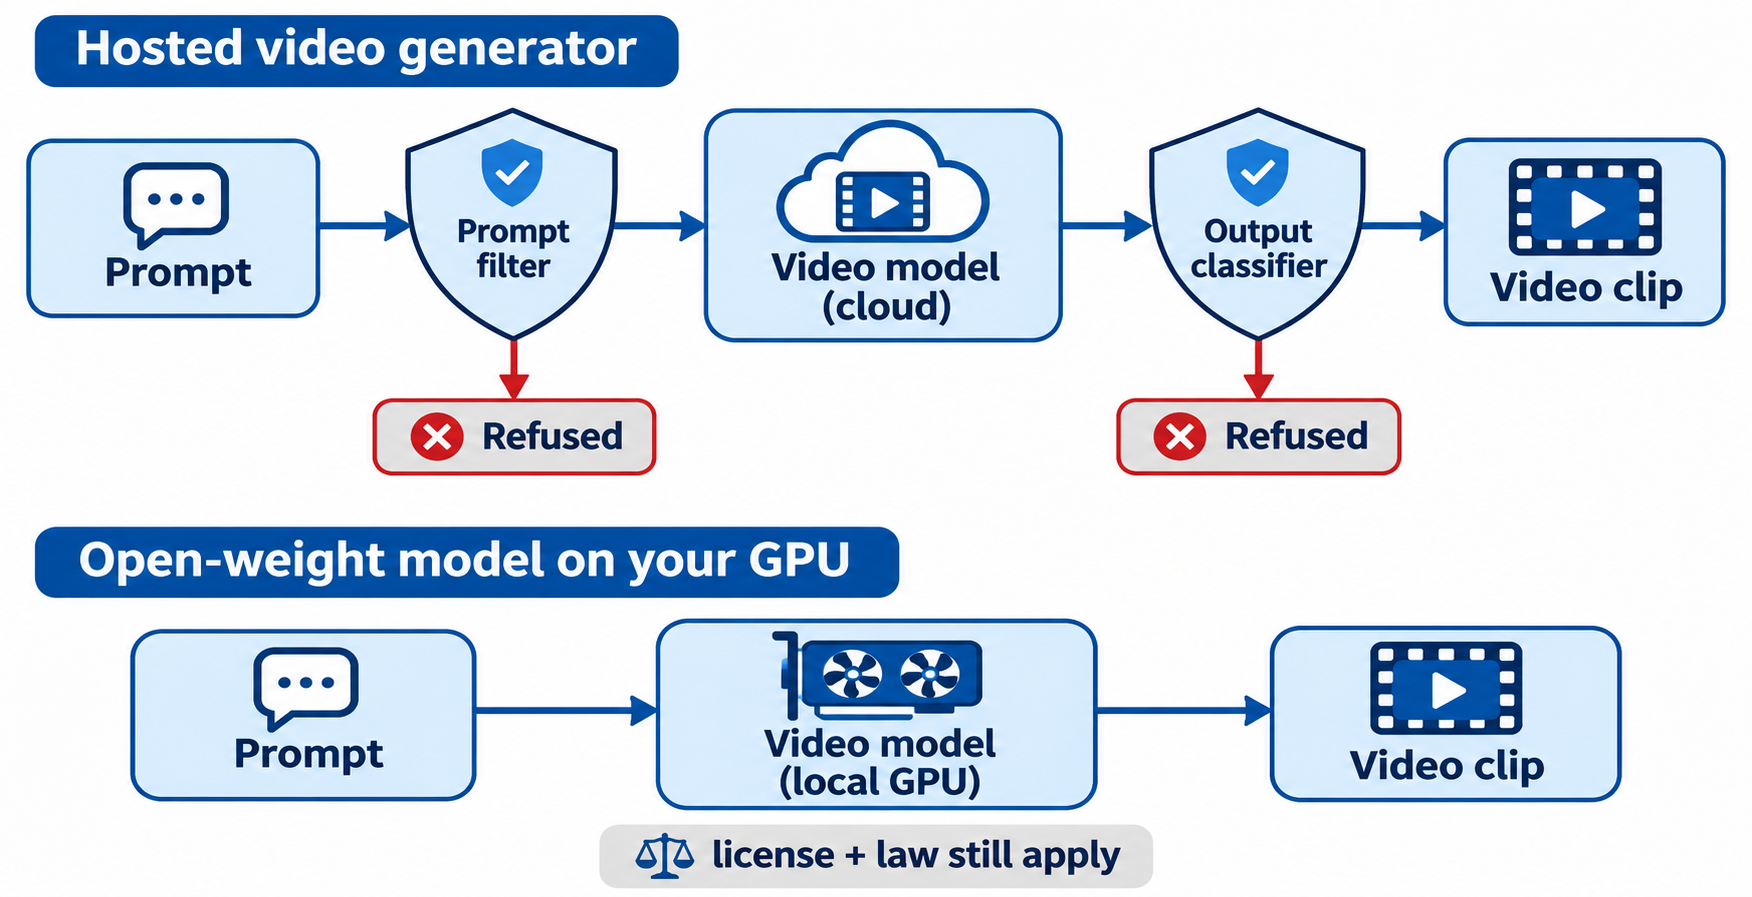
Un générateur de vidéos IA sans restrictions est un outil qui exécute votre requête sans filtre de contenu côté fournisseur. En pratique, cela ne décrit que les modèles à poids ouverts que vous exécutez vous-même. Les outils hébergés filtrent tous, mais ils diffèrent par la fréquence à laquelle ils refusent des requêtes inoffensives et par le nombre de modèles que vous pouvez essayer sous un seul compte.
Les générateurs de vidéos hébergés vérifient généralement deux fois : un filtre de requête lit d'abord votre texte, puis un classifieur de sortie inspecte les images avant que le clip ne vous soit renvoyé. Chacun des deux peut refuser. Exécutez un modèle en local et aucune de ces couches n'existe.
Les meilleurs générateurs de vidéos IA sans restrictions : la sélection
Voici une comparaison des principales options. Les prix et les crédits proviennent de chaque page officielle, vérifiés le 13 novembre 2026.
| Outil | Type | Filtre | Formule gratuite | Idéal pour |
|---|---|---|---|---|
| A2E | Hébergé, multi-modèles | Politique du fournisseur | 30 crédits/jour, filigrane, 720p | De nombreux modèles sur un seul compte, plus une API |
| Kling 4.0 | Hébergé | Politique du fournisseur | Voir la page officielle | Scènes à grands mouvements avec audio |
| Gemini Omni Flash | Hébergé (Google) | Politique de Google | Voir la page officielle | Clips de 3 à 15 secondes avec audio natif |
| Grok Imagine | Hébergé (xAI) | Politique de xAI | API payante, facturée à la seconde | Clips courts jusqu'à 15 s, 1080p sur le 1.5 |
| Seedance 2.5 | Hébergé (ByteDance) | Politique de ByteDance | Voir la page officielle | Plans uniques jusqu'à 30 s |
| Wan2.2 | Poids ouverts | Aucun sur votre machine | Poids gratuits | 720p local à 24 fps sur un GPU haut de gamme |
| HunyuanVideo-1.5 | Poids ouverts | Aucun sur votre machine | Poids gratuits | Exécutions locales plus légères (14 Go avec offloading) |
| LTX-2 | Poids ouverts | Aucun sur votre machine | Poids gratuits | Vidéo avec audio synchronisé, en local |
1. A2E : un compte, de nombreux modèles vidéo
A2E est une plateforme IA tout-en-un pour les images et les vidéos. Elle figure dans cette liste pour son étendue, pas parce qu'elle ignore la politique : quand un modèle refuse une requête inoffensive, vous la relancez sur un autre modèle avec le même compte et les mêmes crédits. Les modèles vidéo incluent Seedance 2.5, Kling 4.0, Wan 3.0, Veo 3.1, Sora 2 et Grok Imagine, auxquels s'ajoutent face swap, photo parlante, synchronisation labiale et clonage de voix.
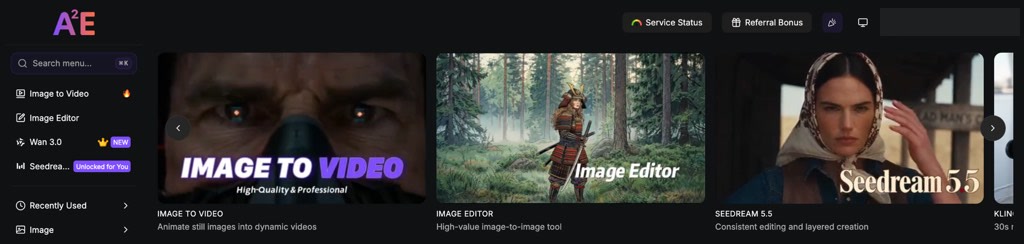
Les nouveaux comptes reçoivent 100 crédits gratuits plus 30 par jour via le check-in, avec une sortie 720p filigranée. Pro coûte 14,9 $ pour un mois avec 1 500 crédits, sans filigrane et avec accès à l'API. Lors de notre test du 13 novembre 2026, un clip image vers vidéo de 5 secondes sur le modèle V2 d'A2E coûtait 40 crédits et était rendu en environ 2 minutes. Un face swap sur le même clip s'exécutait gratuitement dans le quota, et le nouveau visage restait stable sur toutes les images.
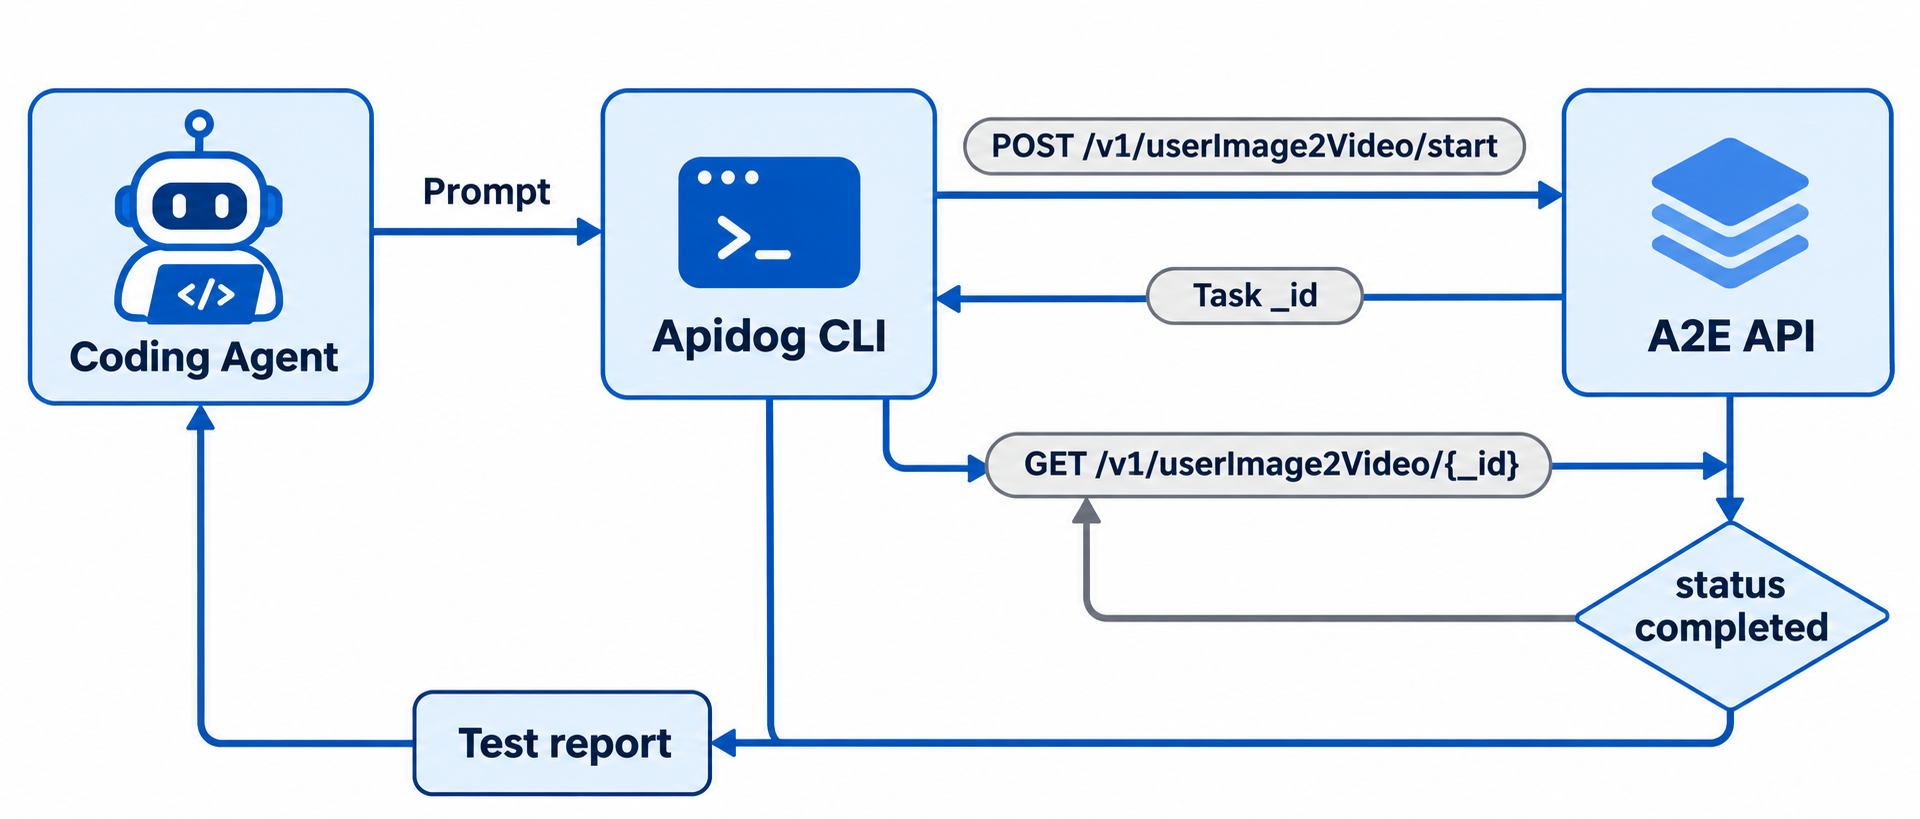
Les développeurs disposent d'une API REST à https://api.a2e.ai avec une spécification OpenAPI et un SKILL.md pour les agents de code. Les tâches sont asynchrones : vous démarrez une tâche, puis vous interrogez son _id jusqu'à ce qu'elle se termine.
Verdict : la voie hébergée la plus simple pour réduire les refus, car changer de modèle coûte un menu déroulant, pas un nouvel abonnement. Les conditions d'A2E s'appliquent toujours, et le site propose un lien vers un formulaire de signalement CSAM.
2. Kling 4.0
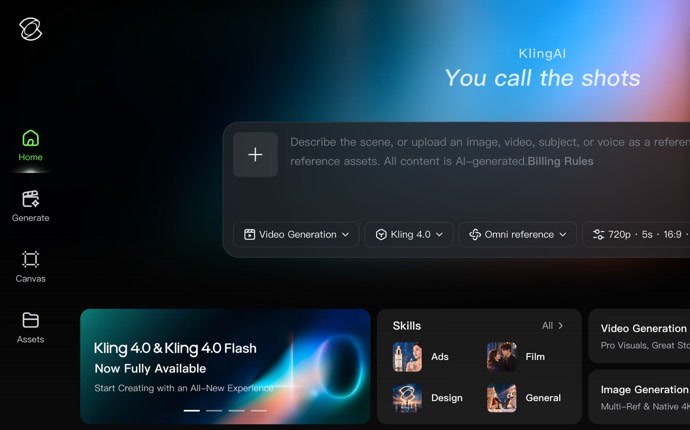
Hébergé. Le site de Kling présente Kling 4.0 comme une solution axée sur le réalisme audio-visuel et la stabilité des scènes à grands mouvements. La zone de requête accepte du texte plus une image, une vidéo, un sujet ou une voix comme référence, et démarre à 720p, 5 secondes et 16:9. Autour se trouvent le contrôle de mouvement, la synchronisation labiale, les avatars parlants et la vidéo vers audio, plus un Canvas à base de nœuds et un accès MCP et API pour le travail par lots. Les forfaits payants commencent à 6,99 $, et Kling est aussi au menu d'A2E.
Verdict : un bon choix pour les clips riches en action. Vérifiez d'abord son quota gratuit sur kling.ai.
3. Google Gemini Omni Flash (anciennement Veo)
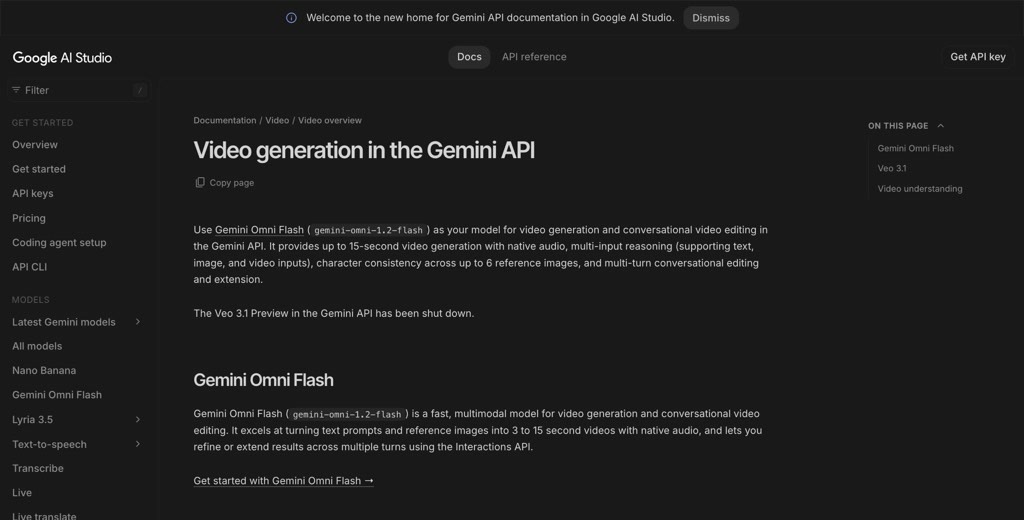
Hébergé. Google a fermé les modèles de préversion Veo 3.1 dans l'API Gemini le 22 octobre 2026, et sa documentation vidéo redirige désormais les développeurs vers Gemini Omni Flash (gemini-omni-1.2-flash). Il crée des clips allant jusqu'à 15 secondes avec audio natif à partir d'entrées texte, image ou vidéo, maintient un personnage cohérent sur jusqu'à 6 images de référence, et permet d'affiner ou de prolonger un clip sur plusieurs tours. La Politique d'utilisation interdite de l'IA générative de Google encadre ce que vous pouvez créer.
Verdict : bonne qualité dans l'écosystème Google, mais pas le choix idéal si les refus sont votre principal problème.
4. Grok Imagine
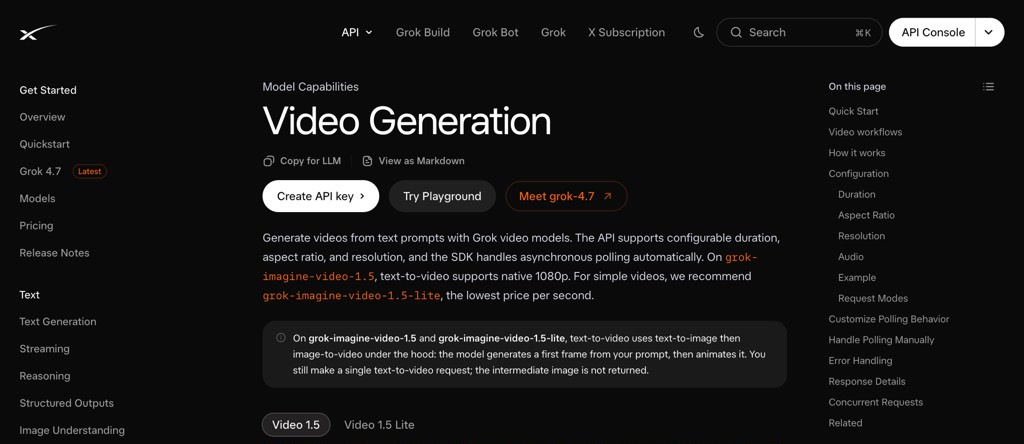
Hébergé. Le modèle vidéo de xAI fonctionne dans l'application Grok et via l'API xAI. Sur grok-imagine-video-1.5, le texte vers vidéo est rendu nativement en 1080p, et le modèle 1.5-lite est le moins cher à la seconde. Les clips durent de 1 à 15 secondes avec l'audio activé par défaut, et le SDK de xAI gère l'interrogation asynchrone pour vous. La modération est identique dans l'application et l'API, donc l'API ne refusera pas moins, mais chaque tâche rapporte son propre statut. Il est aussi au menu d'A2E. Notre analyse de Grok Imagine sans restrictions couvre ce qui a changé et ce qui fonctionne toujours.
Verdict : clips courts rapides et bon marché, avec un filtre qui se déclenche encore sur des requêtes inoffensives.
5. Seedance 2.5
Hébergé. Seedance 2.5 de ByteDance génère l'audio et la vidéo ensemble et est conçu pour de la narration de 30 secondes en un seul plan, jusqu'à 1080p. Il accepte jusqu'à 30 images de référence, 10 vidéos et 10 clips audio. Vous pouvez y accéder via les applications de ByteDance, l'API BytePlus ModelArk et des hébergeurs tiers, A2E inclus. Il bloque les visages humains réels dans les images de référence sur toutes les voies d'accès. Notre guide des requêtes Seedance 2 qui évitent les signalements de contenu couvre les formulations qui déclenchent son filtre par accident.
Verdict : le meilleur choix pour les longs plans uniques, à condition d'éviter les visages réels.
6. Wan2.2
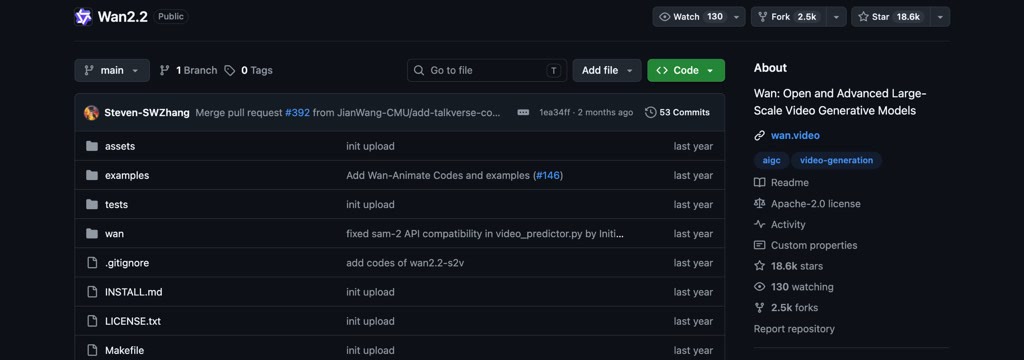
Poids ouverts, exécution locale. Wan2.2 est sous licence Apache 2.0 et propose des modèles de texte vers vidéo, image vers vidéo et parole vers vidéo. Il utilise une architecture Mixture-of-Experts et a été entraîné sur 65,6 % d'images et 83,2 % de vidéos en plus que Wan2.1. Son modèle TI2V-5B gère à la fois le texte et l'image vers vidéo à 720p et 24 fps, et le README indique qu'il fonctionne sur des cartes grand public comme une RTX 4090. Un modèle Animate-14B distinct gère l'animation et le remplacement de personnages.
Verdict : le meilleur point de départ local si vous disposez d'un GPU haut de gamme.
7. HunyuanVideo-1.5
Poids ouverts, exécution locale. HunyuanVideo-1.5 est un modèle de 8,3 milliards de paramètres pour le texte vers vidéo et l'image vers vidéo, conçu pour fonctionner sur des GPU grand public. Son README indique un minimum de 14 Go de mémoire GPU avec l'offloading de modèle activé, et un modèle image-vers-vidéo 480p distillé par étapes rend un clip en environ 75 secondes sur une seule RTX 4090. Le code d'entraînement et un script de réglage LoRA sont également ouverts. Il est fourni sous la licence communautaire propre à Tencent, lisez-la donc avant tout usage commercial.
Verdict : l'option locale la plus légère, si sa licence convient à votre usage.
8. LTX-2
Poids ouverts, exécution locale. LTX-2 de Lightricks génère de la vidéo avec audio synchronisé dans un seul modèle, avec plusieurs modes de performance. Le code est sous Apache 2.0, tandis que les poids portent leur propre licence de modèle listée dans le README, et Hugging Face vous demande d'accepter les conditions avant de télécharger. Le guide de démarrage rapide actuel télécharge environ 66 GiB de poids LTX-2.5, prévoyez donc l'espace disque. Il prend en charge la quantification fp8 et l'offloading quand la mémoire GPU est limitée, et le dépôt inclut un entraîneur LoRA.
Verdict : le choix local quand vous avez besoin du son dans la même passe.
Pour les trois modèles à poids ouverts, ComfyUI est l'interface habituelle : chargez les poids, câblez un workflow, et générez hors ligne. Vous échangez le filtre du fournisseur contre du matériel et du temps de configuration.
Comment réduire les refus par faux positifs sur les outils hébergés
La plupart des refus sur des requêtes légitimes viennent de la formulation, pas de l'intention :
- Décrivez le plan littéralement. « Un chef émince des oignons avec un grand couteau » est plus efficace qu'une requête construite sur des verbes violents.
- Éliminez les noms réels. La plupart des fournisseurs bloquent les requêtes mentionnant des personnalités publiques, pour de bonnes raisons.
- Partez de votre propre image. Cela donne au modèle un sujet clair et consenti.
- Utilisez le prompt négatif pour écarter le gore, le flou et la distorsion.
- Changez de modèle. Une requête refusée par un modèle passe souvent sur un autre.
Laissez votre agent de code tester l'API A2E avec Apidog CLI
Sur une API vidéo, la partie risquée est la tâche asynchrone qui revient en failed, ou le refus que votre interface ne gère pas. Laissez votre agent de code écrire et exécuter ces vérifications avec Apidog CLI.
Configurez-le une fois :
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_APIDOG_TOKEN>
apidog skill install
curl -sL https://video.a2e.ai/dev/openapi-spec -o a2e-openapi.json
apidog import --project <projectId> --format openapi --file ./a2e-openapi.json
Donnez ensuite à votre agent (Claude Code, Codex, Cursor ou OpenCode) une seule requête :
In Apidog project <projectId>, create a test case for POST /v1/userImage2Video/start
with a Bearer token from the environment variable A2E_TOKEN. Assert the response
has code 0 and a data._id. Then call GET /v1/userImage2Video/{_id} until
current_status is completed or failed, and fail the test on failed with the
reason. Run it against environment <envId> and summarize the result.
Les exécutions réelles consomment des crédits A2E, faites donc ajouter par l'agent une attente simulée pour l'état failed (apidog cli-schema get mock-create, puis apidog mock create) et testez la gestion des erreurs dessus. En CI, apidog run --test-case <caseId> -r junit génère un rapport JUnit ; voir Apidog CLI dans un pipeline CI/CD.
Quel générateur de vidéos IA choisir ?
- Zéro filtrage fournisseur, GPU de 14 Go ou plus : HunyuanVideo-1.5 ou Wan2.2 TI2V-5B dans ComfyUI.
- Audio et vidéo depuis un seul modèle local : LTX-2.
- De nombreux modèles hébergés sur un seul compte : A2E.
- Clips riches en action : Kling 4.0.
- Longs plans uniques : Seedance 2.5.
- Créer un produit : l'API d'A2E plus des tests Apidog CLI pour le cycle de vie des tâches asynchrones.
FAQ
Existe-t-il des générateurs de vidéos IA véritablement sans restrictions ?
Uniquement les modèles à poids ouverts que vous exécutez vous-même, comme Wan2.2, HunyuanVideo-1.5 et LTX-2. Ils n'ont aucun filtre côté fournisseur. Leurs licences et votre législation locale s'appliquent toujours, et chaque service hébergé applique une politique de contenu.
A2E est-il gratuit ?
A2E propose un forfait Free à 0 $ avec 30 crédits bonus par jour via le check-in, un filigrane et une sortie 720p. L'accès à l'API commence sur Pro à 14,9 $ pour un mois.
Pourquoi mon générateur de vidéos IA refuse-t-il des requêtes inoffensives ?
Les filtres de requête et les classifieurs de sortie se déclenchent sur des mots liés à la violence ou à des personnes réelles, même dans des scènes innocentes. Décrivez le plan littéralement et essayez un autre modèle.
L'image vers vidéo est-elle moins refusée que le texte vers vidéo ?
Souvent, car votre propre image donne au modèle un sujet clair. Les classifieurs de sortie vérifient toujours les images, ce n'est donc pas une garantie.