
Un agent IA qui corrige les bugs tout seul ne fonctionne que s'il suit une règle unique : pas de reproduction, pas de correction. L'agent transforme le rapport de bug en un test qui échoue aujourd'hui, patche le code sur une branche isolée, relance ce test ainsi que toute la suite, et ne fait un retour que lorsque tout est au vert. Un humain reste chargé de la fusion. S'il ne parvient pas à reproduire le bug, il se tait.
L'équipe DeepSeek Harness a soumis cette idée à un large public le 1ᵉʳ novembre 2026, dans un essai sur la conception des super-agents. Ce guide la transforme en pipeline que vous pouvez construire cette semaine, avec la reproduction écrite sous forme de test API que votre agent crée et exécute depuis le terminal.
Pourquoi « agent, corrige ça » échoue sans reproduction
Demandez à un agent de code de corriger un rapport de bug et vous obtiendrez généralement un diff plein d'assurance. Impossible de savoir s'il corrige votre bug, un bug qu'il a imaginé, ou rien du tout.
Sans étape de reproduction, trois choses tournent mal :
- L'agent devine la cause. Il choisit la ligne la plus probable d'après le message d'erreur et la modifie.
- « Corrigé » n'a aucune définition. La seule preuve est le propre résumé de l'agent.
- Des régressions s'introduisent. Un patch sur un validateur partagé peut corriger un endpoint et en casser quatre autres.
Un test qui échoue résout ces trois problèmes : il cible le bug, définit ce qu'est une correction réussie et reste dans votre suite en tant que contrôle de régression.
D'où vient « reproduire et corriger en silence »
Dans « Exploring Super-agent Design », l'équipe DeepSeek Harness décrit une pratique issue de son propre groupe d'utilisateurs : lorsqu'une personne signale un bug, un agent tente de le reproduire en arrière-plan. Il ne se manifeste qu'avec une correction confirmée et simple. Sinon, il ne dit rien.
L'essai appelle cela l'exécution spéculative et l'associe à deux éléments que vous réutiliserez ici. Les workers reçoivent une session isolée par tâche, tous les outils et le modèle le plus puissant, et rendent compte à un routeur au lieu de parler aux humains. Un watchdog est une session distincte qui vérifie si chaque worker progresse ou part en vrille.
Une précision : l'essai décrit une architecture, et non des fonctionnalités livrées de DeepSeek Harness. Une partie de celui-ci existe dans un plugin prototype, dsh-superagent-prototype, qui, selon les auteurs, n'est pas un produit officiel DeepSeek. Pour une vue d'ensemble du routeur et des workers, consultez comment construire un super-agent.
Le pipeline de correction de bugs en cinq étapes
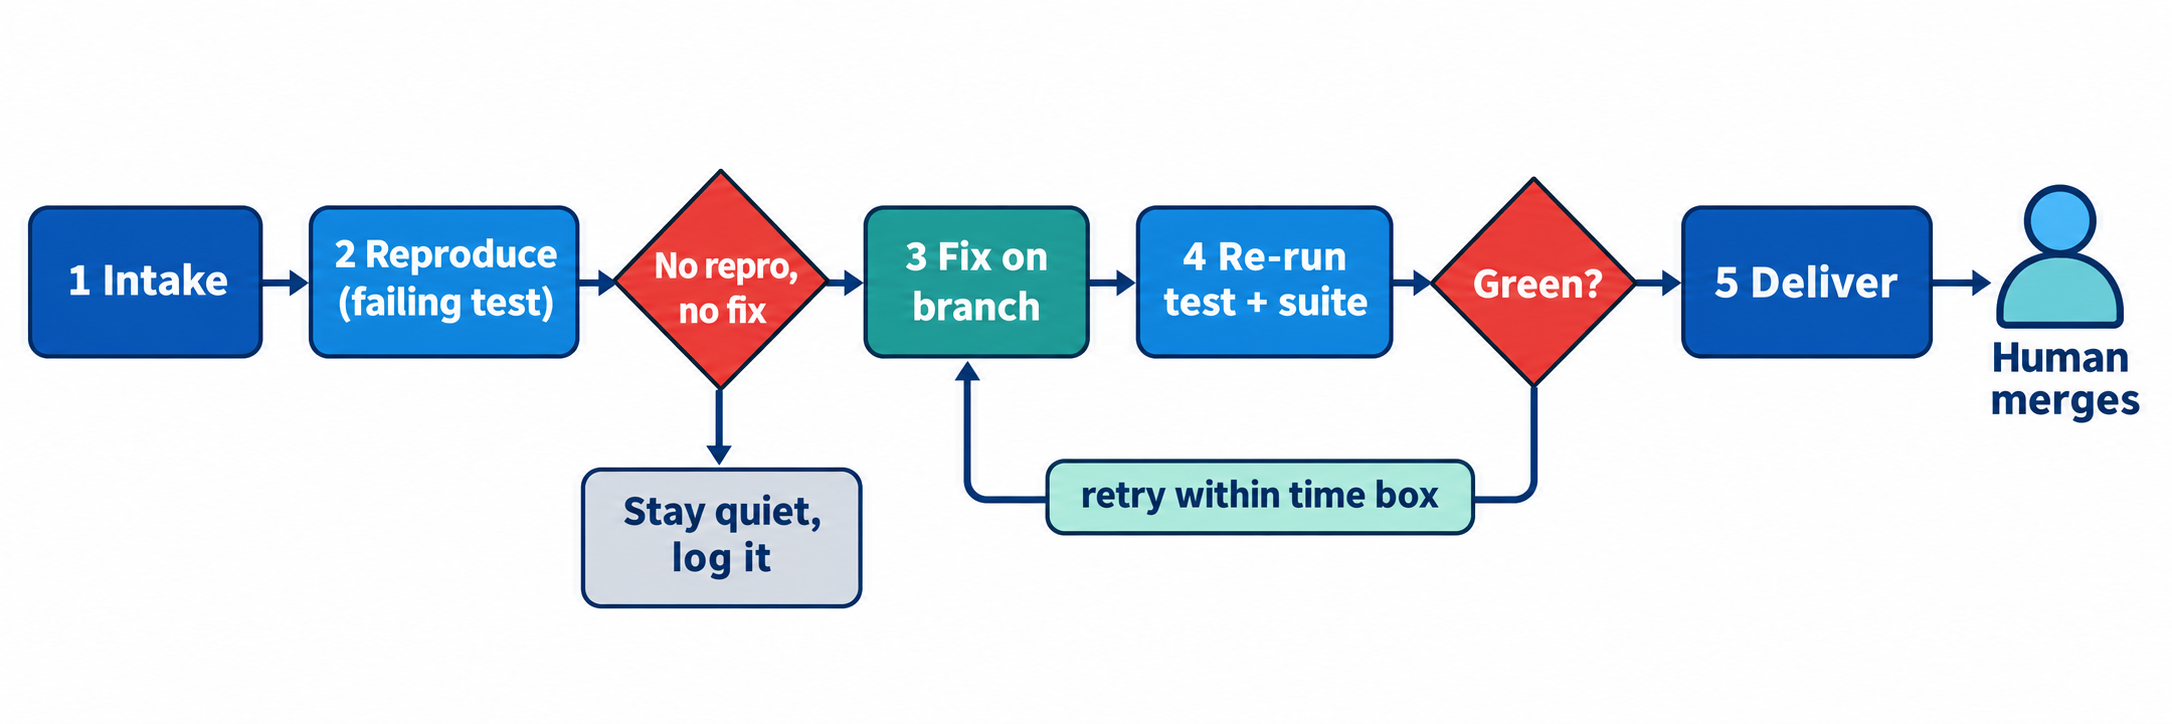
Un agent autocorrecteur exécute la même boucle à chaque fois, avec deux barrières de contrôle :
- Collecte : récupérer le rapport, la requête en échec et la réponse obtenue.
- Reproduction : écrire un test qui échoue pour la raison signalée. Pas de test en échec, pas de correction.
- Correction : patcher le code sur une branche ou un worktree isolé.
- Relance : le nouveau test doit passer, et la suite existante aussi.
- Livraison : ouvrir une pull request avec les preuves, ou se taire.
Étape 1 : structurer le rapport de bug
Votre agent ne peut pas reproduire « le paiement est encore cassé ». Donnez à la collecte une forme fixe :
| Champ | Exemple | Pourquoi c'est important |
|---|---|---|
| Endpoint | POST /orders |
Quel handler lire |
| Requête | Corps avec "coupon": null |
L'entrée exacte qui l'a cassé |
| Réponse réelle | 500, {"error":"internal"} |
Ce que le test doit voir échouer |
| Réponse attendue | 201 avec un id de commande |
Ce que le test affirme |
| Environnement | staging | Là où la reproduction s'exécute |
Si des champs manquent, l'agent pose une question ou extrait la requête des logs. Les corps d'erreur qui suivent les problem details de la RFC 9457 aident, car le type d'erreur arrive dans une forme prévisible.
Étape 2 : reproduire le bug sous forme de test API en échec
C'est la barrière de contrôle. L'agent transforme l'enregistrement de collecte en cas de test avec deux assertions, le code de statut attendu et un champ que la réponse doit contenir, et l'exécute contre l'environnement réel. Trois issues sont possibles :
- Il échoue pour la raison signalée. Vous avez une reproduction. Continuez.
- Il passe. Le bug n'est pas reproductible tel que décrit. Journalisez et arrêtez.
- Il échoue pour une autre raison (erreur d'authentification, données manquantes, timeout). C'est une reproduction défectueuse, pas un bug confirmé. Arrêtez.
Seule la première débloque une correction. C'est ce que « silencieux » signifie en pratique : les deux autres produisent une entrée de journal pour celui qui examine la file d'attente, pas un message dans le chat de l'utilisateur.
Écrivez la reproduction sous forme de test API, pas de test unitaire : l'agent interroge l'interface qu'a utilisée l'utilisateur, il ne peut donc pas reproduire un autre bug par accident.
Étape 3 : corriger le code dans une branche isolée
Une fois la reproduction au rouge, le worker reçoit sa propre copie du code. Un git worktree est l'option la plus légère : un second répertoire de travail sur une nouvelle branche, de sorte que les modifications de l'agent ne touchent jamais votre checkout. Lancez le service depuis celui-ci et pointez-y l'environnement de test.
Gardez deux contraintes strictes. La correction doit rester petite : fixez une limite, par exemple 3 fichiers ou 50 lignes modifiées, et traitez tout ce qui dépasse comme un rapport destiné à un humain. Et elle doit cibler la reproduction : pas de refactoring, de renommages ni de rangement, car chaque modification supplémentaire est quelque chose que votre relecteur devra vérifier.
Étape 4 : relancer la reproduction et toute la suite
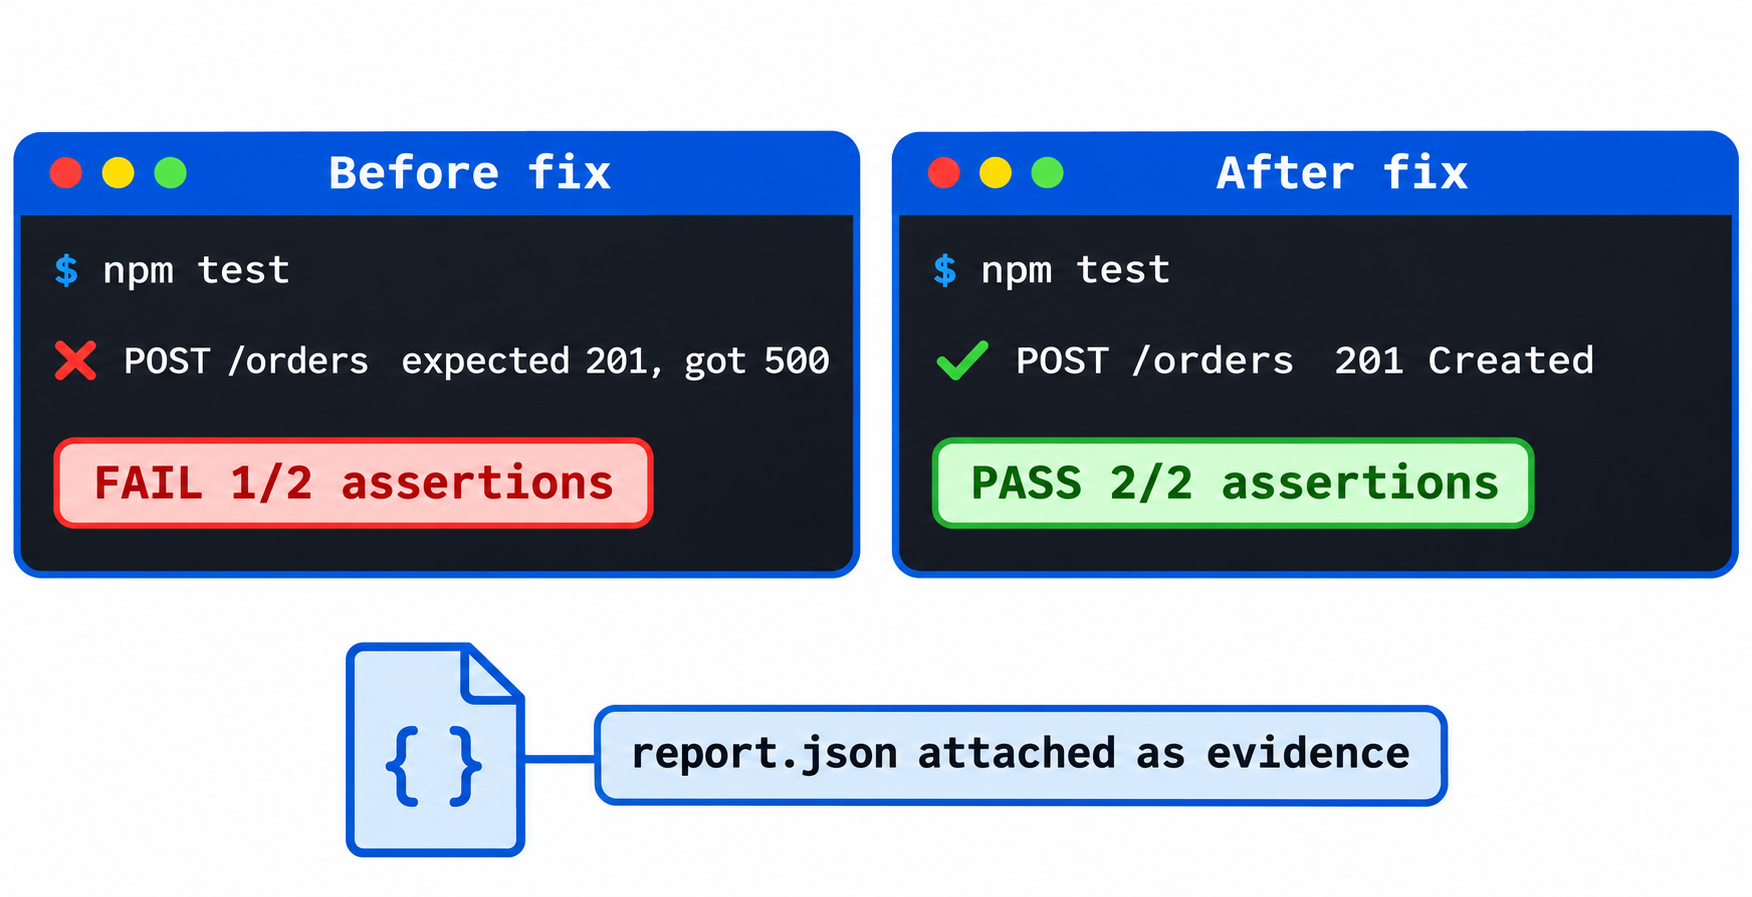
La seconde barrière a deux volets. D'abord, l'agent relance le même cas de test qu'à l'étape 2, inchangé, et il doit passer. Si l'agent a modifié les assertions pour y parvenir, la correction échoue ; votre pipeline le détecte en comparant le fichier de test avant et après.
Ensuite, la suite existante doit rester au vert. Une correction qui rend un test vert et trois rouges retourne à l'étape 3. Limitez la boucle dans le temps, par exemple 3 tentatives ou 20 minutes, puis arrêtez et journalisez ce qui a été tenté. C'est là que le watchdog justifie sa présence : il peut tuer un worker qui modifie sans cesse la même ligne ou part dans des fichiers que la reproduction n'a jamais touchés.
Étape 5 : livrer uniquement une correction confirmée et simple
Quand les deux barrières sont au vert, l'agent ouvre une pull request avec des preuves, pas un récit : le rapport, l'exécution en échec, le diff et l'exécution réussie avec les résultats de la suite. Un humain relit et fusionne. Les branches protégées garantissent que le token de l'agent peut pousser une branche mais ne jamais fusionner dans main. Si une barrière a échoué, le signataire n'entend rien ; l'agent écrit une ligne de log et passe à autre chose.
Garde-fous pour un agent IA autocorrecteur
Mettez ces barrières en place avant la première exécution sans supervision :
| Garde-fou | Réglage | Ce que cela évite |
|---|---|---|
| Périmètre | Fichiers et lignes max par correction | Des réécritures présentées comme des corrections |
| Limite de temps | Tentatives et minutes max par bug | Des boucles incontrôlées qui brûlent des tokens |
| Identifiants | Staging uniquement, pas de clés de production | Une reproduction qui crée de vraies commandes |
| Droits de fusion | Pousser des branches, ne jamais fusionner | Du code non relu qui atteint main |
| Intégrité des tests | Comparer le fichier de test avant et après | Des assertions modifiées pour passer |
| Silence | Aucun message à l'utilisateur en cas d'échec | Du bruit et des affirmations à moitié confirmées |
Les identifiants sont le point le plus crucial : une reproduction interroge réellement l'API, utilisez donc le staging ou des données locales pré-remplies.
Laissez votre agent de code construire la reproduction avec Apidog CLI
L'étape 2 est le cœur du pipeline, et c'est exactement ce pour quoi l'Apidog CLI a été conçu. Votre agent de code (Claude Code, Codex, Cursor ou OpenCode) écrit le cas de test en JSON, le crée dans votre projet Apidog et l'exécute depuis le terminal. Vous rédigez un seul prompt.
Configurez-le une fois :
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Puis remettez à votre agent le rapport de bug et ce prompt :
Here is a bug report for POST /orders in Apidog project <projectId>.
Turn it into an Apidog test case that fails today: assert status 201
and that $.id exists. Run it against staging and confirm it fails for
the reported reason. If it does, fix the handler on a new worktree
branch until the same test passes, run the endpoint's other cases, and
open a PR with both JSON reports. If it doesn't reproduce, stop and log why.
L'agent ne construit pas le payload de mémoire. Il lit le schéma, trouve une catégorie, valide son fichier et crée ensuite seulement le cas :
apidog cli-schema get test-case-create
apidog test-case category --project <projectId>
apidog cli-schema validate test-case-create --file repro-orders.json
apidog test-case create --project <projectId> --file repro-orders.json
Le fichier qu'il écrit ressemble à ceci (les IDs viennent de votre projet) :
{
  "name": "Repro: POST /orders with null coupon returns 500",
  "apiDetailId": 123456,
  "categoryId": 1,
  "method": "post",
  "path": "/orders",
  "parameters": {},
  "commonParameters": {},
  "requestBody": {
    "type": "application/json",
    "data": "{\"items\":[{\"sku\":\"A-100\",\"qty\":1}],\"coupon\":null}"
  },
  "postProcessors": [
    { "type": "assertion", "defaultEnable": true, "enable": true,
      "data": { "name": "status is 201", "subject": "httpCode", "comparison": "equal", "path": "", "value": "201" } },
    { "type": "assertion", "defaultEnable": true, "enable": true,
      "data": { "name": "order id exists", "subject": "responseJson", "comparison": "exists", "path": "$.id" } }
  ]
}
Maintenant, l'exécution au rouge qui prouve le bug :
apidog run --test-case <caseId> --project <projectId> -e <stagingEnvId> -r cli,json --out-file repro-before
Le rapporteur du CLI affiche l'échec de l'assertion de statut sur un 500, et repro-before.json se retrouve dans apidog-reports/. Après la correction, l'agent exécute la commande identique avec --out-file repro-after et les deux assertions passent. Ces deux fichiers constituent les preuves de la pull request. Pour l'étape 4, il exécute tous les cas de l'endpoint afin que la correction ne casse pas discrètement un voisin :
apidog test-case run --project <projectId> --endpoint <endpointId> -e <stagingEnvId> -r cli,json
Ajoutez --upload-report pour afficher l'exécution dans l'application Apidog. Après la fusion, le cas de reproduction reste dans votre projet en tant que test de régression, et le même apidog run avec -r junit s'intègre dans le CI, comme montré dans exécuter Apidog CLI dans un pipeline CI/CD. Pour d'autres configurations, consultez le workflow d'agent Apidog CLI et Apidog CLI dans Claude Code. Apidog Free couvre jusqu'à 4 utilisateurs, vous pouvez donc essayer toute la boucle sans plan payant.
FAQ
Un agent IA peut-il vraiment corriger des bugs sans humain ?
Il peut reproduire, patcher et prouver de nombreux bugs simples tout seul, mais il ne doit pas les fusionner. Gardez un humain sur la fusion, et laissez la protection des branches l'imposer.
Que faire si l'agent ne parvient pas à reproduire le bug ?
Il s'arrête et journalise ce qu'il a tenté. Un bug qu'il ne peut pas reproduire est une correction qu'il ne peut pas confirmer, tout patch serait donc une supposition. Un humain ajoute ensuite des détails au rapport ou le clôture.
Comment empêcher l'agent de modifier le test pour le faire passer ?
Enregistrez une copie ou un hash du cas de test lors de son premier échec et comparez avant d'accepter la correction. Gardez le fichier de test hors des chemins que le worker peut modifier.
Ai-je besoin de DeepSeek Harness pour construire cela ?
Non. L'essai décrit une conception, et son plugin prototype n'est pas un produit officiel DeepSeek. N'importe quel agent de code capable d'exécuter des commandes shell convient, y compris Claude Code dans GitHub Actions. Consultez ce qu'est DeepSeek Harness si vous voulez l'essayer là-bas.