
Jev هو نوع جديد من النماذج من TypeSafe AI. لا يكتب نصوصًا. أنت تقدم له جزءًا من حالة البرنامج، وتعلن عن الأسئلة التي تحتاج إلى إجابة، وهو يعيد إجابات مطبوعة باحتمالات معايرة: احتمال نعم/لا، اختيار من قائمة، أو درجة على مقياس. تُطلق TypeSafe على هذا اسم "نموذج النظام الأول"، والفكرة بسيطة: معظم استدعاءات الذكاء الاصطناعي داخل البرامج لا تطلب نثرًا، بل تطلب قرارًا. إذا كنت قد قمت بتوصيل LLM بمصنف ثم كتبت محللًا لاستخراج تسمية من رده، فإن Jev مصمم خصيصًا لهذه المهمة، تمامًا كما كانت المخرجات المنظمة خطوة أولى نحو ذلك.
لقد أصبح متاحًا على Vercel AI Gateway في 16 سبتمبر 2026، وهذا ما جعله في متناول معظم المطورين. يغطي هذا الدليل ماهية Jev، وكيف يختلف عن نموذج اللغة، وأنواع الأسئلة الثلاثة، وكيفية استدعائه مباشرة ومن خلال Gateway، وكيفية اختباره ومحاكاته في Apidog قبل أن يلامس منطق التوجيه الخاص بك.
ما هو Jev
يصف منشور إطلاق TypeSafe Jev بأنه "استدعاء دالة ذكاء رائد: حالة غير منظمة كمدخل، قرارات احتمالية مطبوعة كمخرج." تحدده ثلاث خصائص.
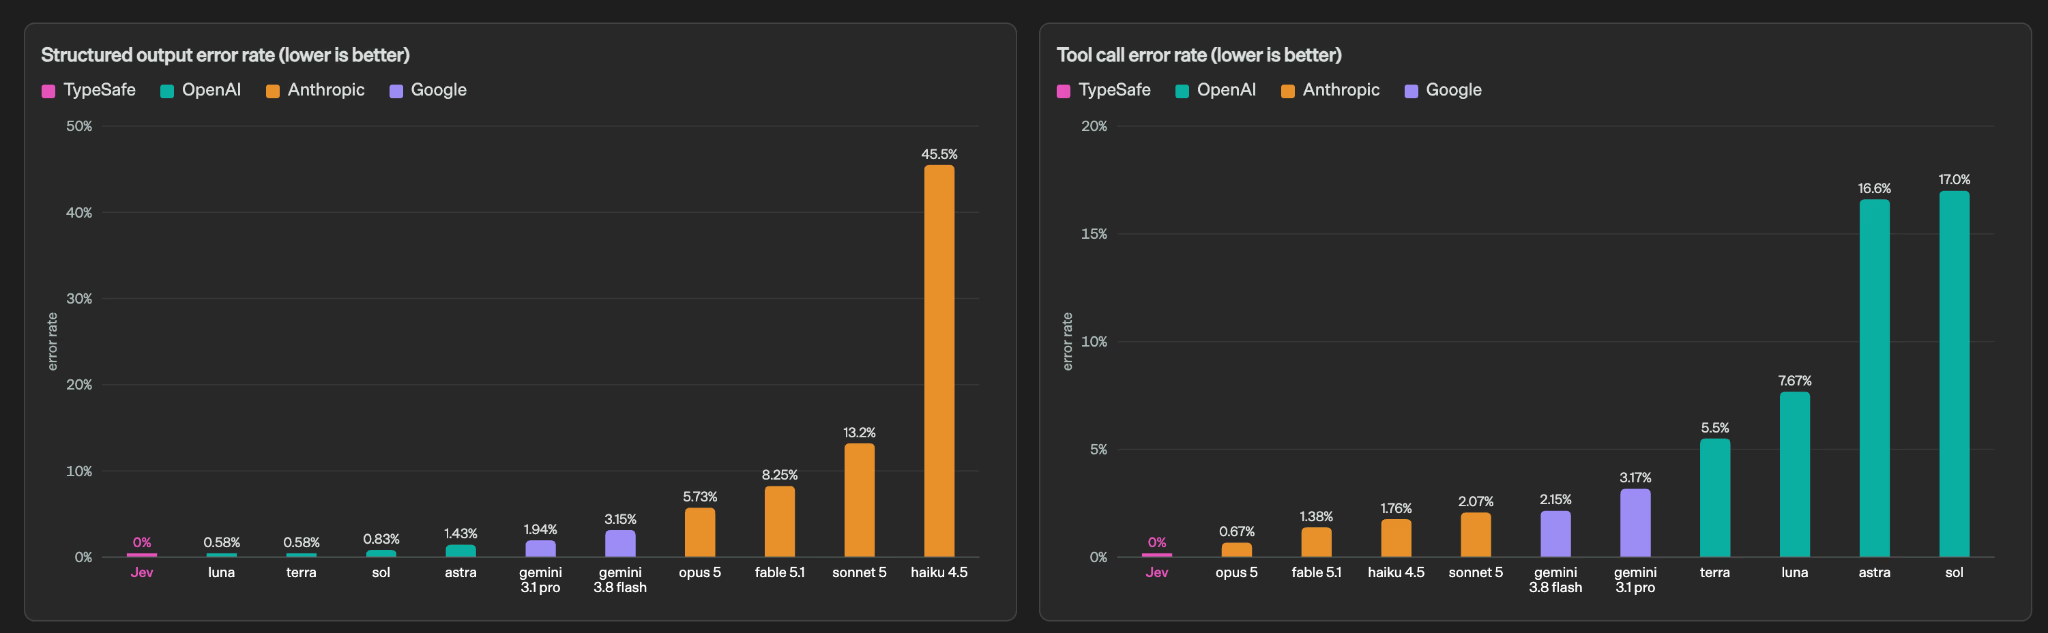
المخرجات مطبوعة، ومعلنة قبل الاستدعاء. تحدد شكل كل سؤال مسبقًا. يمكن للنموذج الإجابة فقط داخل هذا الشكل، لذلك لا يوجد شيء لتحليله ولا يوجد عدم تطابق في المخطط لاكتشافه. كلمة TypeSafe لهذا هي أن Jev "لا يُحدث أخطاء في النوع أبدًا."
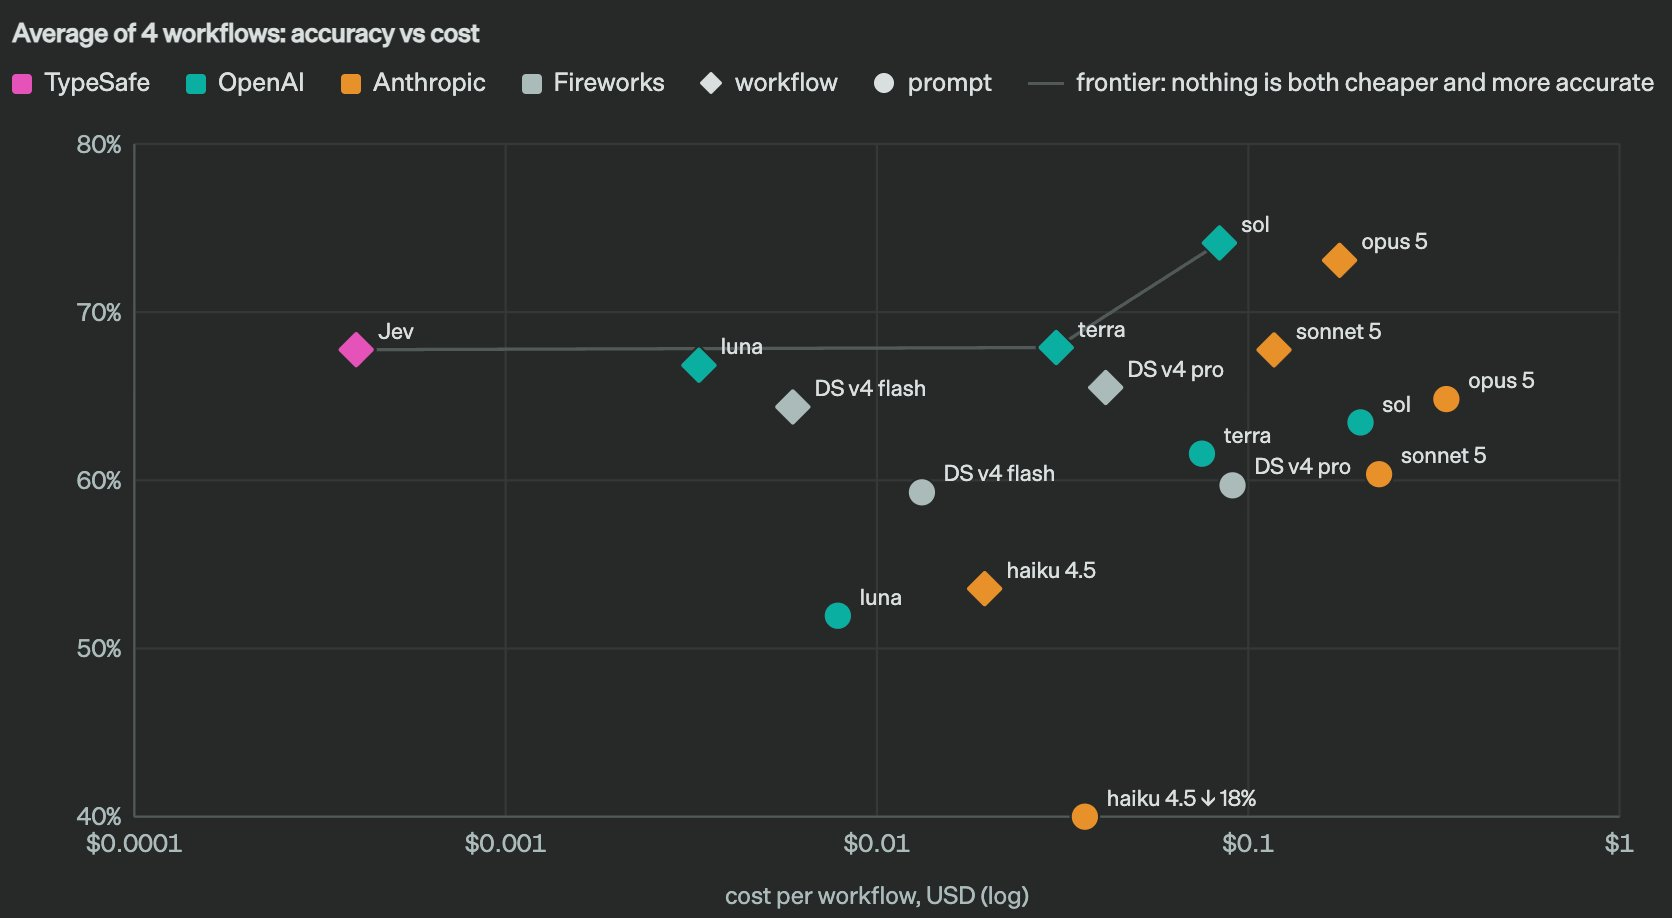
كل إجابة تحمل احتمالًا. سؤال نعم/لا لا يُرجع true؛ بل يُرجع رقمًا مثل 0.97. يُرجع الاختيار التوزيع الكامل عبر الخيارات. قامت TypeSafe بتدريب النموذج بطريقة تسميها التعلم المعزز للقرارات المعايرة، ويزعمون أن الثقة العالية تعني دقة أعلى، لذا يمكنك تحديد عتبة: أتمتة الحالات الواضحة، وتوجيه الحالات غير المؤكدة إلى إنسان.
يتم الإجابة على الأسئلة بالتوازي، في طلب واحد. ينتج نموذج اللغة رمزًا واحدًا في كل مرة. يُقيّم Jev كل سؤال مُعلن مرة واحدة مقابل نفس الحالة، وهذا هو السبب في أن TypeSafe تشير إلى أوقات استجابة شاملة تتراوح من 70 مللي ثانية إلى 500 مللي ثانية. هذه هي أرقام البائع نفسه؛ تعامل معها كادعاء للتحقق منه مقابل عبء العمل الخاص بك، وليس معيارًا.
كيف يختلف Jev عن نموذج اللغة
| نموذج اللغة | Jev | |
|---|---|---|
| المخرجات | نص حر تقوم بتحليله | قيم مطبوعة قمت بالإعلان عنها |
| المعاينة | متسلسلة، رمزًا تلو الآخر | جميع الأسئلة بالتوازي |
| الثقة | غير مكشوفة افتراضيًا | احتمال على كل إجابة |
| الأفضل في | الكتابة، الدردشة، التلخيص | التقييم، التوجيه، التسجيل، التحقق |
| المدخلات | الرسائل | حالة منظمة: سلسلة نصية، كائن، أو مصفوفة |
| الصور | غالبًا مدعومة | نص فقط، في الوقت الحالي |
المقايضة واضحة: يتخلى Jev تمامًا عن توليد السلاسل النصية. إنه ليس نموذج دردشة ولن يلخص مستندًا. حيث يتناسب هو "بيان if الذكي" داخل التطبيق: أي فريق يتعامل مع هذه التذكرة، ما مدى خطورة هذا الخلل، هل هذه الرد آمن للإرسال، هل اجتاز البناء.
أنواع الأسئلة الثلاثة
تكشف واجهة برمجة تطبيقات Jev المباشرة عن ثلاث بدائيات. كل منها عبارة عن كائن JSON تحت مفتاح تختاره.
Noul: احتمال نعم/لا. اسم TypeSafe للنوع المنطقي. يُرجع احتمال أن تكون الإجابة نعم، وتقوم بتحديد عتبتها في الكود.
{ "is_urgent": { "type": "noul", "instructions": "هل تعبر هذه الرسالة عن إلحاح؟" } }
الاستجابة: { "type": "noul", "noul": 0.99 }.
Choice: اختر خيارًا واحدًا من مجموعة مسماة. criteria تُعيّن أسماء الخيارات إلى وصفها، بحد أقصى 255 خيارًا. تحمل الإجابة الاختيار الأعلى بالإضافة إلى التوزيع الكامل ورقم الثقة.
{ "department": { "type": "choice", "instructions": "أي فريق يجب أن يتعامل مع هذا؟",
  "criteria": { "billing": "الرسوم، الفواتير، مشاكل الدفع",
                "shipping": "حالة التسليم، التأخيرات، الطرود المفقودة",
                "returns":  "الاستبدالات، المبالغ المستردة، العناصر التالفة" } } }
الاستجابة: { "type": "choice", "choice": "returns", "confidence": 1.0, "probabilities": { "returns": 1.0, "shipping": 0.0, "billing": 0.0 } }.
Score: موقع على مقياس مرتب. criteria هي مصفوفة من 2 إلى 10 أوصاف للمستوى، الأقل أولاً. النتيجة هي الموقع المرجح بالاحتمال، لذا يمكن أن تقع بين المستويات.
{ "bug_severity": { "type": "score", "instructions": "ما مدى خطورة المشكلة المبلغ عنها؟",
  "criteria": [ "تجميلي؛ لا يوجد تأثير على الوظائف",
                "ميزة معطلة، ولكن يوجد حل بديل",
                "مشكلة حجب؛ لا يوجد حل بديل" ] } }
الاستجابة: { "type": "score", "score": 1.3, "confidence": 0.54, "probabilities": { "0": 0.0, "1": 0.7, "2": 0.3 }, "legend": { "0": "تجميلي...", "1": "معطل...", "2": "حجب..." } }.
تفصيل تسمية واحد: من خلال Vercel AI SDK، يُسمى نوع نعم/لا boolean ويُسمى حقل الإجابة probability. مقابل واجهة برمجة تطبيقات TypeSafe الخاصة بها، يُسمى noul. نفس الفكرة، مفتاح مختلف.
طريقتان لاستدعاء Jev
مباشرةً. احصل على مفتاح من console.typesafe.ai/settings/keys، ثم أرسل POST https://api.typesafe.ai/v1/systemone مع رمز Bearer. معرف النموذج هو jev-latest، والذي يُحل حاليًا إلى jev-1.13.0؛ يشير jev-preview إلى أحدث إصدار، رسميًا أو غير رسمي. توجد حزم SDK بلغة Python و JavaScript، وفقًا لـ دليل البدء السريع، ولكن نقطة النهاية الخام هي طلب POST واحد، وهو الشكل الذي سنستخدمه في Apidog.
عبر Vercel AI Gateway. معرف النموذج هو typesafe-ai/jev وتستدعيه باستخدام experimental_evaluate من AI SDK (الإصدار 7 أو أحدث). تحذير واحد من وثائق التقييم: التقييم متاح عبر AI SDK فقط، وليس عبر نقاط النهاية المتوافقة مع OpenAI أو Anthropic في Gateway. إذا كنت تقوم بالفعل بتوجيه النماذج عبر Gateway، كما في دليلنا GPT-5.6 Sol على AI Gateway، فهذا هو المسار الطبيعي؛ يغطي دليلنا Vercel AI SDK الإعداد.
import { experimental_evaluate as evaluate } from 'ai';

const result = await evaluate({
  model: 'typesafe-ai/jev',
  state: 'The support agent issued a full refund to the customer.',
  questions: { refunded: { type: 'boolean', instructions: 'هل تم إصدار رد أموال؟' } },
});
// result.answers.refunded -> { type: 'boolean', probability: 0.99 }
طلبك الأول باستخدام curl
يقوم هذا بفرز رسالة دعم بجميع الأنواع الثلاثة في مكالمة واحدة:
export TYPESAFE_API_KEY="..."

curl -X POST https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-latest",
    "state": "لقد تم خصم مبلغ مرتين من بطاقتي لطلب واحد وأحتاج إلى إصلاح ذلك اليوم.",
    "questions": {
      "department": { "type": "choice", "instructions": "أي فريق يتعامل مع هذا؟",
        "criteria": { "billing": "رسوم واسترداد", "shipping": "توصيل", "technical": "أخطاء" } },
      "urgency": { "type": "score", "instructions": "ما مدى إلحاح هذا؟",
        "criteria": ["منخفض", "متوسط", "مرتفع"] },
      "wants_refund": { "type": "noul", "instructions": "هل يطلب العميل استعادة المال؟" }
    }
  }'
تحتوي الاستجابة على model، وكائن answers مفتاحًا بواسطة معرفات أسئلتك، و usage مع input_tokens و output_tokens. اقرأ answers.department.choice، answers.urgency.score، و answers.wants_refund.noul، ثم طبق عتباتك.
اختبار ومحاكاة Jev في Apidog
نموذج يُرجع احتمالات يغير شكل الاختبار. لم تعد تؤكد سلسلة نصية؛ أنت تؤكد أن الرقم يتجاوز حدًا معينًا. يجعل Apidog هذا فحصًا محفوظًا وقابلًا للتكرار بدلاً من أمر curl لمرة واحدة.
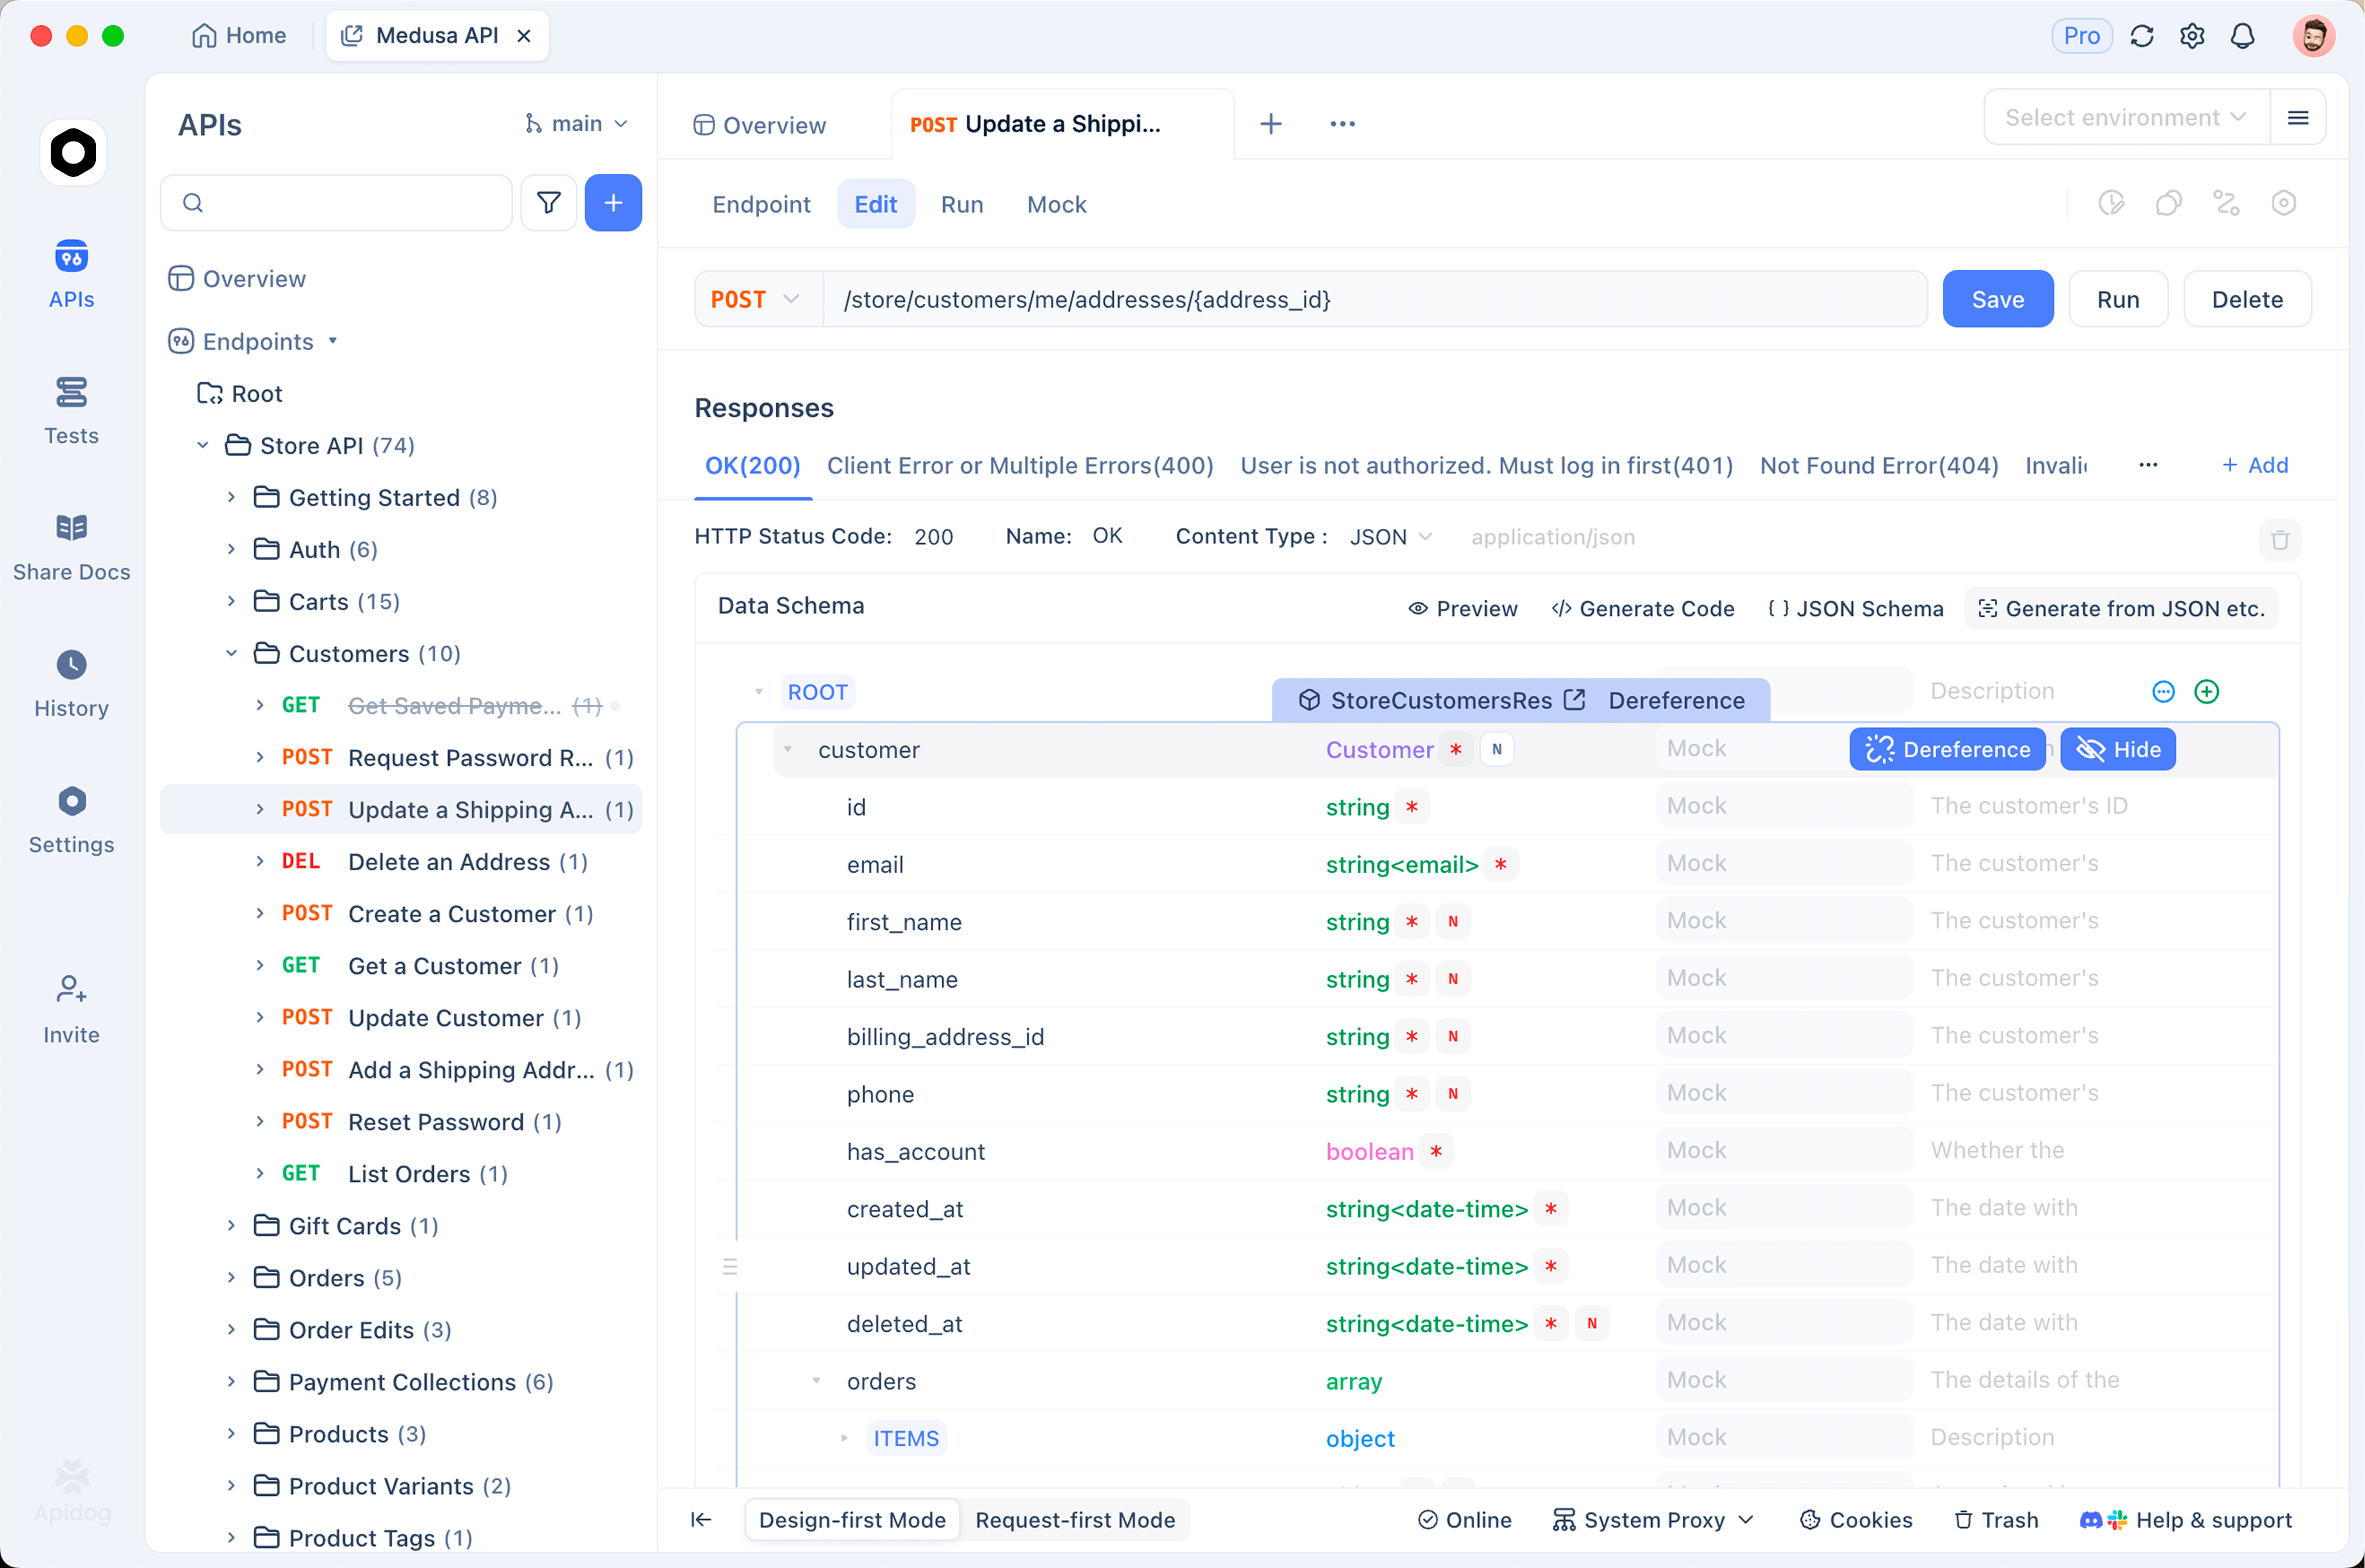
تخزين المفتاح. افتح إدارة البيئة، أنشئ بيئة باسم TypeSafe، وأضف TYPESAFE_API_KEY بالقيمة الحقيقية في الحقل المحلي، بحيث يبقى على جهازك ولا تتم مزامنته أبدًا مع الفريق. يغطي دليلنا حول البيئات والمتغيرات السرية قواعد النطاق.
إنشاء الطلب. طلب جديد، POST https://api.typesafe.ai/v1/systemone، نوع المصادقة Bearer Token مع {{TYPESAFE_API_KEY}}، نص JSON من مثال curl. أرسله واقرأ الإجابات في لوحة الاستجابة.
التحقق من القرار، وليس النص. أضف تأكيدات ما بعد المعالجة مثل answers.department.choice يساوي billing، answers.wants_refund.noul أكبر من 0.9، و answers.urgency.score أكبر من 1.5. الآن، أي تراجع في سلوك Jev، أو في صياغة معاييرك الخاصة، سيؤدي إلى فشل الاختبار بدلاً من توجيه التذاكر بشكل خاطئ بصمت.
محاكاة ذلك للواجهة الأمامية. احفظ الاستجابة كنموذج وهمي، ويمكن بناء واجهة المستخدم لتذاكرك وعرضها بناءً على كائن answers مستقر دون إنفاق رموز أو انتظار النموذج. نظرًا للإعلان عن الشكل، لا يمكن أن تختلف الاستجابة الوهمية والحقيقية.
احفظه كسيناريو. قم بسلسلة بعض الحالات، رسالة هادئة، رسالة غاضبة، رسالة غامضة، وتأكد من انخفاض الثقة في الحالة الغامضة. هذا هو الفحص الذي يخبرك أن عتبتك تؤدي وظيفتها. قم بتنزيل Apidog لإعداد هذا؛ الخطة المجانية تغطي فريقًا من أربعة أفراد.
التسعير، القيود، والأخطاء
من صفحة نماذج TypeSafe:
- السعر: 0.042 دولار لكل مليون رمز إدخال. لا يتم فرض رسوم على رموز الإخراج. يدرج Gateway نفس السعر 0.042 دولار لكل مليون إدخال.
- حدود المعدل: 250,000 رمز في الثانية و 1,200 طلب في الدقيقة، يتم تعديلها ديناميكيًا.
- السياق: 64 ألف رمز لكل طلب، منها 32 ألف لـ
stateبالإضافة إلى أطول سؤال. - الإدخال: نص فقط. سلسلة نصية، كائن JSON، أو مصفوفة من النصوص. لا صور، صوت، أو فيديو.
- اللغة: الإنجليزية هي الأفضل؛ اللغات الأخرى تعمل بدقة أقل.
تأتي الأخطاء كرموز حالة HTTP: 401 لمفتاح مفقود أو غير صالح، 422 عندما يفشل التحقق من صحة النص (درجة بمستوى واحد، اختيار بدون معايير)، 429 لحدود المعدل، و 529 عندما تكون الخدمة محملة بشكل زائد. تراجع وأعد المحاولة في الحالتين الأخيرتين؛ تقوم حزم SDK بذلك افتراضيًا.
الأسئلة الشائعة
هل Jev بديل لنموذج لغوي كبير (LLM)؟
لا. إنه يحل محل جزء من استدعاء نموذج لغوي كبير حيث كنت تطلب قرارًا وتقوم بتحليل النص للحصول عليه. لا تزال عملية التوليد والدردشة والتلخيص تحتاج إلى نموذج لغوي.
هل يمكن أن يُهلوس Jev؟
يمكن أن يكون خاطئًا، لكنه لا يستطيع إنتاج إجابة خارج المخطط الذي أعلنته. حجة TypeSafe هي أن مطابقة المخطط مضمونة، لذا فإن التسمية "المُهلوسة" مستحيلة؛ لا يزال من الممكن الحصول على تسمية خاطئة ذات ثقة منخفضة، وهذا هو سبب أهمية الاحتمال.
ماذا يعني "معاير" عمليًا؟
إذا قال النموذج 0.9، فيجب أن يكون صحيحًا في حوالي 90% من الوقت في هذا النوع من الأسئلة. هذا ما يتيح لك اختيار عتبة وأتمتة ما فوقها. اختبره على بياناتك الخاصة قبل الثقة بالرقم؛ سيناريو محفوظ في Apidog مع حالات مصنفة هو طريقة رخيصة للقيام بذلك.
هل أحتاج إلى Vercel لاستخدام Jev؟
لا. تعمل واجهة برمجة التطبيقات المباشرة على api.typesafe.ai بمفتاح Bearer الخاص بها. Vercel AI Gateway هي وسيلة راحة إذا كنت تستخدم بالفعل AI SDK، وهي المسار الوحيد الذي يدعم experimental_evaluate. في كلتا الحالتين، من المفيد معرفة أساسيات JSON Schema وراء الأشكال المعلنة.
أين يتناسب Jev
استخدم Jev عندما يكون للسؤال مجموعة ثابتة من الإجابات وتحتاج إلى احتمال معها: التوجيه، التصنيف، التسجيل، التحقق، الحواجز الوقائية. احتفظ بنموذج لغتك لكل ما يحتاج إلى كلمات. أعلن عن الشكل، واختبر العتبات في Apidog، ودع رقم الثقة يقرر ما يتم أتمتته.