
Grok 4.6 هو نموذج اللغة الرائد من xAI، تم إطلاقه في 12 أغسطس 2026. يبني هذا النموذج على Grok 4.5 مع التركيز على الوكلاء طويلي الأمد، والترميز الوكيل، والعمل التفاعلي أو المرئي، ويوفر نافذة سياق بحجم 500,000 رمز بتكلفة 2 دولار لكل مليون رمز إدخال و 6 دولارات لكل مليون رمز إخراج. في مؤشر ذكاء التحليل الاصطناعي، يسجل النموذج 61 نقطة، مما يضاهي GPT-5.6 Sol من OpenAI ويتأخر بنقطة واحدة فقط عن Claude Fable 5 من Anthropic، مما يجعله أرخص نموذج حاليًا في طليعة الذكاء.
هذه هي الإجابة في فقرة واحدة. يغطي باقي هذا المنشور ما تغير بالفعل عن Grok 4.5، وما تعنيه أرقام المعايير، وأين يمكنك استخدام النموذج اليوم، وماذا يعني ذلك بالنسبة لك إذا كنت تبني تطبيقات تعتمد على واجهات برمجة تطبيقات نماذج اللغة الكبيرة (LLM APIs). إذا كنت ضمن هذه الفئة الأخيرة، فإن Apidog يوفر لك مساحة عمل مجانية لتصميم واختبار ومحاكاة استدعاءات LLM API، وهو أمر مفيد لتجربة Grok 4.6 دون الحاجة إلى كتابة عميل أولاً.
ملخص سريع
- تاريخ الإصدار: 12 أغسطس 2026، من xAI.
- التركيز: الوكلاء ذوو الأفق الطويل، والترميز متعدد الخطوات، والعمل التفاعلي والمرئي. تقول xAI إن النموذج يختبر ويتحقق من عمله بنفسه بشكل متكرر قبل المتابعة.
- المواصفات: نافذة سياق 500 ألف رمز، تاريخ قطع المعرفة 1 فبراير 2026.
- الأسعار: 2 دولار / 1 مليون رمز إدخال، 6 دولارات / 1 مليون رمز إخراج. يتوفر إصدار أسرع بتكلفة مضاعفة (2x). يأتي الأسبوع الأول مع ضعف الاستخدام المضمن (2x) في Grok Build و Cursor.
- المعايير: مؤشر الذكاء 61 (يتعادل مع GPT-5.6 Sol)، قفزات كبيرة على DeepSWE (54 ← 65.9) و APEX-Agents (47.1 ← 57.5) مقارنة بـ 4.5.
- أين يمكن استخدامه: xAI API، Grok Build، Cursor، OpenRouter، Vercel، و Cloudflare.
Grok 4.6 في لمحة
| المواصفات | Grok 4.6 |
|---|---|
| المطور | xAI |
| تاريخ الإصدار | 12 أغسطس 2026 |
| نافذة السياق | 500,000 رمز |
| تاريخ قطع المعرفة | 1 فبراير 2026 |
| سعر الإدخال / الإخراج | 2 دولار / 6 دولارات لكل مليون رمز |
| النسخة السريعة | 2x السعر |
| مؤشر الذكاء | 61 (GPT-5.6 Sol: 61، Claude Fable 5: 62) |
| التوفر | xAI API، Cursor، Grok Build، OpenRouter، Vercel، Cloudflare |
ما الجديد فعلاً مقارنة بـ Grok 4.5
Grok 4.6 ليس كشفًا عن بنية معمارية جديدة، بل هو قصة تدريب. وفقًا لـ xAI، خضع النموذج لدورة تدريب تكميلية أطول من Grok 4.5، مع ثلاثة مكونات تقوم بالعمل الشاق:
- بيانات منسقة تم إنشاؤها بواسطة النموذج تستهدف الاستدلال والمفاهيم التقنية المتقدمة.
- مجموعات بيانات هندسية عالية الجودة، استمرارًا للنظام الغذائي الغني بالترميز الذي بدأ عندما بدأت xAI في التدريب على جلسات تطوير حقيقية.
- مُحسِّن ووصفة تدريب محسّنة، مع مسارات ضبط دقيقة خاضعة للإشراف تم إعادة إنشائها عبر مجالات الاستدلال والمجالات المتخصصة.
التغيير السلوكي الذي سيلاحظه المطورون هو التحقق الذاتي. أثناء تشغيل الوكلاء لفترات طويلة، يتحقق Grok 4.6 من عمله قبل الانتقال إلى الخطوة التالية، ويقوم بتشغيل الاختبار الذي كتبه للتو، ويعيد قراءة الملف الذي قام بتحريره للتو، بدلاً من المضي قدمًا بناءً على افتراض غير متحقق منه. تشير xAI أيضًا إلى محاولات أولى أقوى في المشاريع التفاعلية والمرئية: تخرج لوحات المعلومات والتطبيقات الصغيرة وعمل واجهة المستخدم أقرب إلى أن تكون قابلة للاستخدام من المحاولة الأولى.
إذا كان نهج تدريب Grok 4.5 يثير اهتمامك، فإن تحليلنا لـ ما يعنيه تدريب جلسات Cursor للمطورين يغطي السلالة التي يبنى عليها هذا النموذج.
المعايير، مع الفروقات المهمة
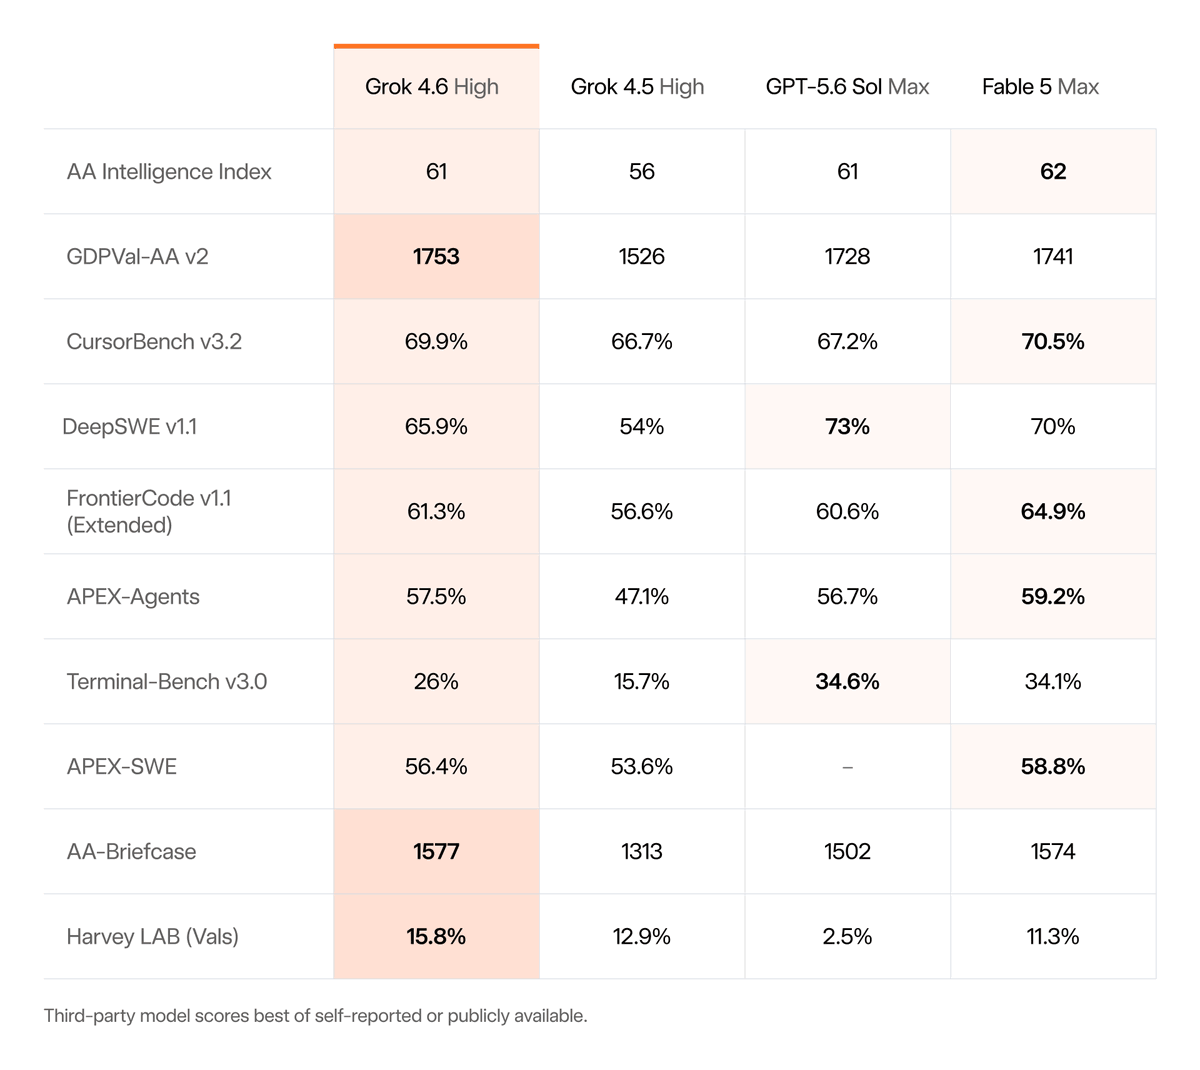
أرقام إطلاق البائعين تستدعي الشك، لكن الفروقات من 4.5 إلى 4.6 كبيرة بما يكفي لتكون ذات مغزى. هذه هي الصورة، بما في ذلك موقف المنافسة:
ثلاث نقاط رئيسية:
- تقلصت فجوة الوكيل. قفزة 10.4 نقطة في APEX-Agents تنقل Grok من "متأخر بوضوح" إلى ضمن 1.7 نقطة من Fable 5 Max، ومتقدمًا قليلاً على GPT-5.6 Sol Max (56.7%).
- تحسن الترميز على مستوى المستودعات بشكل كبير. ارتفاع DeepSWE بما يقارب 12 نقطة هو الفارق بين نموذج يتعثر في التغييرات متعددة الملفات ونموذج يتنافس، على الرغم من أن Sol Max لا يزال يتصدر هذا المعيار بفارق كبير.
- الأرقام المستقلة تدعم القصة. قيست Artificial Analysis متوسط تكلفة 0.84 دولار لكل مهمة في تقييماتها الوكيلة، وهي الأدنى بين النماذج الرائدة، وتصنيف Elo 1753 على GDPval-AA v2 لعمل المعرفة الاحترافي.
للحصول على سياق حول كيفية قراءة إصدارات معايير xAI، والمحاذير التي انطبقت على الجيل الماضي أيضًا، راجع تحليل معايير Grok 4.5 لدينا.
الأسعار: ميزة القيمة في الطليعة
حافظ Grok 4.6 على تسعيرة Grok 4.5: 2 دولار لكل مليون رمز إدخال، 6 دولارات لكل مليون رمز إخراج. مقارنة بالنماذج التي يتنافس معها الآن، هذا فرق صارخ:
| النموذج | سعر الإخراج / 1 مليون رمز |
|---|---|
| Grok 4.6 | 6 دولارات |
| Claude Opus 4.8 | 25 دولارًا |
| GPT-5.6 Sol | 30 دولارًا |
هذا فرق بمقدار 5 أضعاف في نهاية الإخراج مقابل GPT-5.6 Sol لنموذج يتعادل معه في مؤشر الذكاء المركب. الرموز الرخيصة لا تعني تلقائيًا مهام رخيصة، فالتشغيل الأضعف الذي يحتاج إلى مراجعة وإصلاح يكلف أكثر من فاتورة رموزه، لكن بيانات التكلفة المستقلة لكل مهمة تشير إلى أن الكفاءة حقيقية، وليست مجرد سعر ملصق منخفض.
النسخة الأسرع بسعر 2x (4 دولارات / 12 دولارًا) تستهدف الاستخدام التفاعلي الحساس للكمون. وحتى 19 أغسطس، يحصل مستخدمو Grok Build و Cursor على ضعف الاستخدام المضمن (2x) لاختبار النموذج.
أين يمكنك استخدام Grok 4.6 اليوم
- xAI API عبر console.x.ai، متوافق مع OpenAI. دليل Grok 4.5 API الخاص بنا ينطبق مباشرة؛ ما عليك سوى تغيير اسم النموذج.
- Cursor، متاح كخيار نموذج؛ نشرت Cursor ملاحظات الإطلاق الخاصة بها جنبًا إلى جنب مع xAI.
- Grok Build، مساحة العمل الوكيلة الخاصة بـ xAI، مع مكافأة الاستخدام المضاعف (2x) في أسبوع الإطلاق.
- OpenRouter، Vercel، و Cloudflare، للفرق التي توجه نماذج متعددة عبر بوابة واحدة؛ مدرج باسم
x-ai/grok-4.6على OpenRouter.
لا يوجد طرح منفصل للمستهلكين للتشابك هنا: هذا إصدار موجه للمطورين أولاً، وأسرع طريقة لتقييمه هي من خلال واجهة برمجة التطبيقات (API) أو بيئة تطوير متكاملة (IDE) تدعمه بالفعل.
القيود والأسئلة المفتوحة
يجب أن يقدم تقييم أسبوع الإطلاق لك المحاذير إلى جانب الأرقام الرئيسية:
- المعايير معظمها مبلغ عنها من قبل البائع. لقد نشرت Artificial Analysis نتائج مستقلة تتفق بشكل عام، لكن أرقام الترميز المحددة (DeepSWE، FrontierCode، CursorBench) تأتي من جدول إطلاق xAI الخاص. لم تصمد أرقام إطلاق Grok 4.5 إلا جزئيًا تحت الاختبار المستقل؛ افترض بعض الانحدار نحو المتوسط هنا أيضًا.
- نافذة السياق هي الأصغر في الطليعة. 500 ألف رمز تغطي معظم أعباء العمل الحقيقية، لكن GPT-5.6 Sol يقدم 1.05 مليون و Claude Fable 5 يقدم مليون. إذا كنت تعالج مستودعات أحادية كاملة أو مجموعات مستندات ضخمة في استدعاء واحد، فإن هذه الفجوة مادية.
- Sol لا يزال يتصدر حيث يكون الأمر أصعب. عجز DeepSWE البالغ 7 نقاط يعني أن العمل المستقل بالكامل عبر قواعد بيانات التعليمات البرمجية الكبيرة الموجودة لا يزال أقوى على GPT-5.6 Sol Max، وهذا هو العبء العملي الأكثر قيمة اقتصاديًا للوكيل.
- نضج النظام البيئي متأخر. معالجة الدفعات، وطبقات تخزين الأوامر المؤقتة، وعناصر التحكم في الاستخدام على منصة xAI أحدث من ما يعادلها في OpenAI و Anthropic. تغطي توافقية OpenAI معظم الأمر، ولكن ليس كله.
لا شيء من هذه الأمور يلغي أهليته. إنها تحدد مكانة Grok 4.6: خيار السعر مقابل الأداء الذي تقيمه بجدية، وليس الخيار الافتراضي الذي تعتمده بناءً على السمعة.
ماذا يعني هذا لمطوري واجهة برمجة التطبيقات (API)
القراءة الاستراتيجية: أصبح للطليعة الآن منافس حقيقي من حيث السعر. حتى هذا الإصدار، كان تحقيق مخرجات بمستوى GPT-5.6 Sol يعني دفع 25-30 دولارًا لكل مليون رمز إخراج. Grok 4.6 يقوم بذلك مقابل 6 دولارات، مما يغير الحسابات في حلقات الوكيل بشكل خاص، فالوكيل الذي يقوم بـ 40 استدعاء نموذج لكل مهمة يشعر بفرق 5 أضعاف في سعر الإخراج على الفور.
عمليًا، تعني واجهة برمجة التطبيقات المتوافقة مع OpenAI أن تقييمها يكلف فترة بعد الظهر، وليس سباقًا سريعًا. وجه عميلك الحالي إلى https://api.x.ai/v1، وقم بتشغيل عبء عملك الحقيقي عليه، وقارن النتائج. قم بإعداد هذه المقارنة في Apidog ويمكنك الاحتفاظ بطلبات GPT-5.6 و Claude و Grok 4.6 جنبًا إلى جنب في مشروع واحد، مع بيئات لكل مزود وتأكيدات تتحقق من جودة الإخراج واستخدام الرمز والكمون عبر الثلاثة، وهي أدلة مفيدة قبل الالتزام بعبء عمل إنتاجي لأي منها.
تركيز النموذج على الوكيل يرفع أيضًا من أهمية صحة استدعاء الأدوات. إذا كان تكاملك مع Grok يتضمن استدعاءات وظائف، فاختبر الحمولة التي يولدها، وليس فقط النص الذي يكتبه.
الأسئلة الشائعة
ما هو Grok 4.6 في جملة واحدة؟ هو نموذج xAI الرائد لشهر أغسطس 2026، مُعدل للوكلاء طويلي الأمد والترميز، مع نافذة سياق بحجم 500 ألف رمز ونتائج معيارية رائدة بتكلفة تعادل خُمس سعر إخراج المنافسين تقريبًا.
هل Grok 4.6 أفضل من GPT-5.6؟ يتعادلان في مؤشر ذكاء التحليل الاصطناعي برصيد 61 نقطة. يتصدر GPT-5.6 Sol Max في الترميز على نطاق المستودعات (DeepSWE)؛ يتفوق Grok 4.6 قليلاً في APEX-Agents ويكلف حوالي 5 أضعاف أقل لكل رمز إخراج.
ما الفرق بين Grok 4.5 و 4.6؟ نفس السعر، نفس واجهة برمجة التطبيقات، نموذج أفضل بشكل ملحوظ: +11.9 نقطة على DeepSWE، +10.4 على APEX-Agents، وميل جديد للتحقق الذاتي أثناء المهام الطويلة.
هل يمكنني تجربة Grok 4.6 مجانًا؟ يتضمن Grok Build و Cursor ضعف الاستخدام (2x) خلال أسبوع الإطلاق، والطرق الموضحة في دليلنا لاستخدام Grok 4.5 مجانًا تنطبق إلى حد كبير على 4.6.