
GPT-Live-1.1 هو نموذج OpenAI الصوتي ثنائي الاتجاه (full-duplex)، وهو متاح في واجهة الـ API منذ 20 نوفمبر 2026. يصغي أثناء حديثه، ويسلّم مهام الاستدلال واستدعاء الأدوات إلى نموذج خلفي من اختيارك، ويُحتسب بill به بالدقيقة: 0.05 دولار لكل دقيقة نشطة و0.02 دولار لكل دقيقة في وضع الاستعداد. تصل إليه عبر نقطة نهاية واحدة هي v1/live/sessions، وليس عبر Realtime API.
تناول منشورنا السابق حول ماهية GPT-Live ميزة الصوت في ChatGPT قبل أن يتمكن المطوّرون من استدعائها. يغطي هذا الدليل نموذج الـ API: ما الجديد فيه، وتكلفته، وكيف تعمل الجلسة، وكيف يقارن بـ GPT-Realtime.
ما هو GPT-Live-1.1؟
GPT-Live-1.1 نموذج صوتي يجري محادثة منطوقة في الوقت الفعلي بينما يتولى نموذج خلفي منفصل مهمة التفكير. يستقبل الصوت والنص، ويعيد الصوت والنص، ويواصل الإصغاء أثناء حديثه، حتى يتمكن المتصل من المقاطعة أو إضافة تفاصيل في منتصف الجملة. مُعرّفه (model ID) هو gpt-live-1.1، وهو يدعم البث (streaming) واستدعاء الدوال (function calling).
تصف صفحة نموذج GPT-Live-1.1 أنه «نموذج صوتي ثنائي الاتجاه للمحادثات متعددة اللغات». ثنائي الاتجاه يعني تدفق الصور الصوتية في الجهتين في آنٍ واحد، مثل مكالمة هاتفية، بدلاً من جهاز اللاسلكي الذي ينتظر فيه أحد الطرفين دورَه.
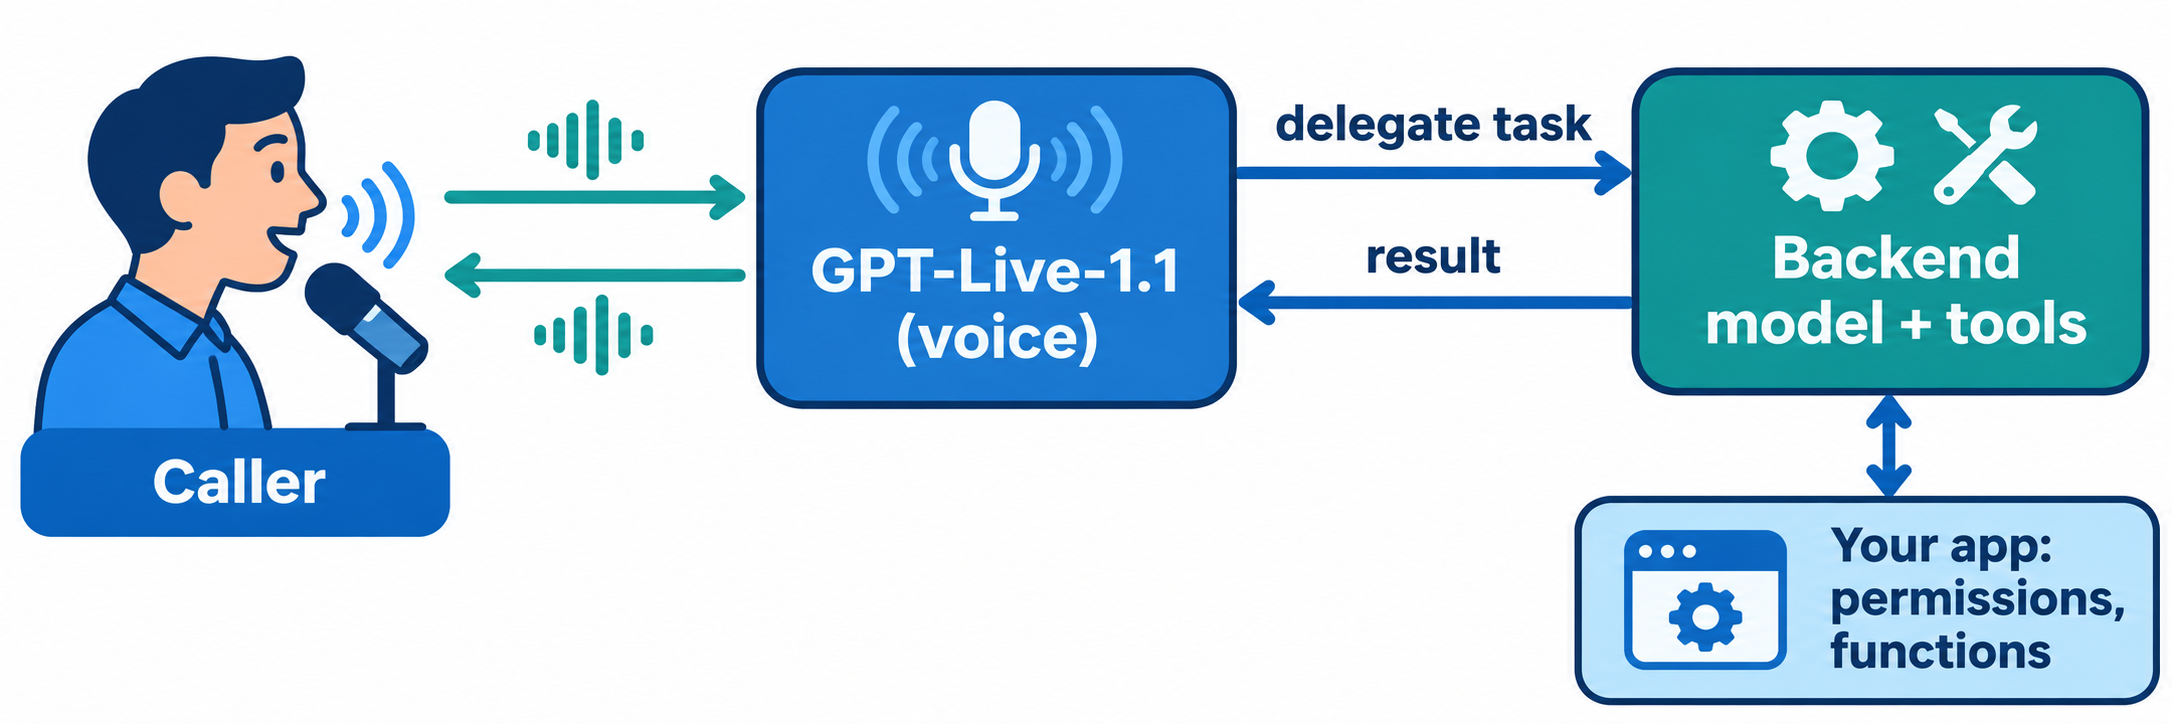
الجزء الآخر من التصميم هو التفويض. يقرر GPT-Live متى يحتاج الطلب إلى عمل حقيقي، فيرسله إلى نموذج خلفي (نموذج Responses من OpenAI أو وكيل خاص بك)، ويواصل الحديث أثناء عمل النموذج الخلفي، ثم يشرح النتيجة بصوت مسموع.
ما الذي تغيّر مقارنة بـ GPT-Live-1
يحافظ GPT-Live-1.1 على نقطة النهاية والأسعار ومجموعة الميزات نفسها التي توفرها GPT-Live-1. التغييرات تخص جودة الصوت والتعامل مع المهام. إليك ما يذكره OpenAI في وثائق النموذج وفي إعلانه على X:
| المجال | GPT-Live-1 | GPT-Live-1.1 |
|---|---|---|
| تحويل الكلام إلى نص | المستوى الأساسي | أدق، وفقًا لصفحة النموذج |
| اللكنة والصوت عبر اللغات | المستوى الأساسي | أكثر اتساقًا، وفقًا لصفحة النموذج |
| الجلسات الخاملة | سعر الاستعداد المذكور في صفحتها | أُعلن عن الاستعداد كخيار جديد بسعر 0.02 دولار/دقيقة |
| إتمام المهام | المستوى الأساسي | «يُتم المهام بموثوقية أكبر»، وفقًا لإعلان OpenAI |
| نقطة النهاية | v1/live/sessions |
v1/live/sessions |
| السعر (نشط) | 0.05 دولار/دقيقة | 0.05 دولار/دقيقة |
| حدود المعدل | جلسات متزامنة | حد منفصل للجلسات المتزامنة |
لم تنشر OpenAI أرقامًا مرجعية (benchmarks) لمكاسب تحويل الكلام إلى نص أو الموثوقية، لذا تعامل معها كادعاءات من المورّد حتى تقيسها بنفسك. كما أن إعلان OpenAI يصف الاستعداد بأنه جديد مع هذا الإصدار، بينما تُدرج صفحة GPT-Live-1 الآن سعر الاستعداد نفسه البالغ 0.02 دولار.
بما أن النموذجين يتشاركان نقطة النهاية والأسعار، فإن التبديل يبدأ بضبط حقل model في الجلسة إلى gpt-live-1.1. أعِد بعد ذلك تشغيل تقييمات الصوت الخاصة بك للتأكد من المكاسب على حركة البيانات الخاصة بك.
أسعار GPT-Live-1.1
تُحتسب جلسات GPT-Live-1.1 الصوتية بالمدة، لا بالرموز (tokens). وهذه هي الأسعار المذكورة في صفحة أسعار OpenAI، وقد تم التحقق منها في 20 نوفمبر 2026:
| المقياس | السعر |
|---|---|
| وقت الجلسة النشطة | 0.05 دولار لكل دقيقة |
| وقت الجلسة في وضع الاستعداد | 0.02 دولار لكل دقيقة |
| النموذج الخلفي والأدوات | تُحتسب بشكل منفصل بالأسعار العادية لذلك النموذج |
ثمة تفاصيل للفوترة مهمة عند تقدير التكاليف:
- الفوترة بالثانية. لا تُقرّب المدة لأقرب دقيقة كاملة.
- وضع الاستعداد يعمل مع WebRTC فقط. ينطبق السعر المنخفض على جلسات WebRTC أثناء إيقاف الاستدلال مؤقتًا.
- رسوم التهيئة. تُحتسب فوترة 15 ثانية عند إنشاء جلسة WebRTC أثناء الإعداد، وتُخصم من رسوم المدة بمجرد تشغيل الجلسة.
- النموذج الخلفي فاتورة ثانية. رموز Responses المفوَّض بها واستدعاءات الأدوات تُحتسب أيضًا.
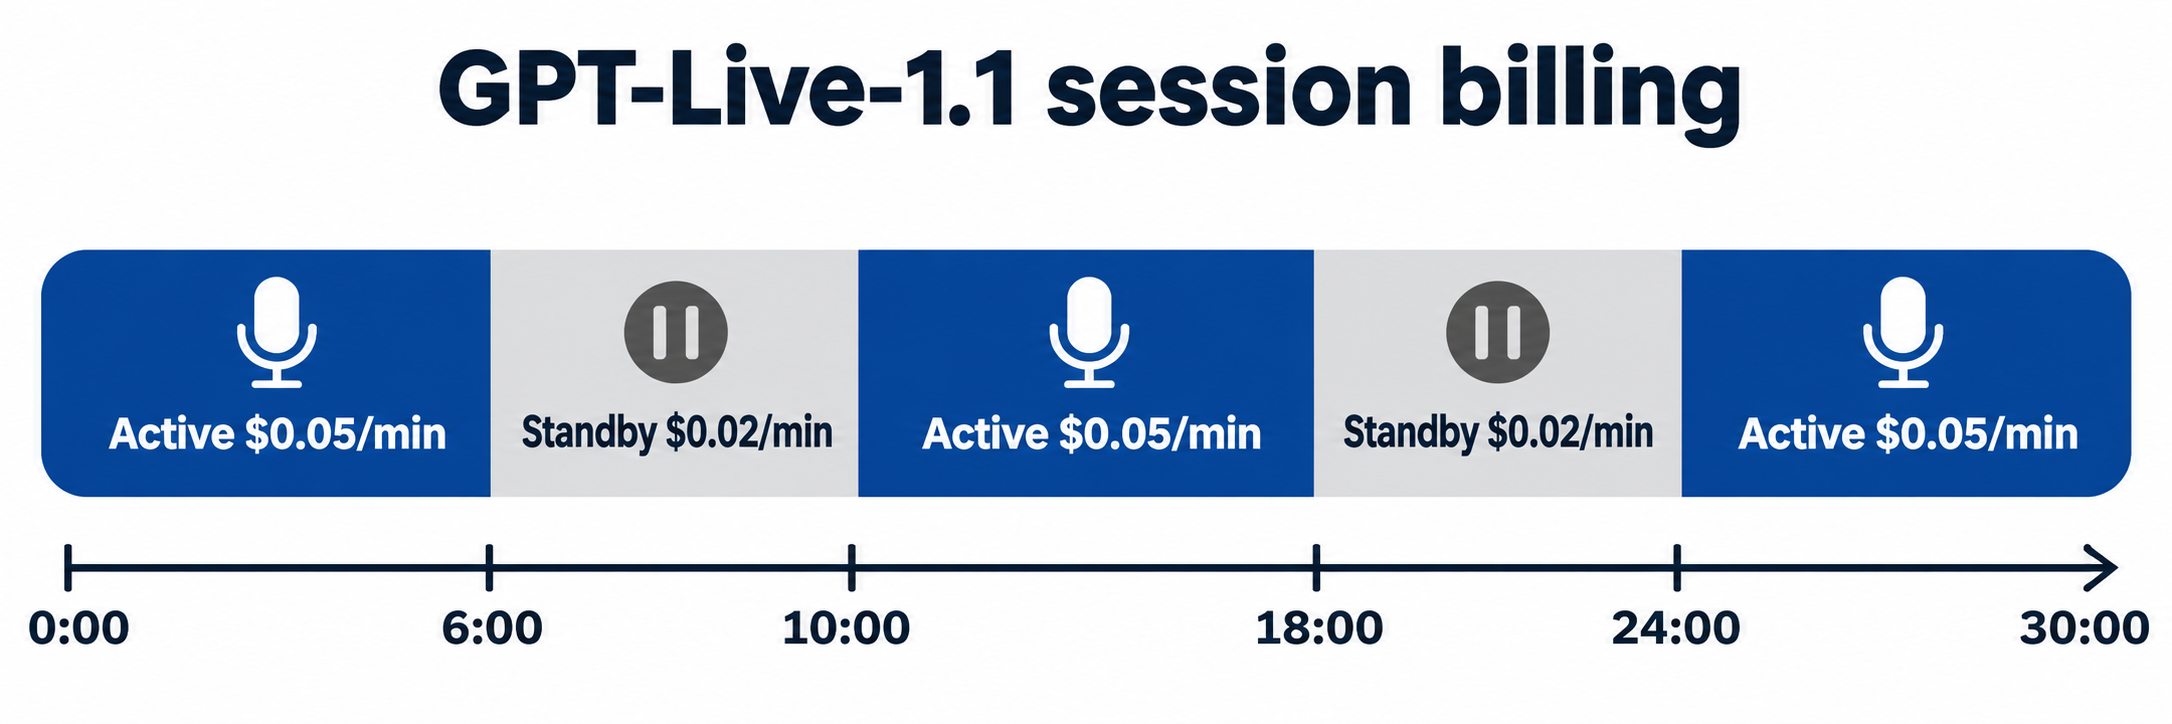
مثال محسوب من المخطط الزمني أعلاه: جلسة دعم مدتها 30 دقيقة تقضي 20 دقيقة في الوضع النشط و10 دقائق في وضع الاستعداد بينما يبحث المتصل عن شيء ما. تكلفة الصوت: 20 × 0.05 دولار + 10 × 0.02 دولار = 1.20 دولار. وبدون وضع الاستعداد، تكلّف الجلسة نفسها 30 × 0.05 دولار = 1.50 دولار. أضف إلى ذلك ما ينفقه النموذج الخلفي على المهام المفوَّضة إليه.
كيف يعمل GPT-Live-1.1: الصوت مع التفويض
يتكون تطبيق GPT-Live من جزأين. يقسّم دليل البدء هذين الجزأين كالتالي:
- يتولى GPT-Live المحادثة. يصغي ويتحدث ويقرر متى يطلب المساعدة من النموذج الخلفي. تمنحه تعليمات قصيرة حول أسلوب الحديث ومتى يفوّض.
- يتولى النموذج الخلفي المهام المفوَّضة. يستدل، ويستدعي الأدوات، ويعيد النتائج ليقولها GPT-Live بصوت مسموع. التعليمات التفصيلية وقواعد العمل وسير عمل الأدوات تقيم هنا.
- يتحمل تطبيقك الأجزاء الحساسة. يتحقق من الأذونات، ويجمع التأكيدات، ويشغّل الدوال التي تتعامل مع أنظمتك، ويحفظ تقدّم المهام.
تختار أحد نمطي تفويض عند إنشاء الجلسة، ولا يمكنك التبديل بين النمطين أثناء الجلسة:
| النمط | من يشغّل النموذج الخلفي | اختره عندما |
|---|---|---|
| تفويض Responses | تستدعي OpenAI نموذج Responses الذي تضبطه وتنقل السياق والنتائج | تريد أن يدير GPT-Live طلبات النموذج الخلفي نيابةً عنك |
| تفويض العميل | يشغّل تطبيقك أي نموذج أو وكيل أو خدمة ويعيد النتائج | تحتاج إلى التحقق من النتائج أو حجب بياناتها أو دمجها، أو استخدام نموذج خلفي غير تابع لـ OpenAI |
يوصي دليل التفويض بالبدء بتفويض Responses. أما تفويض العميل فيناسب الفرق التي تضيف صوتًا أمام وكيل نصي قائم.
أنشئ أول جلسة GPT-Live-1.1 لك
لدى GPT-Live نقطة نهاية خاصة به. تُدرج صفحة النموذج v1/live/sessions كنقطة نهاية مدعومة، وتضع علامة «غير مدعوم» على Chat Completions وResponses وv1/realtime. توصي OpenAI باستخدام WebRTC للصوت، مع WebSockets وSIP كبديلين.
تسير عملية WebRTC الموضحة في دليل البدء السريع في خمس خطوات:
- يطلب المتصفح الإذن بالوصول إلى الميكروفون ويضيف مساراته إلى اتصال نظير (peer connection).
- ينشئ قناة بيانات (data channel)، ثم ينشئ عرض SDP.
- يرسل المتصفح العرض إلى خادمك.
- يُرسل خادمك
sessionوtransport: { type: "webrtc", sdp }إلىPOST /v1/live/sessionsمع مفتاح الـ API الخاص بك. - يطبّق المتصفح إجابة SDP المرتجعة وينتظر الحدث
session.started.
وإليك استدعاء الخادم من مثال TypeScript الخاص بـ OpenAI، مقتطعًا إلى إعدادات الجلسة فقط:
const result = await client.live.create({
  session: {
    model: "gpt-live-1.1",
    instructions:
      "Be concise. Delegate requests needing current information to the backend, which can search the web.",
    delegation: {
      type: "responses",
      responses: {
        model: "gpt-5.6-terra",
        instructions:
          "Use web search when current facts are needed. Return concise, grounded results for a spoken conversation.",
        tools: [{ type: "web_search" }],
        tool_choice: "auto",
      },
    },
  },
  transport: { type: "webrtc", sdp: request.body.sdp },
});
احتفظ بمفتاح الـ API على الخادم، ولا ترسل session.start على قناة البيانات: فطلب HTTP يبدأ الجلسة بالفعل. توفر OpenAI أيضًا OpenAI Live Console، وهو تطبيق نموذجي محلي لمشاهدة المحادثات ونشاط التفويض وأدوات النموذج الخلفي.
وضع الاستعداد: خفّض تكاليف الخمول
يُبقي وضع الاستعداد اتصال WebRTC مفتوحًا عندما لا يتحدث أحد، ثم يستأنف الاستدلال عندما يتكلم شخص ما. يبقى الاتصال ومُعرّف الجلسة كما هما، وتعود سجل المحادثة عند استئناف الجلسة.
تفعّله بحقلين في إعدادات الجلسة:
{
  "session": {
    "model": "gpt-live-1.1",
    "wake_policy": { "type": "speech", "vad_threshold": 0.5 },
    "idle_timeout_s": 20
  }
}
wake_policy.type: "speech"ينتظر وجود كلام قبل بدء الاستدلال.idle_timeout_sيقبل عددًا صحيحًا من 5 إلى 60. بعد هذا العدد من الثواني دون أي نص مُدخل أو مُخرج، تنتقل الجلسة إلى وضع الاستعداد.vad_thresholdيتراوح من 0 إلى 1 وقيمته الافتراضية 0.5. القيم الأعلى تتطلب أدلة أقوى على وجود كلام للاستيقاظ.
استمع إلى الحدثين session.paused وsession.resumed لتتبع الحالة، وأبقِ مسار الميكروفون نشطًا. وهناك مقايضة مذكورة في دليل إدارة الجلسات: قد يستغرق أول رد على عبارة قصيرة بعد وضع الاستعداد وقتًا أطول. في حالة الفجوات الطويلة، قد يكون إغلاق الجلسة وبدء جلسة جديدة أقل تكلفة من وضع الاستعداد.
GPT-Live-1.1 مقابل GPT-Realtime
يضع دليل وكلاء الصوت من OpenAI الاختيار في إطار معماري. يناسب GPT-Live المحادثات ثنائية الاتجاه مع نموذج خلفي منفصل. أما Realtime API فيناسب نموذجًا واحدًا يسمع ويستدل ويستدعي الأدوات ويتحدث في جلسة واحدة.
| GPT-Live-1.1 | GPT-Realtime-2.1 | |
|---|---|---|
| نقطة النهاية | v1/live/sessions |
v1/realtime |
| التصميم | واجهة صوتية مع نموذج خلفي مفوَّض | نموذج واحد من الكلام إلى الكلام |
| المدخلات | صوت، نص | نص، صوت، صورة |
| الفوترة | 0.05 دولار/دقيقة نشطة، 0.02 دولار/دقيقة استعداد | بالرموز: 32 دولار للإدخال، 64 دولار للإخراج لكل مليون رمز صوتي |
| تكلفة النموذج الخلفي | تُحتسب بشكل منفصل | مضمّنة في سعر الرموز |
| الأفضل لـ | إضافة الصوت إلى وكيل نصي قائم | وكلاء صوت مستقلون بذاتهم |
يجعل الفوترة بالدقيقة تكاليف الصوت في GPT-Live سهلة التوقع للمكالمات الطويلة. أما فوترة الرموز في Realtime فتتبع حجم الصوت والنص المتدفق، وتدمج الاستدلال في سعر واحد. للاطلاع على نظرة أعمق للمقارنة السابقة، راجع GPT-Live مقابل GPT-Realtime ودليلنا حول GPT-Realtime-2 API.
حدود المعدل والوصول
تحسب حدود GPT-Live الجلسات المتزامنة، لا الرموز. تملك GPT-Live-1.1 وGPT-Live-1 حدودًا منفصلة تنطبق عبر مناطق الاستدلال كافة. تُدرج صفحة GPT-Live-1 خمسين جلسة متزامنة في الفئة Build، و300 في Launch، و500 في Grow، وتضع علامة «غير مدعوم» على الفئة المجانية (Free). صفحة GPT-Live-1.1 لم تنشر جدولها الخاص بعد، لذا تحقق من صفحة حدود مؤسستك قبل تخطيط حمل العمل.
اختبر خادم الجلسات باستخدام Apidog CLI
يحتوي تكامل GPT-Live لديك على واجهة HTTP تخصك: نقطة النهاية /api/session التي تبادل عروض SDP. يعيد مثال OpenAI رمز 403 عند وجود أصل (origin) غير متوقع، و400 عند غياب عرض SDP. هذه المسارات لا تصل إلى OpenAI إطلاقًا، لذا يمكنك اختبارها عند كل عملية commit وبدون أي تكلفة صوتية. دع وكيل البرمجة لديك يكتب الاختبارات ويشغّلها باستخدام Apidog CLI.
ثبّت الأداة، وسجّل الدخول، وأضف مهارة Apidog إلى وكيلك:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
ثم امنح وكيلك تعليمات واحدة:
In Apidog project <projectId>, add POST /api/session for my GPT-Live-1.1 server.
Create test cases that assert: a request with a wrong Origin header returns 403,
a request with no sdp field returns 400. Run them against the local environment
and summarize any failures.
يقرأ الوكيل المخططات (schemas)، ويتحقق من صحة بياناته، وينشئ نقطة النهاية وحالات الاختبار، ثم يشغّلها:
apidog cli-schema get endpoint-create
apidog endpoint create --project <projectId> --file ./endpoint.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file ./case.json
apidog test-case create --project <projectId> --file ./case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
الأمر نفسه apidog run مع -r junit يُدمج بسهولة في أنظمة CI؛ راجع تشغيل Apidog CLI في خط أنابيب CI/CD. وإذا كنت تستخدم Claude Code، فإليك دليل Apidog CLI في Claude Code الذي يشرح خطوات الإعداد. تغطي الخطة المجانية من Apidog فرقًا تصل إلى 4 مستخدمين.
الأسئلة الشائعة
هل GPT-Live-1.1 متاح في الـ API؟ نعم. أتاحت OpenAI نموذج GPT-Live-1.1 في الـ API في 20 نوفمبر 2026، بالمُعرّف gpt-live-1.1 على نقطة النهاية v1/live/sessions. منشورنا السابق حول GPT-Live API سبق هذا الإصدار.
كم يكلّف GPT-Live-1.1؟ 0.05 دولار لكل دقيقة نشطة و0.02 دولار لكل دقيقة في وضع الاستعداد، تُحتسب بالثانية. يُحتسب استخدام النموذج الخلفي والأدوات بشكل منفصل بأسعارهما العادية.
ما الفرق بين GPT-Live-1 وGPT-Live-1.1؟ يحوّل GPT-Live-1.1 الكلام إلى نص بدقة أكبر، ويحافظ على لكنة وصوت أكثر اتساقًا عبر اللغات، ويضيف خيار الاستعداد للجلسات الخاملة. أما الأسعار ونقطة النهاية فهي نفسها.
هل يمكن لـ GPT-Live-1.1 رؤية الصور؟ ليس بشكل مباشر. أرسل الصور إلى نموذج خلفي يدعم الرؤية، والذي يعيد نصًا لاستخدامه في GPT-Live.
هل يدعم GPT-Live-1.1 استدعاء الدوال؟ نعم. تُدرج صفحة النموذج البث واستدعاء الدوال. عمليًا، يتولى نموذجك الخلفي استدعاءات الأدوات عبر التفويض، ويشغّل تطبيقك أي دوال مخصصة.