
أعلنت DeepSeek عن إيقاف نموذجها الرئيسي واستبداله بأصغر نماذجها. في 10 سبتمبر 2026، أصبح DeepSeek-V4.1-Flash متاحًا بشكل عام (GA) على واجهة برمجة التطبيقات (API)، وتحتوي ملاحظة الإصدار على سطر قد تفضل معظم المختبرات إخفاءه: ابتداءً من 14 سبتمبر، سيتم توجيه كل طلب إلى deepseek-v4-pro إلى V4.1-Flash وسيتم محاسبته بأسعار Flash. أصبح نموذج Flash ذو الـ 552 مليار معلمة، مع 8 مليارات معلمة نشطة عند الإدخال، مسؤولاً الآن عن عائلة V4 بأكملها.
هذه هي القصة وراء عمليات البحث عن "deepseek v4.1 flash" هذا الأسبوع، وهي مهمة لسببين. أولاً، المعمارية جديدة. إن تقسيم المُشفر-المُفكك السببي (Causal Encoder-Decoder)، والتخزين المؤقت FP4 KV بحجم 890 بايت لكل رمز، والرؤية الأصلية من خطوة التدريب المسبق الأولى ليست تغييرات تدريجية لـ DeepSeek V4. ثانياً، قائمة الأسعار تغيرت معها. إذا كنت تدفع أسعار V4-Pro، فستنخفض فاتورتك بنسبة 70% أو أكثر في الرابع عشر من الشهر سواء قمت بتغيير أي شيء أم لا.
يغطي هذا الدليل ما تم إصداره، وكيف تعمل المعمارية بلغة المطورين، وما تقوله معايير البائع، وحسابات التسعير. ويختتم بسير عمل لاختبار النموذج مقابل مطالباتك الخاصة في Apidog، لأن جدول المقارنات هو نقطة بداية، وليس حكمًا نهائيًا.
ملخص سريع
- DeepSeek-V4.1-Flash متاح بشكل عام (GA) اعتبارًا من 10 سبتمبر 2026. معرف النموذج:
deepseek-flash. عنوان URL الأساسي لم يتغير عندhttps://api.deepseek.com. - 552 مليار معلمة بنظام MoE (763 مليار مع مُشفر الرؤية)، 8 مليارات نشطة للملء المسبق (prefill)، و16 مليار نشطة لفك التشفير (decode). سياق 1 مليون، و384 ألف كحد أقصى للإخراج.
- وفقًا لأرقام DeepSeek الخاصة، فإنه يتفوق على V4-Pro في HumanEval وGSM8K وDeepSWE وTerminal-Bench.
- الأسعار في أوقات الذروة: 0.30 دولار لكل مليون إدخال غير موجود في ذاكرة التخزين المؤقت (cache-miss input)، و1.20 دولار لكل مليون مخرج. خارج أوقات الذروة يكون السعر نصف ذلك.
- سيتم إعادة توجيه طلبات V4-Pro إلى V4.1-Flash في 14 سبتمبر الساعة 04:00 بالتوقيت العالمي المنسق (UTC).
ما تم إصداره في 10 سبتمبر
أجرت DeepSeek نسخة بيتا داخلية لمدة يومين اعتبارًا من 8 سبتمبر تحت اسم النموذج deepseek-v4.1-flash-expires-on-0910، بحد أقصى 20 طلبًا متزامنًا لكل حساب وبنفس سعر deepseek-v4-flash. أفادت TechNode عن تلك النسخة التجريبية. بعد يومين، أصبح النموذج متاحًا بشكل عام (GA)، مع إدخال في سجل التغييرات مؤرخ في 2026-09-10 وإعلان على X.
ثلاثة تغييرات في التسمية تهم الكود الخاص بك:
- معرف النموذج الجديد هو
deepseek-flash. استخدمه للتكاملات الجديدة. - الأسماء القديمة
deepseek-v4-flashوdeepseek-v4-flash-vision-expلا تزال تعمل، ولكن يتم خدمتها بواسطة V4.1-Flash. تم إيقاف V4-Flash وV4-Flash-Vision-Exp كنماذج منفصلة. deepseek-v4-proسيستمر بالعمل حتى 14 سبتمبر، ثم سيتم توجيهه إلى V4.1-Flash.
لم تتغير عناوين URL الأساسية: https://api.deepseek.com لتنسيق OpenAI، وhttps://api.deepseek.com/anthropic لتنسيق Anthropic. كانت واجهة برمجة تطبيقات الاستجابات مدعومة بالفعل في خط Flash، لذلك تنتقل التكاملات بنمط Codex. للحصول على تفاصيل المعلمات، بما في ذلك إدخال الصور وجهد التفكير، راجع كيفية استخدام DeepSeek-V4.1-Flash API.
معمارية المشفر-المفكك السببي للمطورين
تصف بطاقة النموذج تصميمًا تسميه DeepSeek المُشفر-المُفكك السببي (Causal Encoder-Decoder)، أو CED. إليك ما يعنيه كل رقم عندما تكون أنت من يدفع مقابل الرموز المميزة.
552 مليار معلمة، 763 مليار مع الرؤية. العمود الفقري للغة هو نموذج خليط من الخبراء (mixture-of-experts) يضم 552 مليار معلمة. أضف مُشفر DeepSeek-ViT، الذي تم تدريبه من الصفر لهذا الإصدار، ويصل النموذج الكامل إلى 763 مليار معلمة. هذه هي المعلمات المخزنة، وليس تكلفة الطلب.
8 مليارات نشطة للملء المسبق (prefill)، 16 مليار نشطة لفك التشفير (decode). هذا هو التغيير الأبرز. تنقسم الطبقات الأربعون إلى 20 طبقة مُشفرة و20 طبقة مُفككة. قراءة مطالبتك (الملء المسبق) تنشط حوالي 8 مليارات معلمة لكل رمز مميز. كتابة الإجابة (فك التشفير) تنشط حوالي 16 مليار معلمة. استخدمت نماذج DeepSeek MoE السابقة ميزانية واحدة للمعلمات النشطة لكلا المرحلتين.
لماذا يهم هذا التقسيم؟ الملء المسبق (Prefill) مقيد بالحوسبة: تدفع وثيقة بحجم 200 ألف رمز مميز عبر النموذج في تمريرة واحدة. فك التشفير (Decode) مقيد بالذاكرة: تُولد رمزًا مميزًا واحدًا في كل مرة، والتكلفة هي قراءة الأوزان وذاكرة التخزين المؤقت KV من HBM. عدد أقل من المعلمات في الملء المسبق يقلل من وقت أول رمز مميز في المدخلات الطويلة. المزيد في فك التشفير يشتري جودة الإجابة حيث تكون الحوسبة الإضافية رخيصة نسبيًا لحركة الذاكرة. مسار وكيل بسياق 1 مليون ينتج ردًا من 2 ألف رمز مميز يسلك المسار الأرخص لـ 99.8% من رموزه.
384 خبيرًا موجهًا بالإضافة إلى خبير مشترك واحد لكل طبقة. يختار الموجه عددًا قليلاً من أصل 384 خبيرًا لكل رمز مميز، ويعمل الخبير المشترك في كل مرة. هكذا تتحول 552 مليار معلمة مخزنة إلى 8 مليارات أو 16 مليار معلمة نشطة.
CSA2 وذاكرة التخزين المؤقت FP4 KV. تأتي تقنية الانتباه المتناثر المضغوط 2 (Compressed Sparse Attention 2) بثلاثة أوضاع انتباه ثابتة. مقترنة بتخزين FP4 لذاكرة التخزين المؤقت الرئيسية KV، يبلغ حجم الذاكرة المؤقتة العالمية 890 بايت لكل رمز، أي حوالي ربع حجم DeepSeek-V4-Flash. تشير ملاحظة الإصدار إلى أنها تستهلك 1/4 ذاكرة HBM و1/8 مساحة تخزين SSD للجيل السابق. عند 890 بايت لكل رمز، يتطلب سياق كامل بحجم 1 مليون رمز حوالي 0.9 جيجابايت من ذاكرة التخزين المؤقت KV. وهذا جزء من سبب تحديد حد التزامن بـ 2,500 لـ Flash مقابل 500 لـ Pro.
سياق 1 مليون، ومخرج 384 ألف. تم تدريب الانتباه المتناثر (sparse attention) على 64 ألفًا وتم توسيعه إلى 1 مليون عند علامة 34 تريليون رمز من مجموعة بيانات متعددة الوسائط بحجم 45 تريليون رمز. يوصف جهد التفكير بأنه قابل للتحكم المستمر على مقياس من 1 إلى 100؛ شكل معلمة API الدقيق لهذا المقياس هو [تحقق] مقابل الوثائق.
المقاييس المعيارية: ما أبلغت عنه DeepSeek
كل رقم في هذا القسم هو من إبلاغ DeepSeek من بطاقة النموذج. لم يتم نشر أي تقييم مستقل حتى 10 سبتمبر. اقرأها على أنها ادعاء البائع، ثم قم بإجراء اختباراتك الخاصة.
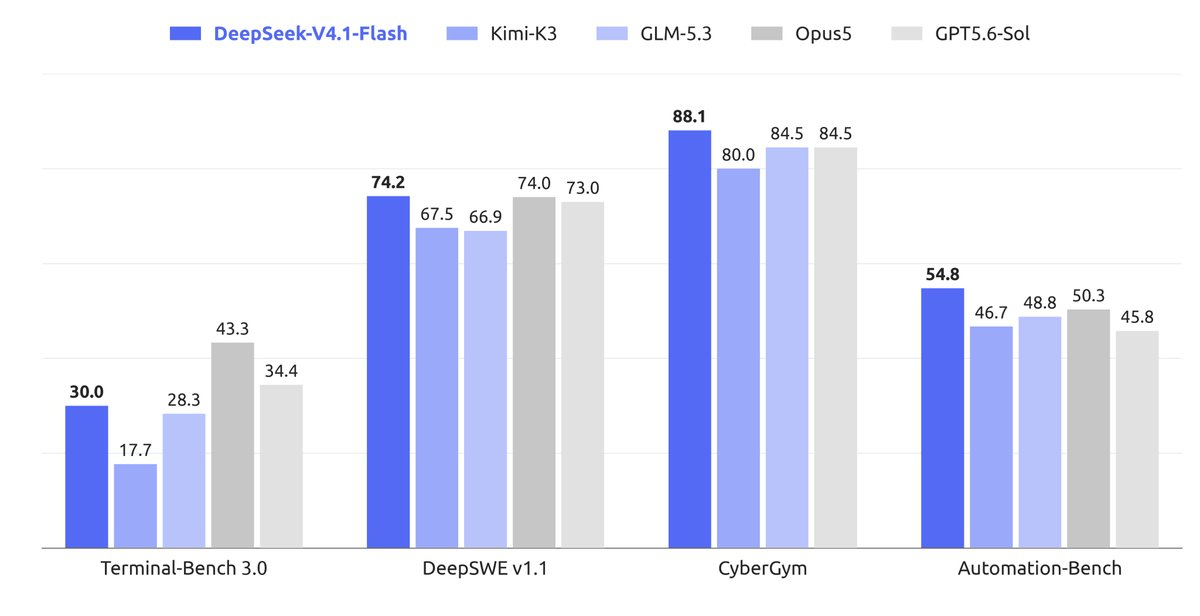
النمط ثابت: V4.1-Flash يتجاوز V4-Pro في كل صف، مع أوسع فجوة في البرمجة الوكيلة (agentic coding). قفز DeepSWE بمقدار 11.5 نقطة فوق Pro وما يقرب من 20 نقطة فوق Flash القديم. GSM8K مشبع، لذلك فإن فارق الـ 0.4 نقطة لا يخبرك بالكثير.
نتائج الرؤية، وهي أيضًا من تقارير البائع: MMMU-Pro 56.5، CVBench 77.9، DocVQA 95.6، RefCOCO 86.0. DocVQA هو الرقم الذي يجب مراقبته، نظرًا لأن تحليل المستندات هو المكان الذي تذهب إليه معظم حركة مرور الرؤية في الإنتاج.
صياغة DeepSeek لإعادة توجيه V4-Pro هي أن V4.1-Flash "تجاوز V4 Pro بشكل شامل في الأداء والتكلفة والسرعة والوقت الإجمالي"، مستشهدة باختبارات أجرتها أطراف متعددة. لم يتم تسمية هذه الأطراف. تعامل مع هذه الجملة كادعاء يمكنك التحقق منه.
التسعير وإعادة توجيه V4-Pro
الأسعار أدناه مأخوذة من صفحة التسعير، وهي سارية اعتبارًا من 10 سبتمبر الساعة 04:00 بالتوقيت العالمي المنسق (UTC)، بالدولار الأمريكي لكل مليون رمز مميز.
| deepseek-flash خارج الذروة | deepseek-flash ذروة | deepseek-v4-pro خارج الذروة | deepseek-v4-pro ذروة | |
|---|---|---|---|---|
| الإدخال، نجاح التخزين المؤقت | $0.003 | $0.006 | $0.022 | $0.044 |
| الإدخال، فشل التخزين المؤقت | $0.15 | $0.30 | $0.66 | $1.32 |
| الإخراج | $0.60 | $1.20 | $1.98 | $3.96 |
أوقات الذروة هي من الساعة 01:00 إلى 04:00 ومن 06:00 إلى 10:00 بالتوقيت العالمي المنسق (UTC) في أيام الأسبوع؛ خارج أوقات الذروة يكون السعر 50% من سعر الذروة. التخزين المؤقت للسياق تلقائي، ويكلف نجاح التخزين المؤقت 50 ضعفًا أقل من الفشل في أي من المستويين.
مقارنة بأسعار V4-Flash في أغسطس، يقلل V4.1-Flash من تكلفة الإدخال (نجاح التخزين المؤقت) بنحو 57%، والإدخال (فشل التخزين المؤقت) بنحو 32%، والإخراج بنحو 9%.
العمود الخاص بـ V4-Pro هو الذي يجب مراقبته. بعد 14 سبتمبر، سيتم محاسبة الطلب المرسل إلى deepseek-v4-pro بأسعار عمود Flash. في أوقات الذروة، سيكون ذلك 0.30 دولار بدلاً من 1.32 دولار لكل مليون إدخال غير موجود في ذاكرة التخزين المؤقت (أقل بنسبة 77%) و1.20 دولار بدلاً من 3.96 دولار لكل مليون مخرج (أقل بنسبة 70%). تحصل على هذا التخفيض دون الحاجة إلى لمس الكود، على الرغم من أنه يجب عليك تحديث معرف النموذج على أي حال بدلاً من الاعتماد على اسم مستعار متقاعد. يستعرض دليل الترحيل قائمة التحقق، ويغطي تحليل التسعير المتعمق حسابات نجاح التخزين المؤقت لجلسات الوكيل الطويلة.
تقييم V4.1-Flash مقابل مطالباتك الخاصة في Apidog
يقول جدول البائع إن النموذج جيد في DeepSWE. لكنه لا يذكر ما إذا كان يتعامل مع مخطط الاستخراج الخاص بك، أو تنسيق استدعاء أداتك، أو نصوص دعمك البالغة 300 ألف رمز مميز. إليك سير عمل في Apidog يجيب على هذه الأسئلة في فترة ما بعد الظهر ويستمر في الإجابة عليها بعد كل تحديث صامت للنموذج.
- قم بتخزين المفتاح كمتغير بيئة. أنشئ بيئة Apidog وأضف
DEEPSEEK_API_KEYمن منصة DeepSeek. أشر إليه في عنوان Authorization كـBearer {{DEEPSEEK_API_KEY}}. - أضف نقطة النهاية. أنشئ
POST https://api.deepseek.com/chat/completions، أو استورد مواصفات OpenAPI. - احفظ طلبًا واحدًا لكل مطالبة حقيقية. خذ من خمس إلى عشر مطالبات من سجلات الإنتاج واحفظ كل منها كطلب خاص بها مع
"model": "deepseek-flash". احتفظ بنسخة موجهة إلىdeepseek-v4-proحتى الرابع عشر حتى تتمكن من مقارنة المخرجات جنبًا إلى جنب. - قم بالتدفق ومشاهدة الأحداث. اضبط
"stream": true. يعرض Apidog استجابات SSE حدثًا تلو الآخر، لذا تظهر فروق الاستدلال وفروق الإجابة بشكل منفصل بدلاً من كتلة من سطورdata:. إنها أسرع طريقة لمعرفة وقت أول رمز مميز عند الملء المسبق الطويل. - أضف تأكيدات وقم ببناء سيناريو اختبار. تأكد من رمز الحالة، ومن حقل
tool_callsحيث تتوقع واحدًا، ومن صحة JSON للمخرج. قم بربط الطلبات المحفوظة في سيناريو اختبار. - أعد التشغيل عند كل تحديث للنموذج. عندما تدفع DeepSeek التغيير التالي وراء
deepseek-flash، قم بتشغيل السيناريو. اربطه بـ CI باستخدامapidog-cliبحيث يعمل عند كل عملية نشر.
إليك نص إحدى تلك المطالبات المحفوظة، باستخدام OpenAI SDK:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["DEEPSEEK_API_KEY"],
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[
        {"role": "system", "content": "Extract the order ID, SKU list, and refund amount as JSON."},
        {"role": "user", "content": "Ticket #48213: customer wants a refund of $42.90 for SKUs KB-220 and MS-114 from order ORD-99117."},
    ],
    stream=True,
)

for chunk in response:
    if chunk.choices[0].delta.content:
        print(chunk.choices[0].delta.content, end="")
حمل Apidog والصق هذا النص في طلب محفوظ. يختبر Apidog طبقة API، وليس مضيف النموذج، لذا ما تراه هو الاستجابة التي سيحصل عليها المستخدمون.
الأسئلة الشائعة
هل DeepSeek-V4.1-Flash بديل لـ V4-Pro؟ نعم، بقرار من DeepSeek. اعتبارًا من 14 سبتمبر الساعة 04:00 بالتوقيت العالمي المنسق (UTC)، سيتم تقديم طلبات deepseek-v4-pro بواسطة V4.1-Flash بأسعار Flash. لم يتبق أي نموذج أكبر في تشكيلة V4 API.
هل أحتاج إلى تغيير معرف النموذج الخاص بي؟ ليس فورًا. deepseek-v4-flash و deepseek-v4-flash-vision-exp و (بعد الرابع عشر) deepseek-v4-pro كلها ستوجه إلى V4.1-Flash. انتقل إلى deepseek-flash في المرة القادمة التي تعدل فيها التكامل. يحتوي دليل API على المرجع الكامل للمعلمات.
ماذا يعني 8 مليارات للملء المسبق / 16 مليار لفك التشفير بالنسبة للكمون؟ عدد أقل من المعلمات النشطة عند الإدخال يعني وقتًا أسرع لأول رمز مميز في المطالبات الطويلة. المزيد عند الإخراج يعني أن الحوسبة تذهب إلى حيث يتم تحديد جودة التوليد. ذاكرة التخزين المؤقت KV بحجم 890 بايت لكل رمز تبقي الجلسات الطويلة رخيصة للاحتفاظ بها في الذاكرة.
هل يمكنني تشغيله محليًا؟ الأوزان مرخصة بترخيص MIT على Hugging Face. العمود الفقري وحده يبلغ حوالي 552 جيجابايت عند 8 بت أو 280 جيجابايت عند 4 بت، لذا هذا مشروع متعدد وحدات معالجة الرسوميات (GPU) أو دفق من SSD، وليس مشروعًا لجهاز كمبيوتر محمول. دعم محرك الاستدلال في اليوم الأول هو [تحقق].
هل المقاييس المعيارية مستقلة؟ لا. كل نتيجة أعلاه تأتي من بطاقة نموذج DeepSeek. يحتوي التقرير التقني على المنهجية.
ماذا يعني هذا لخط V4
جمعت DeepSeek واجهة برمجة تطبيقات (API) كانت تحتوي على نموذجين في نموذج واحد. الرهان هو أن نموذجًا بحجم 552 مليار معلمة بميزانية فك تشفير 16 مليار معلمة، وذاكرة تخزين مؤقت KV بربع الحجم، و2500 جلسة متزامنة لكل حساب يخدم أعباء عمل الوكلاء بشكل أفضل من نموذج أكبر بثلاثة إلى أربعة أضعاف السعر. أرقام البائع تدعم هذا الرهان؛ عبء عملك هو الذي يقرر ما إذا كان صامدًا.
وجه SDK الخاص بك إلى deepseek-flash، وقم بتشغيل مطالباتك الخاصة من خلاله قبل الرابع عشر، واحتفظ بسيناريو الاختبار. إذا كنت قد بنيت على واجهة برمجة تطبيقات V4-Flash الأصلية، فإن تكاملك يعمل بالفعل. ما تغير هو النموذج الكامن وراءه، وهذا هو الجزء الذي يستحق القياس.