
كلٌّ من Together AI وFireworks AI وGroq يبيعون العرض ذاته: وجّه عميل OpenAI الحالي لديك إلى عنوان URL أساسي جديد، واستبدل المفتاح، واحصل على نماذج مفتوحة الأوزان بجزء بسيط من التكلفة. هذا العرض صحيح. أما غير الصحيح فهو أن مقارنة طبقاتهم المجانية بسيطة كترتيب ثلاثة أرقام جنبًا إلى جنب، لأن اثنين من المزوّدين الثلاثة لا ينشران رقمًا ثابتًا على الإطلاق.
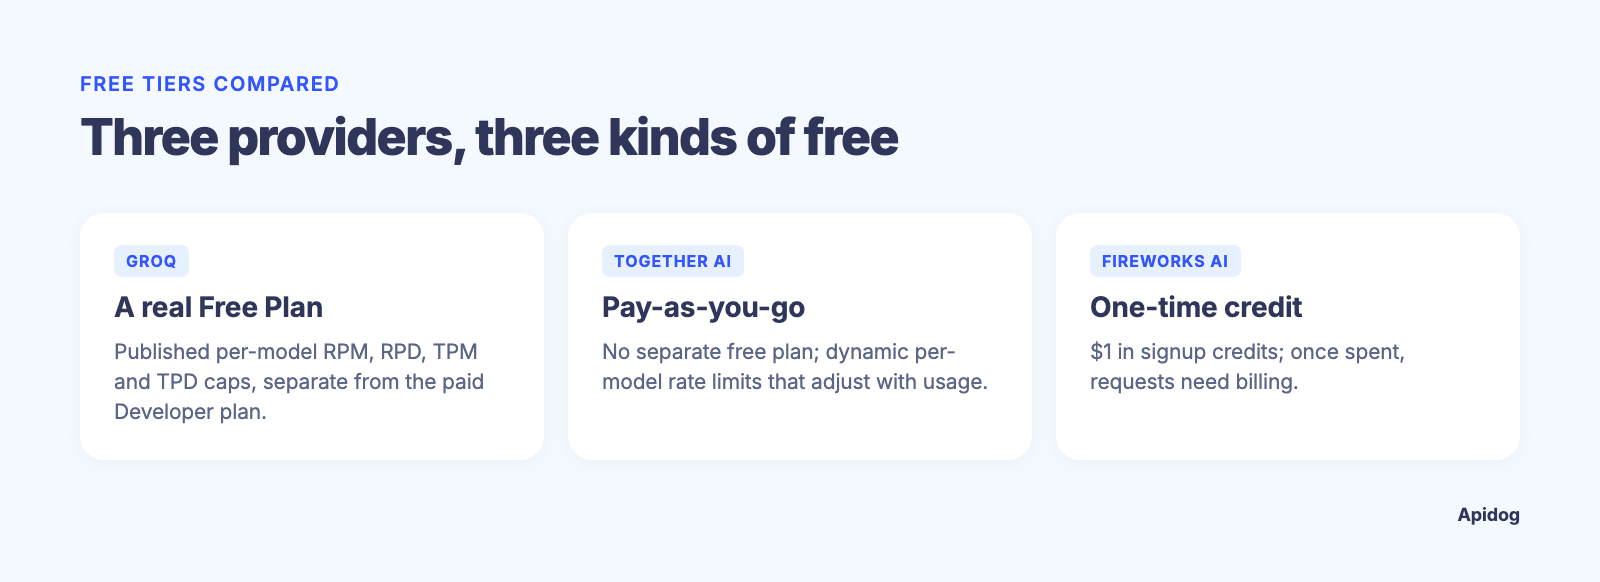
Groq هو الاستثناء: صفحة حدود المعدل لديه تنشر فعلاً أرقام الخطة المجانية الحقيقية، لكل نموذج، في تبويب يتخطاه معظم القرّاء في طريقهم إلى تبويب خطة المطوّر المجاور له. أما Together AI فقد أخبرنا بصراحة، في وثائقه الخاصة، أنه لا يملك حدودًا ثابتة لكل نموذج لينشرها؛ سقفك يتحرك مع استخدامك. ويربط Fireworks AI وصوله المجاني برصيد ائتماني لمرة واحدة بدلاً من طبقة خطة. ثلاثة تصاميم مختلفة، ومع ذلك لا تزال مقالة «أي طبقة مجانية أكبر» عاجزة عن اختزال ذلك في رقم واحد.
باختصار
كلٌّ من Groq وTogether AI وFireworks AI يوفّر نقطة نهاية متوافقة مع OpenAI، لذا فإن التنقل بينها هو عنوان URL أساسي ومفتاح API، وليس إعادة كتابة. يقسّم Groq الوصول إلى خطة مجانية وخطة مطوّر مدفوعة، وخلافًا للاثنين الآخرين، ينشر أرقامًا حقيقية للخطة المجانية لكل نموذج، مثل 30 RPM / 1K RPD / 8K TPM / 200K TPD على gpt-oss-120b وgpt-oss-20b. أما Together AI فلا ينشر أرقامًا ثابتة للطبقة المجانية؛ وتقول وثائقه إن الحدود تتحرك ديناميكيًا مع سعتك الحالية واستخدامك الناجح الأخير. ويمنح Fireworks AI الحسابات الجديدة رصيدًا ائتمانيًا لمرة واحدة (دولار واحد، وفقًا لصفحة أسعاره) بدلاً من مخصّص مجاني متكرر. والقرار الأهم من الرقم الرئيسي هو أي النماذج تحتاجها فعلاً وكيف يتصرف سقف كل مزوّد بمجرد أن تصل إليه. يتيح لك Apidog حفظ طلب واحد وتبديل عنوان URL الأساسي والمفتاح لكل بيئة، بحيث تقيس الثلاثة بنفسك بدلاً من الوثوق بجدول.
شكل API واحد، ثلاثة مفاتيح
يعمد المزوّدون الثلاثة عمدًا إلى محاكاة مخطط OpenAI Chat Completions. ولهذا تبدو أدلة الترحيل لهذه الأدوات متطابقة في كل مرة: غيّر base_url، وغيّر ترويسة Authorization، وأبقِ بقية الكود كما هو. القاعدة المتوافقة مع OpenAI لدى Groq هي https://api.groq.com/openai/v1/. ولدى Together AI هي https://api.together.ai/v1، كما هو مؤكد مباشرةً في وثائق البدء السريع الخاصة به. ولدى Fireworks AI هي https://api.fireworks.ai/inference/v1، وفقًا لـدليل التوافق مع OpenAI.
هذا الشكل المشترك هو سبب استحقاق إجراء اختبار مواجهة مباشر: فإضافة مزوّد رابع أو خامس تكلّف دقائق، لا إعادة تصميم. نغطي آليات إدارة هذا النوع من الإعداد متعدد المزوّدين في كيفية إدارة عناوين URL الأساسية عبر البيئات في Apidog، وإذا كنت تزن خيارات التوجيه على نطاق أوسع، فإن استعراضنا لبدائل OpenRouter يغطي مكان كلٍّ من هؤلاء الثلاثة في تلك الصورة.
ما يمكنك التحقق منه فعلاً بشأن كل طبقة مجانية
إليك المقارنة المبنية فقط على ما يصرّح به كل مزوّد علنًا حتى سبتمبر 2026. وحيث لا يفصح مزوّد عن رقم، يقول الجدول ذلك بدلًا من التخمين.
| Groq | Together AI | Fireworks AI | |
|---|---|---|---|
| نموذج الوصول المجاني | خطة مجانية (منفصلة عن خطة المطوّر المدفوعة) | الدفع حسب الاستخدام من التسجيل؛ لا يوجد اسم «خطة مجانية» منفصل | رصيد تسجيل لمرة واحدة |
| المخصّص المجاني الموثّق | منشور لكل نموذج: gpt-oss-120b/gpt-oss-20b بـ 30 RPM، 1K RPD، 8K TPM، 200K TPD؛ وcompound بـ 30 RPM، 250 RPD، 70K TPM (وفق حدود معدل Groq، اطُّلعت عليه في 2026-09-15) |
غير منشور كأرقام ثابتة؛ موصوف بأنه ديناميكي لكل مؤسسة | دولار واحد في أرصدة مجانية وفق أسعار Fireworks |
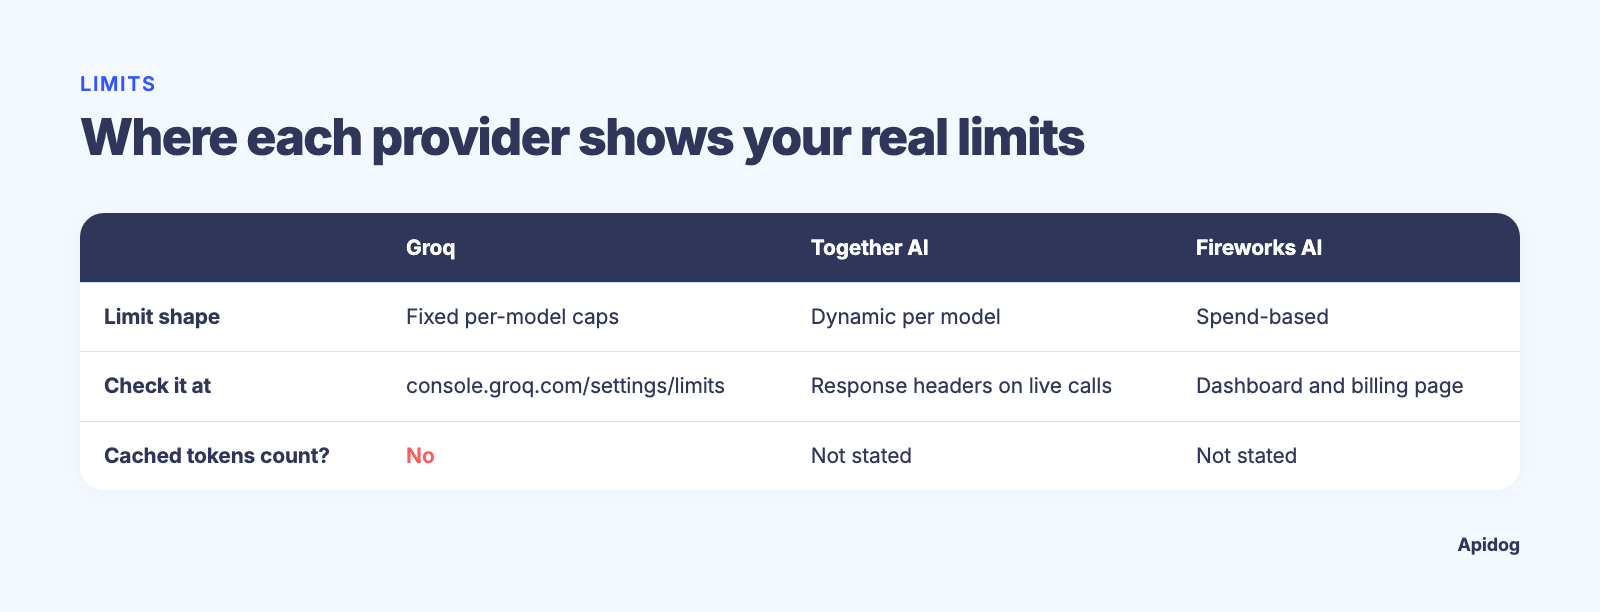
| كيف تتشكّل الحدود | حدود RPM/RPD/TPM/TPD لكل نموذج، تُفرض على مستوى المؤسسة | معدل ديناميكي لكل نموذج، يتعدّل مع سعتك الحالية واستخدامك الناجح الأخير | قائم على الإنفاق؛ بمجرد استهلاك الرصيد، تحتاج الطلبات إلى تفعيل الفوترة |
| أين تتحقق من أرقامك الخاصة | console.groq.com/settings/limits |
ترويسات الاستجابة في المكالمات الحية، مثل x-ratelimit-reset |
لوحة تحكم الحساب وصفحة الفوترة |
| هل تُحتسب الرموز المخزّنة مؤقتًا ضمن الحدود؟ | لا، وفق وثائق Groq نفسها | غير مذكور في الصفحات التي اطّلعنا عليها | غير مذكور في الصفحات التي اطّلعنا عليها |
يبرز أمران بمجرد أن تقرأ صفحات المصدر فعلاً بدلًا من ملخص ورقة المواصفات. أولًا، أرقام الخطة المجانية لدى Groq أعلاه هي القيم الافتراضية المنشورة؛ وتحمل الصفحة ذاتها تبويب خطة المطوّر بسقوف أعلى، وconsole.groq.com/settings/limits هو المرجع إذا اختلفت أرقامك. ثانيًا، تحديد المعدل لدى Together AI ليس جدولًا على الإطلاق. فصفحة حدود المعدل الخاصة به تنص صراحةً على أنه «لا توجد حدود ثابتة منشورة لكل نموذج»، وأن سقفك يرتفع مع «حركة مرور مستدامة وناجحة». هذا نموذج مختلف جوهريًا عن صف طبقة مجانية ثابت، ويعني أن الإجابة الصادقة عن سؤال «ما هو معدل RPM المجاني لدى Together» هي «تحقق من ترويسات استجابتك»، وليس رقمًا مأخوذًا من جدول.
إذا أردت التعمّقات الأحادية المزوّد بأرقام قابلة للتحقق لمنتج واحد في كل مرة، فراجع مقالتينا المرافقتين عن الطبقة المجانية من Groq API والطبقة المجانية من Cerebras API. هذه المقالة هي المحور؛ وتلك المقالتان تقومان بالتنقيب الكامل لكل مزوّد.
الطلبات مقابل الرموز، الثابت مقابل الديناميكي
الفرق التصميمي الحقيقي بين هؤلاء الثلاثة ليس حجم المخصّص المجاني، بل شكل السقف.
نموذج Groq هو النموذج الذي يعرفه معظم المطوّرين بالفعل من التعامل مع حدود المعدل في أماكن أخرى: سقف ثابت لكل نافذة زمنية، مقسَّم حسب RPM وRPD وTPM وTPD، ويُطبَّق على مستوى المؤسسة بدلًا من مفتاح API واحد. وهذا يعني أنه إذا أنشأت ثلاثة مفاتيح لثلاث خدمات تحت حساب Groq واحد، فإنها تتشارك مجمّعًا واحدًا. يغطي دليلنا العام عن حدود معدل GPT API البنية نفسها RPM/TPM بمزيد من العمق إن لم تكن قد تعاملت مع سقوف قائمة على الرموز من قبل.
نموذج Together AI يكافئ حركة المرور المستقرة والناجحة بدلًا من معاقبة حركة المرور المتدفقة بجدار صلب. فالحساب الهادئ والحساب الثقيل جيد السلوك لا يحصلان على السقف ذاته، لأن السقف يتعدّل وفق التاريخ الأخير للحساب نفسه ووفق السعة الحية للنموذج في تلك اللحظة. وهذا خبر سار إذا كان عبء عملك موثوقًا، ومجهول حقيقي إذا كانت حركة مرورك متدفقة بطبيعتها.
ويتجنّب Fireworks AI تصميم حدود المعدل كليًا تقريبًا للمستخدمين الجدد من خلال ربط الفترة المجانية برصيد بالدولار بدلًا من نافذة معدل الطلبات. فأنت لا تتقيّد بمدى سرعة استدعائك للـ API؛ بل تتقيّد بمقدار تكلفة استدعاءاتك قبل نفاد الرصيد. وهذا يقلب سؤال التخطيط من «كم عدد الطلبات في الدقيقة» إلى «كم عدد الرموز التي يمكن أن يشتريها دولار واحد بسعر الرمز لهذا النموذج»، وهو ما يعتمد كليًا على النموذج الذي تختاره.
إنها رهانات مختلفة على نوع الاستخدام الذي ينبغي أن تحمي منه طبقة «مجانية»: الحجم المستدام، أو الارتفاعات المفاجئة، أو الإنفاق الإجمالي. وأيًّا كان ما تبني عليه، ستصل في النهاية إلى خطأ 429، وطريقة إشارة المزوّد إلى تلك اللحظة لا تقل أهمية عن الرقم الذي أثارها. يشرح دليل استكشاف أخطاء تجاوز حد المعدل وإصلاحها كيفية قراءة ترويسات الاستجابة تلك وبناء منطق إعادة محاولة لا يزيد المشكلة سوءًا.
أثبته بنفسك في خمس دقائق
بالنظر إلى مقدار هذه البيانات التي تعيش خلف شاشة تسجيل دخول أو ترويسة استجابة حية، فإن أسرع طريق إلى إجابة حقيقية ليس مقالة أخرى عن ورقة المواصفات، بل اختبار واحد يشغّله وكيل البرمجة لديك على الثلاثة جميعًا. مع Apidog CLI يكون ذلك أمرًا واحدًا. أعدّ الإعداد مرة واحدة:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
يأتي الرمز من Apidog ضمن إعدادات الحساب، رمز الوصول إلى API. ثم أعطِ الوكيل أمرًا واحدًا:
Use Apidog CLI on project <id>. Create Groq, Together and Fireworks environments
with the OpenAI-compatible base URLs from this article and a comparable model id
in a MODEL variable. Add POST /chat/completions with Bearer auth from {{API_KEY}}
and one test case with an identical prompt and max_tokens. Run it once per
environment with that provider's key, then compare status, latency and the
x-ratelimit headers.
الأوامر التي يشغّلها، متحقَّق منها مقابل Apidog CLI 2.2.7:
apidog environment create Groq --project <id> --base-url https://api.groq.com/openai/v1
apidog environment create Together --project <id> --base-url https://api.together.ai/v1
apidog environment create Fireworks --project <id> --base-url https://api.fireworks.ai/inference/v1
apidog cli-schema validate test-case-create --file chat-case.json
apidog test-case create --project <id> --file chat-case.json
apidog run --test-case <caseId> --project <id> -e <togetherEnvId> \
  --env-var "API_KEY=$TOGETHER_API_KEY" -r cli,json
أصبح تبديل المزوّدين الآن معرّف بيئة، وليس إعادة كتابة. والترويسات هي حيث يظهر سقف Together AI الديناميكي في الوقت الفعلي، وحيث يمكنك التأكد من أن مؤسستك على Groq تطابق جدول الخطة المجانية المنشور. أبقِ زمن الاستجابة في المقارنة أيضًا: فالنموذج المجاني تقنيًا لكنه بطيء ليس أرخص فعلاً بمجرد احتساب الوقت الذي تقضيه في الالتفاف حوله. هذا يحوّل ثلاث صفحات تسويقية إلى مجموعة بيانات واحدة قابلة للمقارنة من حسابك الخاص. هل تشغّل المقارنة باستمرار داخل بناء وكيل أكبر؟ يغطي دليلنا عن أدوات اختبار API لوكلاء الذكاء الاصطناعي ذلك، ويوضّح Apidog CLI في Cursor إعداد الوكيل.
أي طبقة مجانية تناسب حالة استخدامك
بناءً فقط على ما هو قابل للتحقق اليوم، إليك بعض التوصيات الصادقة:
- سقوف متوقعة لكل نموذج يمكنك قراءتها دون تسجيل دخول: ينشر Groq أرقام الخطة المجانية الحقيقية (30 RPM / 1K RPD / 8K TPM / 200K TPD على نماذج
gpt-oss)، وتغطي نافذة السياق لديه البالغة 131,072 رمزًا عبرllama-3.1-8b-instantوllama-3.3-70b-versatileونماذجopenai/gpt-ossنطاقًا واسعًا من أعباء العمل مفتوحة الأوزان على نقطة نهاية واحدة. - حركة مرور مستقرة جيدة السلوك، مع عدم الرغبة في تتبّع حدود المعدل: يناسب النموذج الديناميكي لدى Together AI هذا النمط؛ فالاستخدام الناجح المستدام يرفع سقفك الخاص بمرور الوقت بدلًا من تقييدك عند رقم محدَّد في اليوم الأول.
- احتكاك إعداد صفري، مع تقبّل الوصول إلى جدار إنفاق: يختبر الوصول المجاني القائم على الرصيد لدى Fireworks AI أسعار الرمز الحقيقية من أول استدعاء، وهو مفيد عندما يكون السؤال الفعلي هو التكلفة على نطاق واسع لا عدد الطلبات.
يستضيف الثلاثة جميعًا مجموعات فرعية مختلفة من النماذج مفتوحة الأوزان، وقد لا يوجد نموذج يناسب مهمتك على مزوّد ما على مزوّد آخر.
الأسئلة الشائعة
هل يستخدم Together AI وFireworks AI وGroq جميعًا OpenAI SDK؟ نعم. يوثّق الثلاثة جميعًا نقاط نهاية متوافقة مع OpenAI، لذا تعمل مكتبة عميل openai القياسية مع أي منها بمجرد تغيير عنوان URL الأساسي والمفتاح.
أي مزوّد لديه أكبر طبقة مجانية؟ ليس بطريقة يمكنك مقارنتها مباشرةً. ينشر Groq أرقام الخطة المجانية الحقيقية لكل نموذج (30 RPM / 1K RPD / 8K TPM / 200K TPD على gpt-oss-120b/gpt-oss-20b)، ولا يحدّد Together AI رقمًا ثابتًا على الإطلاق، ويربط Fireworks AI الوصول المجاني برصيد ائتماني لمرة واحدة بدلًا من مخصّص. تحقق من console.groq.com/settings/limits إذا اختلفت أرقامك.
هل تُطبَّق حدود المعدل لكل مفتاح API أم لكل حساب؟ بالنسبة إلى Groq، تُطبَّق الحدود على مستوى المؤسسة، لذا تتشارك مفاتيح متعددة تحت حساب واحد المجمّع نفسه، وفق وثائق حدود المعدل الخاصة به. أما Together AI وFireworks AI فلا يذكران ذلك صراحةً في الصفحات التي اطّلعنا عليها؛ تحقق في لوحة التحكم الخاصة بك قبل افتراض غير ذلك.
ماذا يحدث عندما أصل إلى حد المعدل لدى أي من هؤلاء المزوّدين؟ ستحصل على استجابة HTTP 429. التفاصيل تختلف؛ راجع دليل تجاوز حد المعدل لمعرفة كيفية قراءة ترويسات إعادة المحاولة التي تعيدها معظم واجهات API المتوافقة مع OpenAI، وابنِ منطق تراجع تدريجي بدلًا من التخمين.
هل توجد طريقة أسرع لمقارنة هؤلاء من قراءة كل صفحة وثائق بنفسي؟ اجعل وكيل البرمجة لديك يشغّل حالة اختبار واحدة من Apidog CLI على ثلاث بيئات، كما هو موصوف أعلاه. عشرون دقيقة مع Apidog CLI ستخبرك عن عبء عملك الفعلي أكثر من أي جدول مقارنة، بما في ذلك هذا الجدول.