
لتشغيل Qwen 3.8 27B محليًا، ثبّت Ollama ونفّذ الأمر ollama pull qwen3.8:27b، ثم ollama run qwen3.8:27b. النسخة الافتراضية عبارة عن تنزيل رباعي التكميم (4-bit) بحجم 18 GB، لذا ستحتاج إلى وحدة معالجة رسومات بذاكرة VRAM سعة 24 GB أو جهاز Mac بذاكرة موحّدة سعة 32 GB. الأوزان مرخّصة بموجب Apache-2.0، أي أن النموذج نفسه لا يكلّفك شيئًا. التكلفة الوحيدة هي العتاد والكهرباء.
هذه هي النسخة المختصرة. يغطي باقي هذا الدليل برامج التشغيل الأربعة الجديرة بالاستخدام (Ollama وLM Studio وllama.cpp وMLX)، ومقدار الذاكرة التي يحتاجها كل مستوى تكميم، والسرعة المتوقعة على عتاد حقيقي، وكيفية جعل وكيل البرمجة الخاص بك يختبر نقطة النهاية المحلية باستخدام Apidog CLI بمجرد تشغيلها.
هل أنت جديد على العائلة؟ مقال ما هو Qwen 3.8 يغطي الطراز الأعلى Max البالغ 2.4 تريليون معامل. أما هذا الدليل فيتحدث عن أخيه الصغير الكثيف الذي يتسع على مكتبك.
ما هو Qwen 3.8 27B؟
Qwen 3.8 27B هو نموذج رؤية-لغة كثيف بـ27 مليار معامل من فريق Qwen في شركة Alibaba، صدر في أغسطس 2026 بموجب رخصة Apache-2.0. يقرأ النصوص والصور والفيديو، ويفكر قبل الإجابة افتراضيًا، ويتمتع بنافذة سياق أصلية تبلغ 262,144 رمزًا قابلة للتمديد إلى مليون رمز عبر توسيع YaRN.
تدرج بطاقة النموذج الرسمية هذه المواصفات:
| المواصفة | Qwen 3.8 27B |
|---|---|
| المعاملات | 27 مليار كثيفة (تدرج الـHub رقم 28 مليار شاملًا مشفّر الرؤية) |
| الطبقات | 64، مزيج من كتل Gated DeltaNet وGated Attention |
| السياق | 262,144 أصلية، وحتى 1,000,000 مع YaRN |
| المدخلات | نص، صورة، فيديو |
| التفكير | مفعّل افتراضيًا، مع reasoning_effort بقيم xhigh أو medium أو low |
| إضافات | طبقات التنبؤ متعدد الرموز (MTP) |
| الرخصة | Apache-2.0 |
في جدول المعايير المعيارية الخاص بـQwen نفسه، يحقق 61.7 على SWE-bench Pro، و73.0 على Terminal Bench 2.1، و89.2 على GPQA Diamond. هذه أرقام من الشركة المصنّعة. مقال تفصيل معايير Qwen 3.8 يشرح كيفية قراءة ذلك الجدول، بما في ذلك الصفوف التي طوّرتها Qwen داخليًا.
لماذا يهمك هذا محليًا؟ لأن نموذجًا كثيفًا بحجم 27B بتكميم 4-bit يتسع على وحدة معالجة رسومات استهلاكية واحدة، مع استدعاء الأدوات والرؤية والتفكير في ملف واحد.
ما مقدار ذاكرة RAM وVRAM التي تحتاجها لـQwen 3.8 27B؟
خطّط لحجم ملف التكميم لديك زائد 3 إلى 6 GB لذاكرة KV cache وبيئة التشغيل. بالنسبة للمستوى الافتراضي Q4_K_M، يعني ذلك 24 GB من VRAM على وحدة رسومات أو جهاز Mac بسعة 32 GB.
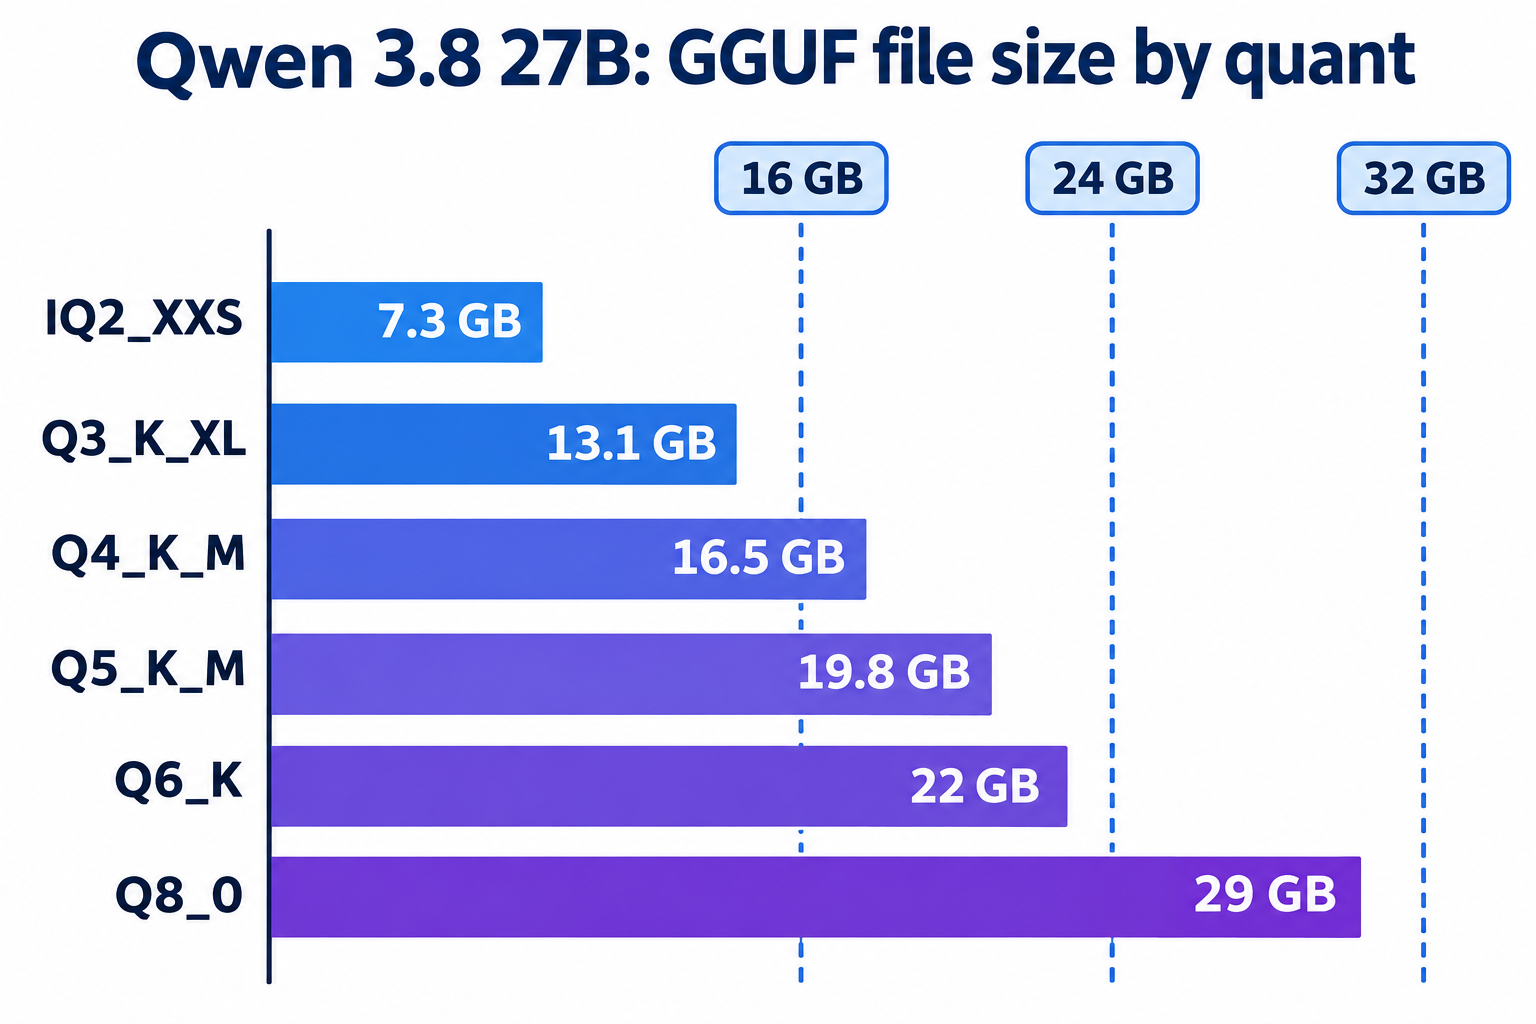
فيما يلي أحجام ملفات GGUF من مستودع التكميم الخاص بـunsloth، تم التحقق منها في 9 نوفمبر 2026:
| التكميم | حجم الملف | العتاد الواقعي |
|---|---|---|
| UD-IQ2_XXS | 7.27 GB | جهاز Mac بسعة 16 GB أو وحدة رسومات بسعة 12 GB، مع فقدان ملحوظ في الجودة |
| UD-Q3_K_XL | 13.1 GB | وحدة رسومات 16 GB، أو Mac بسعة 24 GB |
| UD-Q4_K_M | 16.5 GB | وحدة رسومات 24 GB، أو Mac بسعة 32 GB (الخيار الأمثل) |
| UD-Q5_K_M | 19.8 GB | وحدة رسومات 24 GB بسياق قصير، أو Mac بسعة 32 GB |
| UD-Q6_K | 22 GB | وحدة رسومات 32 GB، أو Mac بسعة 48 GB |
| Q8_0 | 29 GB | وحدة رسومات 48 GB، أو Mac بسعة 64 GB |
يضيف مشروع الرؤية (mmproj-F16.gguf) حجمًا قدره 928 MB إذا أردت إدخال الصور. وسم qwen3.8:27b الافتراضي في Ollama يبلغ 18 GB لأنه يتضمن الرؤية.
طول السياق هو التكلفة الخفية. يضع حساب التخطيط من llm-speed حجم Q4_K_M عند نحو 21.9 GB بسياق 32,000 رمز. لهذا فإن بطاقات الـ24 GB هي الحد الأدنى العملي للمستوى Q4، ولهذا لا ينبغي تحميل نافذة الـ262K كاملة إلا إذا كانت لديك ذاكرة زائدة عن الحاجة.
على أجهزة Mac، تذكّر أن macOS يحتفظ بجزء من الذاكرة الموحّدة للنظام. يمكن لجهاز Mac بسعة 24 GB نظريًا تحميل Q4_K_M، لكنك لن تجد سوى مساحة ضئيلة للسياق أو متصفحك. ننصح باختيار Q3_K_XL هناك.
ما مدى سرعة تشغيل Qwen 3.8 27B محليًا؟
توقّع نحو 38 إلى 44 رمزًا في الثانية على RTX 3090 أو 4090 بمستوى Q4_K_M مع llama.cpp، و65 إلى 75 رمزًا على RTX 5090. أما جهاز Mac Studio مع شريحة M3 Ultra فيفك الترميز بمعدل 25 إلى 27 رمزًا في الثانية تقريبًا.
لم نقم بقياس هذه الأرقام بأنفسنا. هذه تشغيلات مقيسة نشرها موقع llm-speed، مع العتاد وبيئة التشغيل التي ذكرها:
| العتاد | التكميم / بيئة التشغيل | فك الترميز (رمز/ث) | التعبئة المسبقة (رمز/ث) |
|---|---|---|---|
| RTX 3090 سعة 24 GB | Q4_K_M، llama.cpp | 38.6 (محادثة قصيرة، سياق 4K) | 482 |
| RTX 4090 سعة 24 GB | Q4_K_M، llama.cpp | 43.4 (محادثة قصيرة، سياق 4K) | 448 |
| RTX 5090 سعة 32 GB | Q4_K_M، llama.cpp | 75.2 (محادثة قصيرة، سياق 4K) | 563 |
| L40S سعة 45 GB | Q4_K_M، llama.cpp | 34.3 (محادثة قصيرة) | 569 |
| M3 Ultra سعة 96 GB | Q4_K_M، llama.cpp | 25.2 (محادثة قصيرة) | 45 |
| M3 Ultra سعة 96 GB | 4-bit، MLX 0.31.3 | 27.3 (محادثة قصيرة) | 12 |
سرعة فك الترميز تنخفض بالكاد مع زيادة السياق على وحدات الرسومات: لا يزال الـ4090 يحقق 39.0 رمزًا في الثانية بعد موجه من 33,131 رمزًا. التعبئة المسبقة هي موضع تعثر أجهزة Mac. على موجه من 11,827 رمزًا، عالج الـM3 Ultra نحو 283 رمزًا في الثانية، مقابل ما يقرب من 2,000 إلى 3,000 على الـ4090، أي أن قاعدة شيفرة كبيرة تعني عشرات الثواني قبل أول رمز.
التفكير أيضًا يستهلك ميزانية وقتك. عندما طلب Simon Willison من نسخة محلية من Qwen 3.8 27B تحديد الألعاب من أوزان نموذج خام، استغرقت إجابة واحدة 46 دقيقة و43,506 رموز تفكير. للمهام اليومية، خفّض reasoning_effort إلى low أو أوقف التفكير تمامًا.
تشغيل Qwen 3.8 27B باستخدام Ollama
Ollama هو أسرع خيار على أي نظام تشغيل. ثبّته من ollama.com، ثم:
ollama pull qwen3.8:27b
ollama run qwen3.8:27b
على شرائح Apple Silicon، جرّب وسم qwen3.8:27b-mlx، الذي يستخدم بيئة MLX بنفس الحجم 18 GB.
السياق الافتراضي في Ollama صغير، مما يعطل جلسات الوكلاء الطويلة. ارفعه قبل تشغيل الخادم:
OLLAMA_CONTEXT_LENGTH=32768 ollama serve
يوفر Ollama أيضًا واجهة برمجية متوافقة مع OpenAI على العنوان http://localhost:11434/v1، لذا تعمل أي مكتبة OpenAI SDK بمجرد تغيير عنوان URL الأساسي:
curl http://localhost:11434/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model": "qwen3.8:27b",
       "messages": [{"role": "user", "content": "Write a Python function that validates an email address."}]}'
هل تريده داخل وكيل برمجة؟ يوفر Ollama اختصارات تشغيل جاهزة: الأمر ollama launch claude --model qwen3.8 يشغّل Claude Code على النموذج المحلي، وollama launch opencode --model qwen3.8 يفعل الشيء نفسه مع OpenCode.
تشغيله باستخدام LM Studio
LM Studio هو الخيار المناسب إذا أردت واجهة رسومية وإعدادات تحميل لكل نموذج على حدة. ابحث عن Qwen 3.8 27B، ونزّل النسخة lmstudio-community/Qwen3.8-27B-GGUF بمستوى Q4_K_M (16.8 GB)، ثم حمّلها.
هناك إعداد واحد مهم: ارفع طول السياق عند تحميل النموذج. وجد Simon Willison أن السياق الافتراضي البالغ 8,192 رمزًا فشل بأخطاء مع موجهه الطويل واضطر لتحميل نافذة أكبر.
ثم افتح تبويب Developer وشغّل الخادم المحلي، أو نفّذ lms server start من الطرفية. تقع نقطة النهاية المتوافقة مع OpenAI على http://localhost:1234/v1.
تشغيله باستخدام llama.cpp
يمنحك llama.cpp أكبر قدر من التحكم، وهو يشغّل معظم قياسات الأداء أعلاه. على macOS أو Linux:
brew install llama.cpp

llama-server -hf unsloth/Qwen3.8-27B-GGUF:UD-Q4_K_M \
  --jinja -c 32768 -ngl 99 \
  --temp 1.0 --top-p 0.95 --top-k 20 \
  --port 8080
يعالج الرمز -hf تنزيل التكميم مباشرة من Hugging Face، والرمز --jinja يطبّق قالب المحادثة الخاص بالنموذج (ضروري لاستدعاء الأدوات والتفكير)، والرمز -c يضبط السياق، و-ngl 99 يضع كل الطبقات على وحدة الرسومات. قيم أخذ العينات هي توصيات Qwen لوضع التفكير. أما لوضع غير التفكير، فتقترح بطاقة النموذج درجة حرارة 0.7، وtop_p بقيمة 0.8، وtop_k بقيمة 20، وpresence_penalty بقيمة 1.5.
لإيقاف التفكير لطلب واحد، أرسل "chat_template_kwargs": {"enable_thinking": false} في متن الطلب.
تشغيله باستخدام MLX على جهاز Mac
MLX هو إطار المصفوفات الخاص بشركة Apple، وعادةً ما يكون أسرع بيئة تشغيل لفك الترميز على شرائح Apple Silicon. ثبّت mlx-lm واستخدم النسخة الرباعية التكميم من mlx-community:
pip install mlx-lm

mlx_lm.generate --model mlx-community/Qwen3.8-27B-4bit \
  --prompt "Explain the difference between a mutex and a semaphore." \
  --max-tokens 1024

mlx_lm.server --model mlx-community/Qwen3.8-27B-4bit --port 8080
يكشف mlx_lm.server مسارًا متوافقًا مع OpenAI على /v1/chat/completions. وتنشر منظمة mlx-community أيضًا نسخًا بـ8-bit وmxfp4 وMTP إذا أردت مبادلة الذاكرة بالجودة أو السرعة.
دع وكيل البرمجة الخاص بك يختبر نقطة النهاية المحلية باستخدام Apidog CLI
كل برامج التشغيل تقدم الشكل نفسه المتوافق مع OpenAI، لكن كلًا منها يتعامل مع كتل التفكير واستدعاء الأدوات والمهلات بشكل مختلف. قبل أن توجه أي تطبيق إلى localhost، دع وكيل البرمجة الخاص بك يبني اختبارًا قابلًا للتكرار باستخدام Apidog CLI، بحيث يظهر أي قالب معطوب أو حد سياق في ثوانٍ، لا في منتصف مهمة ما.
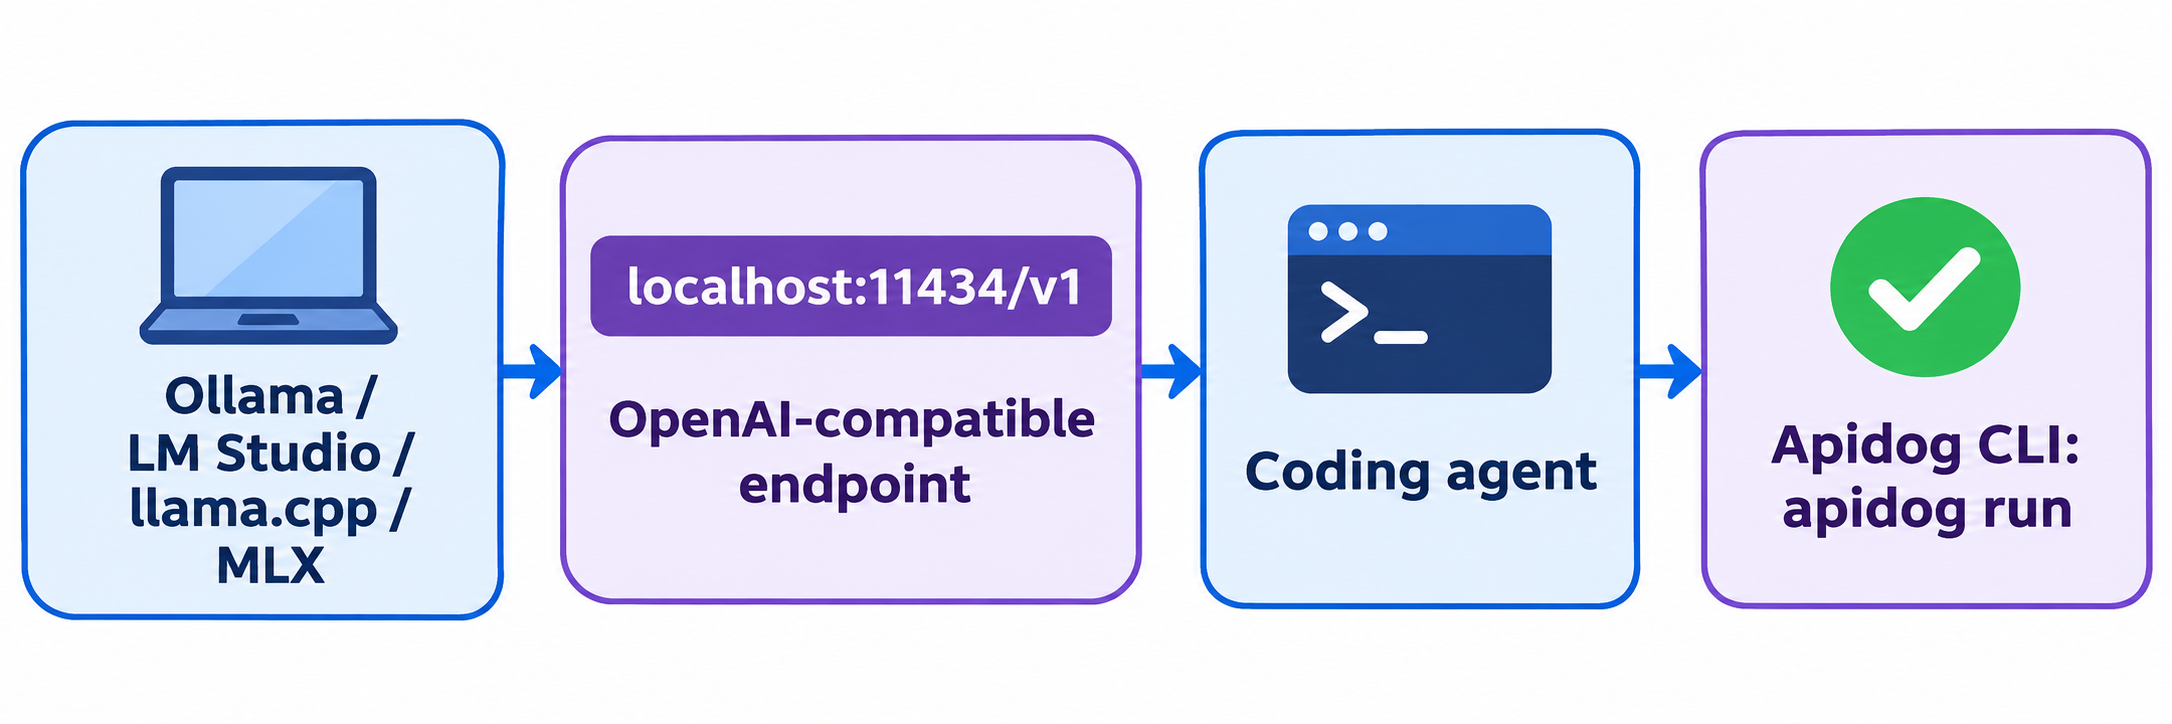
أعدّه مرة واحدة:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
ثم أعطِ Claude Code أو Codex أو Cursor موجهًا واحدًا:
In Apidog project <projectId>, create an environment "qwen-local" with base URL
http://localhost:11434/v1. Add a POST /chat/completions endpoint for model
qwen3.8:27b, then a test case that asserts status 200, a non-empty
choices[0].message.content, usage.completion_tokens > 0, and a second request
with a tools array that returns a tool_calls entry. Run it and summarize failures.
يقرأ الوكيل مخطط كل حمولة، ويتحقق من صحة الـJSON، وينشئ الموارد، ويشغّل الاختبار:
apidog environment create qwen-local --project <projectId> --base-url http://localhost:11434/v1
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema get test-case-create
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json --timeout-request 300000
القيمة الطويلة لـ--timeout-request مهمة هنا: قد يستغرق نموذج بحجم 27B في وضع التفكير دقائق على جهاز Mac. غيّر عنوان URL الأساسي إلى http://localhost:1234/v1 أو :8080/v1 وسيختبر الاختبار نفسه LM Studio أو llama.cpp أو MLX. لمزيد من إعدادات الوكلاء، راجع Apidog CLI في Claude Code ومرجع أمر apidog run. تغطي الخطة المجانية من Apidog حتى 4 مستخدمين.
الوضع المحلي مقابل واجهة Qwen 3.8 API المستضافة
التشغيل المحلي يحفظ الموجهات على جهازك، ويعمل دون اتصال بالإنترنت، ولا يكلّف شيئًا لكل رمز. المقابل هو السرعة والتوسع: تستضيف نقطة النهاية السحابية الطراز الأكبر بكثير Qwen 3.8-Max بسياق 1 مليون رمز ودون انتظار في التعبئة المسبقة. إذا احتجت الطراز الأعلى، اقرأ دليل Qwen 3.8 API لدينا أو طرق الوصول المجاني. وللبرمجة الوكيلية بأيٍّ من الحجمين، يقارن Qwen 3.8 للبرمجة بين إعدادات الأدوات المختلفة.
الأسئلة الشائعة
هل تشغيل Qwen 3.8 27B محليًا مجاني؟ نعم. الأوزان متاحة بموجب Apache-2.0 على Hugging Face، وكلٌّ من Ollama وLM Studio وllama.cpp وMLX مجاني. لا تدفع إلا ثمن العتاد والكهرباء.
هل يمكن تشغيل Qwen 3.8 27B على جهاز Mac بسعة 16 GB؟ فقط بمستويات تكميم ثنائية البت مثل UD-IQ2_XXS (7.27 GB) وبسياق قصير، مع انخفاض ملحوظ في الجودة. جهاز Mac بسعة 32 GB يعمل بمستوى Q4_K_M هو الإعداد المريح.
هل يعمل Qwen 3.8 27B على RTX 3090؟ نعم. يتسع Q4_K_M في 24 GB مع مساحة لسياق يتراوح بين 16K و32K، وقيس llm-speed نحو 38 رمزًا في الثانية على llama.cpp.
كيف أوقف وضع التفكير؟ أرسل "chat_template_kwargs": {"enable_thinking": false} على llama.cpp أو vLLM، أو خفّض reasoning_effort إلى low. توصي Qwen بدرجة حرارة 0.7 وtop_p بقيمة 0.8 لوضع غير التفكير.
هل يدعم النموذج المحلي الصور؟ نعم. وسم Ollama البالغ 18 GB يتضمن الرؤية. مع llama.cpp، نزّل ملف mmproj-F16.gguf بجانب النموذج.
ما الفرق بين Qwen 3.8 27B وQwen 3.8-Max؟ Max هو طراز أعلى بنمط خليط الخبراء (mixture-of-experts) بـ2.4 تريليون معامل، يُقدَّم عبر واجهة Alibaba البرمجية. أما 27B فهو نموذج كثيف صغير بما يكفي لوحدة رسومات واحدة أو جهاز Mac بسعة 32 GB.