
يمكنك تشغيل نموذج Nemotron 3.5 Transcribe الجديد من NVIDIA على وحدة معالجة رسومات واحدة ونسخ تسجيلات مدتها ساعة كاملة في 40 لغة دون دفع مقابل كل دقيقة أو إرسال الصوت إلى أي جهة خارجية. إنه أفضل نموذج مفتوح الأوزان على لوحة صدارة Hugging Face Open ASR، ويُطرح بموجب ترخيص OpenMDW-1.1 الملائم للاستخدام التجاري، وقد نشرت NVIDIA أوزان BF16 وFP8 وNVFP4 في يوم الإطلاق، 28 أكتوبر 2026.
يغطي هذا الدليل العتاد الذي تحتاجه، والطرق الثلاث لتشغيله (vLLM وSGLang-Omni وTransformers)، والأوامر الدقيقة من بطاقة النموذج الرسمية، والإعدادات التي يخطئ فيها الناس. وقد نُسخت جميع الأوامر من البطاقة في 29 أكتوبر 2026.
جديد على النموذج؟ يشرح دليلنا المجاني ما يفعله وكيف يُصنَّف. ليس لديك وحدة معالجة رسومات؟ تبلغ تكلفة واجهة API المستضافة 0.002 دولار لكل دقيقة.
لماذا تشغّله محليًا
- لا فاتورة لكل دقيقة. بسعر DeepInfra البالغ 0.002 دولار لكل دقيقة، تكلّف 10,000 ساعة 1,200 دولار. أما على وحدة معالجة الرسومات الخاصة بك فالتكلفة هي الكهرباء فقط.
- الخصوصية. مكالمات العملاء والنسخ الطبي والتسجيلات القانونية لا تغادر شبكتك أبدًا.
- مجموعة الميزات الكاملة. يدعم مسار vLLM الطوابع الزمنية للكلمات، وتمييز المتحدثين، والترجمة، والمطالبات السياقية. بعض نقاط النهاية المستضافة لا تُتيح سوى جزء من ذلك.
- الضبط الدقيق. تُظهر تدوينة الإطلاق من NVIDIA أن ضبطًا دقيقًا طبيًا خفّض معدل خطأ الكلمات (WER) من 30.8% إلى 11.8%. ولا يمكنك فعل ذلك إلا بامتلاك الأوزان.
العتاد: ما الذي يشغّله
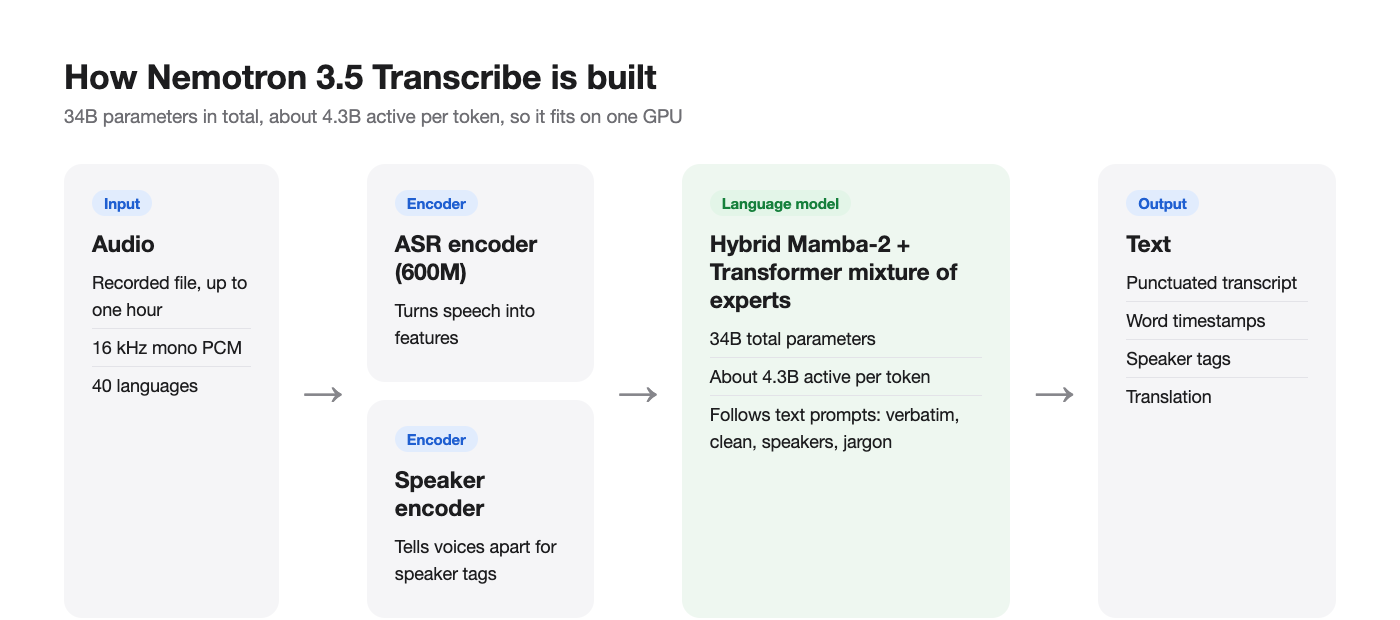
يمتلك النموذج 34 مليار معامل إجمالًا ونحو 4.3 مليار معامل نشطة، لذا فإن الأوزان كبيرة حتى وإن كان الحساب لكل رمز (token) صغيرًا. الهدف المرجعي لدى NVIDIA هو وحدة H100 بسعة 80 جيجابايت بدقة BF16. جدول التوافق من بطاقة النموذج:
| GPU | Precisions | Runtimes |
|---|---|---|
| H100, H200 | BF16, FP8 | vLLM 0.32.0, Transformers, SGLang-Omni 0.2.0 (H100) |
| A100 80 GB | BF16 | vLLM 0.32.0, Transformers |
| L40S 48 GB | FP8 | vLLM 0.32.0, Transformers |
| B200, GB200, GB300 DGX Station | BF16, FP8, NVFP4 | vLLM 0.32.0, Transformers |
| DGX Spark (GB10), Jetson Thor | BF16, FP8, NVFP4 | vLLM 0.32.0, Transformers |
| RTX PRO 6000 Blackwell Server | BF16, FP8, NVFP4 | vLLM, Transformers, SGLang-Omni, GGML |
| RTX 5090 (32 GB) | NVFP4 only | vLLM 0.32.0, Transformers, GGML |
اختر نقطة التحقق (checkpoint) المناسبة لبطاقتك:
nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B(BF16)nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B-FP8nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B-NVFP4
بطاقة بسعة 24 جيجابايت مثل RTX 4090 ليست على القائمة، وApple Silicon غير مدعوم. أنظمة التشغيل هي Linux، أو Windows عبر WSL2. يعمل GGML أيضًا على Windows الأصلي، لكن تدوينة إطلاق NVIDIA تقول إن بناء NeMo-Speech.cpp المحلي لا يزال «قريبًا».
الخيار الأول: خادم vLLM (موصى به)
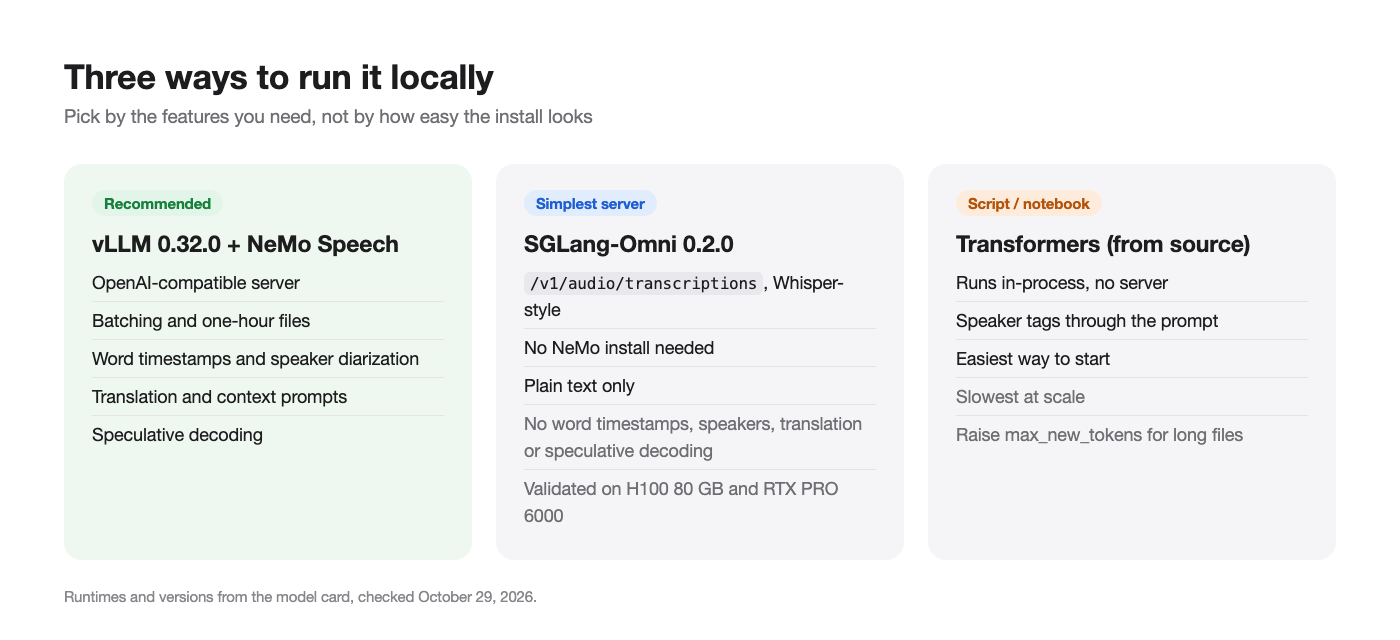
يمنحك vLLM نقطة نهاية متوافقة مع OpenAI مع التجميع على دفعات (batching)، وملفات مدتها ساعة، وفك الترميز التخميني (speculative decoding)، والطوابع الزمنية للكلمات. يحتاج إلى vLLM 0.32.0 بالإضافة إلى أحدث فرع main من NeMo Speech، الذي يوفّر إضافة vLLM الخاصة بالنموذج.
التثبيت
تستخدم البطاقة uv وPython 3.13:
git clone https://github.com/NVIDIA-NeMo/Speech.git nemo-speech
cd nemo-speech
uv venv --python 3.13 .venv
UV_PROJECT_ENVIRONMENT=$PWD/.venv uv sync --extra asr --extra vllm --locked --no-install-project
uv pip install --python .venv/bin/python --no-deps -e .
uv pip install --python .venv/bin/python --no-deps av==19.0.2
uv pip install --python .venv/bin/python --no-deps opencv-python-headless==5.0.0.93
source .venv/bin/activate
hf download nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B --local-dir ./NVIDIA-Nemotron-3.5-Transcribe-30B-A4B
تتيح PyAV (وهي av) فك ترميز ملفات M4A وغيرها من الصيغ المضغوطة دون الحاجة إلى FFmpeg على النظام. أما OpenCV فهي موجودة لأن vLLM يحتاجها بينما تُسقطها إعدادات تبعيات NeMo.
تشغيل الخادم
export VLLM_PLUGINS=nemo_speechlm
export VLLM_MAX_AUDIO_DECODE_DURATION_S=3600
export VLLM_MAX_AUDIO_CLIP_FILESIZE_MB=180
export VLLM_USE_V2_MODEL_RUNNER=0
vllm serve ./NVIDIA-Nemotron-3.5-Transcribe-30B-A4B \
  --served-model-name nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B \
  --trust-remote-code --dtype bfloat16 --gpu-memory-utilization 0.94 \
  --max-model-len 65536 --max-num-batched-tokens 4096 --max-num-seqs 192 \
  --enable-chunked-prefill --no-enable-prefix-caching \
  --use-replayssm --mamba-backend flashinfer --mamba-cache-mode none \
  --mm-processor-cache-gb 0 --no-async-scheduling \
  --limit-mm-per-prompt '{"audio":{"count":6,"length":120000000}}' \
  --speculative-config '{"method":"mtp","num_speculative_tokens":8}' \
  --reasoning-parser nemotron_v3 \
  --trust-request-mm-kwargs \
  --middleware nemo.collections.speechlm2.vllm.salm.ctc_serving.ctc_timestamp_middleware
المعلَمات (flags) التي يستحق فهمها:
VLLM_MAX_AUDIO_DECODE_DURATION_S=3600يرفع حد الصوت في vLLM من 600 ثانية إلى ساعة واحدة. إذا نسيته فسوف تفشل الملفات الطويلة.VLLM_USE_V2_MODEL_RUNNER=0يُبقي على مشغّل V1، الذي تحتاجه الطوابع الزمنية للكلمات.--speculative-configيفعّل التنبؤ متعدد الرموز بثمانية رموز مسودة (MTP8). على H100، قاست NVIDIA قيمة RTFx إجمالية للنص الإنجليزي المجمّع على دفعات تبلغ 270 مع MTP8 و410 مع MTP2، لذا جرّب"num_speculative_tokens":2إذا كانت الإنتاجية تهمك أكثر من زمن الاستجابة.--middleware ... ctc_timestamp_middlewareو--trust-request-mm-kwargsيتيحان للطلبات طلب الطوابع الزمنية للكلمات.- الإعدادات موجّهة لوحدة H100 بسعة 80 جيجابايت. على البطاقات الأخرى، خفّض
--gpu-memory-utilizationأو--max-model-lenأو--max-num-seqs.
يستمع الخادم على 127.0.0.1:8000. أضف --host 0.0.0.0 للوصول إليه من أجهزة أخرى على شبكتك.
أرسل ملفًا
import base64
from openai import OpenAI

client = OpenAI(base_url="http://127.0.0.1:8000/v1", api_key="EMPTY")
audio = base64.b64encode(open("standup.wav", "rb").read()).decode()

response = client.chat.completions.create(
    model="nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B",
    messages=[{"role": "user", "content": [
        {"type": "text", "text": "Transcribe the following audio."},
        {"type": "audio_url", "audio_url": {"url": f"data:audio/wav;base64,{audio}"}},
    ]}],
    temperature=0,
    extra_body={"chat_template_kwargs": {"enable_thinking": False}, "skip_special_tokens": False},
)
print(response.choices[0].message.content)
استبدل تعليمة النص بأي مطالبة مهمة. لاجتماع فيه عدة أصوات:
Transcribe verbatim, including fillers. Write numbers as spoken, without punctuation or capitalization. Start every speaker turn with <spk:0>, <spk:1>, etc. Keep one stable tag per speaker. Output only the speaker-tagged transcript.
لطلبات الطوابع الزمنية للكلمات قواعد: تسجيل واحد لكل طلب، وstream=false وn=1. وعندها يتضمن الرد كائن ctc_timestamps يحتوي على الكلمات وأوقات البداية والنهاية بالثواني ووسوم المتحدثين.
الخيار الثاني: SGLang-Omni للنسخ النصي البسيط
إذا كنت تحتاج فقط إلى نص من ملفات كاملة، فإن SGLang-Omni 0.2.0 أبسط ولا يحتاج إلى NeMo. وقد تم التحقق من صحته على وحدة H100 بسعة 80 جيجابايت ووحدة RTX PRO 6000 Blackwell بنقطة تحقق BF16 أو FP8.
sgl-omni serve \
  --model-path nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B \
  --model-name nemotron-transcribe \
  --mem-fraction-static 0.85 \
  --port 8000

curl http://localhost:8000/v1/audio/transcriptions \
  -F model=nemotron-transcribe \
  -F file=@audio.wav
مسار /v1/audio/transcriptions ذاك يطابق الشكل الذي تستخدمه واجهة Whisper API من OpenAI، لذا غالبًا لا يحتاج كود عميل Whisper الحالي سوى عنوان أساسي جديد. المقابل: لا طوابع زمنية للكلمات، ولا وسوم للمتحدثين، ولا ترجمة، ولا فك ترميز تخميني في هذا التكامل.
الخيار الثالث: Transformers داخل سكربت
لدفاتر الملاحظات (notebooks) والمهام لمرة واحدة، شغّله داخل العملية ذاتها مع Hugging Face Transformers المثبّت من المصدر:
pip install git+https://github.com/huggingface/transformers
from transformers import AutoModelForMultimodalLM, AutoProcessor

model_id = "nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B"
processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForMultimodalLM.from_pretrained(model_id, device_map="auto")

prompt = ("Transcribe this audio with punctuation and capitalization. Include all spoken words "
          "and verbal fillers. Put speaker tags <spk:0> <spk:1> <spk:2> <spk:3> on the transcription.")
inputs = processor.apply_transcription_request(["podcast.mp3"], prompt=[prompt]).to(model.device)
outputs = model.generate(**inputs, max_new_tokens=4096)
print(processor.decode(outputs[:, inputs.input_ids.shape[1]:], skip_special_tokens=False))
إنها أسهل طريقة للبدء وأبطأ طريقة للتشغيل على نطاق واسع. ارفع max_new_tokens للملفات الطويلة: فالساعة الكثيفة بالكلام قد تنتج نحو 20,000 رمز.
ما مدى سرعته على وحدة معالجة الرسومات الخاصة بك؟
الرقم الرئيسي لدى NVIDIA هو 2,238 ثانية من الصوت لكل ثانية على وحدة RTX PRO 6000 Blackwell واحدة، مع أوزان NVFP4 وفك الترميز التخميني DFlash2، و0.13 ثانية لإرجاع مقطع مدته 30 ثانية. اقرأ الحاشية: هذه الأرقام تأتي من NIM المُحسّن، الذي لم تُنشر تغييراته في الخدمة كمصدر مفتوح بعد. وتقول البطاقة إن تكامل vLLM المفتوح يُتوقع أن يكون أبطأ بنحو مرتين.
للنسخ الإنجليزي المجمّع على دفعات على H100 بدقة BF16، تسرد البطاقة أرقام RTFx التالية (ثواني الصوت لكل ثانية من الحساب):
| Speculative decoding | RTFx |
|---|---|
| MTP2 | 410 |
| DFlash2, K=7 | 340 |
| MTP8 | 270 |
| DFlash2, K=15 | 260 |
حتى أبطأ صف يتجاوز ساعة من الصوت في أقل من 15 ثانية من زمن وحدة معالجة الرسومات في العمل المجمّع على دفعات. وإذا أردت نموذج المسودة DFlash2، فاعلم أن vLLM 0.32.0 يحتاج إلى تصحيح صغير من البطاقة، وأن DFlash2 يعطّل الطوابع الزمنية للكلمات، ولا ينبغي جمعه مع MTP.
مشكلات شائعة وحلولها
- الملفات الطويلة تُقطع عند 10 دقائق. لقد تجاهلت
VLLM_MAX_AUDIO_DECODE_DURATION_S=3600. - لا طوابع زمنية في الرد. تحقق من
VLLM_USE_V2_MODEL_RUNNER=0، ومن معلَم--middleware، ومن أن الطلب يحتوي علىstream=falseوتسجيل واحد. - نفاد الذاكرة على البطاقات الأصغر. انتقل إلى نقطة تحقق FP8 أو NVFP4 وخفّض
--max-num-seqs. - عبارات متكررة في نهاية النص. توصي البطاقة بوجود حاجز ضد حلقات التوليد على المخرجات النهائية. حدّد سقفًا لـ
max_tokensواقتطع التكرارات. - تهجئة خاطئة للأسماء. أضف
Context terms: <names>إلى المطالبة. - أصوات خلفية في النص. جرّب مطالبة المجال القريب التجريبية من البطاقة، والتي خفّضت معدل خطأ الكلمات (WER) في الصوت المختلط من 27.32% إلى 4.78% في اختبار NVIDIA.
إذا كنت جديدًا على vLLM نفسه، فإن شرحنا لـ vLLM يغطي كيفية تجميعه للطلبات على دفعات وإدارته لذاكرة وحدة معالجة الرسومات.
دع وكيل البرمجة لديك يختبر الخادم المحلي باستخدام Apidog CLI
لا يكون النموذج المحلي مفيدًا إلا إذا بقيت نقطة نهايته صحيحة عبر ترقيات vLLM وتعديلات المطالبات وتبديل نقاط التحقق. دع وكيل البرمجة لديك يتولى ذلك باستخدام Apidog CLI، بتشغيل الفحوصات ضد http://127.0.0.1:8000 من الجهاز نفسه.
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
ثم أعطِ وكيلك مطالبة واحدة:
In Apidog project <id>, add POST {{baseUrl}}/v1/chat/completions for my local
Nemotron 3.5 Transcribe server. Create test cases that send samples/en.wav and
samples/two-speakers.wav as base64 audio_url content with temperature 0, and assert
status 200, a non-empty choices[0].message.content, and at least two distinct <spk:N>
tags for the two-speaker file. Run them against the local environment and report failures.
يقرأ الوكيل المخطط، ويتحقق من صحة حمولته، ويكتب الحالات ويشغّلها:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
شغّله بعد كل ترقية للخادم، أو اربط apidog run ... -r junit بـ CI كما هو موضح في Apidog CLI في خط أنابيب CI/CD. لإعداد الوكيل، راجع Apidog CLI في Claude Code.
الأسئلة الشائعة
هل يمكنني تشغيل Nemotron 3.5 Transcribe على RTX 4090؟ إنها ليست على قائمة التوافق لدى NVIDIA. أصغر بطاقة استهلاكية مُدرجة هي RTX 5090 مع نقطة تحقق NVFP4.
هل يعمل على Mac؟ لا يدعم أي وقت تشغيل رسمي Apple Silicon حتى 29 أكتوبر 2026.
هل الاستخدام المحلي مجاني للمنتجات التجارية؟ يسمح ترخيص OpenMDW-1.1 بالاستخدام التجاري وغير التجاري. اقرأ نص الترخيص لمعرفة شروط الإسناد قبل الإطلاق.
هل يمكنه نسخ الصوت المباشر؟ لا. إنه نموذج غير متصل (offline) للملفات المسجلة. وتوفّر NVIDIA نموذجًا منفصلًا هو Nemotron 3.5 ASR Streaming للاستخدام المباشر.
أيهما أسرع، vLLM أم SGLang-Omni؟ لا تنشر NVIDIA مقارنة مباشرة بينهما. استخدم vLLM عندما تحتاج إلى طوابع زمنية أو متحدثين أو ترجمة، وSGLang-Omni لأبسط خادم نصي فقط.
كيف يُصنَّف مقابل النماذج المحلية الأخرى؟ يتصدر كل نموذج مفتوح الأوزان على لوحة صدارة Open ASR بتاريخ 28 أكتوبر. وتقارنه قائمتنا أفضل نماذج تحويل الكلام إلى نص مفتوحة المصدر بـ Qwen3-ASR وGranite Speech وCanary-Qwen وVoxtral وWhisper.
شغّله
نزّل نقطة التحقق التي تناسب وحدة معالجة الرسومات لديك، وشغّل vLLM مع حد الصوت البالغ ساعة واحدة وبرمجية الطوابع الزمنية الوسيطة، وأرسل ملف WAV عبر عميل OpenAI. ثم دع وكيلك يشغّل فحوصات Apidog ضد نقطة النهاية المحلية حتى تُثبت كل ترقية أنه لا يزال ينسخ بنجاح قبل أن تثق به في تسجيلات حقيقية.