
لتشغيل ERNIE 5.5 Flash محليًا، ثبّت vLLM 0.32.0 مع إضافة vLLM-ERNIE من Baidu، ثم شغّل الأمر vllm serve baidu/ERNIE-5.5-Flash-Base مع توازي البيانات وتوازي الخبراء على عقدة متعددة وحدات معالجة الرسومات. ستحصل على خادم متوافق مع OpenAI على المنفذ 8000. الملاحظة المهمة: الأوزان المفتوحة المتاحة اليوم هي نموذج Base، أي نقطة حفظ من مرحلة التدريب المسبق تُكمل النص، وليس نموذج محادثة.
في الأسفل: ما يمكنك تنزيله، متطلبات العتاد التي تذكرها Baidu، أوامر التشغيل الدقيقة، وكيفية اختبار نقطة النهاية. كل الأوامر والأرقام أدناه مأخوذة من بطاقة النموذج على Hugging Face ومستودع vLLM-ERNIE، وتم التحقق منها بتاريخ 12 نوفمبر 2026.
جديد على هذا النموذج؟ ابدأ بـما هو ERNIE 5.5 Flash. وإذا أردت نموذج المحادثة دون الحاجة إلى عنقود GPU، فإن دليل واجهة برمجة التطبيقات ERNIE 5.5 Flash هو الطريق الأسرع.
ماذا يمكنك تشغيله محليًا اليوم؟
يمكنك تشغيل ERNIE 5.5 Flash Base، المُصدر على Hugging Face بصيغتي FP8 وBF16. إنه نموذج مزيج خبراء متناثر (sparse mixture-of-experts) بـ 280 مليار معلمة مع 14 مليار معلمة نشطة لكل رمز، دُرّب على 33.5 تريليون رمز. أما ERNIE 5.5 Flash Preview المضبوط للمحادثة فهو متاح عبر الواجهة البرمجية فقط في الوقت الحالي؛ وتقول Baidu إن أوزانه ستتوفر «قريبًا» بموجب رخصة Apache 2.0.
إليك مقارنة بين الإصدارين من حيث الاستضافة الذاتية:
| ERNIE 5.5 Flash Base | ERNIE 5.5 Flash Preview | |
|---|---|---|
| ما هو | نقطة حفظ في نهاية التدريب المسبق | أول نموذج بعد التدريب (محادثة، استدلال، وكلاء) |
| الأوزان | متوفرة على Hugging Face وModelScope بصيغتي FP8 وBF16 | غير مُصدرة حتى 12 نوفمبر 2026 |
| نقطة النهاية التي تستدعيها | /v1/completions (إكمال نص) |
إكمالات محادثة مع استدلال وأدوات |
| الرخصة | ERNIE 5.5 Flash Base Model License v1.0 | Apache 2.0 مَعْهودة عند الإصدار |
| أين تستخدمه الآن | وحدات معالجة الرسومات الخاصة بك | واجهة Qianfan البرمجية، OpenRouter |
حاليًا، تحتوي مجموعة ERNIE-5.5-Flash من Baidu على نقطتي الحفظ الخاصة بنموذج Base فقط، ويشير ملف README الخاص بـ vLLM-ERNIE إلى أن نموذج المحادثة «قادم قريبًا». أما منشور إصدار Preview فلا يذكر أي تاريخ.
إذا أردت مساعدًا للبرمجة اليوم، فلن يوفره لك نموذج Base المحلي. أما إذا أردت نقطة انطلاق للضبط الدقيق أو أبحاث التعلم القليل الأمثلة، فBase هو ما بُني من أجله.
متطلبات العتاد لتشغيل ERNIE 5.5 Flash
تشغل أوزان FP8 نحو 280 غيغابايت من ذاكرة GPU، وتشغل أوزان BF16 نحو 560 غيغابايت، لذا فهذه مهمة لخادم متعدد وحدات معالجة الرسومات، وليس لجهاز محمول. يسرد ملف README الخاص بـ vLLM-ERNIE أقل عدد من وحدات GPU التي تتسع للأوزان، وتعمل الإضافة على وحدات NVIDIA فقط.
| ذاكرة GPU لكل بطاقة | FP8 (~280 غيغابايت أوزان) | BF16 (~560 غيغابايت أوزان) |
|---|---|---|
| 288 غيغابايت | 2 GPU | 4 GPU |
| 192 غيغابايت | 4 GPU | 8 GPU (أو عقدتان × 4 GPU) |
| 80 غيغابايت | 8 GPU | عقدتان × 8 GPU |
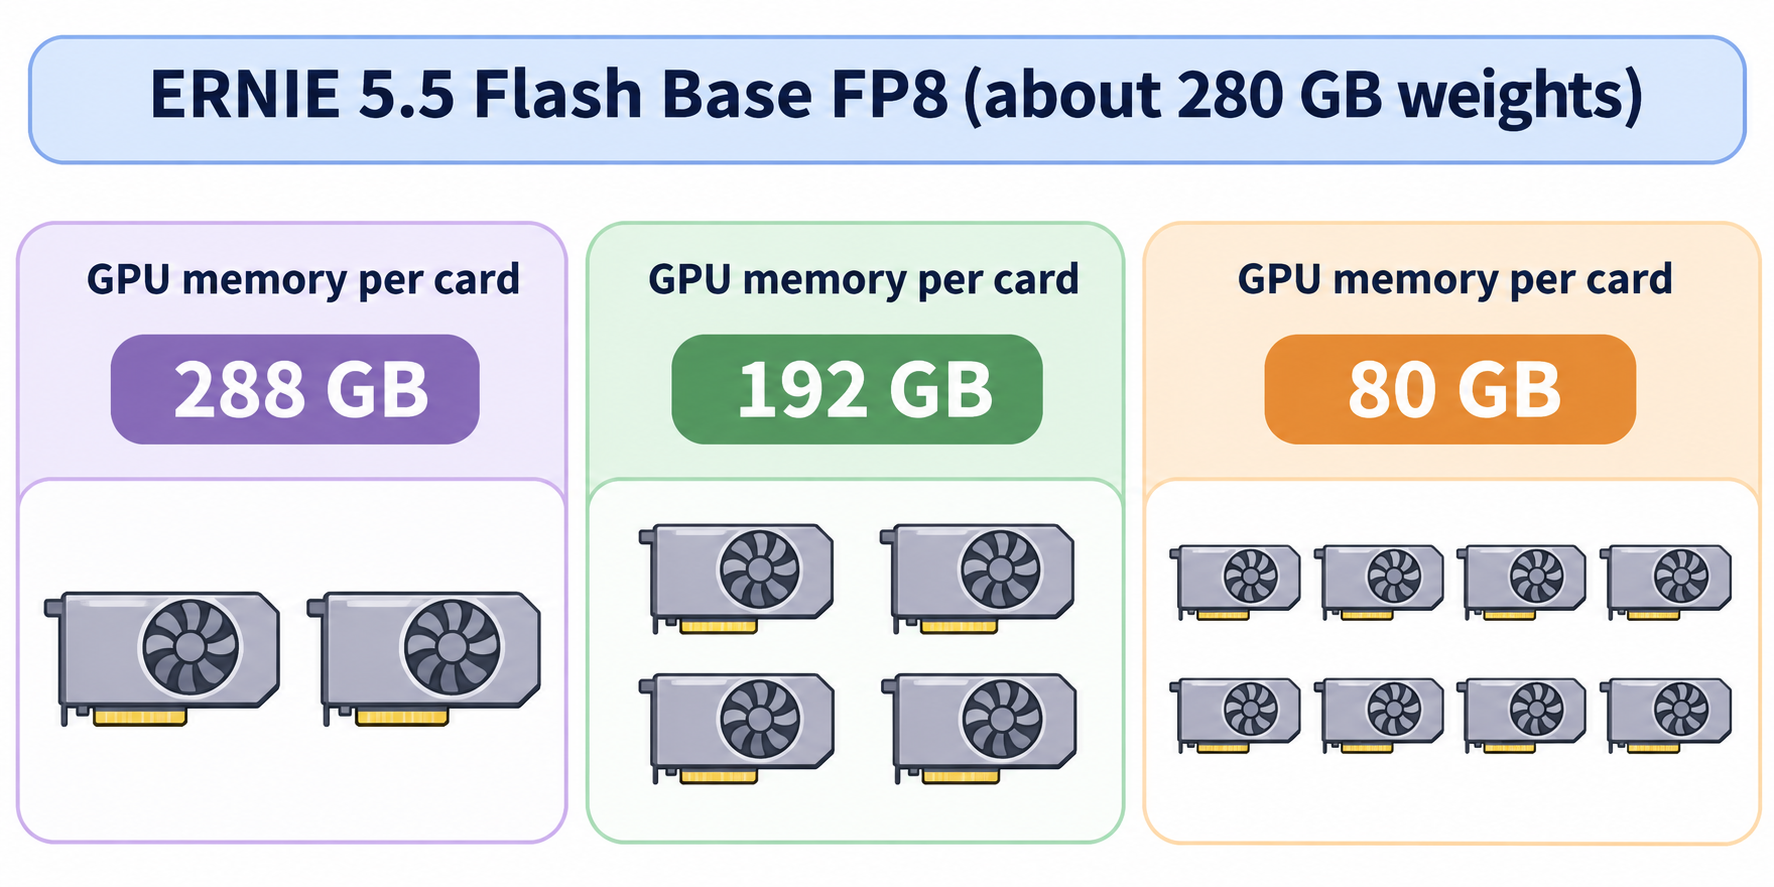
هذه هي الحدود الدنيا لتحميل الأوزان. وتحتاج ذاكرة التخزين المؤقت KV إلى مساحة إضافية فوق ذلك، ولهذا يعتمد طول السياق الذي يمكنك تقديمه على بطاقاتك:
- وحدات GPU بسعة 80 غيغابايت: قدّم FP8 على 8 وحدات GPU باستخدام
--data-parallel-size 8و--gpu-memory-utilization 0.93. يتسع حتى 262,144 رمزًا؛ أما 1 مليون فلا يتسع. - سياق بمليون رمز: قيم Baidu مخصصة لوحدات GPU بذاكرة 184 غيغابايت ثنائية، مع خفض نسبة الاستخدام إلى 0.85 لأن التجهيز المسبق (prefill) لمليون رمز يحتاج عشرات الغيغابايتات من الذاكرة المؤقتة.
- المعمارية مهمة: أوامر FP8 تمرر
--moe-backend humming، الذي يدعم تفعيل SiTU الخاص بالنموذج مع أوزان FP8 على وحدات GPU من فئة Blackwell. على وحدات GPU من فئة Hopper، احذف هذا الخيار واترك نواة MoE الافتراضية في vLLM.
كلمة «محليًا» تعني عتادًا تتحكم به: عقدة 8 GPU مستأجرة، أو خادم محلي داخل منشأتك، أو عنقود مختبري.
تثبيت vLLM وإضافة ERNIE
لا يدعم vLLM معمارية ERNIE 5.5 (Ernie5_5_MoeForCausalLM) بشكل افتراضي. توفرها Baidu كإضافة تعمل على حزمة vLLM 0.32.0 المُصدرة دون أي تعديل. أنشئ بيئة Python 3.12 وثبّت كليهما:
uv venv --python 3.12
source .venv/bin/activate
uv pip install vllm==0.32.0
uv pip install git+https://github.com/baidu/vLLM-ERNIE.git
تُحمَّل الإضافة من خلال نقطة الدخول vllm.general_plugins في كل عملية vLLM. إذا أخبرك vllm serve لاحقًا بأن Model architectures ['Ernie5_5_MoeForCausalLM'] are not supported، فذلك يعني أن الإضافة غير مثبتة في البيئة التي تشغّل vllm، أو أن VLLM_PLUGINS مضبوط دون تضمين ernie.
لجلب الأوزان من ModelScope بدلًا من Hugging Face، اضبط VLLM_USE_MODELSCOPE=True. أسماء المستودعات متطابقة على المنصتين. وإذا كنت جديدًا على vLLM نفسه، فإن نظرة عامة على vLLM لدينا تشرح الخادم وواجهته البرمجية المتوافقة مع OpenAI.
أمر vllm serve الخاص بـ ERNIE 5.5 Flash
هذا هو أمر FP8 من ملف README الخاص بـ vLLM-ERNIE، لعقدة واحدة بـ 4 وحدات GPU عند سياق التدريب البالغ 128K مع تشغيل فك التشفير التخميني ECHO:
export VLLM_ENGINE_READY_TIMEOUT_S=3600
vllm serve baidu/ERNIE-5.5-Flash-Base \
    --host 0.0.0.0 \
    --port 8000 \
    --data-parallel-size 4 \
    --enable-expert-parallel \
    --moe-backend humming \
    --kv-cache-dtype fp8 \
    --max-model-len 131072 \
    --speculative-config '{"method":"mtp","num_speculative_tokens":2}'
دور كل خيار، وفقًا لملاحظات Baidu:
- توازي بيانات للاهتمام (attention) مع توازي خبراء لـ MoE (
--data-parallel-size 4 --enable-expert-parallel) يحتفظ بأكبر قدر من ذاكرة KV المؤقتة ويوفر أعلى إنتاجية. أما التوازي الشدّي (tensor parallelism) (--tensor-parallel-sizeبقيمة 2 أو 4 أو 8) يخفض زمن الاستجابة عند التزامن المنخفض لكنه يحتفظ بذاكرة KV مؤقتة أقل. - ذاكرة KV المؤقتة بصيغة FP8 (
--kv-cache-dtype fp8) تخزن الذاكرة المؤقتة بصيغة FP8؛ بينما تُبقيها قيمةautoبصيغة BF16. - فك التشفير التخميني ECHO يعيد استخدام الطبقة الأخيرة للنموذج نفسها كمسودة مدمجة. هنا يصوغ خطوتين مسودة؛ وتعمل القيمتان 1 أو 3 أيضًا. احذف
--speculative-configللتشغيل دون مسودة.
تعرض بطاقة النموذج صيغة أقصر على المنفذ 30000 دون إعداد التخمين.
أمّن الخادم. هذه الأوامر ترتبط بـ 0.0.0.0 دون أي مصادقة. ينصح ملف README من Baidu بإضافة --api-key <key> أو الارتباط بـ 127.0.0.1 ما لم تكن الشبكة موثوقة. نفّذ أحد الخيارين قبل كشف المنفذ.
BF16 وسياق المليون رمز
يعمل BF16 عبر عقدتين بـ 4 وحدات GPU لكل منهما (DP8 مع EP8) باستخدام --data-parallel-size 8 و--data-parallel-size-local 4 و--data-parallel-address ${HEAD_IP} و--data-parallel-hybrid-lb؛ وتضيف العقدة الثانية --data-parallel-start-rank 4. انسخ الأمر الكامل من ملف README؛ فهو يضبط أيضًا واجهة الشبكة بين العقد.
للحصول على نافذة السياق الكاملة البالغة 1,048,576 رمزًا، مرر --max-model-len 1048576 و--gpu-memory-utilization 0.85، واخفض --max-num-seqs بحيث تتسع ذاكرة KV المؤقتة لكل رتبة طلبات كاملة بمليون رمز.
استدعاء نقطة النهاية المتوافقة مع OpenAI
يكشف vLLM مسارات بأسلوب OpenAI، لكن نموذج Base لا يملك قالب محادثة، لذا تستدعي /v1/completions بمُدخل نصي خام. للاستخدام بمثال قليل (few-shot)، ضع الأمثلة في المُدخل وأوقف التوليد عند نهاية إجابة واحدة:
curl http://127.0.0.1:8000/v1/completions \
    -H 'Content-Type: application/json' \
    -d '{
        "model": "baidu/ERNIE-5.5-Flash-Base",
        "prompt": "Question: What is 15% of 240?\nAnswer:",
        "max_tokens": 64,
        "temperature": 0,
        "stop": ["\n"]
    }'
وفقًا لملف README من Baidu، يعود النص المُكمل بقيمة 36. ثلاث تفاصيل تربك المستخدمين:
- مرر
"temperature": 0لفك التشفير الجشع. يضبط ملفgeneration_config.jsonللنموذج قيمdo_sample=falseوtemperature=1.0وtop_p=0.95. يطبّق vLLM درجة الحرارة وtop_p لكنه يتجاهلdo_sample، لذا سيأخذ عينات ما لم تتجاوز هذا الإعداد. - لا تضف
<|ERNIE_MASK|>بنفسك. يسبقه مُرمِّز الرموز تلقائيًا (بمعرّف الرمز 2) في مُدخلات الإكمال. - طابق اسم النموذج. استخدم
baidu/ERNIE-5.5-Flash-Base-BF16عند تشغيل أوزان BF16.
أي حزمة OpenAI SDK تعمل إذا وجّهت base_url إلى http://<host>:8000/v1 واستدعيت الإكمالات، وليس إكمالات المحادثة.
Base مقابل Preview: أيهما تستخدم؟
استخدم Base إذا كنت تخطط للتدريب فوقه؛ واستخدم Preview إذا احتجت مساعدًا جاهزًا الآن. يمنحك Base تحكمًا كاملًا وبيانات لا تغادر خوادمك أبدًا. ويمنحك Preview المحادثة والاستدلال واستدعاء الأدوات، لكن عبر Qianfan أو OpenRouter فقط.
عندما تتوفر أوزان Preview، تكون الإضافة جاهزة لها مسبقًا. يوثّق ملف README الخيارات الإضافية الموسومة بـ «قريبًا»: --reasoning-parser ernie5 --tool-call-parser ernie5 --enable-auto-tool-choice، بالإضافة إلى نموذج مسودة DSpark لفك التشفير التخميني. ستظهر عملية التفكير في reasoning_content واستدعاءات الأدوات في message.tool_calls، لذا يتحول الخادم نفسه الذي تبنيه اليوم إلى واجهة خلفية للمحادثة بمجرد تبديل الأوزان وإضافة ثلاثة خيارات.
الرخصة هي الفرق الآخر. يُصدر Base بموجب اتفاقية ترخيص ERNIE 5.5 Flash Base Model License v1.0، وليس Apache 2.0. اقرأ الرخصة الكاملة قبل بناء منتج عليها. بتاريخ 12 نوفمبر 2026 كانت تنص على:
- الاستخدام غير التجاري مجاني، دون الحاجة إلى أي إشعار.
- الاستخدام التجاري للمنتجات التي تحقق حتى 50 مليون دولار سنويًا مجاني من رسوم الترخيص، لكن يجب عليك عرض عبارة «Powered by ERNIE» وإرسال إشعار لمرة واحدة إلى Baidu.
- فوق 50 مليون دولار سنويًا، تحتاج أولًا إلى تفويض كتابي منفصل من Baidu.
- «النطاق الجغرافي» في الرخصة يستثني الاتحاد الأوروبي والمملكة المتحدة وكوريا الجنوبية.
للحصول على نموذج مفتوح الأوزان أصغر يمكنك استضافته ذاتيًا بوحدات GPU أقل، راجع دليلنا حول استضافة GLM-5.3 ذاتيًا.
دع وكيل البرمجة لديك يختبر نقطة النهاية باستخدام Apidog CLI
نشر vLLM الجديد يحتاج إلى اختبار أولي يمكنك إعادة تشغيله بعد كل تعديل على الخيارات: الحالة، ومخطط الاستجابة، وعدد الرموز في الثانية. سلّم هذه المهمة لوكيل البرمجة لديك وApidog CLI بدلًا من إعادة كتابة أوامر curl يدويًا.
اضبط واجهة CLI مرة واحدة:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
ثم امنح Claude Code أو Codex أو Cursor مُدخلًا واحدًا:
In Apidog project <projectId>, create an environment "ernie-local" with base URL
http://<gpu-host>:8000. Add a test case for POST /v1/completions with model
baidu/ERNIE-5.5-Flash-Base, prompt "Question: What is 15% of 240?\nAnswer:",
max_tokens 64, temperature 0. Assert status 200, that choices[0].text exists,
and that usage.completion_tokens > 0; log completion_tokens divided by the
response time in seconds as tokens/s. Run it and summarize the result.
يقرأ الوكيل مخطط الحمولة، ويتحقق منه، ويكتب حالة الاختبار ويشغّلها:
apidog environment create ernie-local --project <projectId> --base-url http://<gpu-host>:8000
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
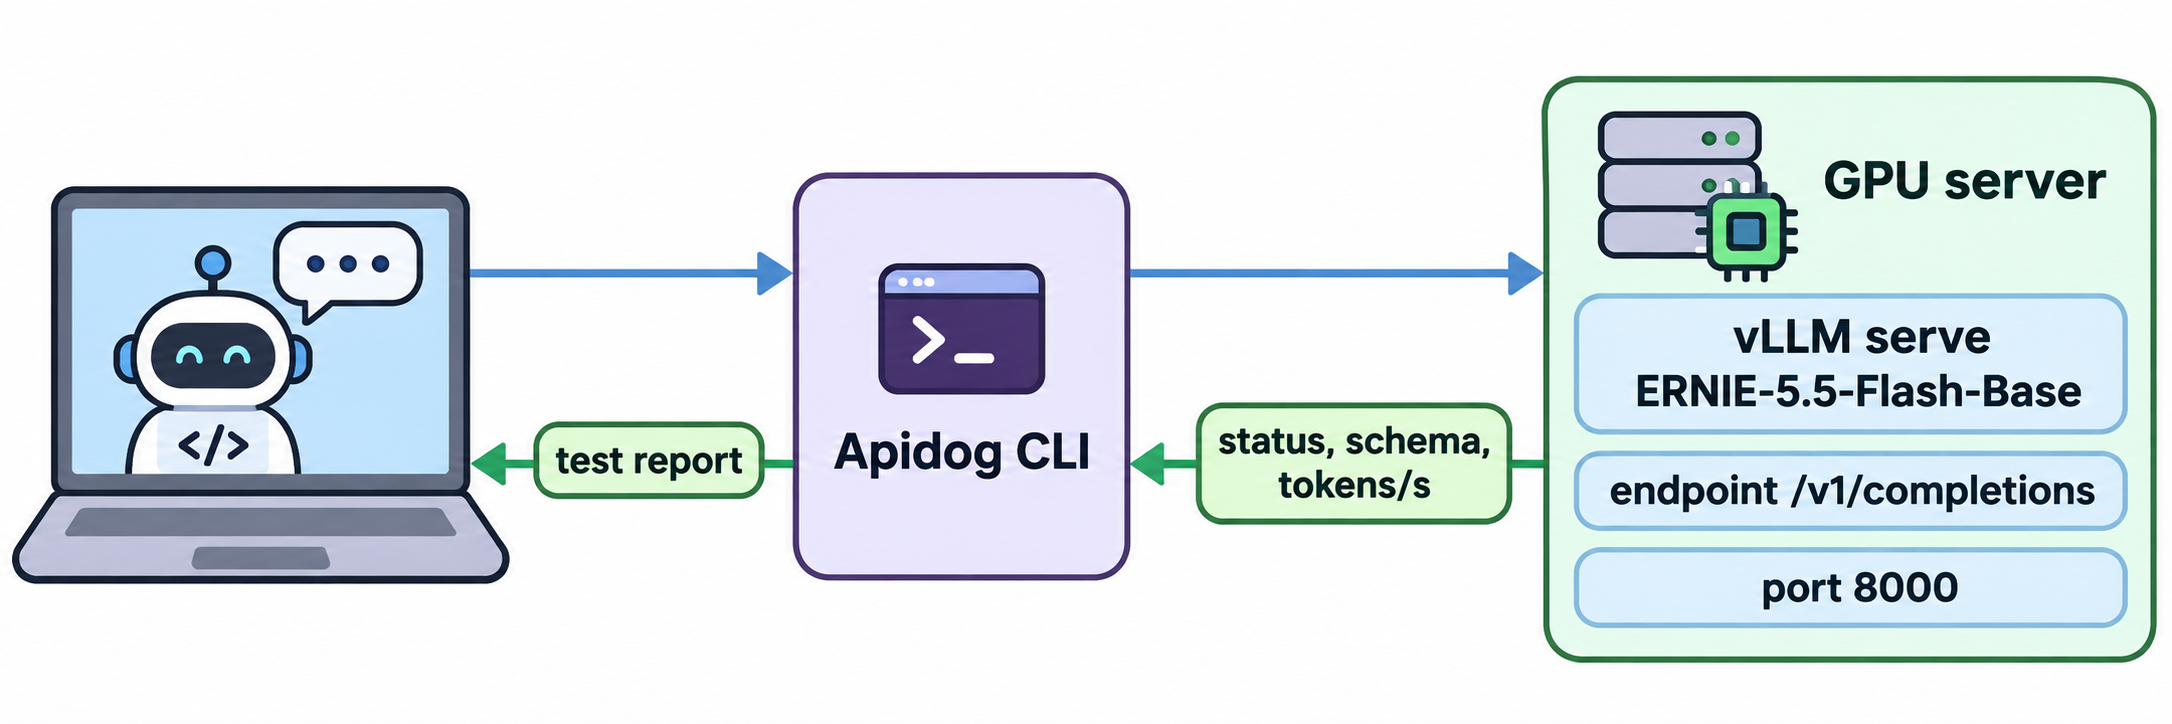
شغّل واجهة CLI من جهاز يمكنه الوصول إلى المنفذ 8000. إذا ضبطت --api-key على الخادم، اطلب من الوكيل تخزينها كمتغير بيئة وإرسالها كرمز Bearer. أعد تشغيل الحالة نفسها بعد تغيير --tensor-parallel-size أو تعطيل فك التشفير التخميني أو رفع --max-model-len، وستحصل على مقارنة عادلة بين الأحوال. أضف -r junit وستُدرج العملية نفسها في خط CI/CD. للاطلاع على إعداد الوكيل خطوة بخطوة، راجع Apidog CLI في Claude Code. تغطي الخطة المجانية من Apidog حتى 4 مستخدمين.
الأسئلة الشائعة
هل يمكنني تشغيل ERNIE 5.5 Flash على وحدة GPU استهلاكية واحدة؟ لا. أوزان FP8 تشغل نحو 280 غيغابايت، وأصغر إعداد تذكره Baidu هو وحدتا GPU بسعة 288 غيغابايت لكل منهما. مع بطاقات بسعة 80 غيغابايت تحتاج إلى 8 منها. استخدم Preview عبر الواجهة البرمجية إذا لم تمتلك هذا العتاد.
هل أوزان ERNIE 5.5 Flash Preview متاحة؟ لا، حتى 12 نوفمبر 2026. تقول Baidu إنها ستُفتح المصدر قريبًا بموجب Apache 2.0، وتُدرج إضافة vLLM-ERNIE نموذج المحادثة ضمن «قريبًا». فقط أوزان Base (FP8 وBF16) متوفرة على Hugging Face.
لماذا يفشل /v1/chat/completions على نموذج Base؟ لأن Base لم يُدرَّب على المحادثة ولا يملك قالب محادثة. تقدمه Baidu عبر /v1/completions بمُدخل نصي خام. ضع أمثلة few-shot في المُدخل واستخدم تسلسل إيقاف.
هل يدعم vLLM إصدار ERNIE 5.5 بشكل أصلي؟ لا، ليس في نواة vLLM. تحتاج إلى إضافة vLLM-ERNIE من Baidu فوق vLLM 0.32.0. وتعمل على وحدات NVIDIA فقط. كما يقدم SGLang النموذج عبر صورة Docker مخصصة مذكورة في بطاقة النموذج.
هل يمكنني استخدام ERNIE 5.5 Flash Base تجاريًا؟ نعم، بشروط. المنتجات التي تحقق حتى 50 مليون دولار سنويًا يمكنها استخدامه مجانًا من رسوم الترخيص مع نسب الفضل «Powered by ERNIE» وإشعار لمرة واحدة إلى Baidu. وفوق ذلك تحتاج إلى تفويض كتابي، ويستثني نطاق الرخصة الجغرافي الاتحاد الأوروبي والمملكة المتحدة وكوريا الجنوبية.