
يمكنك تشغيل DeepSeek V4 Flash محليًا دون وحدة معالجة رسومات باستخدام llama-modchip، وهي مجموعة من تصحيحات llama.cpp مفتوحة المصدر تقلّص نموذج 284B إلى ملف GGUF بحجم 56.56 GiB بمعدل 1.71 بت لكل وزن. على شريحة حاسوب محمول AMD Zen 5 بـ 16 نواة و64 جيجابايت من الذاكرة العشوائية، يبلغ معدل التعبئة المسبقة (prefill) حوالي 44 رمزًا في الثانية، ومعدل فك الترميز (decode) من 9 إلى 15 رمزًا في الثانية، دون أي استخدام للذاكرة الافتراضية (swap).
يغطي هذا الدليل متطلبات العتاد، والأوامر، والمقايضات في الجودة، وكيف يمكن لوكيل البرمجة الخاص بك اختبار نقطة النهاية المحلية.
ما الذي يفعله llama-modchip فعلًا
llama-modchip هي مجموعة من تصحيحات نوى ggml وllama.cpp، ومحوّلات ترميز كمي (quantization transcoders) وأدوات تشغيل لتشغيل نماذج Mixture-of-Experts المتفرقة بالكامل في ذاكرة النظام العشوائية. يستهدف إصدارها v2.4.0 حجمين من النماذج: نموذج DeepSeek-V4-Flash بحجم 284B على أجهزة بذاكرة 64 جيجابايت، ونماذج MoE بحجم 30B على أجهزة بذاكرة 16 إلى 32 جيجابايت.
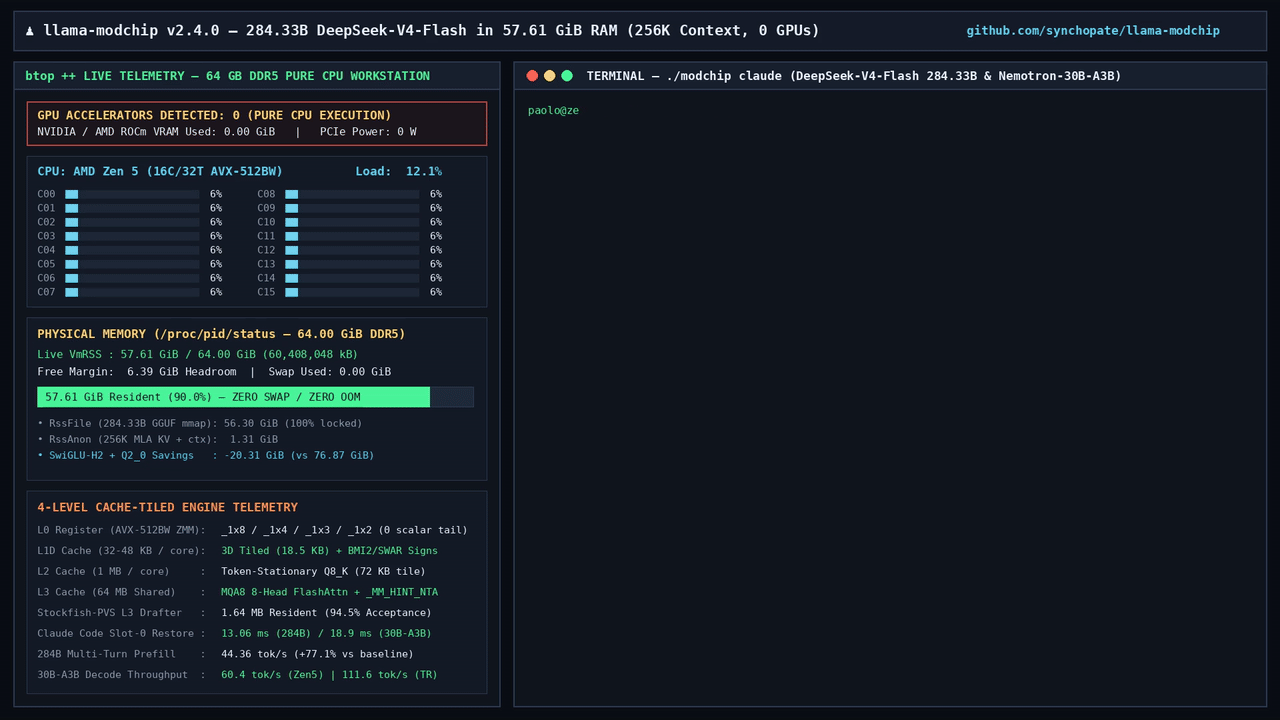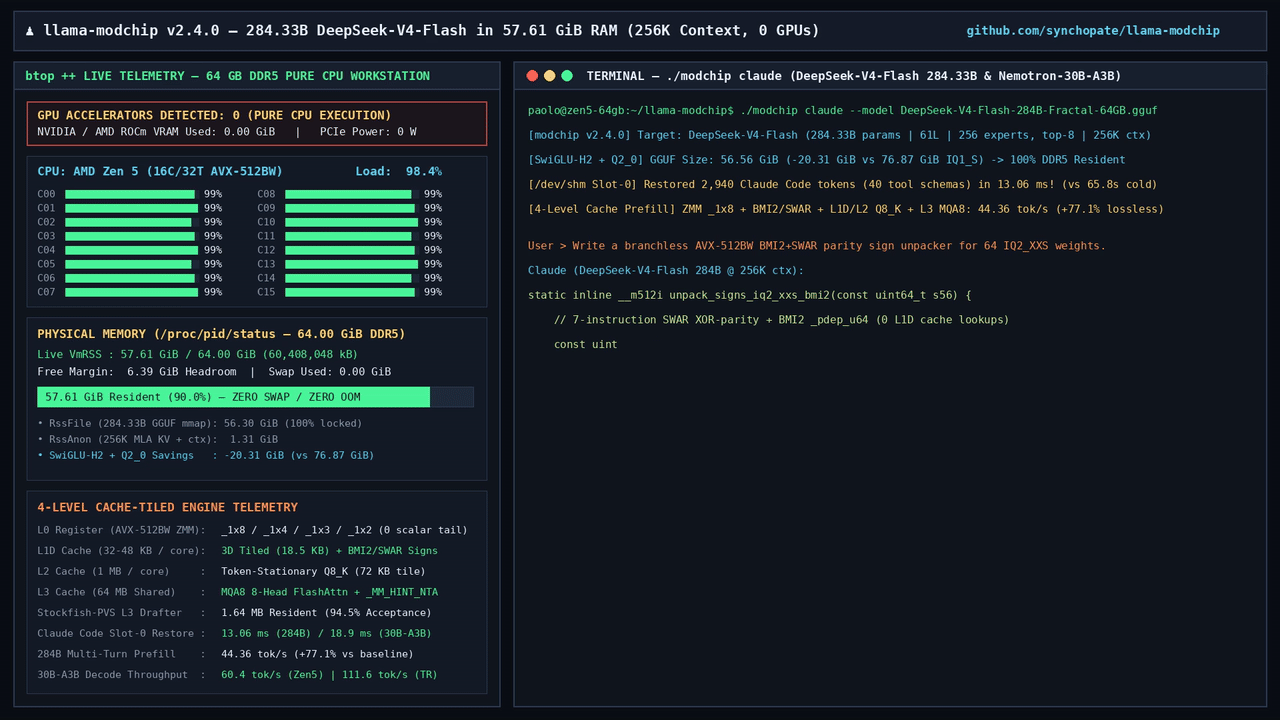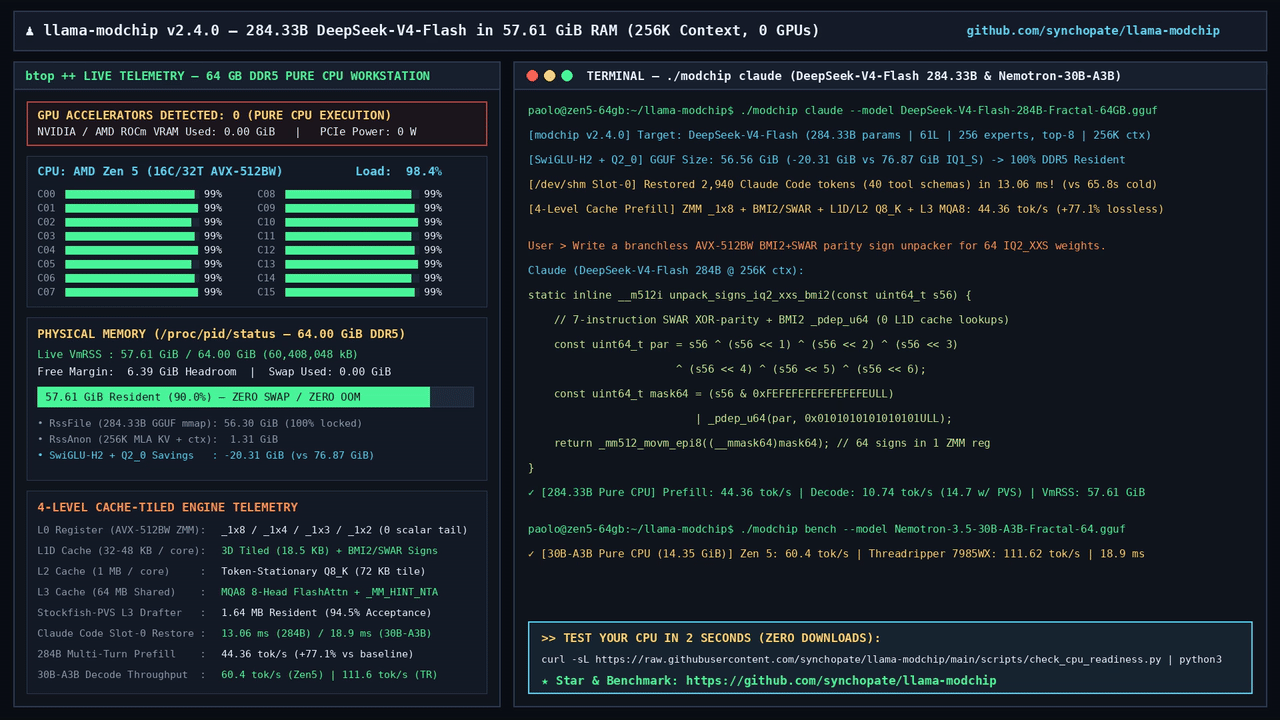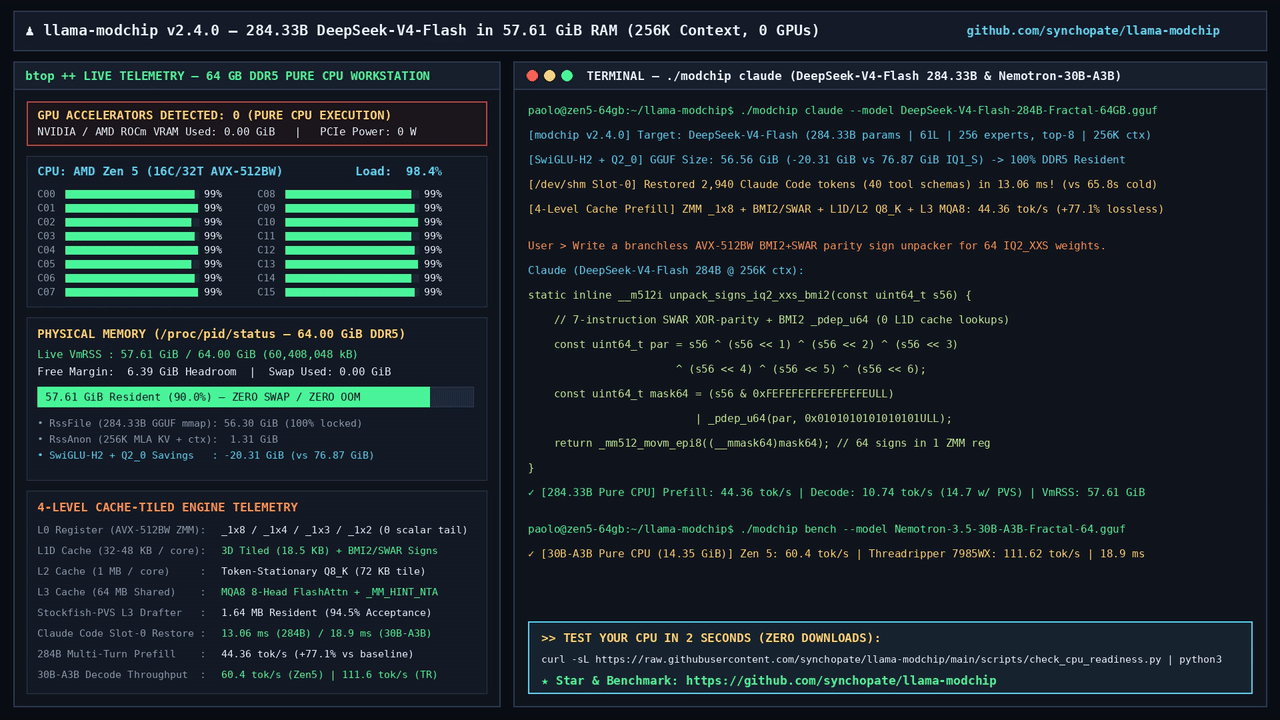
تم نشر المشروع على Hacker News في 8 نوفمبر 2026 وتجاوز 370 نقطة. المستودع مرخّص بموجب Apache 2.0.
هناك ثلاثة أمور تجعل نموذج 284B يتسع في الذاكرة:
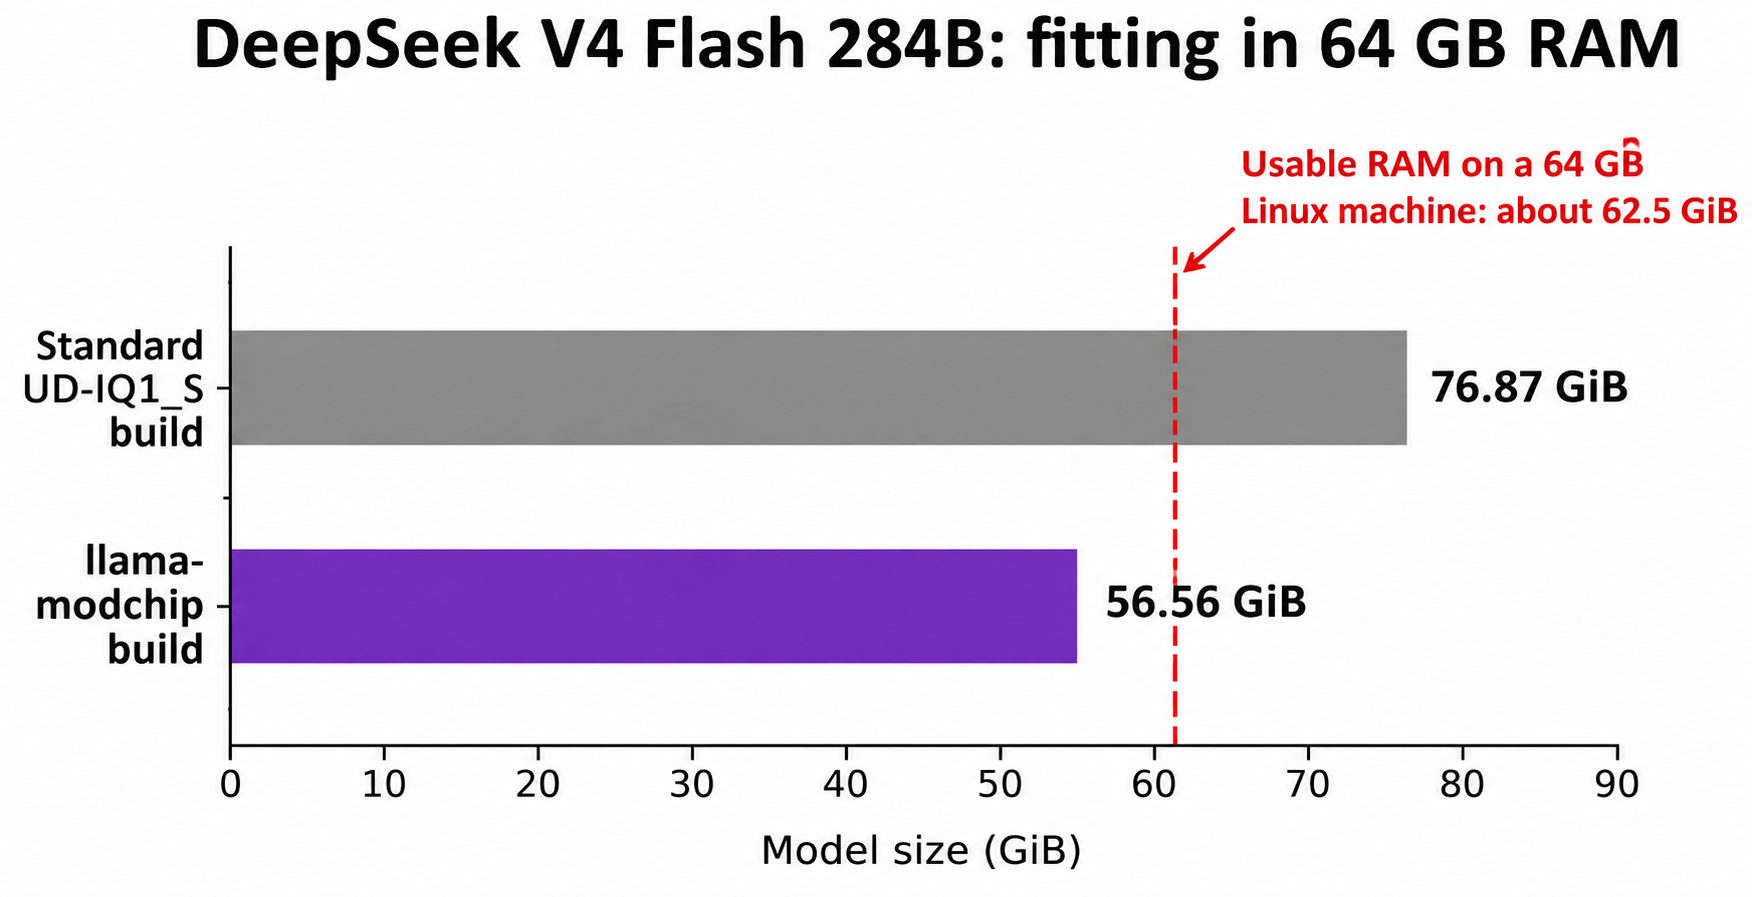
- نقطة تفتيش (checkpoint) أصغر. نسخة Unsloth القياسية
UD-IQ1_Sتبلغ 76.87 GiB، أي أكثر من حوالي 62.5 GiB التي يمكن لجهاز لينكس بذاكرة 64 جيجابايت استخدامها. يحوّلها llama-modchip إلى 56.56 GiB. - تقسيم ذاكرة التخزين المؤقت للمعالج (cache tiling). تقسّم نوى prefill العمل عبر السجلات وذاكرة التخزين المؤقت من L1 إلى L3: بمعدل 25.0 إلى 44.36 رمزًا في الثانية على Zen 5 بـ 16 نواة، أي تحسّن بنسبة 77%.
- الصياغة الذاتية التخمينية (self-speculative drafting). يرفع مُصوغ n-gram بحجم 1.64 ميجابايت معدل فك الترميز من حوالي 9 إلى 14.7 رمزًا في الثانية كحد أقصى.
بشكل افتراضي، تعمل جميع الخبراء الموجَّهين الـ 6 بالإضافة إلى الخبير المشترك في كل طبقة، فلا يتم استبعاد أي شيء.
العتاد الذي تحتاجه لتشغيل DeepSeek V4 Flash محليًا
تحتاج إلى 64 جيجابايت من ذاكرة النظام العشوائية ومعالج x86_64 حديث، ويفضل أن يدعم AVX-512. جميع أرقام نموذج 284B في هذا الدليل قيسها المشرف على جهاز واحد: AMD Ryzen 9 9955HX (16 نواة، 32 خيط، 64 ميجابايت L3) مع 64 جيجابايت من DDR5 على لينكس، بدون وحدة معالجة رسومات.
| جهازك | الذاكرة العشوائية | ما يقرنه README به | السرعة المُبلَّغ عنها (بدون GPU) |
|---|---|---|---|
| حاسوب محمول أو حاسوب مصغّر | 16 إلى 32 جيجابايت | Nemotron-3.5-30B-A3B، بحجم 14.35 GiB | 25.0 إلى 60.4 رمزًا/ث |
| حاسوب مكتبي أو خادم | 64 جيجابايت | DeepSeek-V4-Flash 284B، بحجم 56.56 GiB | 44.4 رمزًا/ث prefill، 9.1 إلى 14.7 رمزًا/ث decode |
| محطة عمل بـ 8 قنوات | 128 جيجابايت أو أكثر | DeepSeek 284B أو Nemotron 30B | 111.62 رمزًا/ث (نموذج 30B فقط) |
- استهلاك الذاكرة يبلغ ذروته عند 57.61 إلى 58.9 GiB مع سياق 256K، وهو ما يبقى تحت السقف القابل للاستخدام البالغ 62.5 GiB. أغلق كل التطبيقات الأخرى قبل تحميله.
- الملف التنفيذي الجاهز يعمل على لينكس x86_64 فقط (
llama-server-modchip-linux-x86_64). سكربت الإعداد./modchipيدعم لينكس وmacOS. نتائج Apple Silicon في README تخص نماذج 30B وليس 284B. [تحقق] من إمكانية تشغيل 284B على جهاز Mac بذاكرة 64 جيجابايت. - عرض نطاق الذاكرة هو العامل المحدد. تقول الأسئلة الشائعة إن لوحة خادم بـ 8 أو 12 قناة تضاعف سرعة فك الترميز بحوالي 3 إلى 4 مرات مقارنة بـ DDR5 ثنائي القناة.
يأتي المستودع مع فحص جاهزية لا يُنزّل أي نموذج:
curl -sL https://raw.githubusercontent.com/synchopate/llama-modchip/main/scripts/check_cpu_readiness.py | python3
اقرأ السكربت قبل تمريره إلى Python.
كيفية تشغيل DeepSeek V4 Flash بدون GPU، خطوة بخطوة
الطريقة 1: الإعداد المُوجَّه
git clone https://github.com/synchopate/llama-modchip.git
cd llama-modchip
./modchip chat
يفتح الأمر ./modchip chat محادثة في الطرفية مع عرض مباشر لعدد الرموز في الثانية. الأوامر الفرعية الأخرى:
| الأمر | ما يفعله |
|---|---|
./modchip web |
محادثة ويب وقياسات على http://127.0.0.1:8787 |
./modchip bench |
اختبار سرعة لمدة 30 ثانية مع بطاقة نتائج قابلة للمشاركة |
./modchip claude |
يشغّل Claude Code متصلًا بالمحرك المحلي |
./modchip status / stop |
يفحص الجاهزية أو يوقف الخدمات في الخلفية |
الطريقة 2: الخادم المباشر
هذه الطريقة تنزّل ملف GGUF والخادم الجاهز من مستودع Hugging Face وتشغّله على المنفذ 8080:
hf download Synchopate/DeepSeek-V4-Flash-0731-Fractal-64GB-CPU-GGUF --local-dir ./dsv4
chmod +x ./dsv4/llama-server-modchip-linux-x86_64
./dsv4/llama-server-modchip-linux-x86_64 \
  -m ./dsv4/DeepSeek-V4-Flash-0731-Fractal-00001-of-00003.gguf \
  -c 32768 -t 16 -fa on --port 8080
اضبط -t على عدد الأنوية الفعلية لديك. يستخدم المثال سياق 32K؛ أما أرقام 256K فتستخدم -c 262144.
مطبقة واحدة: نسخ llama.cpp الأصلية وOllama وLM Studio لا يمكنها تحميل هذا الملف. تستخدم نقطة التفتيش نوع موتر (tensor type) مخصصًا (المعرّف 40)، لذا تفشل النسخ غير المصححة بخطأ unknown tensor type 40. استخدم سكربت ./modchip أو الملف التنفيذي المرفق.
الخادم هو نسخة مصححة من llama-server الخاص بـ llama.cpp، لذا يدعم مسار /v1/chat/completions بأسلوب OpenAI:
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"messages":[{"role":"user","content":"Reply with the word ready."}],"max_tokens":8}'
البوابة على المنفذ 8787
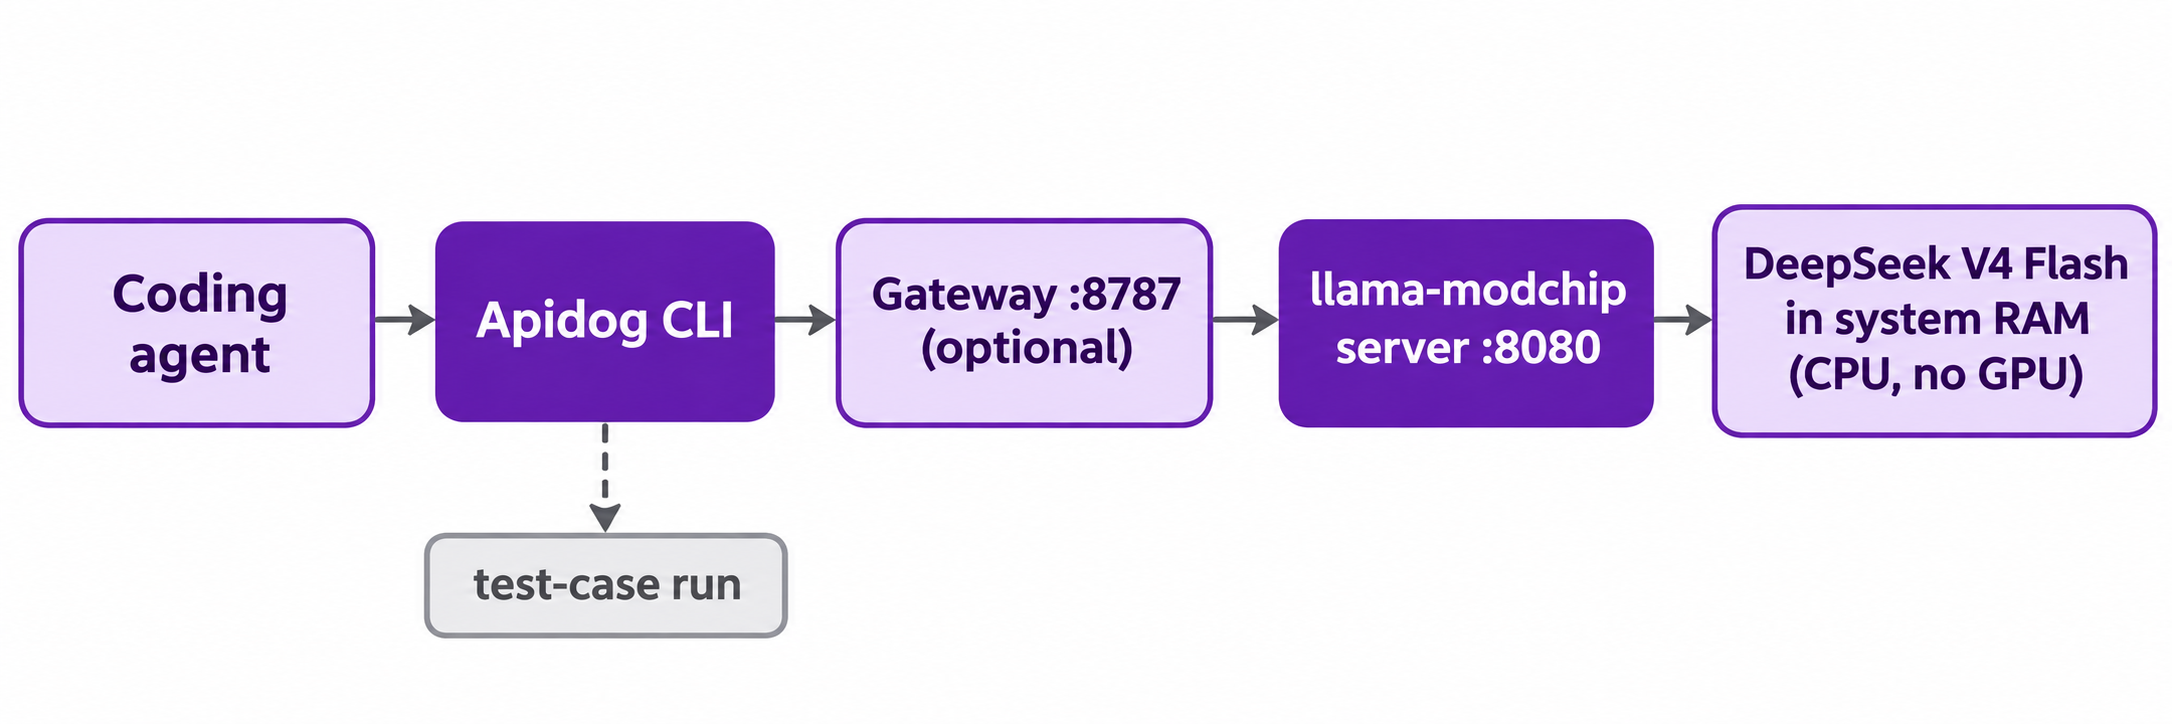
gateway/sse_gateway.py هو وكيل (proxy) على 127.0.0.1:8787 يعيد التوجيه إلى المحرك (اضبط العنوان المصدر باستخدام LLAMA_BACKEND_URL). وهو يوفر /v1/chat/completions و/v1/messages و/v1/models و/health. اضبط GATEWAY_API_KEY وسيصبح مطلوبًا رمز حامل (bearer token). يشير الأمر ./modchip claude إلى هذه البوابة لـ Claude Code.
السرعة والجودة: ما الذي تكلفك به 1.71 بت لكل وزن
أرقام السرعة حقيقية لكنها مرتبطة بشروط محددة. إليك جدول المشرف لـ DeepSeek-V4-Flash بسياق 256K على Ryzen 9 9955HX:
| التكوين | Prefill | Decode | Decode مع المُصوغ |
|---|---|---|---|
UD-IQ1_S غير المصحح (76.87 GiB) |
نفاد الذاكرة أو swap على 64 جيجابايت | 5.91 رمزًا/ث | غير متاح |
| الافتراضي في v2.4.0 (Top-6، 56.56 GiB) | 43.16 إلى 44.36 رمزًا/ث | 9.06 إلى 9.95 رمزًا/ث | 11.5 إلى 14.7 رمزًا/ث |
| Top-5 على الطبقات اللاحقة | 43.16 إلى 44.36 رمزًا/ث | 9.68 إلى 9.87 رمزًا/ث | 12.2 إلى 15.1 رمزًا/ث |
| Top-4 مع SwiGLU بالبوابة أولاً | 43.16 إلى 44.36 رمزًا/ث | 10.12 إلى 10.74 رمزًا/ث | 13.0 إلى 16.0 رمزًا/ث |
تنتقل إلى الصفوف الأسرع باستخدام LLAMA_MOE_TOP_K=5 أو 4. يقول README إن Top-5 يضيف حوالي 0.42% من الارتباك (perplexity) مقارنةً بإعداده الافتراضي.
تنبيهان تكررا كثيرًا في نقاشات Hacker News:
- كلمة «بدون فقدان» تعني بدون فقدان مقارنةً بملف 1.71 bpw، وليس مقارنةً بالأوزان الأصلية. تشابه الكوساينوس البالغ 1.00000 يقارن بين بيئات التشغيل المصححة وغير المصححة على نفس نقطة التفتيش المضغوطة، حيث تقع معظم الخبراء الموجَّهين عند
IQ1_S(حوالي 1.56 بت). لاحظ المعلّقون أن الجودة تنخفض عادةً تحت 4 بت، وأن README لا يتضمن أي مقارنة مع مخرجات الدقة الكاملة. - Prefill هو العائق الرئيسي للوكلاء. بمعدل 44 رمزًا في الثانية، يستغرق طلب بحجم 10,000 رمز حوالي 225 ثانية قبل ظهور أول رمز من المخرجات. لقطات KV (استغراق 13.1 إلى 32.6 ميلي ثانية لاستعادة طلب Claude Code بـ 40 أداة) تساعد في الأدوار المتكررة، وليس عند السياق الجديد.
ملاحظة إضافية: هذه نقطة تفتيش V4-Flash الصادرة في يوليو بعلامة 0731. أصدرت DeepSeek لاحقًا نسخة V4.1 Flash. إذا كانت أحدث الأوزان مهمة لك، اقرأ أولًا كيف يقارن DeepSeek V4.1 Flash بـ V4 Pro وV4 Flash.
عامل نموذج 284B المحلي كنموذج خاص وغير متصل بالإنترنت للمسودات والمهام الدفعية والتجارب، واختبره أولًا على طلباتك الخاصة.
دع وكيل البرمجة يختبر نقطة النهاية المحلية باستخدام Apidog CLI
النموذج المحلي يبقى واجهة برمجة تطبيقات: هل يجيب؟ هل صيغة JSON صحيحة؟ هل كسر آخر تغيير في المعاملات شيئًا ما؟ يمكن لوكيل البرمجة تنفيذ هذه الفحوصات باستخدام Apidog CLI، الذي يعمل على جهازك ويصل إلى 127.0.0.1 مباشرة. أعدّه مرة واحدة:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
يضيف الأمر apidog skill install مهارة Apidog ليعرف وكيلك الأوامر. ثم أعطِ الوكيل، على سبيل المثال Claude Code، طلبًا واحدًا:
In Apidog project <projectId>, create an environment called local-dsv4 with base URL
http://127.0.0.1:8080. Add a POST /v1/chat/completions endpoint and a test case that
sends a short prompt, asserts status 200, asserts choices[0].message.content is not empty,
and asserts the response time is under 120 seconds. Run it against local-dsv4 and
summarize any failures.
يقرأ الوكيل المخططات (schemas)، ويتحقق من صحة حمولاته، ثم يكتب ويشغّل:
apidog environment create local-dsv4 --project <projectId> --base-url http://127.0.0.1:8080
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog test-case run <caseId> --project <projectId> -e <envId> -r cli,json --timeout-request 180000
الخيار --timeout-request (بالمللي ثانية) مهم: النموذج 284B المقيّد بالمعالج بطيء بما يكفي لتجاوز المهلة الافتراضية.
الفائدة الحقيقية هي المقارنة: وجّه بيئة ثانية إلى واجهة DeepSeek السحابية، وشغّل نفس حالة الاختبار، وشاهد أين ينحرف الترميز الكمي المحلي. أضف --upload-report لعرض عمليات التشغيل في التطبيق. راجع Apidog CLI في Claude Code ودليل تثبيت Apidog CLI. تغطي الخطة المجانية من Apidog حتى 4 مستخدمين.
المعالج المحلي مقابل GPU مقابل الواجهة السحابية
| الخيار | ما تحتاجه | الأفضل لـ |
|---|---|---|
| llama-modchip على المعالج | 64 جيجابايت RAM، معالج x86_64 حديث | العمل الخاص وغير المتصل بالإنترنت دون فاتورة API، إذا قبلت بطء prefill |
| خدمة النموذج على GPU باستخدام vLLM أو SGLang | ذاكرة فيديو كبيرة أو جهاز متعدد وحدات GPU | الاستضافة الذاتية السريعة بدقة أعلى |
| واجهة DeepSeek السحابية | مفتاح API | مخرجات بجودة كاملة وبسرعة إنتاجية |
لمسار GPU، اتبع كيفية تشغيل DeepSeek V4 محليًا، الذي يغطي vLLM وSGLang. لحسابات الذاكرة لنقطة التفتيش الأحدث، راجع كيفية تشغيل DeepSeek V4.1 Flash محليًا. ولاختبار أي نموذج محلي كواجهة برمجة، راجع اختبار نماذج LLM المحلية كواجهات برمجية.
الأسئلة الشائعة
هل يمكنني فعلًا تشغيل DeepSeek V4 Flash بدون GPU؟
نعم، باستخدام llama-modchip و64 جيجابايت من الذاكرة العشوائية. يبلغ المشرف عن 44.36 رمزًا في الثانية لـ prefill و9 إلى 15 رمزًا في الثانية لـ decode على Ryzen 9 9955HX بـ 16 نواة، مع النموذج الكامل بحجم 56.56 GiB في الذاكرة وبدون swap.
هل يعمل مع Ollama أو LM Studio؟
لا. تستخدم نقطة التفتيش نوع موتر مخصصًا، وترفض نسخ llama.cpp غير المصححة وOllama وLM Studio تحميله بخطأ unknown tensor type 40. استخدم سكربت ./modchip من المستودع أو الملف التنفيذي المرفق llama-server-modchip-linux-x86_64.
ماذا لو كانت لديّ 16 أو 32 جيجابايت فقط من الذاكرة العشوائية؟
شغّل نموذج MoE بحجم 30B بدلًا من ذلك. يقرن README تلك الفئة مع Nemotron-3.5-30B-A3B كملف بحجم 14.35 GiB، ويبلّغ عن 25.0 إلى 60.4 رمزًا في الثانية على المعالج.
ما مدى جودة المخرجات بمعدل 1.71 بت لكل وزن؟
لا يقارن المشروع بينه وبين DeepSeek الكامل بدقته الأصلية، وكان معلّقو Hacker News متشككين عند هذا الحجم. اختبر طلباتك مقارنةً بالواجهة السحابية قبل الاعتماد عليه.
هل الخادم المحلي متوافق مع OpenAI؟
نعم. إنه نسخة مصححة من llama-server الخاص بـ llama.cpp، لذا يعمل /v1/chat/completions على المنفذ 8080. كما توفر البوابة الاختيارية على المنفذ 8787 مسار /v1/messages بأسلوب Anthropic الذي يستخدمه Claude Code.
هل يمكن لوكيل البرمجة الخاص بي اختبار النموذج المحلي تلقائيًا؟
نعم. ثبّت Apidog CLI، وشغّل apidog skill install، واطلب من وكيلك إنشاء بيئة تشير إلى http://127.0.0.1:8080 وحالة اختبار لمسار /v1/chat/completions. سيشغّل بعد ذلك apidog test-case run ويبلّغ عن الإخفاقات.