
تواصل سلسلة Qwen من Alibaba دفع الحدود في نماذج اللغة الكبيرة، ويبرز Qwen3-Next-80B-A3B كمثال رئيسي على الكفاءة التي تلتقي بالأداء العالي. يبحث المهندسون والمطورون عن نماذج توفر استدلالًا قويًا دون العبء الحسابي للعمالقة الكثيفة. يلبي هذا النموذج هذا الطلب مباشرةً، حيث يضم 80 مليار معلمة ولكنه ينشط 3 مليارات فقط لكل رمز. وبالتالي، تحقق الفرق سرعات استدلال أسرع وتكاليف تدريب مخفضة، مما يجعله مثاليًا لعمليات النشر في العالم الحقيقي.
في هذا المنشور، ستستكشف المكونات الأساسية لـ Qwen3-Next-80B-A3B، وتفحص بنيته المبتكرة، وتراجع بيانات الأداء التجريبية، وتتقن واجهة برمجة التطبيقات الخاصة به من خلال خطوات عملية. علاوة على ذلك، ستقوم بدمج أدوات مثل Apidog لتعزيز سير عملك. بحلول النهاية، ستمتلك المعرفة اللازمة لنشر هذا النموذج بفعالية في تطبيقاتك.
ما الذي يميز Qwen3-Next-80B-A3B؟ الميزات الأساسية والابتكارات
يظهر Qwen3-Next-80B-A3B من عائلة Qwen من Alibaba كنموذج Mixture of Experts (MoE) متفرق ومحسن لكل من السرعة والقدرة. يقوم المطورون بتنشيط جزء صغير فقط من معلماته أثناء الاستدلال، مما يترجم إلى توفير كبير في الموارد. على وجه التحديد، يستخدم هذا النموذج إعداد MoE فائق التفرق مع 512 خبيرًا، ويوجه إلى 10 خبراء لكل رمز جنبًا إلى جنب مع خبير مشترك واحد. ونتيجة لذلك، فإنه ينافس أداء النماذج الأكثر كثافة مثل Qwen3-32B بينما يستهلك طاقة أقل بكثير.
علاوة على ذلك، يدعم النموذج التنبؤ بالرموز المتعددة، وهي تقنية تسرع فك التشفير التخميني. تتيح هذه الميزة للنموذج إنشاء رموز متعددة في وقت واحد، مما يعزز الإنتاجية في مراحل فك التشفير. يقدر المطورون هذا للتطبيقات التي تتطلب استجابات سريعة، مثل روبوتات الدردشة أو أدوات التحليل في الوقت الفعلي.
تتضمن السلسلة متغيرات مصممة خصيصًا لاحتياجات محددة: النموذج الأساسي للتدريب المسبق العام، ونسخة التعليمات للمهام المحادثة الدقيقة، ومتغير التفكير لسلاسل الاستدلال المتقدمة. على سبيل المثال، يتفوق Qwen3-Next-80B-A3B-Thinking في حل المشكلات المعقدة، متفوقًا على نماذج مثل Gemini-2.5-Flash-Thinking في المعايير. بالإضافة إلى ذلك، يتعامل مع 119 لغة، مما يتيح عمليات نشر متعددة اللغات دون إعادة التدريب.
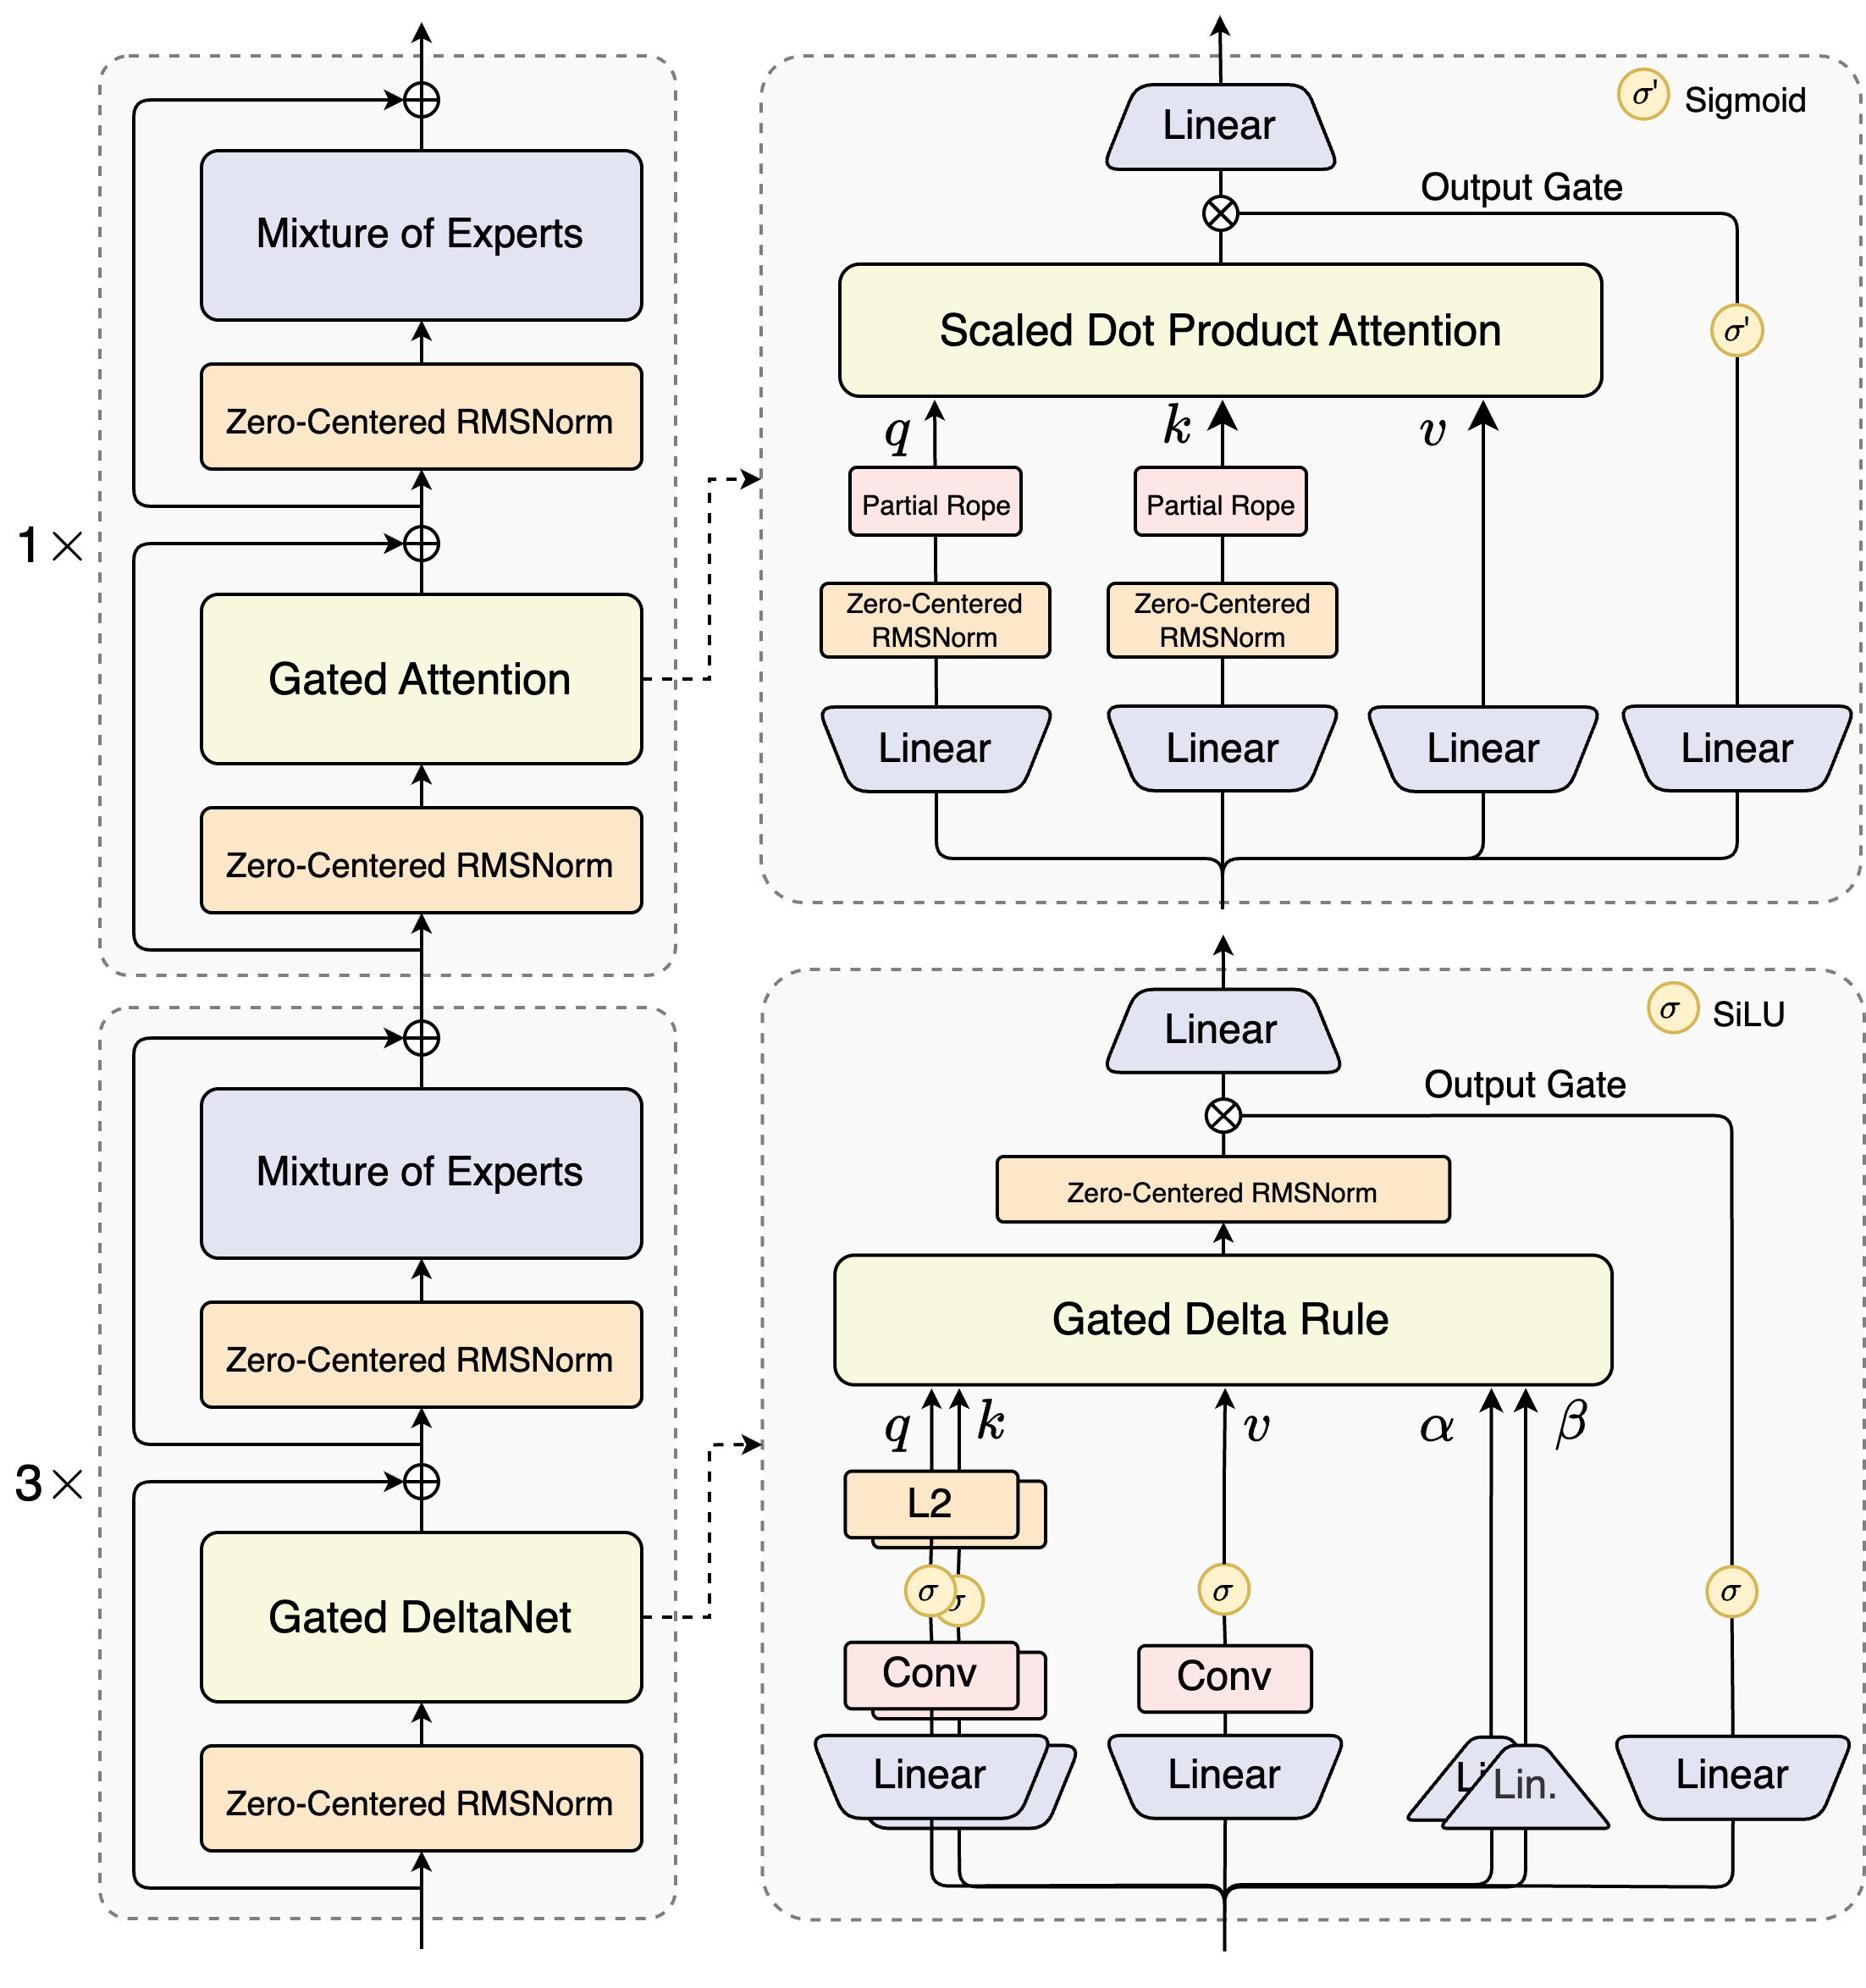
تكشف تفاصيل التدريب عن المزيد من الكفاءات. يقوم مهندسو Alibaba بالتدريب المسبق لهذا النموذج باستخدام طرق فعالة من حيث التوسع، مما يكلف 10% فقط من التكلفة مقارنة بـ Qwen3-32B. إنهم يستفيدون من تصميم هجين عبر 48 طبقة مع بُعد مخفي يبلغ 2048، مما يضمن توزيعًا متوازنًا للحساب. وبالتالي، يظهر النموذج فهمًا فائقًا للسياق الطويل، ويحافظ على الدقة بعد 32 ألف رمز حيث تتعثر النماذج الأخرى.
عمليًا، تمكّن هذه الميزات المطورين من توسيع نطاق حلول الذكاء الاصطناعي بتكلفة فعالة. سواء كنت تبني محركات بحث للمؤسسات أو مولدات محتوى آلية، يوفر Qwen3-Next-80B-A3B العمود الفقري للتطبيقات المبتكرة. بناءً على هذا الأساس، يتناول القسم التالي العناصر المعمارية التي تجعل هذه الكفاءات ممكنة.
تشريح بنية Qwen3-Next-80B-A3B: مخطط تقني
يقدم مهندسو Qwen3-Next-80B-A3B تصميمًا هجينًا يجمع بين آليات البوابات وتقنيات التطبيع المتقدمة. في جوهره تكمن طبقة Mixture of Experts (MoE)، حيث يتخصص الخبراء في مسارات حسابية مميزة. يوجه النموذج المدخلات ديناميكيًا، وينشط مجموعة فرعية لتقليل الحمل الزائد. على سبيل المثال، تعالج كتلة الانتباه ذات البوابة الاستعلامات والمفاتيح والقيم من خلال تضمينات RoPE الجزئية وطبقات RMSNorm المتمركزة حول الصفر، مما يعزز الاستقرار في التسلسلات الطويلة.
لننظر إلى وحدة الانتباه ذات المنتج النقطي المتدرج. إنها تدمج إسقاطات خطية تليها بوابات إخراج معدلة بتنشيطات سيجمويد. يتيح هذا الإعداد تحكمًا دقيقًا في تدفق المعلومات، مما يمنع التخفيف في المساحات عالية الأبعاد. علاوة على ذلك، يسبق RMSNorm المتمركز حول الصفر هذه العمليات ويتبعها، مما يركز التنشيطات حول الصفر للتخفيف من مشكلات التدرج أثناء التدريب.
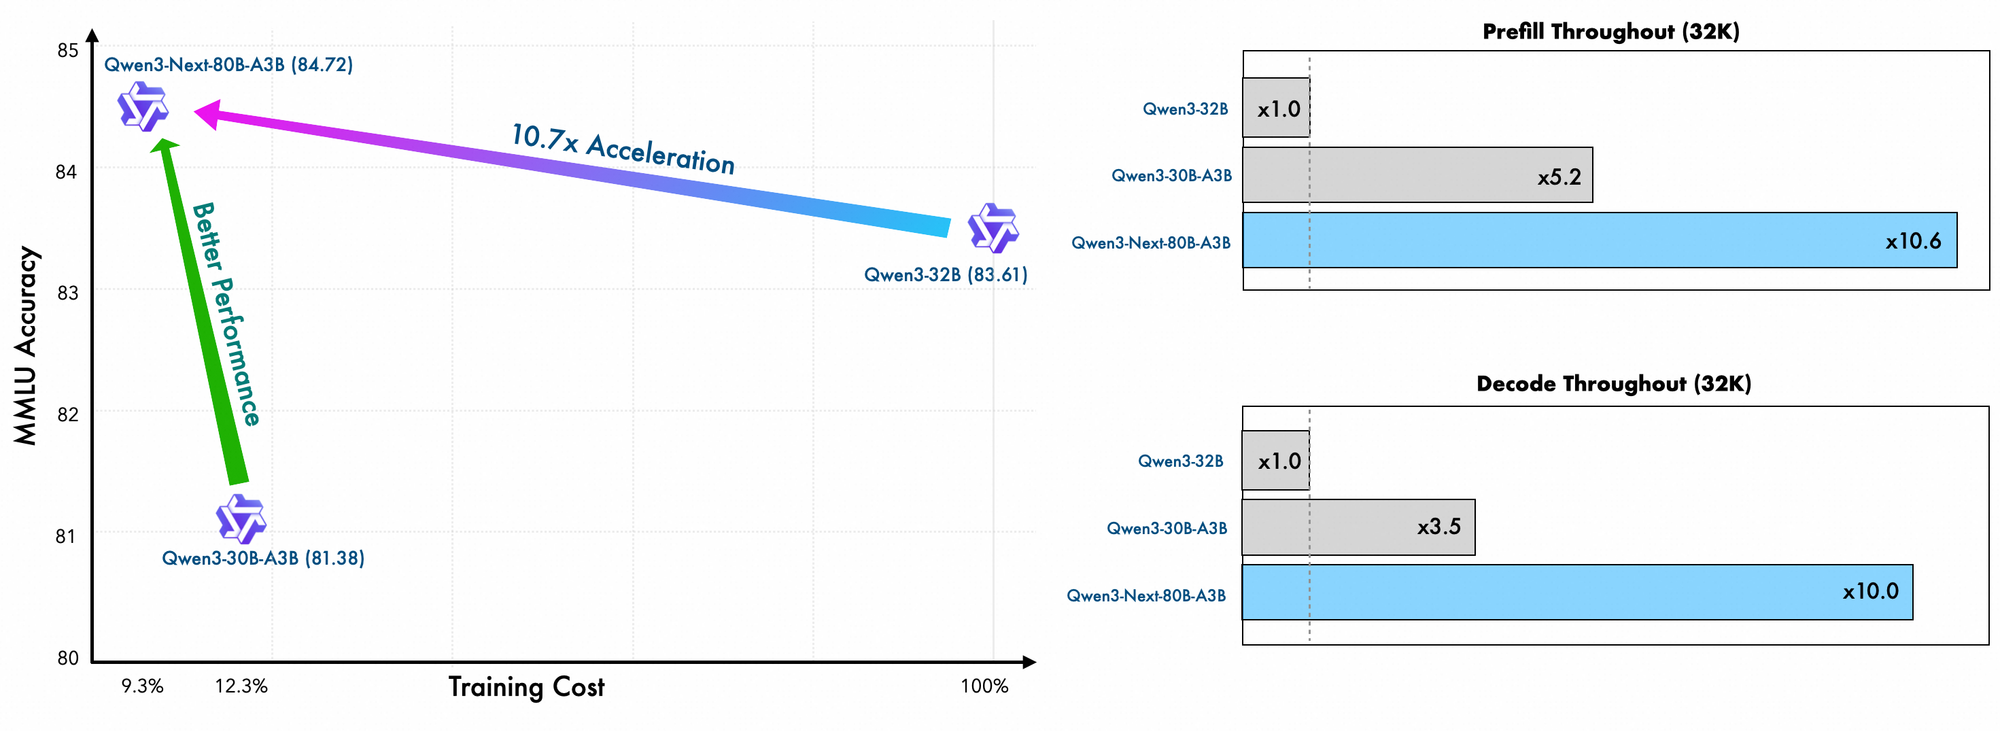
يوضح الرسم البياني كتلتين أساسيتين: تركز العلوية على الانتباه المبوب مع انتباه المنتج النقطي المتدرج، بينما تركز السفلية على DeltaNet المبوب. في مسار الانتباه (توسع 1x)، تتدفق المدخلات عبر RMSNorm المتمركز حول الصفر، ثم إلى نواة الانتباه المبوب. هنا، تستخدم إسقاطات الاستعلام (q) والمفتاح (k) والقيمة (v) RoPE الجزئي للترميز الموضعي. بعد الانتباه، تتغذى طبقة RMSNorm أخرى وطبقات خطية في MoE، التي تستخدم إخراجًا مبوبًا بسيجمويد.
بالانتقال إلى مسار DeltaNet (توسع 3x)، تستخدم البنية قاعدة دلتا مبوبة للتنبؤات الدقيقة. تتميز بتطبيع L2 على q و k، وطبقات تلافيفية لاستخراج الميزات المحلية، وتنشيطات SiLU لعدم الخطية. تضمن بوابة الإخراج، جنبًا إلى جنب مع إسقاط خطي، مخرجات متعددة الرموز متماسكة. يدعم تصميم هذه الكتلة فك التشفير التخميني للنموذج، حيث يتنبأ بالعديد من الرموز مسبقًا، ويتم التحقق منها في التمريرات اللاحقة.
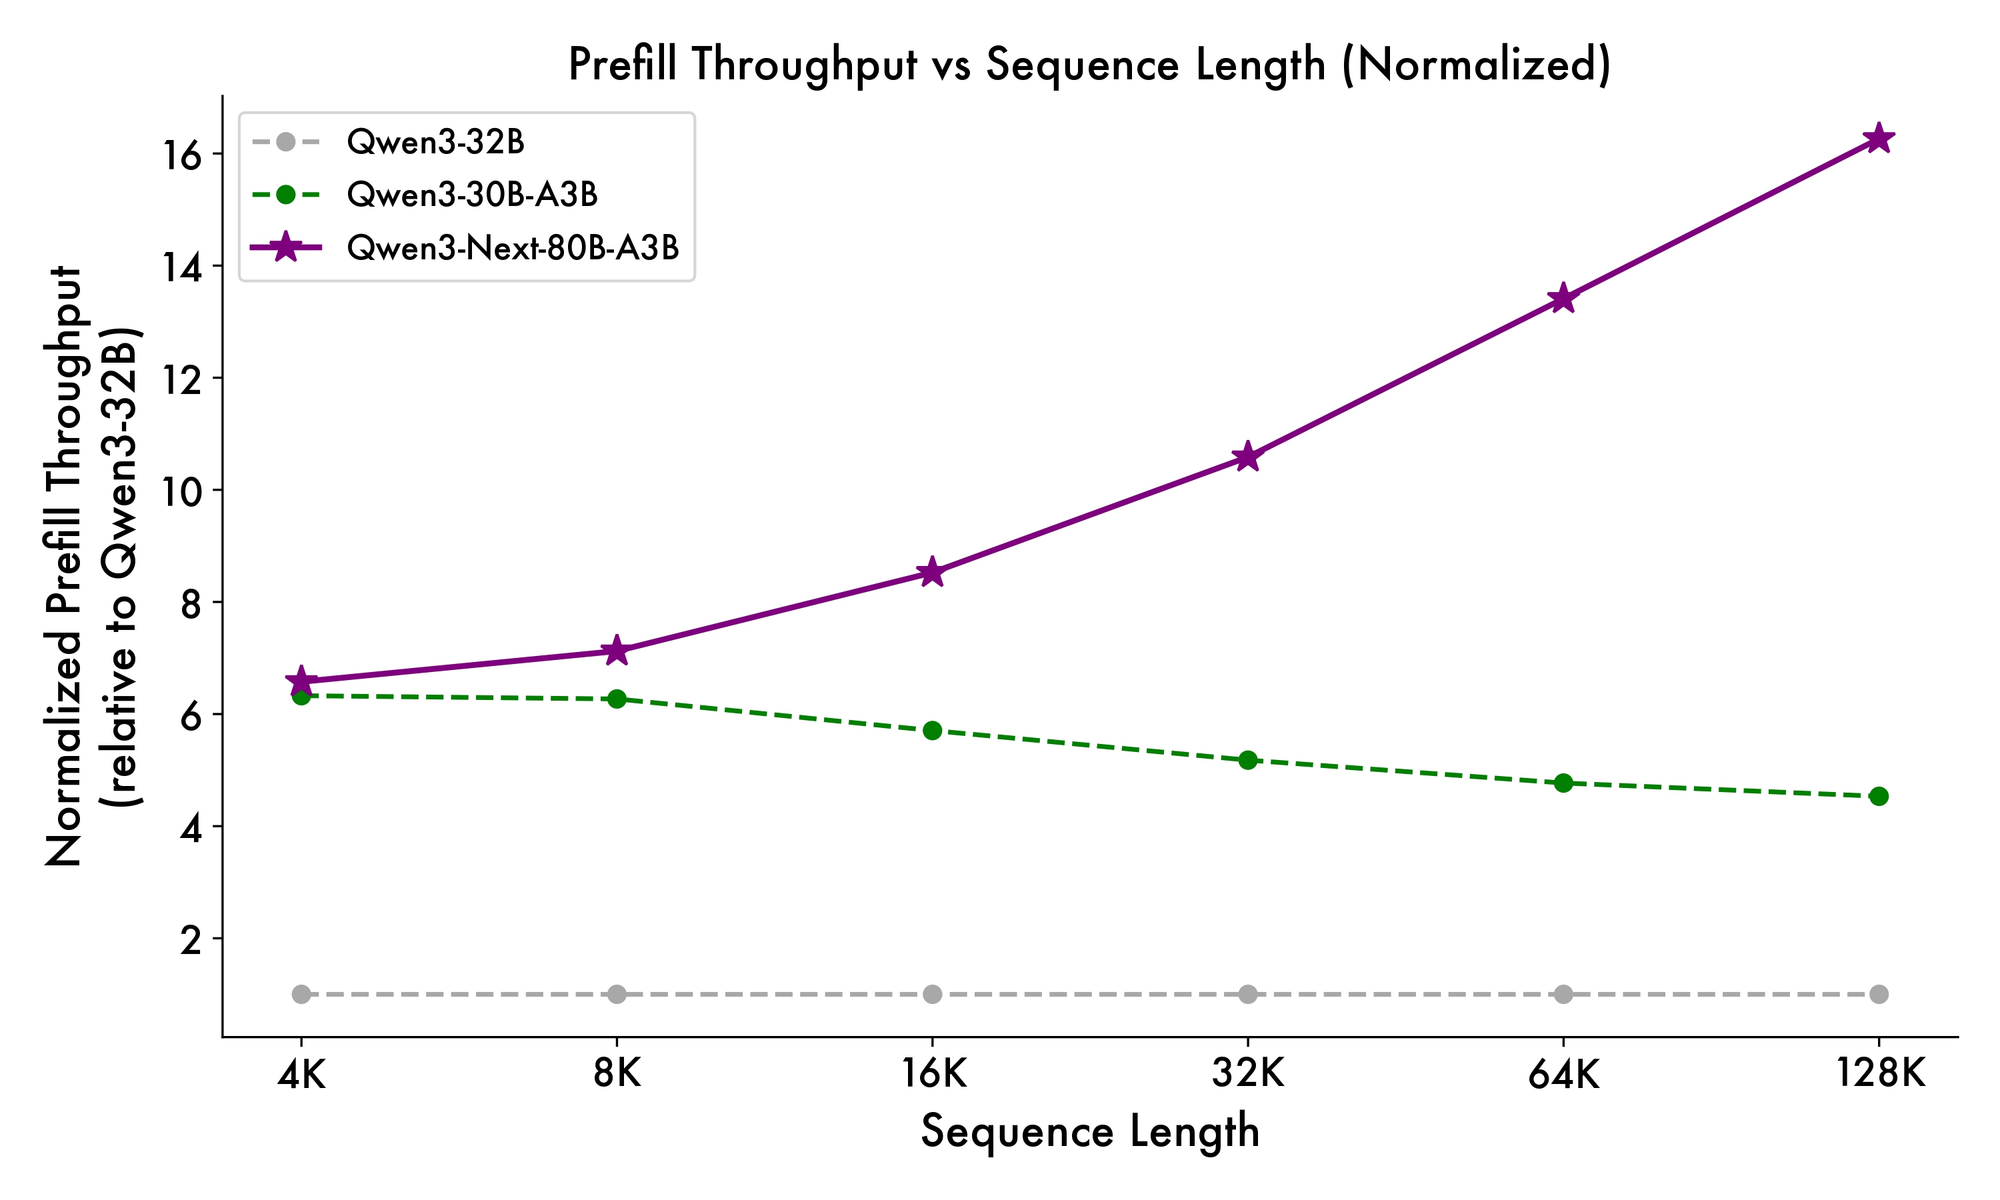
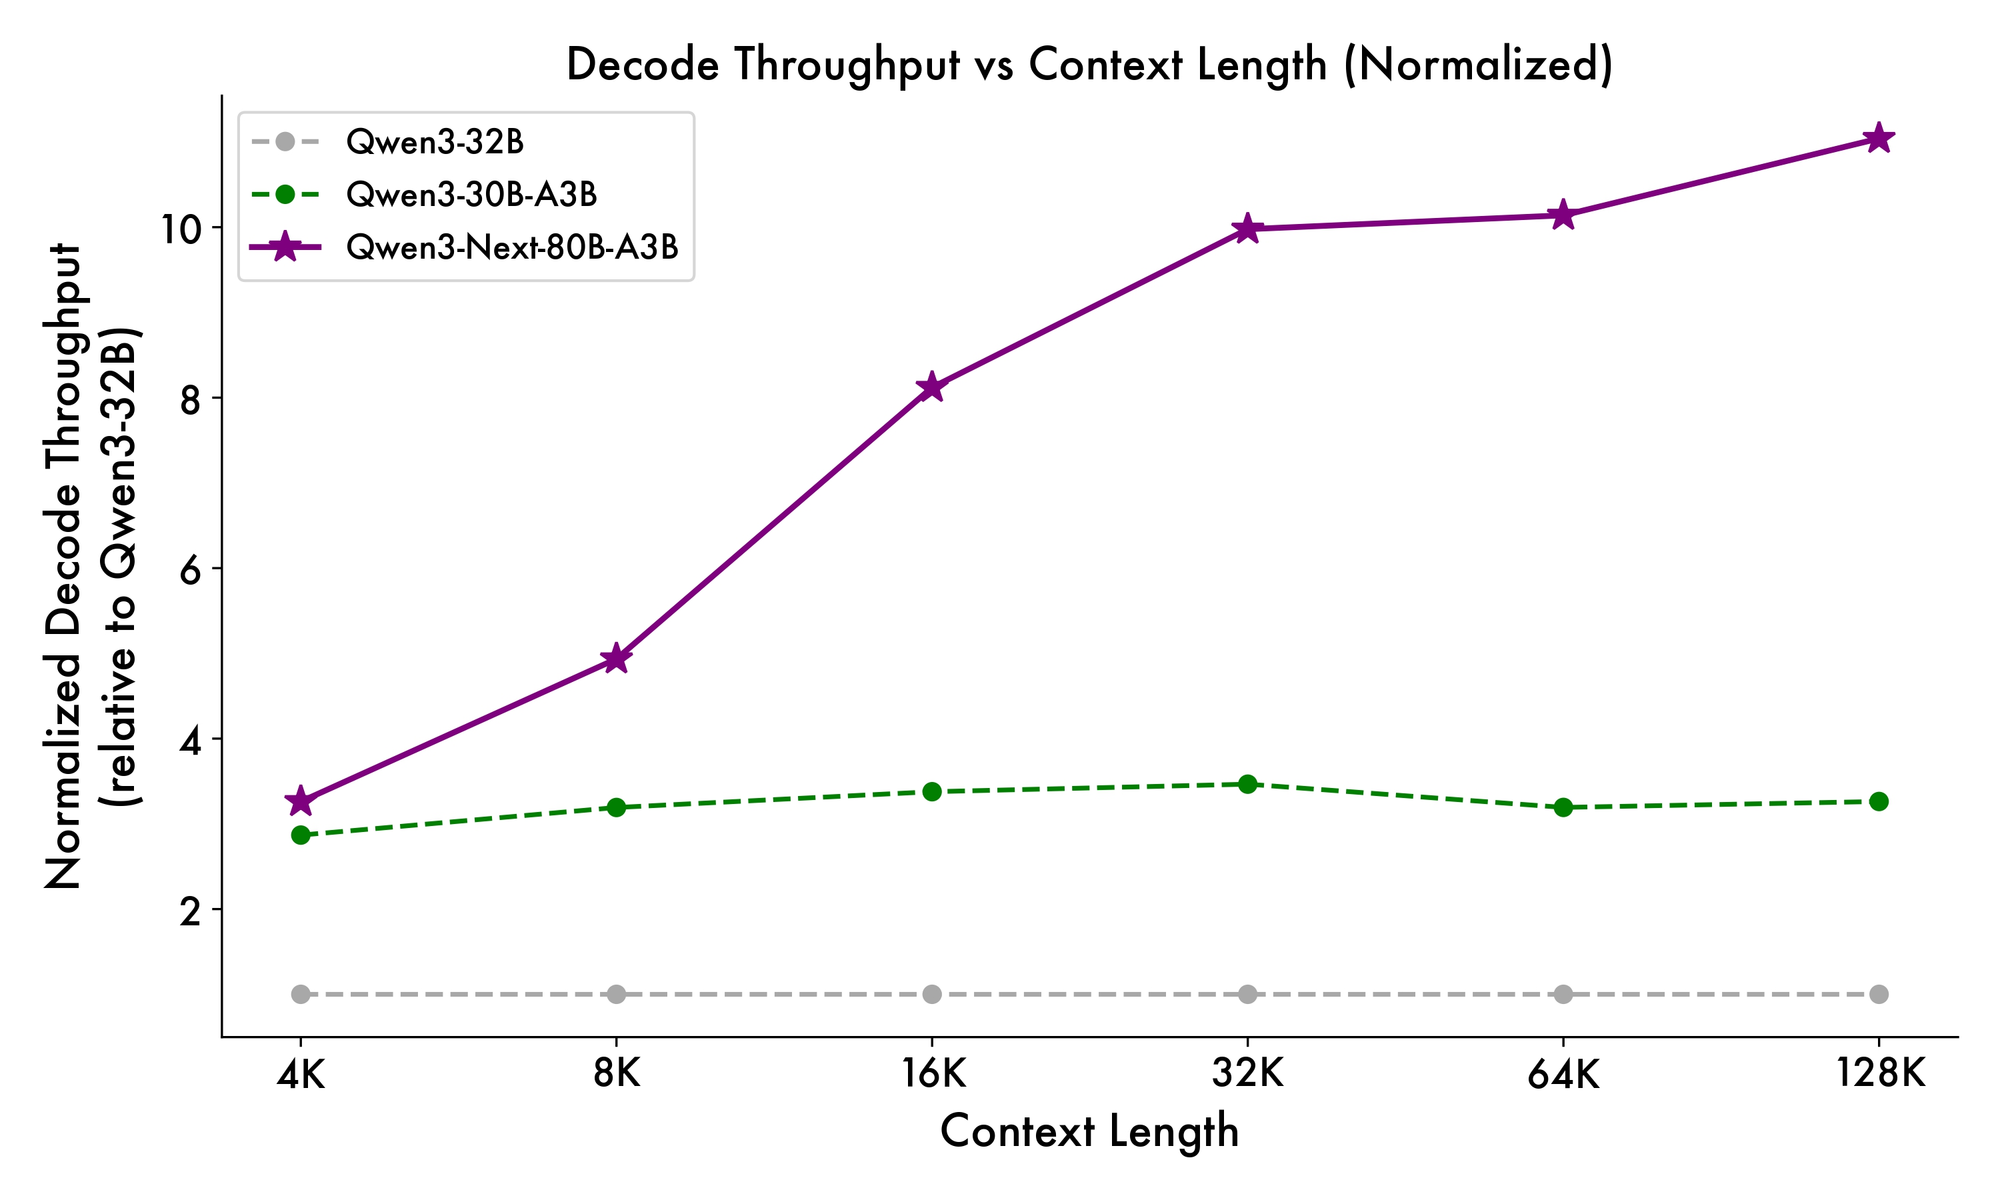
علاوة على ذلك، يشتمل الهيكل العام على خبير مشترك في MoE للتعامل مع الأنماط الشائعة عبر الرموز، مما يقلل من التكرار. تحافظ تضمينات الحبل الجزئية في الإسقاطات على الثبات الدوراني للسياقات الممتدة. كما يتضح في المعايير، ينتج هذا التكوين إنتاجية أعلى بما يقرب من 7 أضعاف عند أطوال سياق 4K مقارنة بـ Qwen3-32B. بعد 32 ألف رمز، تتجاوز السرعات 10 أضعاف، مما يجعلها مناسبة لمهام تحليل المستندات أو توليد التعليمات البرمجية.
يستفيد المطورون من هذه الوحداتية عند الضبط الدقيق. يمكنك تبديل الخبراء أو تعديل عتبات التوجيه لتخصيص النموذج لمجالات مثل التمويل أو الرعاية الصحية. في جوهرها، لا تعمل البنية على تحسين الحساب فحسب، بل تعزز أيضًا القدرة على التكيف. مع هذه الرؤى، ننتقل الآن إلى كيفية ترجمة هذه العناصر إلى مكاسب أداء قابلة للقياس.
تقييم Qwen3-Next-80B-A3B: مقاييس الأداء المهمة
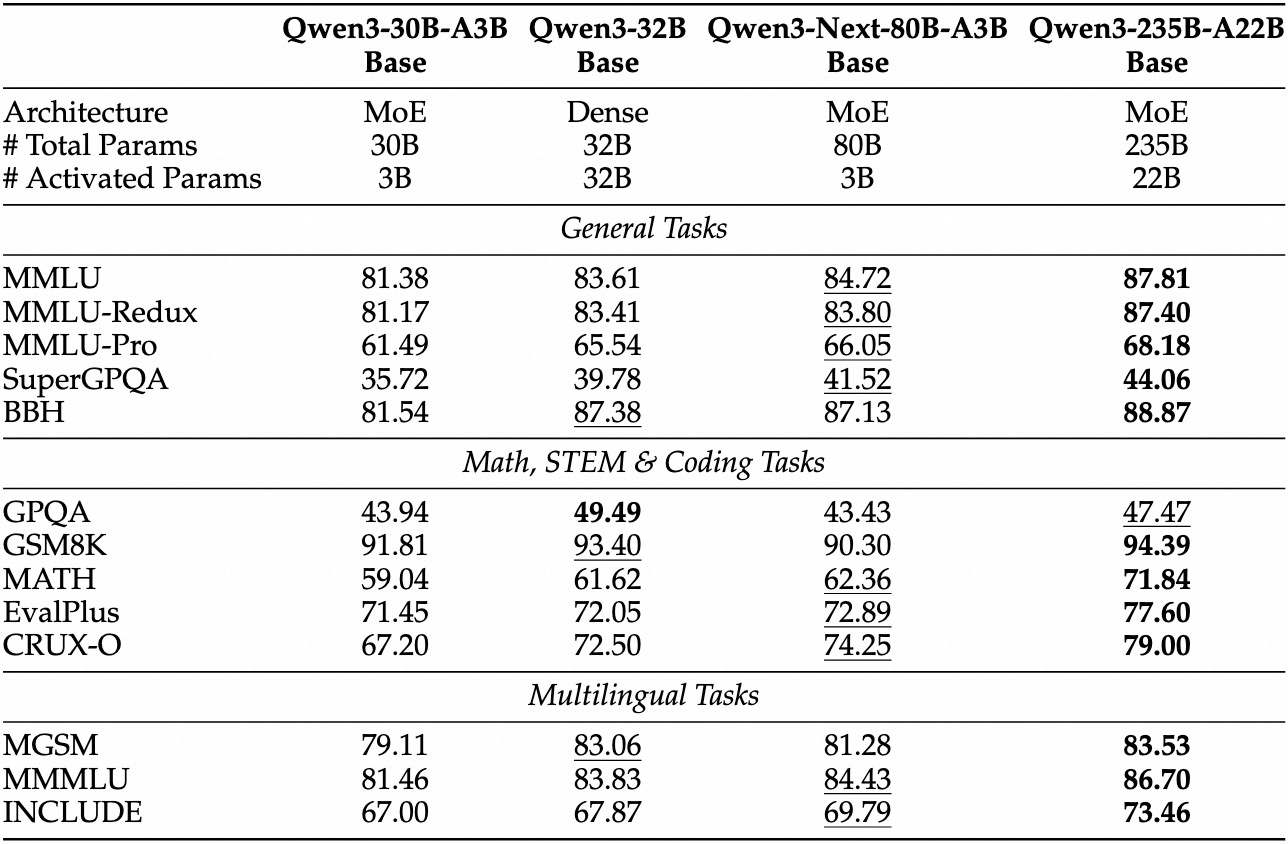
تضع التقييمات التجريبية Qwen3-Next-80B-A3B في صدارة الذكاء الاصطناعي المدفوع بالكفاءة. في المعايير القياسية مثل MMLU و HumanEval، يتفوق النموذج الأساسي على Qwen3-32B على الرغم من استخدامه عُشر المعلمات النشطة. على وجه التحديد، يحقق 78.5% في MMLU للمعرفة العامة، متفوقًا على المنافسين بنقطتين إلى ثلاث نقاط في المجموعات الفرعية للاستدلال.
بالنسبة لمتغير التعليمات، تكشف مهام المحادثة عن نقاط قوة في اتباع التعليمات. يسجل 85% على MT-Bench، مما يدل على حوارات متماسكة متعددة الأدوار. وفي الوقت نفسه، يتألق نموذج التفكير في سيناريوهات سلسلة التفكير، محققًا 92% على GSM8K لمشكلات الرياضيات—متفوقًا على Qwen3-30B-A3B-Thinking بنسبة 4%.
تشكل سرعة الاستدلال حجر الزاوية في جاذبيته. عند سياق 4K، يصل معدل إنتاج فك التشفير إلى 4 أضعاف Qwen3-32B، ويتوسع إلى 10 أضعاف عند الأطوال الأطول. تُظهر مراحل التعبئة المسبقة، الحاسمة لمعالجة المطالبات، تحسينات بمقدار 7 أضعاف، بفضل MoE المتفرق. تنخفض استهلاك الطاقة وفقًا لذلك، مع تكاليف تدريب تبلغ 10% من النماذج الأكثر كثافة.
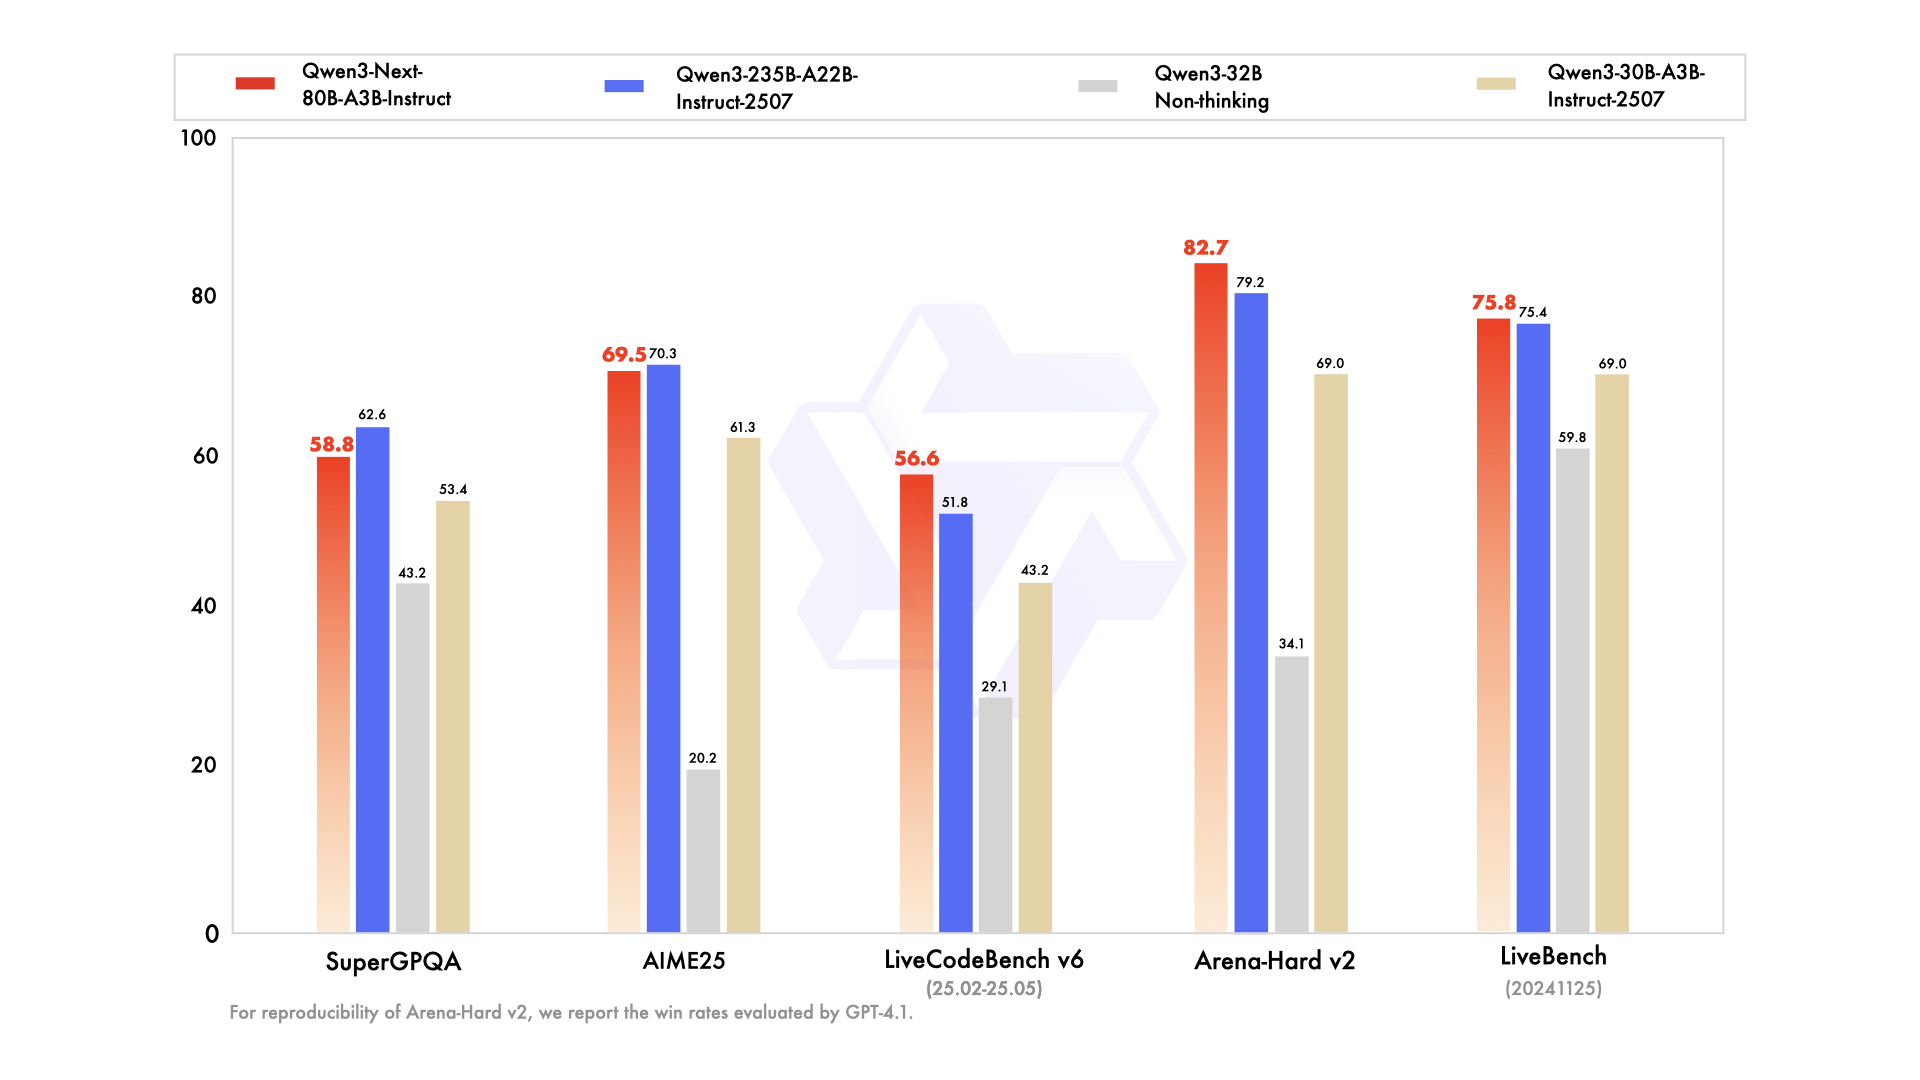
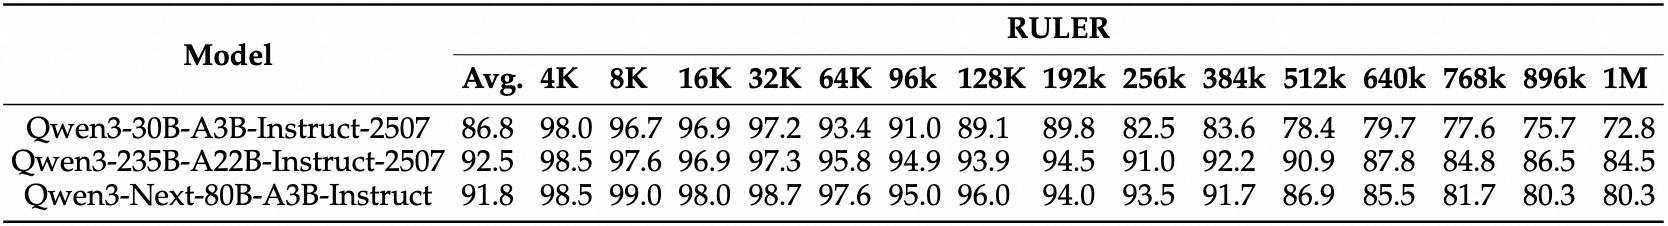
تُبرز المقارنات مع المنافسين تفوقه. مقابل Llama 3.1-70B، يتفوق Qwen3-Next-80B-A3B-Thinking في RULER (استدعاء السياق الطويل) بنسبة 15%، مسترجعًا التفاصيل من 128 ألف رمز بدقة. مقابل DeepSeek-V2، يوفر دعمًا أفضل للغات متعددة دون التضحية بالسرعة.
| المعيار | Qwen3-Next-80B-A3B-Base | Qwen3-32B-Base | Llama 3.1-70B |
|---|---|---|---|
| MMLU | 78.5% | 76.2% | 77.8% |
| HumanEval | 82.1% | 79.5% | 81.2% |
| GSM8K | 91.2% | 88.7% | 90.1% |
| MT-Bench | 84.3% (Instruct) | 81.9% | 83.5% |
يؤكد هذا الجدول على الأداء المتفوق باستمرار. ونتيجة لذلك، تتبناه المنظمات للإنتاج، موازنة بين الجودة والتكلفة. بالانتقال من النظرية إلى الممارسة، أنت الآن تزود نفسك بأدوات الوصول إلى واجهة برمجة التطبيقات.
إعداد الوصول إلى واجهة برمجة تطبيقات Qwen3-Next-80B-A3B: المتطلبات الأساسية والمصادقة
توفر Alibaba واجهة برمجة تطبيقات Qwen من خلال DashScope، منصتها السحابية، مما يضمن التكامل السلس. أولاً، أنشئ حساب Alibaba Cloud وانتقل إلى لوحة تحكم Model Studio. حدد Qwen3-Next-80B-A3B من قائمة النماذج—المتاحة في أوضاع القاعدة والتعليمات والتفكير.
احصل على مفتاح واجهة برمجة التطبيقات (API) الخاص بك من لوحة التحكم ضمن "API Keys". يقوم هذا المفتاح بمصادقة الطلبات، مع حدود معدل تستند إلى مستواك (يقدم المستوى المجاني مليون رمز/شهر). للمكالمات المتوافقة مع OpenAI، قم بتعيين عنوان URL الأساسي إلى https://dashscope.aliyuncs.com/compatible-mode/v1. تستخدم نقاط نهاية DashScope الأصلية https://dashscope.aliyuncs.com/api/v1/services/aigc/text-generation/generation.
قم بتثبيت حزمة تطوير البرامج (SDK) الخاصة بـ Python عبر pip: pip install dashscope. تتعامل هذه المكتبة مع التسلسل وإعادة المحاولة وتحليل الأخطاء. بدلاً من ذلك، استخدم عملاء HTTP مثل requests للتطبيقات المخصصة.
تفرض أفضل ممارسات الأمان تخزين المفاتيح في متغيرات البيئة: export DASHSCOPE_API_KEY='your_key_here'. وبالتالي، يظل الكود الخاص بك قابلًا للنقل عبر البيئات. بعد اكتمال الإعداد، يمكنك المتابعة إلى صياغة أول استدعاء لواجهة برمجة التطبيقات.
دليل عملي: استخدام واجهة برمجة تطبيقات Qwen3-Next-80B-A3B مع Python و DashScope
يبسط DashScope التفاعلات مع Qwen3-Next-80B-A3B. ابدأ بطلب إنشاء أساسي باستخدام متغير التعليمات للاستجابات الشبيهة بالدردشة.
إليك نص برمجي للمبتدئين:
import os
from dashscope import Generation

os.environ['DASHSCOPE_API_KEY'] = 'your_api_key'

response = Generation.call(
    model='qwen3-next-80b-a3b-instruct',
    prompt='Explain the benefits of MoE architectures in LLMs.',
    max_tokens=200,
    temperature=0.7
)

if response.status_code == 200:
    print(response.output['text'])
else:
    print(f"Error: {response.message}")
يرسل هذا الكود مطالبة ويسترجع ما يصل إلى 200 رمز. يستجيب النموذج بشرح موجز، مسلطًا الضوء على مكاسب الكفاءة. لوضع التفكير، قم بالتبديل إلى 'qwen3-next-80b-a3b-thinking' وأضف تعليمات الاستدلال: "فكر خطوة بخطوة قبل الإجابة."
تعزز المعلمات المتقدمة التحكم. قم بتعيين top_p=0.9 لأخذ عينات النواة، أو repetition_penalty=1.1 لتجنب الحلقات. للسياقات الطويلة، حدد max_context_length=131072 للاستفادة من قدرة النموذج البالغة 128 ألفًا.
تعامل مع التدفق للتطبيقات في الوقت الفعلي:
from dashscope import Streaming

for response in Streaming.call(
    model='qwen3-next-80b-a3b-instruct',
    prompt='Generate a Python function for sentiment analysis.',
    max_tokens=500,
    incremental_output=True
):
    if response.status_code == 200:
        print(response.output['text_delta'], end='', flush=True)
    else:
        print(f"Error: {response.message}")
        break
ينتج عن هذا إخراج رمزًا برمز، وهو مثالي لتكاملات واجهة المستخدم. يتضمن معالجة الأخطاء التحقق من response.code لمشكلات الحصة (على سبيل المثال، 10402 للرصيد غير الكافي).
علاوة على ذلك، يوسع استدعاء الوظائف من الفائدة. حدد الأدوات في مخطط JSON:
tools = [{
    "type": "function",
    "function": {
        "name": "get_weather",
        "description": "Get current weather",
        "parameters": {
            "type": "object",
            "properties": {"city": {"type": "string"}}
        }
    }
}]

response = Generation.call(
    model='qwen3-next-80b-a3b-instruct',
    prompt='What\'s the weather in Beijing?',
    tools=tools,
    tool_choice='auto'
)
يقوم النموذج بتحليل النية ويعيد استدعاء أداة، تقوم بتنفيذها خارجيًا. يدعم هذا النمط سير العمل القائم على الوكلاء. باستخدام هذه الأمثلة، يمكنك بناء خطوط أنابيب قوية. بعد ذلك، قم بدمج Apidog لاختبار وتحسين هذه الاستدعاءات دون الحاجة إلى كتابة الكود في كل مرة.
تحسين سير عملك: دمج Apidog لاختبار واجهة برمجة تطبيقات Qwen3-Next-80B-A3B
يحول Apidog تطوير واجهة برمجة التطبيقات إلى عملية مبسطة، خاصة لنقاط نهاية الذكاء الاصطناعي مثل Qwen3-Next-80B-A3B. تجمع هذه المنصة بين التصميم، والمحاكاة، والاختبار، والتوثيق في واجهة واحدة، مدعومة بالذكاء الاصطناعي للأتمتة الذكية.
ابدأ باستيراد مخطط DashScope إلى Apidog. أنشئ مشروعًا جديدًا، وأضف نقطة النهاية POST https://dashscope.aliyuncs.com/api/v1/services/aigc/text-generation/generation، والصق مفتاح واجهة برمجة التطبيقات (API) الخاص بك كرأس: X-DashScope-API-Key: your_key.
صمم الطلبات بصريًا: قم بتعيين معلمة النموذج إلى 'qwen3-next-80b-a3b-instruct'، أدخل مطالبة في النص كـ JSON {"input": {"messages": [{"role": "user", "content": "Your prompt here"}]}}. يقترح ذكاء Apidog حالات اختبار، وينشئ اختلافات مثل المطالبات الحافة أو عينات ذات درجة حرارة عالية.
قم بتشغيل مجموعات الاختبارات بالتسلسل. على سبيل المثال، قم بقياس زمن الاستجابة عبر درجات الحرارة:
- الاختبار 1: درجة حرارة 0.1، طول المطالبة 100 رمز.
- الاختبار 2: درجة حرارة 1.0، سياق 10 آلاف رمز.
تتتبع الأداة المقاييس—وقت الاستجابة، استخدام الرمز، معدلات الخطأ—وتصور الاتجاهات في لوحات المعلومات. استجابات وهمية للتطوير دون اتصال: يحاكي Apidog مخرجات Qwen بناءً على البيانات التاريخية، مما يسرع عمليات بناء الواجهة الأمامية.
يتم إنشاء التوثيق تلقائيًا من مجموعاتك. قم بتصدير مواصفات OpenAPI مع الأمثلة، بما في ذلك تفاصيل Qwen3-Next-80B-A3B مثل ملاحظات توجيه MoE. تتيح ميزات التعاون للفرق مشاركة البيئات، مما يضمن اختبارًا متسقًا.
في أحد السيناريوهات، يقوم مطور باختبار مطالبات متعددة اللغات. يكتشف ذكاء Apidog التناقضات، ويقترح إصلاحات مثل إضافة تلميحات لغوية. ونتيجة لذلك، ينخفض وقت التكامل بنسبة 40%، وفقًا لتقارير المستخدمين. للاختبارات الخاصة بالذكاء الاصطناعي، استفد من توليد البيانات الذكي الخاص به: أدخل مخططًا، وسيقوم بصياغة مطالبات واقعية تحاكي حركة مرور الإنتاج.
علاوة على ذلك، يدعم Apidog خطافات CI/CD، حيث يقوم بتشغيل اختبارات واجهة برمجة التطبيقات في خطوط الأنابيب. اتصل بـ GitHub Actions للتحقق التلقائي بعد النشر. يقلل هذا النهج ذو الحلقة المغلقة من الأخطاء في التطبيقات المدعومة بـ Qwen.
استراتيجيات متقدمة: تحسين استدعاءات واجهة برمجة تطبيقات Qwen3-Next-80B-A3B للإنتاج
يرفع التحسين الاستخدام الأساسي إلى مستوى موثوقية على مستوى المؤسسة. أولاً، قم بتجميع الطلبات حيثما أمكن—يدعم DashScope ما يصل إلى 10 مطالبات لكل استدعاء، مما يقلل من الحمل الزائد للمهام المتوازية مثل مزارع التلخيص.
راقب اقتصاديات الرمز: يفرض النموذج رسومًا لكل معلمة نشطة، لذا فإن المطالبات الموجزة تحقق وفورات. استخدم result_format='message' لواجهة برمجة التطبيقات للحصول على مخرجات منظمة، وتحليل JSON مباشرة لتجنب المعالجة اللاحقة.
للتوافر العالي، نفذ عمليات إعادة المحاولة مع التراجع الأسي:
import time
from dashscope import Generation

def call_with_retry(prompt, max_retries=3):
    for attempt in range(max_retries):
        response = Generation.call(model='qwen3-next-80b-a3b-instruct', prompt=prompt)
        if response.status_code == 200:
            return response
        time.sleep(2 ** attempt)
    raise Exception("Max retries exceeded")
يتعامل هذا مع الأخطاء العابرة مثل حدود معدل 429. قم بالتوسع أفقيًا عن طريق توزيع المكالمات عبر المناطق—يوفر DashScope نقاط نهاية في سنغافورة والولايات المتحدة.
تشمل اعتبارات الأمان تنظيف المدخلات لمنع حقن المطالبات. تحقق من مدخلات المستخدم مقابل القوائم البيضاء قبل إعادة توجيهها إلى واجهة برمجة التطبيقات. بالإضافة إلى ذلك، سجل الاستجابات مجهولة الهوية للتدقيق، امتثالًا للائحة العامة لحماية البيانات (GDPR).
في الحالات القصوى، مثل السياقات فائقة الطول، قم بتقسيم المدخلات وتوقعات السلسلة. يساعد متغير التفكير هنا: قم بالمطالبة بـ "الخطوة 1: تحليل القسم أ؛ الخطوة 2: التوليف مع ب." يحافظ هذا على الاتساق على مدى أكثر من 100 ألف رمز.
يستكشف المطورون أيضًا الضبط الدقيق عبر منصة Alibaba، على الرغم من أن مستخدمي واجهة برمجة التطبيقات يلتزمون بهندسة المطالبات. وبالتالي، تضمن هذه التكتيكات عمليات نشر قابلة للتطوير وآمنة.
خاتمة: لماذا يستحق Qwen3-Next-80B-A3B اهتمامك
يعيد Qwen3-Next-80B-A3B تعريف الذكاء الاصطناعي الفعال من خلال MoE المتفرق، والبوابات الهجينة، والمعايير المتفوقة. يستفيد المطورون من واجهة برمجة التطبيقات الخاصة به عبر DashScope للنماذج الأولية السريعة، المعززة بأدوات مثل Apidog لدقة الاختبار.
أنت الآن تمتلك المخطط: من الفروق المعمارية الدقيقة إلى تحسينات الإنتاج. طبق هذه الرؤى لبناء أنظمة أسرع وأكثر ذكاءً. جرب اليوم—مستقبل الذكاء القابل للتطوير ينتظرك.