
معايير Qwen4-Max في سطر واحد: تُظهر بطاقة علي بابا تفوق Qwen4-Max على Qwen3.8-Max في كل اختبار من الاختبارات الـ15 التي يظهر فيها النموذجان معًا، والمركز الأول إجمالًا في 4 من 16، لكن معظم هذه الأرقام مصدرها تشغيلات علي بابا نفسها. في Work360 سجّل 52.69 مقابل 47.74، وانخفض متوسط التكلفة لكل مهمة من 4.43 دولار إلى 1.67 دولار.
الاختبار المعياري لا يُقدَّر بشيء ما لم تُجب عن سؤال «من أجراه، وكيف؟». يغطّي هذا الدليل كل النتائج التي نشرتها علي بابا في 16 نوفمبر 2026، ويصنّفها إلى نتائج ذاتية التقرير ونتائج من أطراف ثالثة، ويختم بطريقة لإجراء اختبارك الخاص عبر واجهة برمجة تطبيقات Qwen4-Max. وللاساسيات، ابدأ بـما هو Qwen4-Max وكيفية الوصول إليه.
نتائج اختبارات Qwen4-Max في لمحة
قارن منشور الإطلاق من علي بابا بين Qwen4-Max وكل من Qwen3.8-Max-0902 وOpus 5.5 وGPT-6.1 Sol وGPT-6 Astra وKimi K3.1 على 16 اختبارًا معياريًا.
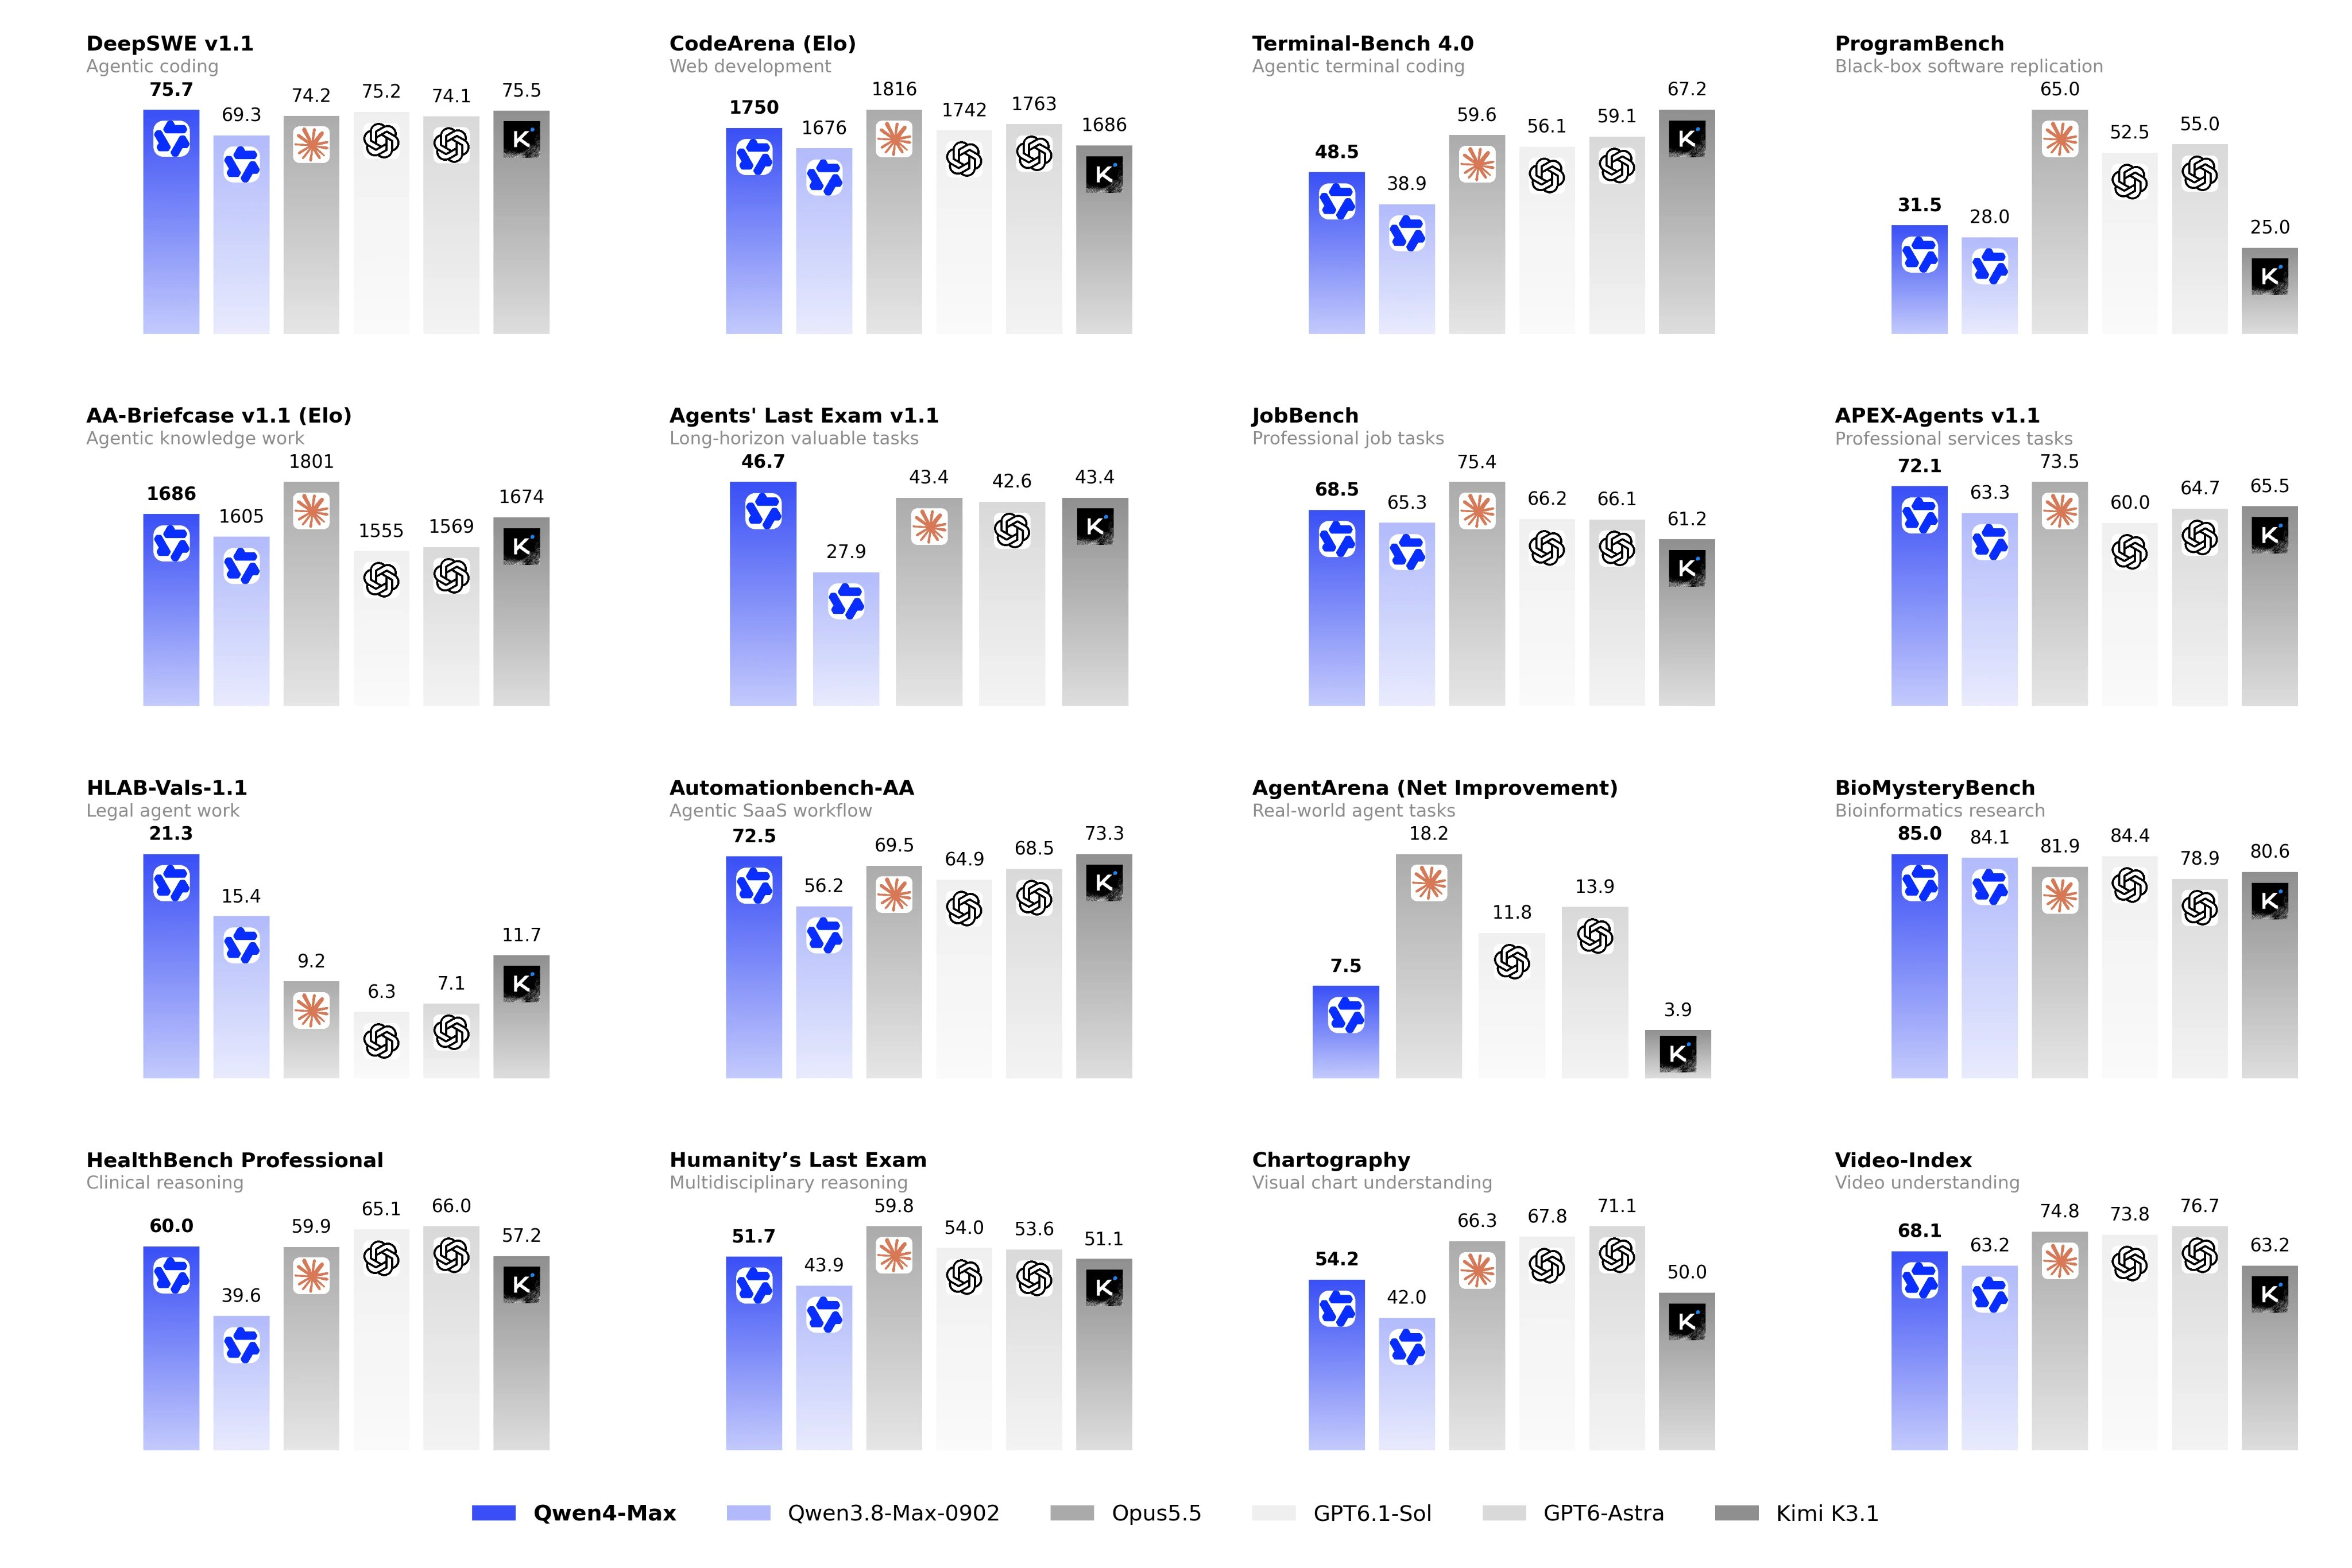
الخط الغامق يشير إلى أعلى نتيجة في الجدول. وكلمة «Alibaba» تعني أن الحواشي لا تستشهد بأي لوحة صدارة خارجية لذلك الاختبار، فاعتبره تشغيلًا من علي بابا نفسها (حواشي JobBench وChartography لا تصف سوى إعدادات علي بابا).
ذاتي التقرير أم من طرف ثالث: من أجرى كل اختبار
عشر من النتائج الـ16 ذاتية التقرير. وستّ أخرى مستشهد بها من لوحات صدارة عامة يديرها آخرون. هذا التفريق هو أنفع مرشّح يمكنك تطبيقه.
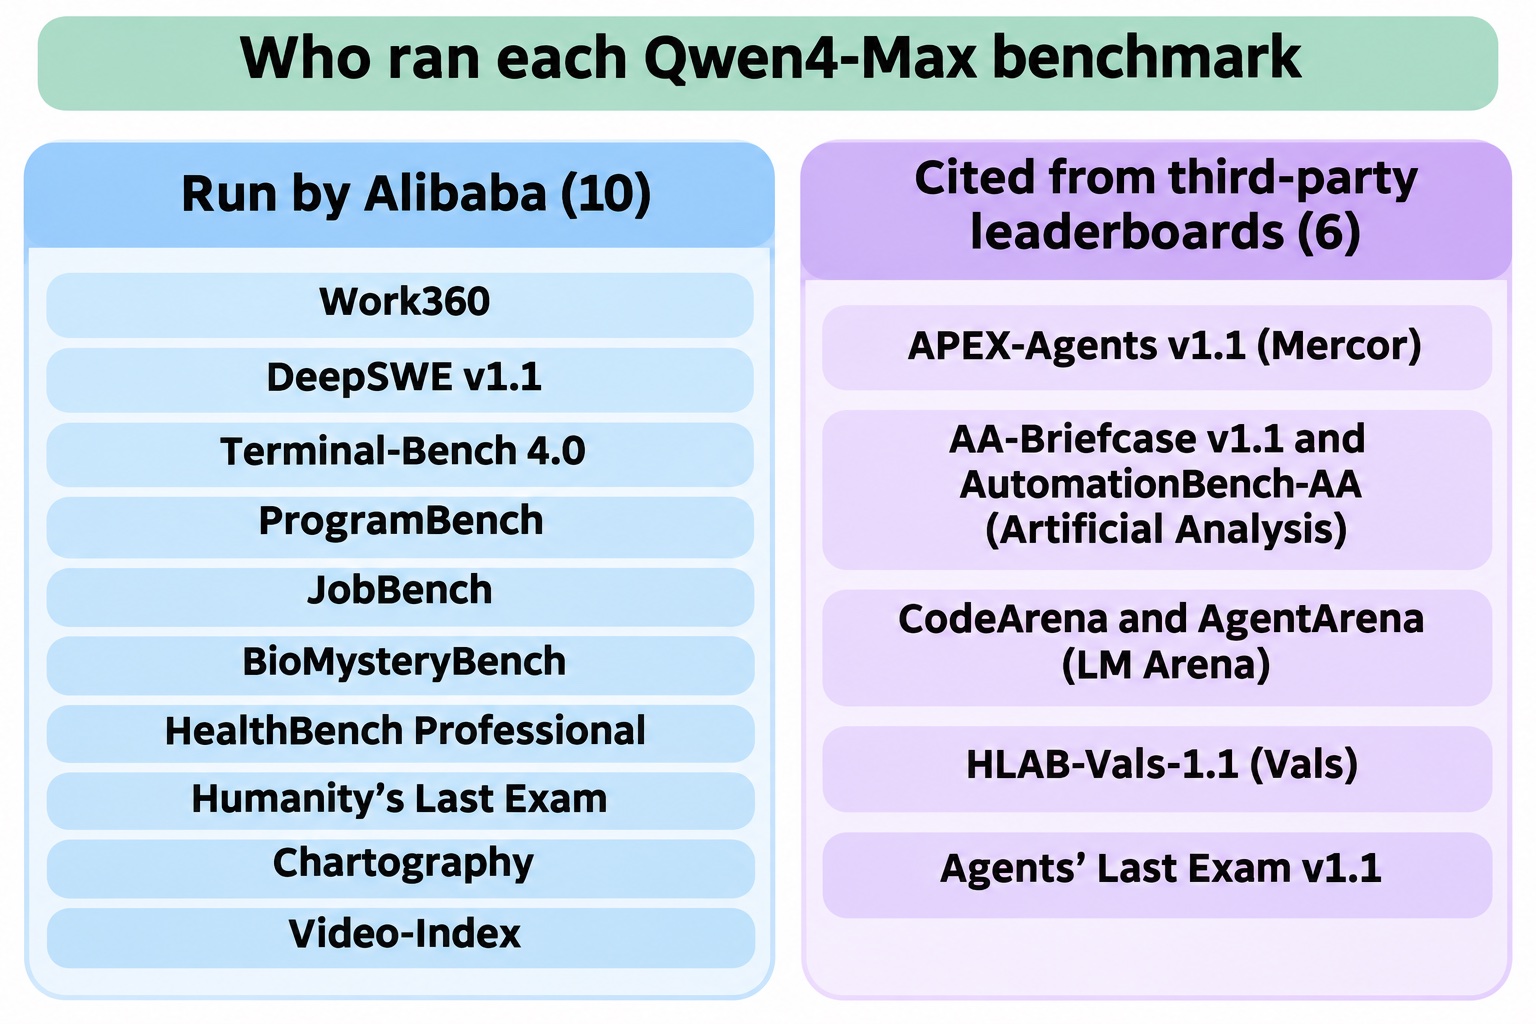
مجموعة الطرف الثالث، بحسب حواشي منشور الإطلاق:
- APEX-Agents v1.1: مستشهد بها من لوحة صدارة Mercor APEX-Agents
- AA-Briefcase v1.1 وAutomationBench-AA: مستشهد بها من Artificial Analysis
- CodeArena وAgentArena: مستشهد بها من LM Arena
- HLAB-Vals-1.1: مستشهد بها من فهرس Vals
- Agents’ Last Exam v1.1: مستشهد بها من لوحة الصدارة الخاصة بها
رقم مستقل يمكنك التحقق منه اليوم: يُدرج فهرس Vals (الإصدار 2.2، المحدَّث في 15 نوفمبر 2026) نموذج Qwen 4 Max بنسبة 63.20% إجمالًا، في المرتبة 11، بسعر 9.33 دولارات لكل اختبار. ما يجعله خلف عشرة نماذج تقودها Claude Fable 5.2 بنسبة 71.31%، وأمام Kimi K3.1 Pro مباشرةً (62.52%) وQwen 3.8 Max 0902 (59.05%). صورة أكثر تواضعًا من الجدول الرئيسي.
Work360: اختبار علي بابا الخاص بالعمل
Work360 هو اختبار علي بابا للمهام الصناعية المعقدة، ويغطي 26 مجالًا و182 نطاقًا فرعيًا و721 تخصصًا. سجّل Qwen4-Max نتيجة 52.69، بارتفاع عن 47.74 لـQwen3.8-Max.
اقرأ ذلك بحذر: علي بابا هي التي صمّمت الاختبار وشغّلت النماذج، والمقارنة المنشورة تغطي Qwen4-Max وQwen3.8-Max فقط، ولا توجد لوحة صدارة عامة له بعد. إنه رقم مقارنة بين جيلين متتاليين، لا ترتيب ضد مختبرات أخرى.
ما تمنحه إياك Work360 فعليًا هو رقم تكلفة: انخفض متوسط التكلفة لكل مهمة من 4.43 دولار إلى 1.67 دولار، أي تخفيض بنسبة 62%، نتيجةً لتقليل عدد الرموز لكل مهمة مع انخفاض الأسعار معًا. سعر Qwen4-Max المعلن هو 1.50 دولار لكل مليون رمز إدخال و4.50 دولار لكل مليون رمز إخراج وفق صفحة النموذج على QwenCloud. التفاصيل الكاملة في دليل أسعار Qwen4-Max.
Terminal-Bench 4.0 وكفاءة الرموز
يقيس Terminal-Bench قدرة الوكلاء على إنجاز مهام حقيقية في الطرفية (terminal). تُعلن علي بابا نتيجة 48.5 لـQwen4-Max على الإصدار 4.0، بارتفاع عن 38.9 لـQwen3.8-Max. وعلى بطاقة علي بابا نفسها، تقع النماذج الأربعة غير التابعة لـQwen بين 56.1 و67.2، وكلها أعلى من ذلك.
الادعاء الأكبر هو الكفاءة. تقول علي بابا إن استهلاك الرموز ينخفض بنحو 48% عند مستوى الجهد Xhigh وبنحو 49% عند مستوى High على Terminal-Bench 4.0، وبنحو 24% (Xhigh) و35% (High) على Work360. وتُظهر بطاقتها للنتائج مقابل الرموز شكل ذلك:
- على Work360، يتجاوز Qwen4-Max عند مستوى High بالفعل Qwen3.8-Max عند مستوى Xhigh، بنحو 96 ألف رمز لكل مهمة مقابل نحو 165 ألفًا (مقروء من الرسم البياني، لذا فهي تقريبية).
- على Terminal-Bench 4.0، يبلغ Qwen4-Max عند مستوى Xhigh نتيجة 48.5 بنحو 150 ألف رمز لكل مهمة، بينما يبلغ Qwen3.8-Max عند مستوى Xhigh نحو 38 بنحو 290 ألف رمز.
رموز أقل بنتيجة أفضل هو الاتجاه الصحيح إذا كنت تدفع لكل رمز. لكنه أيضًا ذاتي التقرير.
تحقق من المهم معرفته: لوحة صدارة Terminal-Bench العامة تعتمد الآن افتراضيًا الإصدار 4.1، وQwen4-Max غير مُدرج فيها حتى 16 نوفمبر. يُظهر Qwen3.8-Max-0902 نتيجة 27.0% على الإصدار 4.1 (بتشغيل Claude Code بأقصى جهد)، مقابل 38.9 على بطاقة علي بابا للإصدار 4.0. الإصدار وبيئة التشغيل مختلفان، فلا تطرح أحدهما من الآخر، لكن ذلك يُظهر مدى تغيّر النتيجة بتغيّر الإعداد.
أين يتفوق Qwen4-Max وأين يتأخر
مقارنةً بنماذج الحدود الأخرى في الجدول، الصورة مختلطة:
التفوق (4 من 16): DeepSWE v1.1 (75.7، بفارق 0.2 نقطة عن Kimi K3.1)، وAgents’ Last Exam v1.1 (46.7)، وHLAB-Vals-1.1 (21.3)، وBioMysteryBench (85.0، بفارق أقل من نقطة عن GPT-6.1 Sol).
مركز ثانٍ وثيق: APEX-Agents v1.1 (72.1 مقابل 73.5)، وAutomationBench-AA (72.5 مقابل 73.3)، وAA-Briefcase (1686 مقابل 1801 Elo).
تأخر واضح: ProgramBench (31.5 مقابل 65.0)، وTerminal-Bench 4.0 (48.5 مقابل 67.2)، وAgentArena (7.5 مقابل 18.2)، وChartography (54.2 مقابل 71.1)، وHumanity’s Last Exam (51.7 مقابل 59.8).
اثنان من التفوقات الأربعة، Agents’ Last Exam وHLAB-Vals، مصدرهما لوحات صدارة من أطراف ثالثة، ما يجعلهما أقوى الادعاءات في الجدول. أما البرمجة فمتباينة: تفوق ضيق في DeepSWE، وفجوات واسعة في ProgramBench وTerminal-Bench. إذا كنت تشغّل وكلاء طرفية طويلي الأمد، فاختبر قبل التبديل. ولمعرفة ما تغيّر منذ الجيل السابق، راجع Qwen4-Max مقابل Qwen 3.8.
أرقام البرمجة الآمنة والتدريب المسبق
البرمجة الآمنة. على Last Secure Code Bench، في وضع «إعادة بناء الشيفرة دون تلميح أمني» مع فحص الوظيفة والثغرات معًا، ارتفع معدل النجاح على مستوى الدوال من 22.0% لـQwen3.8-Max إلى 31.8%. كما ارتفعت نسبة الشيفرة الناجحة في المستويات الثلاثة جميعها (الدالة والملف والمستودع) من 8% إلى 14.7%. ما زال نحو ثلثي مخرجات مستوى الدوال تفشل في أحد الفحوص، فمراجعة الأمن تبقى مسؤوليتك.
التدريب المسبق. في التقييمات الداخلية عبر المعرفة والشيفرة والأسئلة والنمذجة الرياضية، يُظهر Qwen4-Max-Base بت لكل بايت أقل بنحو 5% إلى 13% من Qwen3.8-Max-Base مع تنشيط معاملات أقل بنسبة 25%. وتشير علي بابا إلى أن نقطتي فحص (checkpoint) في تلك المقارنة (GLM-5.3 وKimi-K3.1-Pro) خضعا لتدريب لاحق، ما قد يُنشّز انحرافًا فيها.
ما ما زال مفقودًا
- إعدادات التقييم لمعظم الاختبارات. منشور الإطلاق لا يذكر مستوى الجهد (High أو Xhigh) ولا بيئة الوكيل التي أنتجت كل قيمة.
- التباين. لا هوامش خطأ ولا عدد تشغيلات. لوحات الصدارة مثل Terminal-Bench تعلن هوامش بنحو 3 إلى 4 نقاط، أكبر من بعض الفجوات أعلاه.
- تشغيلات مستقلة لـTerminal-Bench وWork360. لا يوجد أي منهما على لوحة صدارة عامة بعد.
أجرِ اختبار Qwen4-Max الخاص بك عبر Apidog CLI
لا يوجد اختبار معياري عام يستخدم مطالباتك أو مخططاتك (schemas). أسرع فحص صادق هو مجموعة صغيرة من طلباتك الخاصة، تُشغَّل بالطريقة نفسها في كل مرة، مع تسجيل استهلاك الرموز لتتمكن من حساب تكلفة المهمة بنفسك.
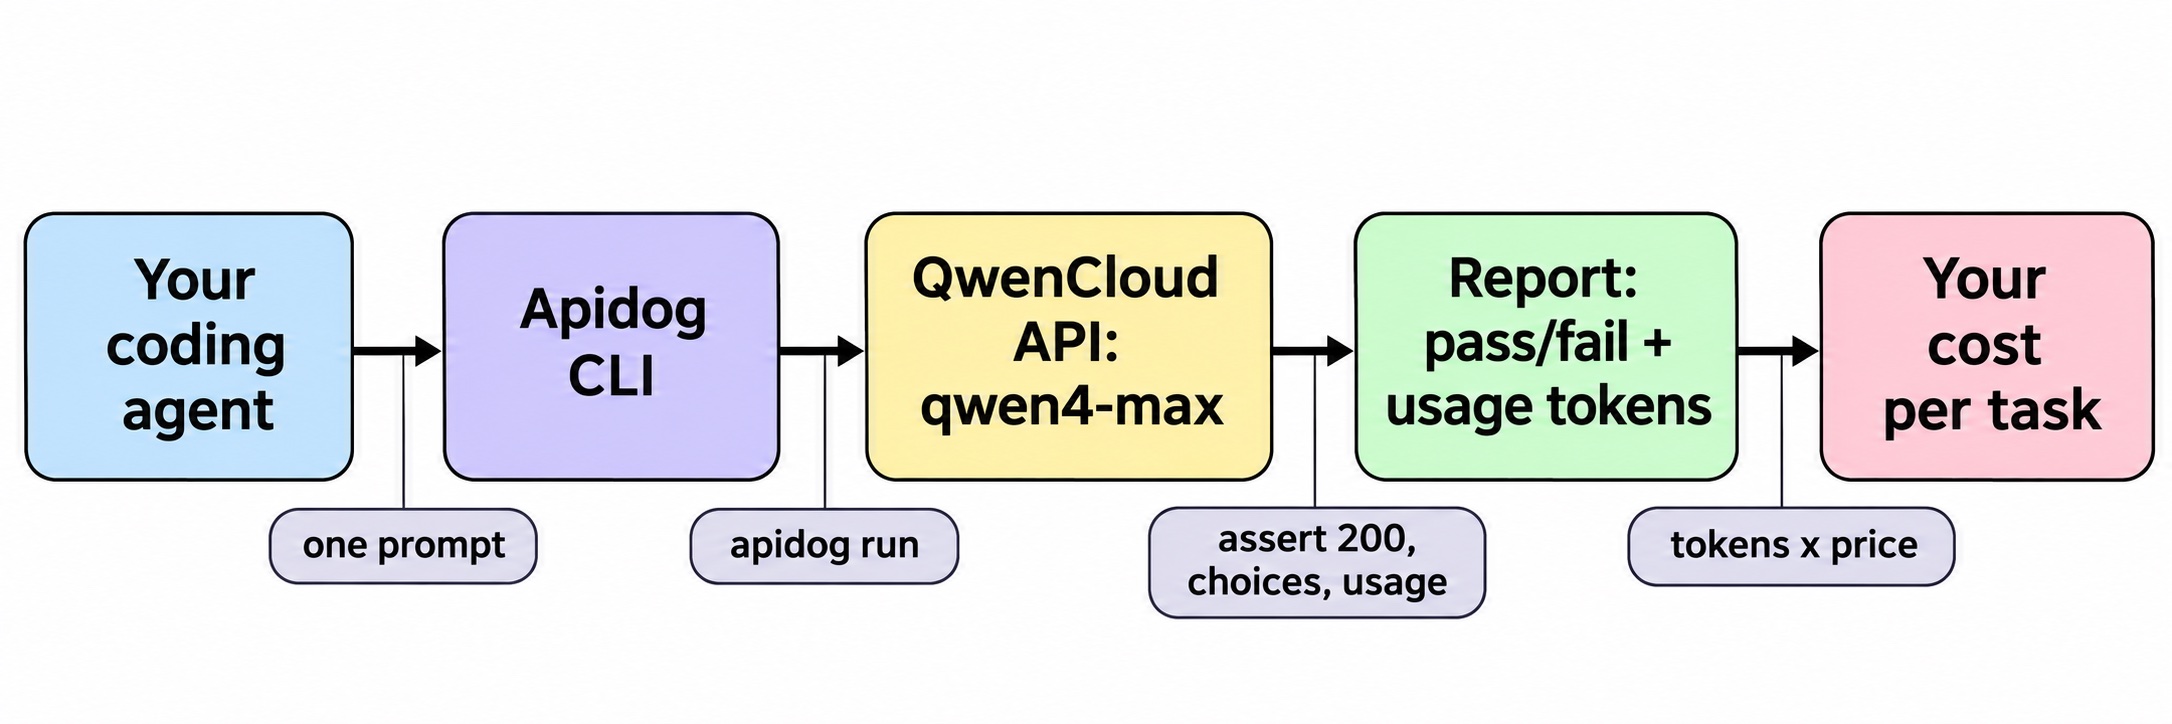
دع وكيل البرمجة لديك يتولى الإعداد باستخدام Apidog CLI. ثبّته مرة واحدة:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_APIDOG_TOKEN>
apidog skill install
يُعلّم apidog skill install وكيلك استخدام الأداة؛ ودليل التثبيت يغطي الرموز المميزة (tokens). ثم امنحه مطالبة واحدة:
In Apidog project <projectId>, add POST /chat/completions for the QwenCloud
OpenAI-compatible API (model qwen4-max, Bearer auth from {{DASHSCOPE_API_KEY}}).
Create an environment "qwencloud-sg" with base URL
https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1.
Create a test case that asserts status 200, a non-empty choices array and a
usage object. Run it once per row of ./prompts.csv, save a JSON report, and
give me pass rate plus total prompt and completion tokens.
يتحقق الوكيل من شكل كل حمولة (payload) قبل كتابة أي شيء. وكل العلامات أدناه مأخوذة من apidog <command> --help في Apidog CLI 2.2.12:
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file ./qwen-chat.json
apidog endpoint create --project <projectId> --file ./qwen-chat.json
apidog environment create qwencloud-sg --project <projectId> --base-url https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file ./case.json
apidog test-case create --project <projectId> --file ./case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -d ./prompts.csv --env-var "DASHSCOPE_API_KEY=$DASHSCOPE_API_KEY" -r cli,json
تشغّل -d تكرارًا واحدًا لكل صف من ملف مطالباتك، وتعيد --env-var تمرير المفتاح وقت التشغيل حتى لا يبقى أبدًا داخل المشروع. يقرأ الوكيل كل كتلة usage من تقرير JSON في مجلد apidog-reports. اضرب رموز المطالبة في 1.50 دولار ورموز الإكمال في 4.50 دولارات لكل مليون، وستحصل على تكلفة المهمة الخاصة بك لمقارنتها بمقدار 1.67 دولار من علي بابا.
بدّل البيئة لتشغيل المجموعة نفسها ضد نموذجك الحالي، وأعِد التشغيل مرتين أو ثلاثًا لترى التباين الذي لا تُظهره بطاقة الإطلاق. السطر نفسه apidog run يُدخل في أنظمة التكامل المستمر (CI) مع -r junit؛ انظر دليل CI/CD. ولمعرفة إعداد الوكيل خطوة بخطوة، راجع Apidog CLI في Claude Code. خطة Apidog المجانية تغطي حتى 4 مستخدمين.
الأسئلة الشائعة
هل اختبارات Qwen4-Max مستقلة؟ غير مستقلة في الغالب. عشر من النتائج الـ16 في بطاقة علي بابا هي تشغيلاتها الخاصة. وستّ مستشهد بها من لوحات صدارة أطراف ثالثة: APEX-Agents (Mercor)، وAA-Briefcase وAutomationBench-AA (Artificial Analysis)، وCodeArena وAgentArena (LM Arena)، وHLAB-Vals (Vals)، وAgents’ Last Exam.
ما هو Work360؟ اختبار علي بابا الخاص بالمهام الصناعية المعقدة عبر 26 مجالًا. سجّل Qwen4-Max نتيجة 52.69 مقابل 47.74 لـQwen3.8-Max؛ ويعتمد النموذجان فقط في المقارنة المنشورة.
ما مستوى أداء Qwen4-Max على Terminal-Bench 4.0؟ تعلن علي بابا نتيجة 48.5، بارتفاع عن 38.9، وبنحو نصف عدد الرموز. النماذج الأخرى في الجدول سجّلت بين 56.1 و67.2.
هل تشغيل Qwen4-Max أرخص من Qwen3.8-Max؟ في تقييم Work360 من علي بابا، انخفض متوسط تكلفة المهمة من 4.43 دولار إلى 1.67 دولار. الأسعار المعلنة هي 1.50 دولار للإدخال و4.50 دولار للإخراج لكل مليون رمز. انظر دليل خطة الرموز لخيارات الاشتراك وQwen4-Max مجانًا للطرق بلا تكلفة.
ما هو Live Delivery في إطلاق Qwen4-Max؟ سير عمل للوكلاء يُسلّم نسخة أولى قابلة للاستخدام مبكرًا ويحسّنها وأنت توجّهه. إنه ليس اختبارًا معياريًا. دليل إضافة Qwen Live Delivery يغطيها.