
أصدرت Alibaba نموذج Qwen 3.8-Max في أوائل أغسطس 2026، وإذا كنت تستخدم بالفعل qwen3.7-max في الإنتاج، فعليك اتخاذ قرار حاسم. يحقق النموذج الجديد مكاسب كبيرة في معايير الوكيل والبحث، ويضيف إدخال الصور، ويُطرح بسعر قائمة أقل، ويأتي مع وعد لم تقدمه Alibaba لسابقه: الأوزان المفتوحة.
لكن القرار ليس بهذه البساطة "النموذج الجديد يفوز". يعمل Qwen 3.7-Max حاليًا بخصم محدود الوقت بنسبة 50% يجعله أرخص من 3.8-Max بالقيمة المطلقة. بعض فروقات المعايير دراماتيكية. والبعض الآخر يساوي الصفر فعليًا. تتناول هذه المقالة كل تغيير مهم، حتى تتمكن من تحديد ما إذا كنت تريد التبديل الآن، أو الانتظار، أو النزول إلى فئة أدنى بالكامل.
إذا كنت تريد الصورة الكاملة للنموذج الجديد أولاً، ابدأ بشرحنا لـ Qwen 3.8-Max. للحصول على معلومات أساسية حول النموذج الرائد السابق، انظر ما قدمه Qwen 3.7.
ملاحظة حول المنهجية قبل الأرقام. يأتي كل رقم معياري أدناه من جدول Alibaba الخاص في منشور إطلاق Qwen 3.8 الرسمي. وهذا مفيد هنا بالفعل: تم تقييم كلا النموذجين في نفس اختبار البائع، لذا فإن الفروقات متسقة داخليًا، حتى لو كان التحقق المستقل لا يزال معلقًا. تم تشغيل معظم صفوف الترميز على حزمة Claude Code، والعديد من المعايير هي داخلية لـ Qwen.
النسخة المختصرة
| ماذا تغير | Qwen 3.7-Max | Qwen 3.8-Max |
|---|---|---|
| Terminal Bench 2.1 | 74.5 | 86.6 |
| SWE-bench Pro | 60.6 | 67.7 |
| PaperBench | 64.8 | 93.0 |
| IFBench | 79.1 | 82.8 |
| GPQA Diamond | 92.4 | 92.6 |
| HLE | 41.4 | 43.6 |
| سعر القائمة (لكل مليون رمز) | $2.5 إدخال / $7.5 إخراج | $2 إدخال / $6 إخراج |
| السعر الحالي (عرض ترويجي) | $1.25 إدخال / $3.75 إخراج | $2 إدخال / $6 إخراج |
| إدخال الصور | لا | نعم |
| البنية المعلنة | لم تُعلن | 2.4T إجمالي، 95B MoE نشط |
| أوزان مفتوحة | لم تُصدر قط | وُعد بها "الأسبوع القادم" (~10 أغسطس) |
| نافذة السياق | 1 مليون رمز | 1 مليون رمز |
الآن التفاصيل.
فروقات المعايير: حيث القفزة حقيقية
تتركز التحسينات الرئيسية حول العمل الوكيلي: المهام طويلة الأمد حيث يخطط النموذج وينفذ ويصحح ذاتيًا.
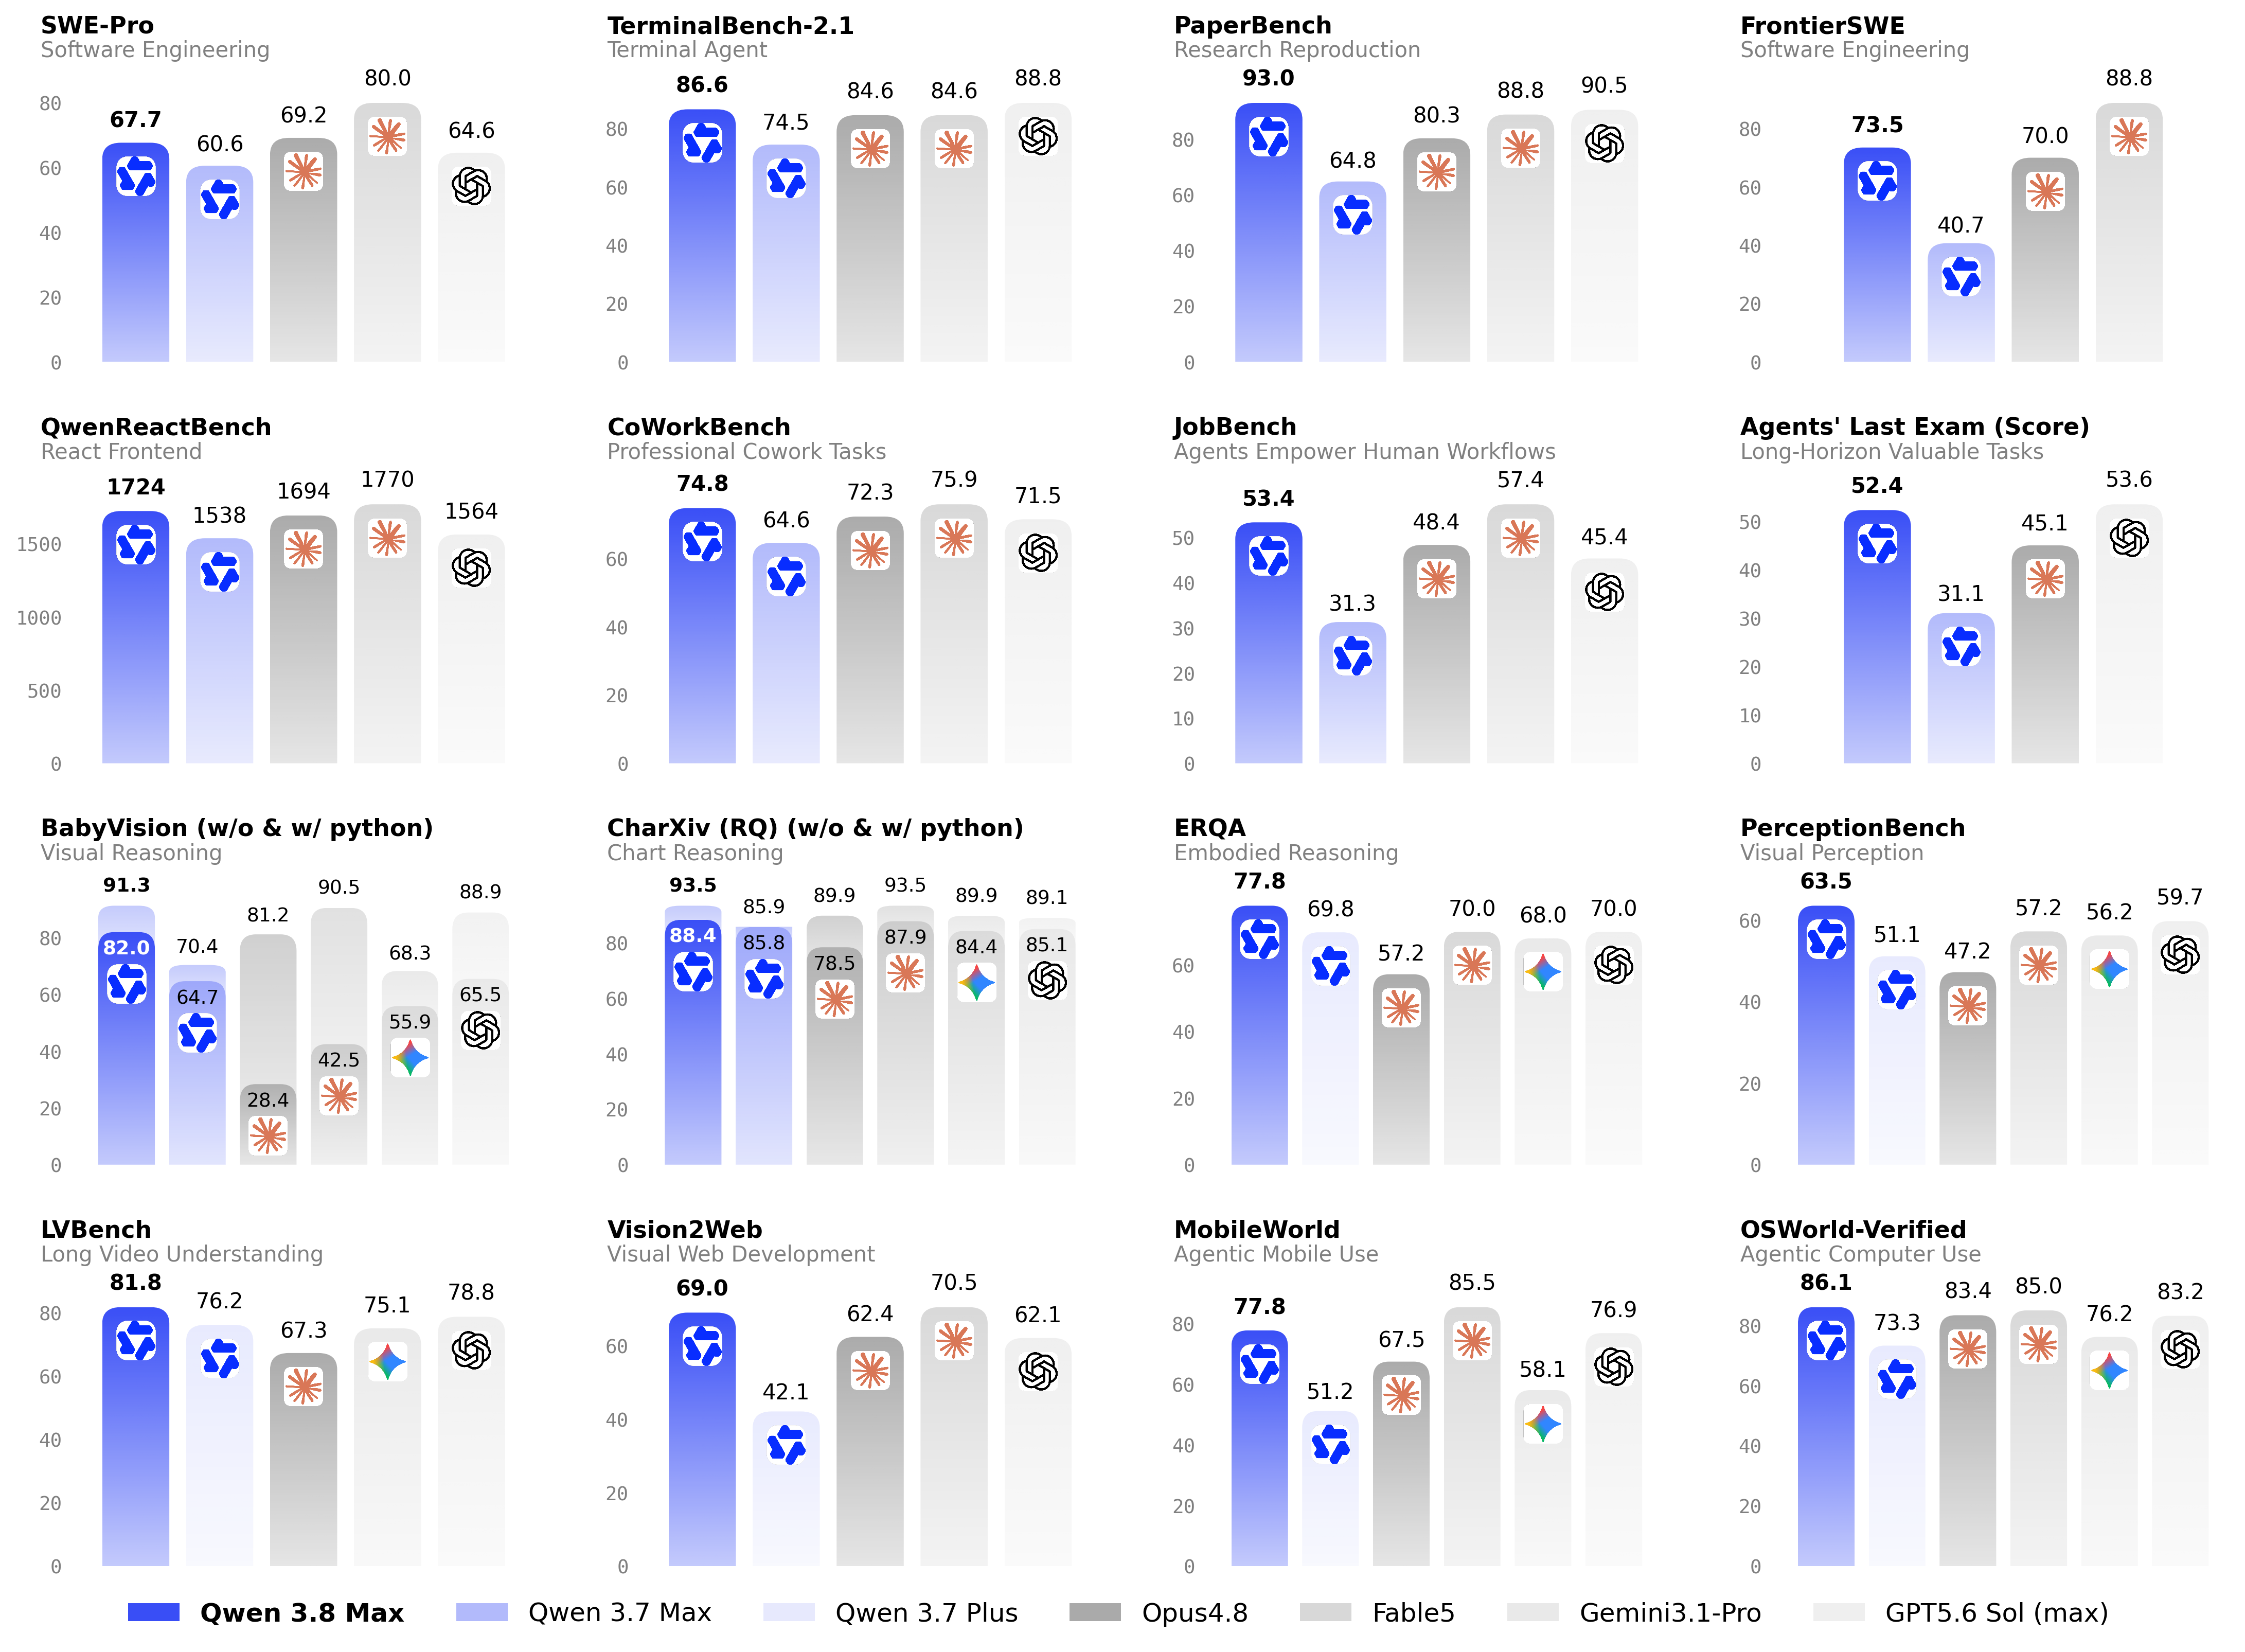
Terminal Bench 2.1: من 74.5 إلى 86.6. هذه قفزة بمقدار 12 نقطة في المهام الوكيلية المعتمدة على الطرفية، وتنقل Qwen من كونه متأخرًا بشكل واضح إلى منافس حقيقي. في نفس الجدول، سجلت Alibaba لنموذج Claude Opus 4.8 و Fable 5 84.6 لكل منهما، مما يضع 3.8-Max متقدمًا عليهما في هذا الصف. لا يزال GPT-5.6 Sol يتصدر بـ 88.8.
SWE-bench Pro: من 60.6 إلى 67.7. زيادة بمقدار 7 نقاط في مهام هندسة البرمجيات في العالم الحقيقي. ذات مغزى، ولكن لنكن صريحين: Fable 5 يسجل 80.0 في نفس الجدول، لذا فإن هذا يمثل لحاقًا، وليس تجاوزًا. إذا كان أداء SWE-bench Pro هو معيار الشراء الأساسي لديك، فإن الريادة لا تزال في مكان آخر.
PaperBench: من 64.8 إلى 93.0. أكبر فرق فردي في الجدول، قفزة بمقدار 28 نقطة في إعادة إنتاج أوراق بحث الذكاء الاصطناعي. وهو أيضًا أفضل صف رائد لـ 3.8-Max، متقدمًا على كل المنافسين في مقارنة Alibaba. إذا كان عبء عملك يتضمن إعادة إنتاج الأبحاث، أو المستندات التقنية الطويلة، أو الاستدلال العلمي متعدد الخطوات، فهذا هو الرقم الذي يجب أن يلفت انتباهك.
IFBench: من 79.1 إلى 82.8. تحسن اتباع التعليمات بما يقرب من 4 نقاط. والجدير بالذكر أن 3.7-Max كان قويًا بالفعل هنا (79.1 تفوق على Opus 4.8 و Fable 5 في نفس الاختبار)، لذا فإن هذا يوسع ريادة موجودة بدلاً من إصلاح نقطة ضعف.
GPQA Diamond: من 92.4 إلى 92.6. ثابت فعليًا. كانت أسئلة وأجوبة العلوم على مستوى الدراسات العليا قد وصلت بالفعل إلى حد التشبع لـ 3.7-Max، والنموذج الجديد لا يغير ذلك. إذا كان عبء عملك يشبه GPQA، فإن الترقية لا تشتري لك شيئًا في الجودة.
HLE: من 41.4 إلى 43.6. تحسن امتحان Humanity's Last Exam نقطتين لكنه لا يزال يتخلف عن المتصدرين: Fable 5 يسجل 53.3 و GPT-5.6 Sol يسجل 47.2 في نفس الجدول. يقلص Qwen 3.8-Max الفجوات في العديد من الأماكن. لكن هذا ليس واحدًا منها.
النمط: مكاسب هائلة في معايير الوكيل والبحث، مكاسب تدريجية في اتباع التعليمات، لا يوجد حركة في معايير المعرفة المشبعة، وفجوة مستمرة في أصعب تقييمات الاستدلال. للحصول على تفاصيل أعمق للجدول الكامل، بما في ذلك التفاصيل الدقيقة حول الحزم والمعايير الداخلية، راجع تحليل معايير Qwen 3.8.
البنية: Alibaba تكشف أرقامها أخيرًا
Qwen 3.8-Max هو نموذج خليط من الخبراء يضم 2.4 تريليون معلمة مع 95 مليار معلمة نشطة لكل تمريرة أمامية، مبني على الأساس المعماري لـ Qwen 3.5. هذه تقريبًا نسبة تنشيط تبلغ 4%، وهو أمر مهم لتكاليف الخدمة: أنت تدفع مقابل الحوسبة لـ 95 مليار، وليس 2.4 تريليون.
التباين مع 3.7-Max هو الكشف نفسه. لم تنشر Alibaba أبدًا أرقام حجم قابلة للمقارنة لـ Qwen 3.7-Max. عدد المعلمات، نسب التنشيط، تكوين الخبراء: كلها غير معلنة. مع 3.8-Max، توضح وثائق نموذج Model Studio ومنشور الإصدار البنية، مما يجعل تخطيط السعة وتقدير التكلفة أقل بكثير من مجرد تخمين.
في سياق سباق الأوزان المفتوحة: يعمل Kimi K3 بإجمالي 2.8 تريليون مع 104 مليار نشطة. Qwen 3.8-Max أصغر على كلا المحورين.
متعدد الوسائط: القدرة التي لم يمتلكها 3.7-Max قط
Qwen 3.7-Max هو نموذج نصي. يقبل Qwen 3.8-Max إدخال الصور بشكل أصلي، ونشرت Alibaba جدولًا منفصلاً للمعايير متعددة الوسائط حيث يتصدر معظم الصفوف مقابل Gemini 3.1 Pro و GPT-5.6 Sol.
النتائج البارزة من جدول Alibaba متعدد الوسائط: MathVision عند 95.2، LogicVista عند 91.9، و OSWorld-Verified عند 86.1 لمهام استخدام الكمبيوتر. لا يوجد عمود لـ 3.7-Max في هذا الجدول للمقارنة، لأنه لا يمكن أن يكون هناك: النموذج الأقدم لا يقبل الصور.
عمليًا، هذا يعني أن أعباء العمل التي كنت تحتاج سابقًا إلى توجيهها إلى نموذج رؤية منفصل (فهم لقطات الشاشة، صور المستندات، أتمتة واجهة المستخدم، استخراج الرسوم البيانية) يمكن الآن تشغيلها على نفس معرف النموذج مثل حركة مرور النص الخاصة بك. يوضح منشور الإصدار أيضًا فهم المستندات الطويلة والفيديو، على الرغم من أن هذه قدرات موضحة في المدونة وليست أنواع إدخال API مميزة، لذا تحقق من وثائق API لحالتك المحددة.
التسعير: النموذج الجديد أرخص، باستثناء الآن
هنا تزداد حسابات الترقية إثارة للاهتمام.
يُطلق Qwen 3.8-Max بسعر 2 دولار إدخال / 6 دولارات إخراج لكل مليون رمز، وهو مستوى واحد ثابت عبر سياق المليون رمز بالكامل. بينما يُدرج Qwen 3.7-Max بسعر 2.5 دولار / 7.5 دولار. لذا فإن النموذج الجديد، الأكثر قدرة، يقل عن سعر قائمة سلفه بنسبة 20%. هذا لا يحدث أبدًا تقريبًا في تغيير جيل رائد.
لكن هناك مشكلة: تدير Alibaba حاليًا عرضًا ترويجيًا محدود الوقت بنسبة 50% على 3.7-Max، مما يرفع سعره الفعلي إلى 1.25 دولار / 3.75 دولار. بأسعار اليوم، يكلف النموذج الأقدم 38% أقل من النموذج الجديد. جميع الأسعار موجودة على صفحة تسعير Model Studio الرسمية.
شيئان يجب تذكرهما:
- يمكن أن ينتهي العرض الترويجي. تصفه Alibaba بأنه محدود الوقت ولم تنشر تاريخ انتهائه. إذا قمت بالتصميم بناءً على 1.25 دولار / 3.75 دولار، فإن افتراض ميزانيتك له تاريخ انتهاء لا يمكنك رؤيته. بأسعار القائمة، 3.8-Max هو النموذج الأرخص.
- رموز "التفكير" تضخم الفواتير الحقيقية. يضبط Qwen 3.8-Max افتراضيًا على
reasoning_effort: xhigh، ويتم محاسبة رموز "التفكير" كإخراج. يمكن أن تصل التكلفة الفعلية لكل طلب إلى أعلى بكثير مما يشير إليه الملصق. يتعامل دليل تسعير Qwen 3.8 الخاص بنا مع اقتصاديات التخزين المؤقت وحساب التكلفة لكل مهمة.
وإذا لم يكن أي من نموذجي Max مناسبًا لميزانيتك، فإن qwen3.7-plus بسعر 0.4 دولار / 1.6 دولار (خصم 20% حاليًا) يظل فئة القيمة. تغطي مقارنة Plus vs Max متى يكون Plus كافيًا.
الأوزان المفتوحة: سابقة لفئة Max
لم يتم شحن أوزان مفتوحة لأي نموذج من فئة Qwen-Max من قبل. لم يفعل Qwen 3.7-Max ذلك، ولم توحي Alibaba بذلك أبدًا. يكسر Qwen 3.8-Max هذا النمط: يعد منشور الإصدار بتوفير الأوزان على Hugging Face و ModelScope "الأسبوع القادم"، مما يشير إلى حوالي 10 أغسطس.
حتى تاريخ كتابة هذه السطور (3 أغسطس 2026)، الأوزان ليست قابلة للتنزيل. تعامل مع الوعد كوعْد. سابقة الأمر مشجعة: وصلت أوزان Kimi K3 بعد 11 يومًا من الإطلاق، ولدى Alibaba سجل حافل في الأوزان المفتوحة مع نماذج Qwen الأصغر. ولكن تنزيل معلمة بحجم 2.4 تريليون هو مشروع استضافة ذاتية متعدد العقد حتى مع التقليل الكمي، لذا بالنسبة لمعظم الفرق، سيكون التأثير العملي هو الوصول المستضاف من طرف ثالث وضغط التسعير، وليس نموذجًا يعمل في رف الخادم الخاص بك.
إذا كانت الأوزان المفتوحة مهمة لقصة مشترياتك أو امتثالك، فقد يحسم ذلك وحده سؤال 3.7 مقابل 3.8. نموذج واحد سيكون لديه (على الأرجح) هذه الأوزان. والآخر لن يكون لديه أبدًا.
ما لم يتغير
من الجدير بالقول بوضوح، لأن منشورات الترقية تميل إلى المبالغة في البيع:
- نافذة السياق: مليون رمز في كلا النموذجين. لا يوجد توسيع. إذا اخترت 3.7-Max للسياق الطويل، فإن 3.8-Max يحافظ على نفس المليون رمز بسعر ثابت عبر النافذة الكاملة.
- مسار الوصول: نفسه. يخدم كلا النموذجين من خلال Alibaba Cloud Model Studio بنقاط نهاية متوافقة مع OpenAI. التبديل هو تغيير معرف النموذج (من
qwen3.7-maxإلىqwen3.8-max)، وليس مشروع ترحيل. يضيف 3.8-Max أيضًا واجهة برمجة تطبيقات متوافقة مع Anthropic، والتي تستحق التجريب في عميل مثل Apidog إذا كانت أدواتك تدعم هذا البروتوكول. - ضوابط الاستدلال: أصبحت رسمية الآن.
reasoning_effortهو معلمة موثقة ومدعومة في 3.8-Max بثلاثة مستويات (xhigh افتراضيًا، متوسط، منخفض)، جنبًا إلى جنب معenable_thinkingوpreserve_thinking. إذا قمت بضبط المطالبات حول سلوك الاستدلال الضمني في 3.7-Max، فلديك الآن قرص صريح بدلاً من ذلك.
هل يجب عليك الترقية؟ ثلاثة مسارات صادقة
قم بالترقية الآن إذا كان عبء عملك وكيلًا أو كثيف البحث. فروقات Terminal Bench (74.5 إلى 86.6) و PaperBench (64.8 إلى 93.0) هي نوع القفزة التي يمكنك أن تشعر بها في الإنتاج، وتحصل على إدخال الصور بالإضافة إلى سعر القائمة الأقل كمكافأة. إذا كنت تبني وكلاء يقومون بتشغيل الأطراف الطرفية، أو إعادة إنتاج الأعمال التقنية، أو معالجة لقطات الشاشة، فإن الحالة واضحة.
استفد من عرض 3.7-Max الترويجي إذا كان عبء عملك يقع في المناطق الثابتة. تحركت مهام المعرفة من نوع GPQA بمقدار 0.2 نقطة. إذا كانت حركة مرورك هي أسئلة وأجوبة، أو تلخيص، أو دردشة عامة، و 3.7-Max يلبي بالفعل معايير الجودة الخاصة بك، فإن 1.25 دولار / 3.75 دولار هو أفضل عرض لكل رمز يقدمه أي نموذج من فئة Max على الإطلاق. اضبط تذكيرًا في التقويم لإعادة التحقق من حالة العرض الترويجي شهريًا، واعلم أن سعرك الاحتياطي هو 3.8-Max بسعر 2 دولار / 6 دولارات، وليس 3.7-Max بسعر القائمة.
انتقل إلى qwen3.7-plus إذا كنت مدفوعًا بالسعر وكانت مهامك روتينية. بسعر 0.4 دولار / 1.6 دولار، فهو أرخص بخمس مرات من 3.8-Max عند الإدخال، وبالنسبة للتصنيف والاستخراج والتوليد المبرمج، غالبًا ما تكون قدرة فئة Max إهدارًا للإنفاق.
اختبر التبديل قبل الالتزام
معايير البائع، حتى لو كانت متسقة داخليًا، لا تتنبأ بكيفية سلوك النموذج على مطالباتك. الطريقة الرخيصة لحسم هذا الأمر هي إجراء مقارنة جنبًا إلى جنب على عبء عملك الفعلي.
في Apidog، يمكنك إعداد ذلك في بضع دقائق: وجه مجموعة واحدة إلى نقطة نهاية Model Studio المتوافقة مع OpenAI، ثم قم بإنشاء بيئتين تختلفان فقط في متغير معرف النموذج، واحدة مضبوطة على qwen3.7-max والأخرى على qwen3.8-max. قم بتشغيل نفس مجموعة الطلبات مقابل كليهما، وقم بتبديل البيئات بنقرة واحدة، وقارن المخرجات وزمن الوصول واستخدام الرموز من عارض الاستجابة. نظرًا لأن كلا النموذجين يتشاركان نفس واجهة برمجة التطبيقات، فإن مجموعة واحدة تغطي كليهما، ويمكنك حفظ مطالبات الإنتاج التمثيلية كسيناريوهات اختبار وإعادة تشغيلها كلما أصدرت Alibaba تحديثًا أو تغير تسعير العرض الترويجي.
هذا يحول "هل يجب علينا الترقية؟" من نقاش حول المعايير إلى فترة بعد الظهر من الأدلة. قم بتنزيل Apidog مجانًا وقم بتشغيل المقارنة مقابل حركة المرور الخاصة بك قبل تغيير أي إعدادات إنتاج.
الأسئلة الشائعة
هل Qwen 3.8-Max أرخص من Qwen 3.7-Max؟
بسعر القائمة، نعم: 2 دولار / 6 دولارات مقابل 2.5 دولار / 7.5 دولار لكل مليون رمز. بالأسعار الفعلية اليوم، لا: العرض الترويجي المحدود الوقت بنسبة 50% لـ 3.7-Max يجعله 1.25 دولار / 3.75 دولار، وهو أقل بنسبة 38% من 3.8-Max. ليس للعرض الترويجي تاريخ انتهاء منشور. تتوفر تفاصيل التكلفة الكاملة في دليل تسعير Qwen 3.8.
هل أحتاج إلى تغيير رمزي للتبديل من qwen3.7-max إلى qwen3.8-max؟
للاستخدام الأساسي، لا. يخدم كلا النموذجين من خلال نفس نقاط نهاية Model Studio المتوافقة مع OpenAI، لذا فإن التبديل هو مجرد تغيير معرف النموذج. قد ترغب في تعيين reasoning_effort بشكل صريح، حيث أن 3.8-Max يضبط افتراضيًا على xhigh وتُحاسب رموز "التفكير" كإخراج. إذا أرسلت صورًا، فهذه قدرة خاصة بـ 3.8-Max فقط وتتطلب تنسيق رسالة إدخال الصورة القياسي.
هل Qwen 3.7-Max لديه أوزان مفتوحة؟
لا، ولن يكون لديه أبدًا بناءً على تاريخ Alibaba مع هذه الفئة. Qwen 3.8-Max هو أول نموذج من فئة Max يتم الوعد بأوزانه المفتوحة، والمتوقع توفرها على Hugging Face و ModelScope حوالي 10 أغسطس 2026. حتى 3 أغسطس، لم تكن الأوزان قابلة للتنزيل بعد.
هل Qwen 3.8-Max أفضل من Claude أو GPT الآن؟
يعتمد ذلك على الصف، وتذكر أن هذه هي أرقام Alibaba الخاصة. في جدولهم، يتفوق 3.8-Max على Opus 4.8 و Fable 5 في Terminal Bench 2.1 ويتصدر الجميع في PaperBench و IFBench. لكنه يتخلف بشدة عن Fable 5 في SWE-bench Pro (67.7 مقابل 80.0) ويتخلف عن جميع المتصدرين في HLE. لا توجد أرقام معايير مستقلة حتى الآن، لذا احتفظ بالحكم النهائي حتى تظهر التقييمات من طرف ثالث.