
أوزان Mistral Large 4 المفتوحة تم رفعها على Hugging Face في 29 أكتوبر 2026. تحصل على نفس النموذج البالغ 1.05 تريليون معامل الذي تقدمه Mistral عبر واجهة API الخاصة بها، بموجب ترخيص MIT معدل، في نقاط تفتيش FP8 و NVFP4 بالإضافة إلى تكميمات GGUF المجتمعية. يمكنك تنزيله دون خطوة موافقة، أو تشغيله على 8 وحدات معالجة رسومات لمراكز البيانات باستخدام vLLM أو SGLang، أو تخطي الأجهزة واستدعاء mistral-large-4 على Mistral API مقابل 0.70 دولار لكل مليون رمز إدخال.
أدناه: ما الذي تغير منذ معاينة 6 أكتوبر، أحجام التنزيل، الأجهزة لكل مسار والترخيص. لنظرة عامة على النموذج، اقرأ تحليل إطلاق Mistral Large 4; لتنسيقات الطلبات وكود SDK، راجع دليل Mistral Large 4 API.
ما هي أوزان Mistral Large 4 المفتوحة؟
أوزان Mistral Large 4 المفتوحة هي نقاط التفتيش القابلة للتنزيل لنموذج Mistral الرائد، الملقب بـ "Le Chonk". إنه نموذج خليط خبراء متعدد الوسائط بحوالي 1.05 تريليون معامل إجمالي، وحوالي 49 مليار نشط لكل رمز (52 مليار عند حساب التضمينات وطبقات الإخراج)، ومشفر رؤية بحجم 1.6 مليار، ونافذة سياق تبلغ 1 مليون رمز، تم إصداره بموجب ترخيص Mistral Ecosystem Open-Weight.
تسرد بطاقة النموذج الرسمية 72 طبقة نصية و128 خبيرًا موجهًا، مع اختيار 4 لكل رمز بالإضافة إلى خبير مشترك واحد.
الإصدار ليس نسخة مجمدة من المعاينة. يقول إعلان الأوزان المفتوحة من Mistral أن النموذج حصل على ثلاثة أسابيع إضافية من التعلم المعزز الذي يركز على البرمجة والأمن السيبراني قبل إطلاق الأوزان.
ما الذي تغير منذ معاينة 6 أكتوبر
إذا اختبرت Large 4 أثناء المعاينة، فهناك أربعة أشياء مختلفة الآن.
| المجال | معاينة 6 أكتوبر | إصدار 29 أكتوبر المفتوح |
|---|---|---|
| الأوزان | API فقط، ووُعدت الأوزان لاحقًا | FP8 و NVFP4 على Hugging Face، بدون بوابات |
| أنماط الاستدلال | high أو none |
low، medium، high (افتراضي high)؛ low يحل محل none |
| Terminal-Bench 4.0 (حسب Mistral) | 28% | 41%، مع حوالي 30% رموز إخراج أقل |
| مقاومة هجمات B3 Agent Security (حسب Mistral) | 93.3% | 97.1% |
| سعر API لكل مليون رمز | معروض بخصم المعاينة | 0.70 دولار إدخال، 0.07 دولار إدخال مخزن مؤقتًا، 2.10 دولار إخراج |
تغيير الاستدلال يكسر الكود. إذا كان تكاملك في المعاينة يرسل reasoning_effort: "none"، فغيّره إلى "low": تشير مشاركة الإطلاق على Hugging Face إلى أن Transformers يشغّل none عند high، لذا فإن الإعداد القديم يكلف رموزًا بدلاً من الفشل.
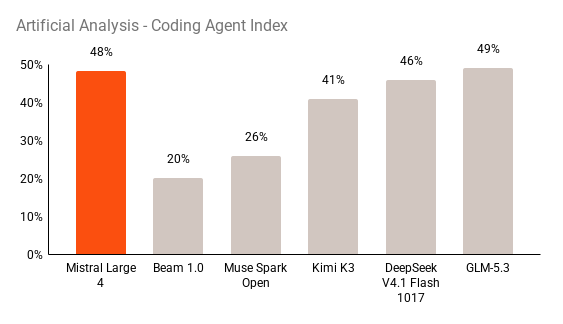
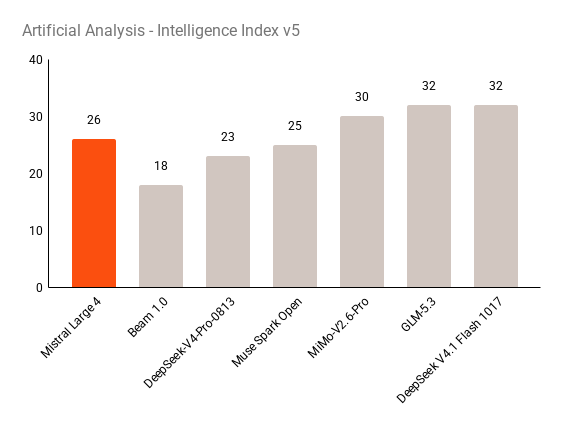
جميع أرقام المعايير في هذا المنشور مُبلَّغ عنها من البائع. تدعي Mistral أيضًا تحقيق 19.7% في معيار FrontierCode 2.0 الخاص بـ Cognition، وهي أعلى نتيجة للأوزان المفتوحة في مخططها، و48% في مؤشر Artificial Analysis Coding Agent، متعادلة تقريبًا مع GLM-5.3. كان التكرار المستقل لا يزال معلقًا عندما تحققنا في 2 نوفمبر.
ثلاث طرق لتشغيل Mistral Large 4
لديك ثلاثة مسارات، والمسار الصحيح يعتمد على مقدار الأجهزة التي تتحكم بها.
- استدعِ Mistral API. معرّف النموذج
mistral-large-4، 0.70 دولار إدخال، 0.07 دولار إدخال مخزن مؤقتًا و2.10 دولار إخراج لكل مليون رمز. لا وحدات معالجة رسومات. - استخدم مزودًا مستضافًا. تدرج Mistral OpenRouter ونقاط نهاية NVIDIA المستضافة وحاوية NIM وMicrosoft Foundry، التي تقدم أيضًا عمليات نشر خاصة على Azure.
- استضف الأوزان بنفسك. نزّل من Hugging Face وشغّلها باستخدام vLLM أو SGLang أو Transformers أو llama.cpp على أجهزتك الخاصة.
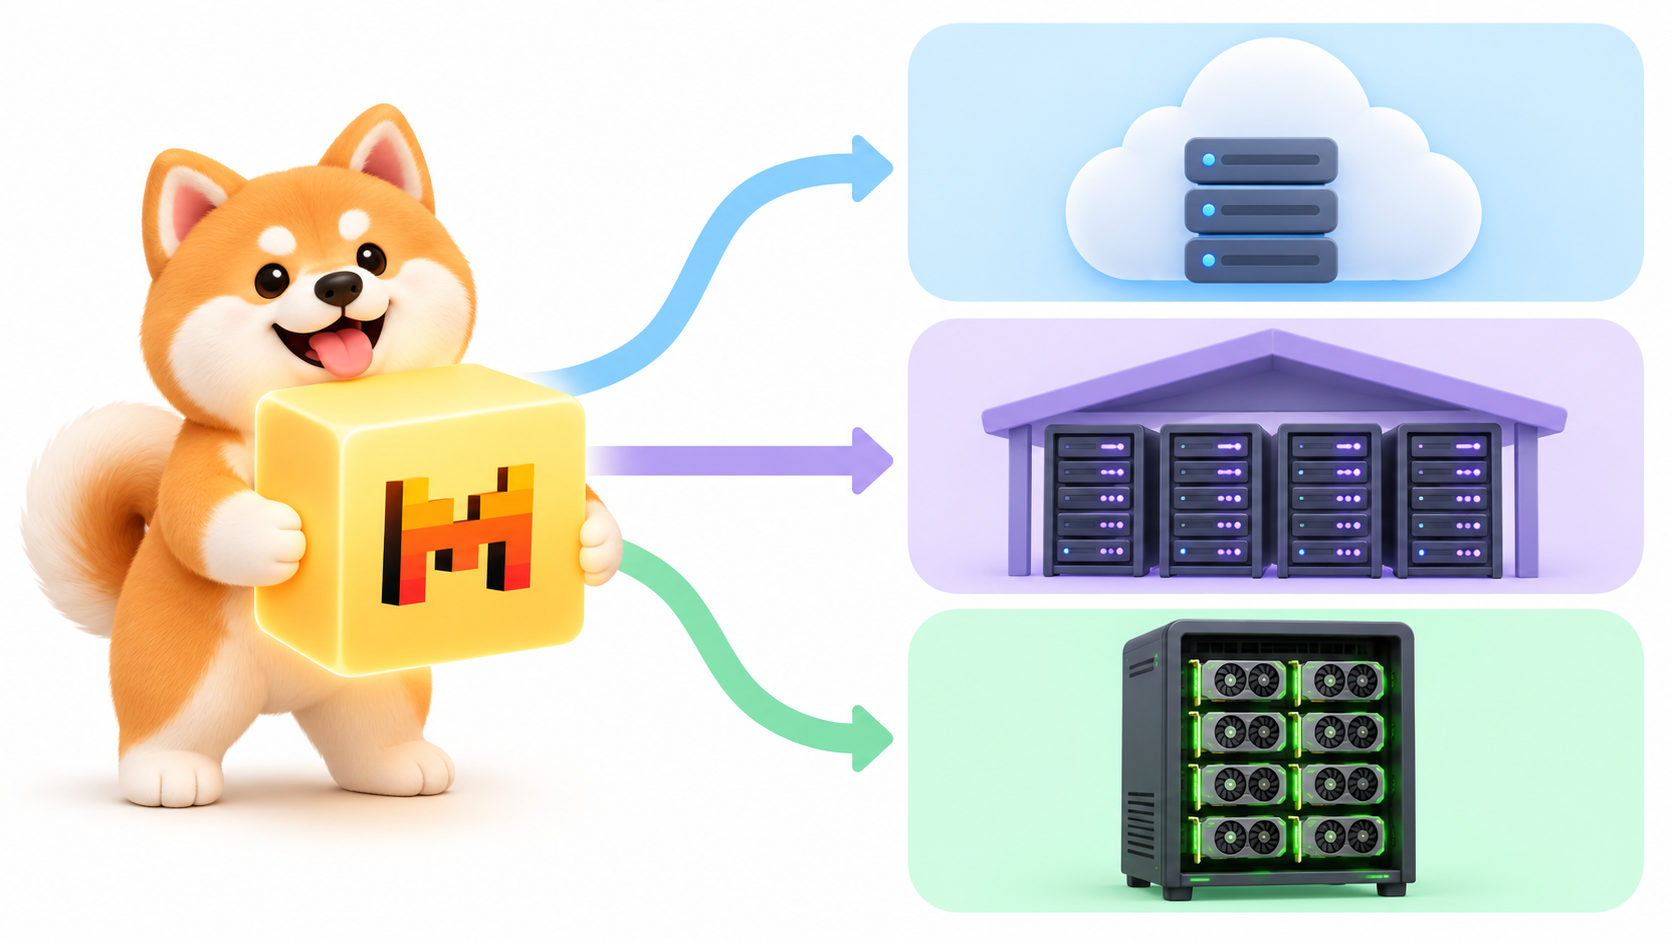
ابدأ بالمسار 1 أو 2. انتقل إلى المسار 3 لسبب ملموس: بيانات لا يمكنها مغادرة شبكتك، أو ضبط دقيق تحتاج إلى امتلاكه، أو حجم عمل يُبقي عقدة 8 وحدات معالجة رسومات مشغولة.
كيفية تنزيل Mistral Large 4
المستودعات الرسمية ليست محمية ببوابات (تقرير Hugging Face API gated: false لكليهما)، لذا يمكن لأي حساب أو عميل مجهول سحبها. الحجم هو البوابة الحقيقية.
| المستودع | التنسيق | الحجم على القرص |
|---|---|---|
mistralai/Mistral-Large-4-1T-A52B |
FP8، رسمي | حوالي 1,061 جيجابايت |
mistralai/Mistral-Large-4-1T-A52B-NVFP4 |
NVFP4، رسمي | حوالي 610 جيجابايت |
ggml-org/Mistral-Large-4-1T-A52B-GGUF |
Q8_0 | حوالي 1,115 جيجابايت |
ggml-org/Mistral-Large-4-1T-A52B-GGUF |
Q4_K_M | حوالي 635 جيجابايت |
ggml-org/Mistral-Large-4-1T-A52B-GGUF |
Q2_K | حوالي 381 جيجابايت |
ggml-org/Mistral-Large-4-1T-A52B-GGUF |
IQ2_XXS | حوالي 298 جيجابايت |
جمعنا هذه من قائمة ملفات كل مستودع في 2 نوفمبر 2026. ينشر Unsloth أيضًا تكميمات GGUF تحت unsloth/Mistral-Large-4-1T-A52B-GGUF.
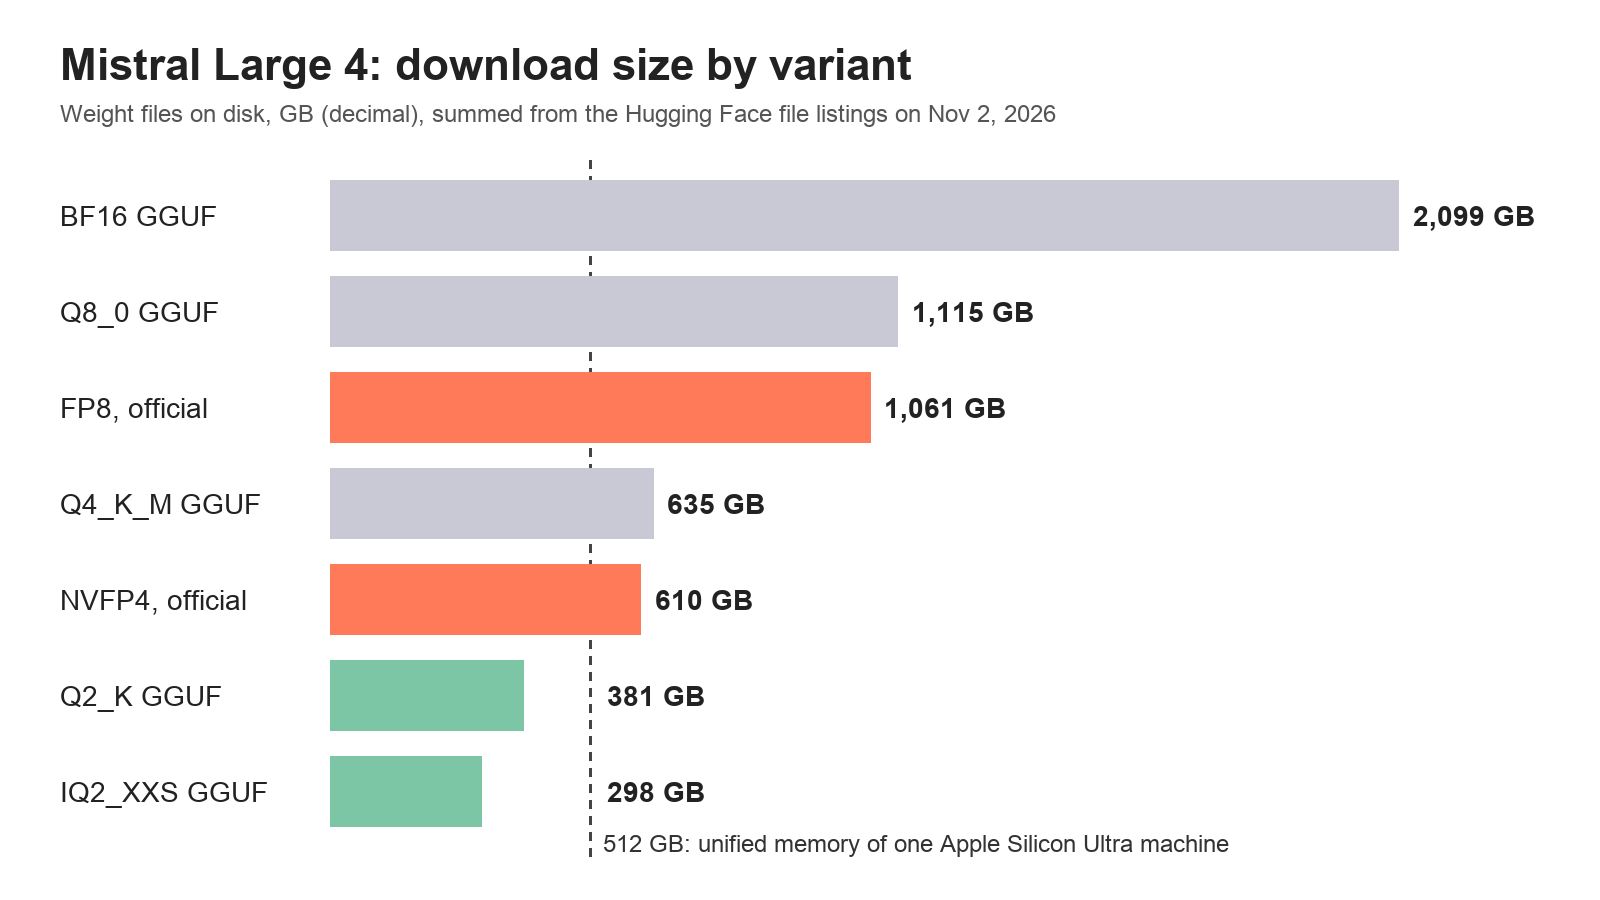
نزّل فقط الملفات التي تحتاجها باستخدام Hugging Face CLI:
pip install -U huggingface_hub
hf download mistralai/Mistral-Large-4-1T-A52B-NVFP4 \
  --local-dir ./mistral-large-4-nvfp4
يستغرق تنزيل FP8 ما يزيد قليلاً عن ساعتين عند سرعة 1 جيجابت في الثانية المستمرة.
كيفية استضافة Mistral Large 4 بنفسك
يفترض كل مثال تقديم رسمي عقدة واحدة بها 8 وحدات معالجة رسومات وتوازي موترات بمقدار 8. إليك ما يتوقعه كل محرك.
| المحرك | نقطة التفتيش | الأجهزة في الأمثلة الرسمية |
|---|---|---|
| vLLM | FP8 | 8 وحدات معالجة رسومات، --tensor-parallel-size 8؛ تستخدم Hugging Face Inference Endpoints 8x H200 |
| vLLM | NVFP4 | 8 وحدات معالجة رسومات NVIDIA Blackwell |
| SGLang | FP8 | 8 وحدات معالجة رسومات، --tp-size 8 |
| Transformers | FP8 | 8 وحدات معالجة رسومات عبر torchrun |
| llama.cpp | Q2_K GGUF | جهاز Apple Silicon Ultra واحد بذاكرة موحدة 512 جيجابايت |
vLLM
توصي بطاقة النموذج بـ vLLM وتوفر صورة Docker مخصصة:
docker run --runtime nvidia --gpus all \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -p 8000:8000 \
  --ipc=host \
  vllm/vllm-openai:mistral-large-4 \
  --model mistralai/Mistral-Large-4-1T-A52B \
  --tensor-parallel-size 8 \
  --tool-call-parser mistral \
  --reasoning-parser mistral \
  --enable-auto-tool-choice \
  --gpu-memory-utilization 0.85
احتفظ بعلامتي المحلل اللغوي، وإلا سيهبط نص التفكير في content وتصل استدعاءات الأدوات كنص خام. لفك تشفير أسرع، توثق البطاقة مفكك تشفير DSpark التخميني الاختياري: أضف --speculative-config '{"method": "dspark", "num_speculative_tokens": 3}'.
على 8x H200 مع هذا المسودة، قاس Hugging Face حوالي 65 رمزًا في الثانية لطلب واحد وحوالي 480 رمزًا في الثانية إجمالاً عبر 1,000 محادثة ShareGPT تحت الحمل.
SGLang يعمل أيضًا: يستخدم مثال sglang serve في بطاقة النموذج --tp-size 8، --speculative-algorithm DSPARK ومحللات auto للاستدلال واستدعاء الأدوات.
llama.cpp على جهاز Mac
قدم فريق llama.cpp دعم اليوم الأول. يناسب تكميم Q2_K (381 جيجابايت) جهاز Apple Silicon Ultra واحد بذاكرة موحدة 512 جيجابايت:
curl -LsSf https://llama.app/install.sh | sh
llama serve -hf ggml-org/Mistral-Large-4-1T-A52B-GGUF:Q2_K
يذكر Hugging Face حوالي 90 رمزًا في الثانية للتعبئة المسبقة و15 للتوليد على جهاز M3 Ultra واحد: جيد للتجارب الخاصة، بطيء لحلقة وكيل. كما أن التكميم 2-بت يفقد الجودة، لذا اختبره على مهامك الخاصة أولاً.
أخذ العينات الموصى به من Mistral هو temperature=1.0 و top_p=0.95 عند كل مستوى استدلال.
استدعاء النموذج المستضاف ذاتيًا
يكشف كل من vLLM و SGLang عن خادم متوافق مع OpenAI، لذا يبدو الطلب مثل أي إكمال محادثة:
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "mistralai/Mistral-Large-4-1T-A52B",
    "messages": [{"role": "user", "content": "Summarize RFC 9110 section 9 in 5 bullets."}],
    "reasoning_effort": "medium",
    "temperature": 1.0,
    "top_p": 0.95
  }'
على API المستضاف، أرسل نفس النص إلى https://api.mistral.ai/v1/chat/completions مع "model": "mistral-large-4" ومفتاح Bearer. تسرد مستندات خادم vLLM المتوافق مع OpenAI الحقول التي يقبلها.
دع Claude Code يختبر كلا نقطتي النهاية باستخدام Apidog CLI
يفشل النموذج المستضاف ذاتيًا بهدوء: علامة محلل مفقودة تسرب الاستدلال إلى content، أو تعود استدعاء أداة كنص عادي. دع وكيل البرمجة الخاص بك يتحقق من كلا المسارين باستخدام Apidog CLI بدلاً من لصق أوامر curl يدويًا.
قم بإعداده مرة واحدة:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick Claude Code when prompted
ثم أعطِ Claude Code موجهًا واحدًا:
In Apidog project <id>, create two environments: "ml4-self-hosted" with base URL
http://localhost:8000 and "ml4-mistral-api" with base URL https://api.mistral.ai.
Add a POST /v1/chat/completions endpoint and a test case that sends a tool-calling
request with reasoning_effort "low", then asserts status 200, that choices[0].message
has a tool_calls array, and that message.content holds no thinking text.
Run it against both environments and tell me where they differ.
يقرأ الوكيل كل مخطط، ويتحقق من صحة حمولته ويشغل الحالة:
apidog environment create ml4-self-hosted --project <id> --base-url http://localhost:8000
apidog environment create ml4-mistral-api --project <id> --base-url https://api.mistral.ai
apidog cli-schema get endpoint-create
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <selfHostedEnvId> -r cli,json
apidog run --test-case <caseId> --project <id> -e <apiEnvId> -r cli,json
أضف --upload-report لعرض التشغيل في تطبيق Apidog، أو ضع نفس سطر apidog run ... -r junit في CI حتى لا يتم شحن ترقية vLLM باستدعاءات أدوات معطلة. يغطي دليل Apidog CLI في Claude Code الإعداد بمزيد من التفاصيل. تغطي خطة Apidog المجانية ما يصل إلى 4 مستخدمين.
الترخيص: ما يمكنك فعله وما لا يمكنك فعله
ترخيص Mistral Ecosystem Open-Weight هو MIT مع شرط واحد إضافي.
يمكنك: تشغيل ونشر وضبط دقيق وتعديل النموذج ومشتقاته، للاستخدام التجاري وغير التجاري، طالما تحتفظ بإشعار حقوق النشر والإذن في النسخ.
تحتاج إلى ترخيص تجاري منفصل من Mistral إذا: قمت بتشغيله كـ "نموذج كخدمة"، والذي يعرفه الترخيص بأنه منح طرف ثالث إمكانية الوصول إلى النموذج أو مشتقاته للاستدلال أو التدريب اللاحق.
لا ينطبق هذا الشرط على: الاستخدام الداخلي، ومنتجات المستخدم النهائي حيث يكون النموذج داخل ميزات أو أطر محددة، ومجرد تمرير الطلبات إلى نموذج يستضيفه شخص آخر، والاستخدام عبر منتجات Mistral الخاصة.
مساعد برمجة داخلي أو ميزة منتج مبنية على النموذج أمر جيد؛ إعادة بيع الاستدلال الخام تحتاج إلى اتفاق. هذا ملخص، وليس نصيحة قانونية.
للحصول على شرح مشابه لنموذج آخر مفتوح الأوزان، راجع دليل استضافة GLM-5.3 ذاتيًا.
هل يجب أن تستضيف بنفسك أم تستدعي API؟
استدعِ API عندما يكون حجمك متواضعًا، أو تريد سياق 1 مليون دون ضبط حدود الخادم، أو لا تشغل بالفعل عقد 8 وحدات معالجة رسومات. بسعر 0.70 دولار إدخال و2.10 دولار إخراج لكل مليون رمز، فإن 100 مليون رمز إدخال بالإضافة إلى 20 مليون رمز إخراج شهريًا تصل إلى 112 دولارًا، قبل أي خصم تخزين مؤقت.
استضف بنفسك عندما لا يمكن لبياناتك مغادرة شبكتك، أو عندما تريد امتلاك ضبط دقيق (يعرض Hugging Face تدريب LoRA مع TRL على عقدة 8x B300)، أو عندما يُبقي الحجم الثابت العقدة مشغولة. خدمة Mistral’s Forge هي الخيار المُدار للضبط على بياناتك الخاصة.
الأسئلة الشائعة
هل أوزان Mistral Large 4 المفتوحة مجانية للتنزيل؟
نعم. كلا المستودعين الرسميين على Hugging Face غير محميين ببوابات، لذا يمكنك تنزيلهما دون طلب الوصول. التكلفة هي تشغيلها: نقطة تفتيش FP8 الرسمية حوالي 1,061 جيجابايت وتستخدم أمثلة التقديم 8 وحدات معالجة رسومات لمراكز البيانات.
هل يمكنني تشغيل Mistral Large 4 على وحدة معالجة رسومات واحدة؟
لا توجد وصفة رسمية تغطي وحدة معالجة رسومات واحدة. يستخدم كل مثال vLLM و SGLang و Transformers 8 وحدات معالجة رسومات مع توازي الموترات. أصغر إعداد موثق هو llama.cpp مع تكميم Q2_K بحجم 381 جيجابايت على جهاز Apple Silicon Ultra واحد بذاكرة موحدة 512 جيجابايت.
هل Mistral Large 4 مفتوح المصدر؟
إنه مفتوح الأوزان، وليس مفتوح المصدر بمعنى OSI. تحصل على الأوزان بموجب ترخيص MIT معدل يسمح بالاستخدام التجاري، لكن تقديم النموذج لأطراف ثالثة كخدمة استدلال أو تدريب لاحق يحتاج إلى ترخيص تجاري منفصل من Mistral.
هل نموذج الأوزان المفتوحة هو نفسه نموذج API؟
تقول Mistral إن نقطة التفتيش الصادرة حصلت على ثلاثة أسابيع إضافية من التعلم المعزز بعد معاينة 6 أكتوبر، ويقدم API النموذج المحدث باسم mistral-large-4. تغيرت أنماط الاستدلال أيضًا: استخدم low أو medium أو high.
كم تكلفة Mistral Large 4 API؟
تدرج Mistral 0.70 دولار لكل مليون رمز إدخال، و0.07 دولار لكل مليون رمز إدخال مخزن مؤقتًا، و2.10 دولار لكل مليون رمز إخراج، اعتبارًا من 2 نوفمبر 2026.