
عندما يفشل وكيل صوتي في مكالمات حقيقية، فإن السبب غالبًا ليس النموذج اللغوي (LLM) ولا الصوت نفسه. تبدأ المشكلة بخطوة سابقة، في الصوت الذي يسمعه الوكيل، سواء كان يُوجَّه إلى نموذج تحويل الكلام إلى نص (STT) أو مباشرةً إلى نموذج تحويل الكلام إلى كلام. تتعامل نماذج STT الحديثة مع ضوضاء المرور والمكيفات بشكل جيد. ما لا تستطيع معالجته هو شخص ثانية يتحدث: زميل عمل، أو تلفاز، أو الوكيل الجالس على المكتب المجاور في مركز الاتصال. يستمع النموذج إلى هذه الأصوات أيضًا، فيتصرف الوكيل بناءً على كلمات لم ينطق بها المتصل أبدًا.
تجلس تقنية Krisp Voice Isolation أمام نموذج STT وتزيل كل الأصوات ما عدا صوت المتحدث الرئيسي. في هذا المراجعة، قرأت معايير الأداء والوثائق الخاصة بـ Krisp، وسجّلت في واجهة الـ API ذاتية الخدمة، ثم شغّلت ثمانية تسجيلات حقيقية من مجموعة البيانات العامة لـ Krisp عبرها. بعد ذلك، أجريت تفريغًا نصيًا للصوت قبل المعالجة وبعدها باستخدام نموذج STT مفتوح المصدر لأرى ما الذي تغيّر فعليًا.
الخلاصة المختصرة: إذا كان وكيلك يستقبل مكالمات من مكاتب أو منازل أو مراكز اتصالات أو أي مكان يوجد فيه حديث في الخلفية، فإن Voice Isolation تستحق الإضافة إلى مسار المعالجة الخاص بك. في اختباري، انخفض حديث الخلفية الذي كان يتحول إلى 331 كلمة في التفريغ النصي المزيّف إلى الصفر. أما المقايضات فهي حقيقية لكنها صغيرة: تكلفة بسيطة على صوت الهاتف النظيف، ومنطقة API تقتصر على الولايات المتحدة، ونماذج أقل في الـ API مقارنة بالـ SDK.
المشكلة: أصوات في الخلفية، لا ضوضاء في الخلفية
تُدرَّب نماذج التعرف على الكلام (STT) على التقاط الكلام، لا على تحديد أي الكلام يستحق الاهتمام. فالضوضاء يمكن تصفيتها لأنها لا تشبه الكلام، أما صوت شخص ثانٍ فيبدو تمامًا كالكلام، لأنه كذلك بالفعل.
المثال الذي تقدمه Krisp معبِّر جدًا: يتصل شخص لطلب إلغاء اشتراك، بينما يسأله زميل قريب عن وجبة الغداء. تُعيد أداة STT تدفقًا واحدًا من الكلمات دون أي إشارة تدل على الكلمات القادمة من المتصل، فيتلقى الوكيل الصوتي كليهما كطلب واحد.
وهذا يعطِّل عمل الوكيل الصوتي بثلاث طرق:
- نصوص خاطئة. تدخل كلمات الشخص المجاور في النص المكتوب، فيجيب النموذج اللغوي (LLM) عن أشياء لم يذكرها المتصل أبدًا.
- مقاطعات كاذبة. يسمع الوكيل صوت الشخص المجاور، فيظن أن المتصل يقاطعه، فيتوقف عن الكلام في منتصف الجملة.
- خلل في تبادل الأدوار. يبدو الكلام في الخلفية وكأن المتصل ما زال يتحدث، فلا يستطيع الوكيل تمييز متى انتهى دوره.
في كل هذه الحالات، يعمل منطق الوكيل كما صُمم له تمامًا. المشكلة أنه يستجيب لصوت ما كان ينبغي أصلًا أن يسمعه.
الأرقام تكشف حجم هذه الفجوة. ففي اختبار إطلاق Voice Isolation 2.5 من Krisp، سجَّل 10 أنظمة STT متوسط خطأ في الكلمات (WER) نسبته 2.10% على تسجيلات صوتية نظيفة لمتحدث واحد. لكن مع وجود شخص ثانٍ يتحدث فوق صوت المتصل، ارتفع المتوسط لدى الأنظمة نفسها إلى 35.92%. وكبح الضوضاء لا يسدّ هذه الفجوة، لأن التشويش هنا هو كلام بشري.
ما هو Krisp Voice Isolation
يزيل Krisp Voice Isolation API & SDK الأصوات الخلفية والضوضاء من تدفق الصوت المباشر ويمرّر صوت المتحدث الرئيسي فقط. وهو مصمم خصيصًا لوكلاء الذكاء الاصطناعي الصوتيين، وهو نفس التقنية الأساسية التي تقدمها Krisp للمكالمات البشرية تحت اسم Background Voice Cancellation (BVC).
يأتي هذا النموذج في مقدمة خط معالجة الوكيل (pipeline)، بحيث يسمع كل نموذج بعده صوتًا واحدًا فقط:
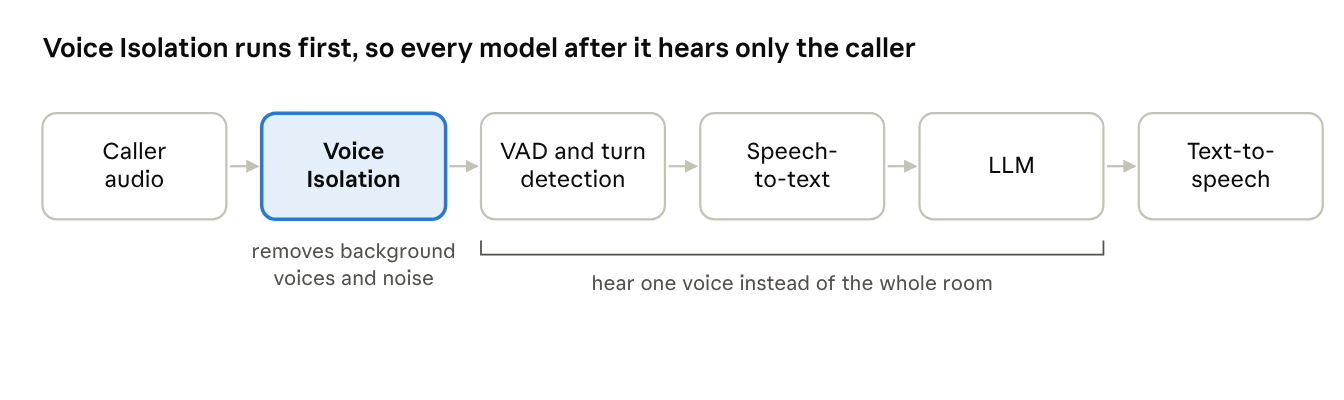
موقع Voice Isolation في خط معالجة وكيل صوتي
وهذا الموقع بالذات هو ما يهم. فبدونه، يلتقط كل من VAD واكتشاف الأدوار صوت الشخص الموجود في الخلفية أيضًا، وهو ما يسبب المقاطعات الخاطئة.
قضت Krisp نحو تسع سنوات في مجال الذكاء الاصطناعي الصوتي، وتقول إنها تعالج أكثر من تريليون دقيقة صوتية سنويًا. يُعد Voice Isolation أحد المنتجات ضمن تشكيلة voice AI API وSDK الخاصة بها. كما أن Voice Isolation جزء من VIVA، وهي مجموعة النماذج اللحظية الخاصة بـ Krisp لوكلاء الصوت، إلى جانب Turn-Taking وInterrupt Prediction وVAD. وهو يعمل بالتكامل مع ميزة turn-taking بدلًا من استبدالها.
تمنحك النماذج الأربعة تحكمًا في مدى قوة إزالة الأصوات الخلفية والضوضاء. عند أقصى قوة (الإعداد الافتراضي)، يزيل نموذج Default أكبر قدر منها. أما Balanced فيعالج الصوت الرئيسي بدرجة أخف مع نفس القدرة الحاسوبية. ويستهلك Lite نحو ثلث القدرة الحاسوبية التي يستهلكها Default. أما HD فهو مخصص لتدفقات WebRTC بتردد 32 كيلوهرتز بدلًا من الصوت الهاتفي. درجة القوة إعداد قابل للضبط أثناء التشغيل دون تغيير القدرة الحاسوبية؛ وفي واجهة API يُمثَّل بالمعامل suppression_level الذي يتراوح من 0 إلى 100.
من القيود التي يجدر معرفتها مسبقًا: تفترض نماذج إزالة الأصوات أن المتحدث قريب من الميكروفون. وكدليل تقريبي، قد يُكبح صوت المتحدث الرئيسي نفسه عند تجاوز المسافة نحو 30 سم. هذه ليست قاعدة صارمة، بل توصية عامة، إذ تعتمد المسافة الفعلية على الظروف الصوتية. أما للأجهزة ذات المدى البعيد مثل مكبرات الصوت الذكية، فتقدم Krisp نموذجًا منفصلًا يزيل الضوضاء فقط.
صدرت الإصدار 2.5 في أغسطس 2026، ونشرت Krisp معيار قياس مفتوحًا ومجموعة بيانات في سبتمبر. أصبح النموذج متاحًا الآن كواجهة API ذاتية الخدمة وكذلك كحزمة تطوير SDK.
ماذا تُظهر مقاييس Krisp القياسية؟
في المقياس القياسي المفتوح من Krisp، خفّضت ميزة Voice Isolation متوسط معدل أخطاء الكلمات من 23.24% إلى 6.24%، أي بتحسّن نسبته 73%.
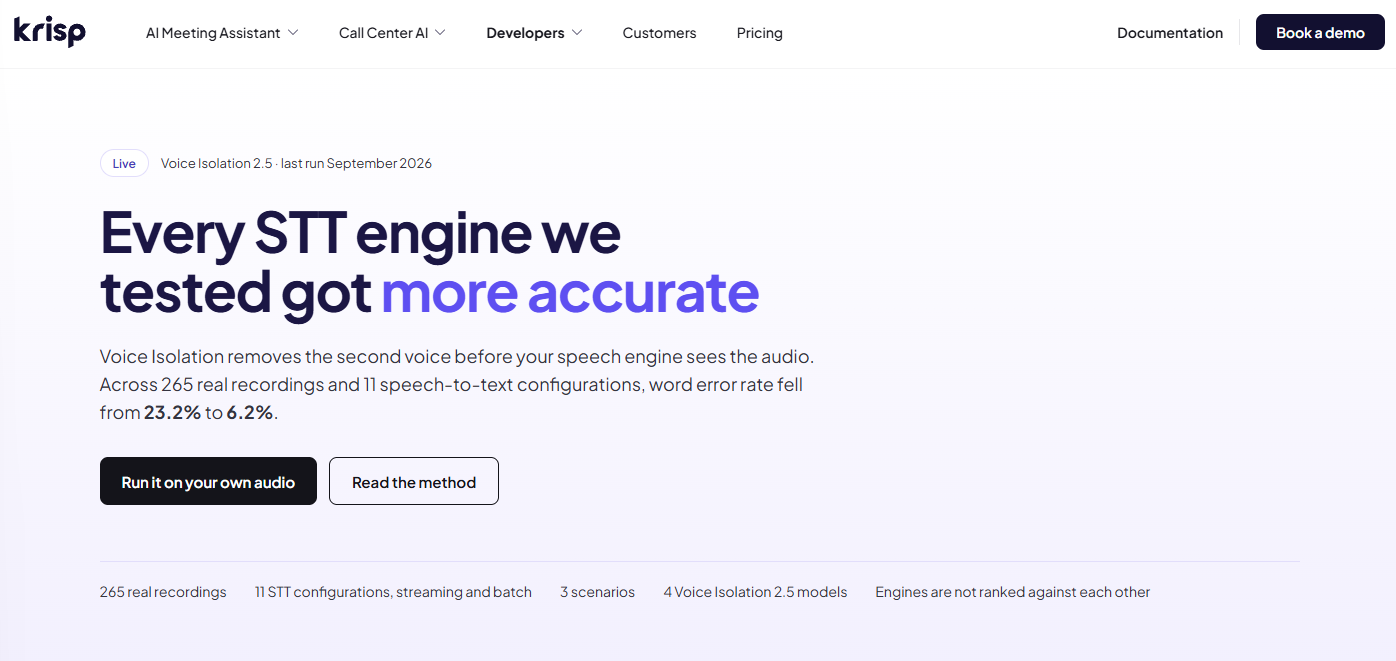
تعرض صفحة المقاييس القياسية من Krisp ملخص النتيجة الرئيسية.
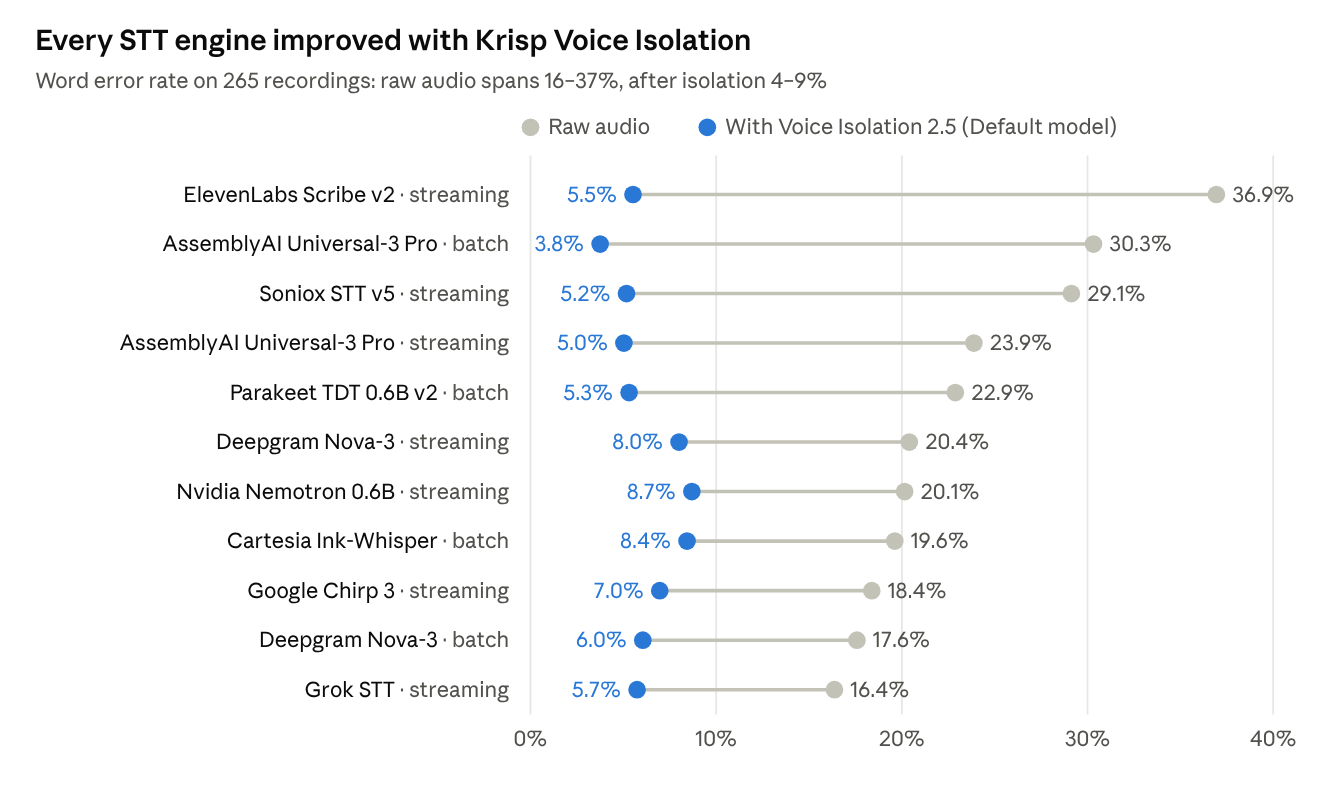
يعتمد المقياس القياسي على 265 تسجيلاً حقيقياً من المكاتب والمنازل وأربعة طوابق عاملة في مراكز الاتصال والسيارات. لم يُحاكَ أي منها ولم تُضِف إليه أصوات لاحقاً. تتبع معظم التسجيلات السيناريو نفسه: المتحدث الرئيسي يتحدث، ثم ينضم شخص ثانٍ، ويصمت المتحدث الرئيسي بينما يواصل الآخر الكلام، ثم يعود المتحدث الرئيسي من جديد. تلك النافذة الصامتة هي الاختبار الحقيقي، لأن النص الصحيح المقابل لها فارغ. تم تمرير كل ملف عبر 11 إعداداً من إعدادات STT تنتمي إلى تسعة محركات، مع عزل الصوت وبدونه.
المصدر: مقياس Krisp القياسي لعزل الصوت، أكتوبر 2026 · 11 إعداد STT، جميع السيناريوهات مجمّعة
تحسّن كل المحرك ولم يسوء أي منها. النتيجة الأكثر فائدة هي ما يحدث للفجوة بين المحركات: على الصوت الخام يبلغ عرضها نحو 20 نقطة، وبعد العزل تتقلص إلى نحو 5 نقاط. إذا كان وكيلك الذكي يلتقط أصواتاً في الخلفية، فإن تنقية المدخل تحسّن معدل WER لديك أكثر مما يفعله اختيار مزوّد STT مختلف.
حسب السيناريو، يعتمد حجم التحسّن على ما إذا كان هناك صوت ثانٍ موجود:
حالات لا تفيد فيها الأداة
تنشر Krisp نقاط ضعفها علنًا، وأعتقد أن هذا هو الجزء الأكثر إقناعًا في التقرير.
- الصوت النظيف من الهاتف يصبح أسوأ قليلًا. في غياب صوت ثانٍ تُزال، لا يمكن للعزل أن يمس سوى الصوت الرئيسي. ارتفع معدل WER في المكالمات الهاتفية من 3.48% إلى 3.91%، وتراجع ملف واحد من 9.42% إلى 21.65%. يحقق نموذج Balanced أفضل نتيجة هنا بنسبة 3.53%.
- الصدى الشديد لا يزال مشكلة قائمة. في اختبار إصدار 2.5 المنفصل، سجّلت التسجيلات أحادية المتحدث ذات الأجواء الصوتية الصعبة نسبة 11.61% مع العزل مقابل 8.02% بدونه. هذا تحسن كبير مقارنة بالإصدار 2.1 (15.42%)، لكنه لا يزال أسوأ من عدم استخدام العزل إطلاقًا.
- العزل المفرط يتسبب في أخطاء صامتة. توضح Krisp أن النماذج السابقة كانت تزيل أحيانًا أجزاءً من الصوت الرئيسي. لا يزال الإنسان قادرًا على فهم الصوت، لكن نظام تحويل الكلام إلى نص كان يسقط جملًا كاملة، فتظهر النسخة المكتوبة سليمة الظاهر لكن فيها فراغات. تم ضبط الإصدار 2.5 لصالح أنظمة STT وليس للأذن البشرية لمعالجة هذه المشكلة.
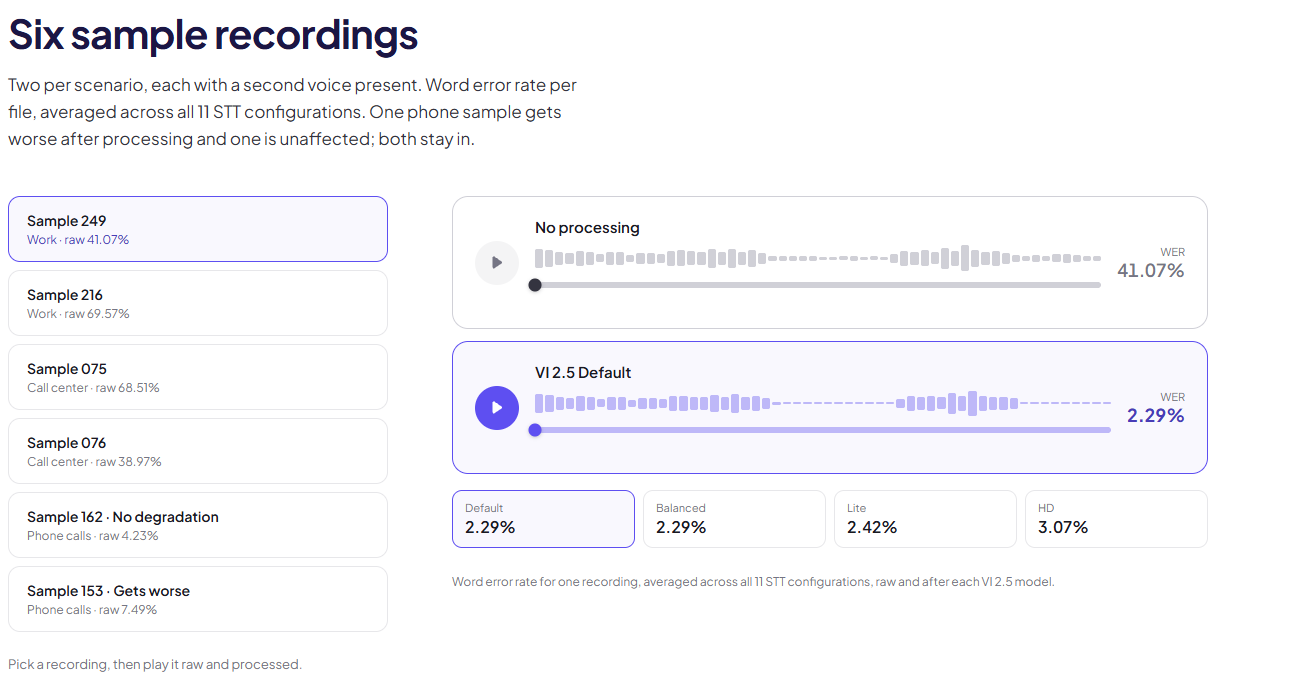
تتيح لك صفحة الاختبار المعياري الاستماع إلى ستة تسجيلات خام ومعالجة. العينة 153، وهي مكالمة هاتفية، مصنفة بعنوان "تزداد سوءًا".
هناك نقطتان أخريان يجب مراعاتهما. نسبة 73% ونسبة 46.4% اللتين ستراهما على موقع Krisp مأخوذتان من اختبارين مختلفين: 265 تسجيلًا في الاختبار المعياري المفتوح، و1,685 تسجيلًا في اختبار إصدار 2.5. كما أن نتائج Krisp تقارن الصوت مع عزلها الخاص وبدونه، ولا تقارنها مع منتجات العزل الخاصة بشركات أخرى.
التسجيلات، والنسخ المكتوبة يدويًا، وتصنيفات المقاطع، ومخرجات كل نموذج هي متاحة للعموم على Hugging Face، ليمكن لأي شخص إعادة إجراء الاختبار. وهذا ما فعلته بعد ذلك.
تجربة عملية: اختبار واجهة Voice Isolation API
في اختباري، أزالت ميزة Voice Isolation كل كلمة من كلام الخلفية في النصوص المستخرجة، وانخفض معدل WER الإجمالي من 40.1% إلى 10.2%.
الإعداد
التسجيل في بوابة المطورين (Developers Portal) سريع، مع إمكانية الدخول عبر Google أو Microsoft أو البريد الإلكتروني. منحني الفترة التجريبية رصيدًا قدره 30 دولارًا وحدًا من جلستين متزامنتين. بعد ذلك، انتقل إلى API Keys → Create key وستحصل على مفتاح يمكنك نسخه مرة واحدة فقط.
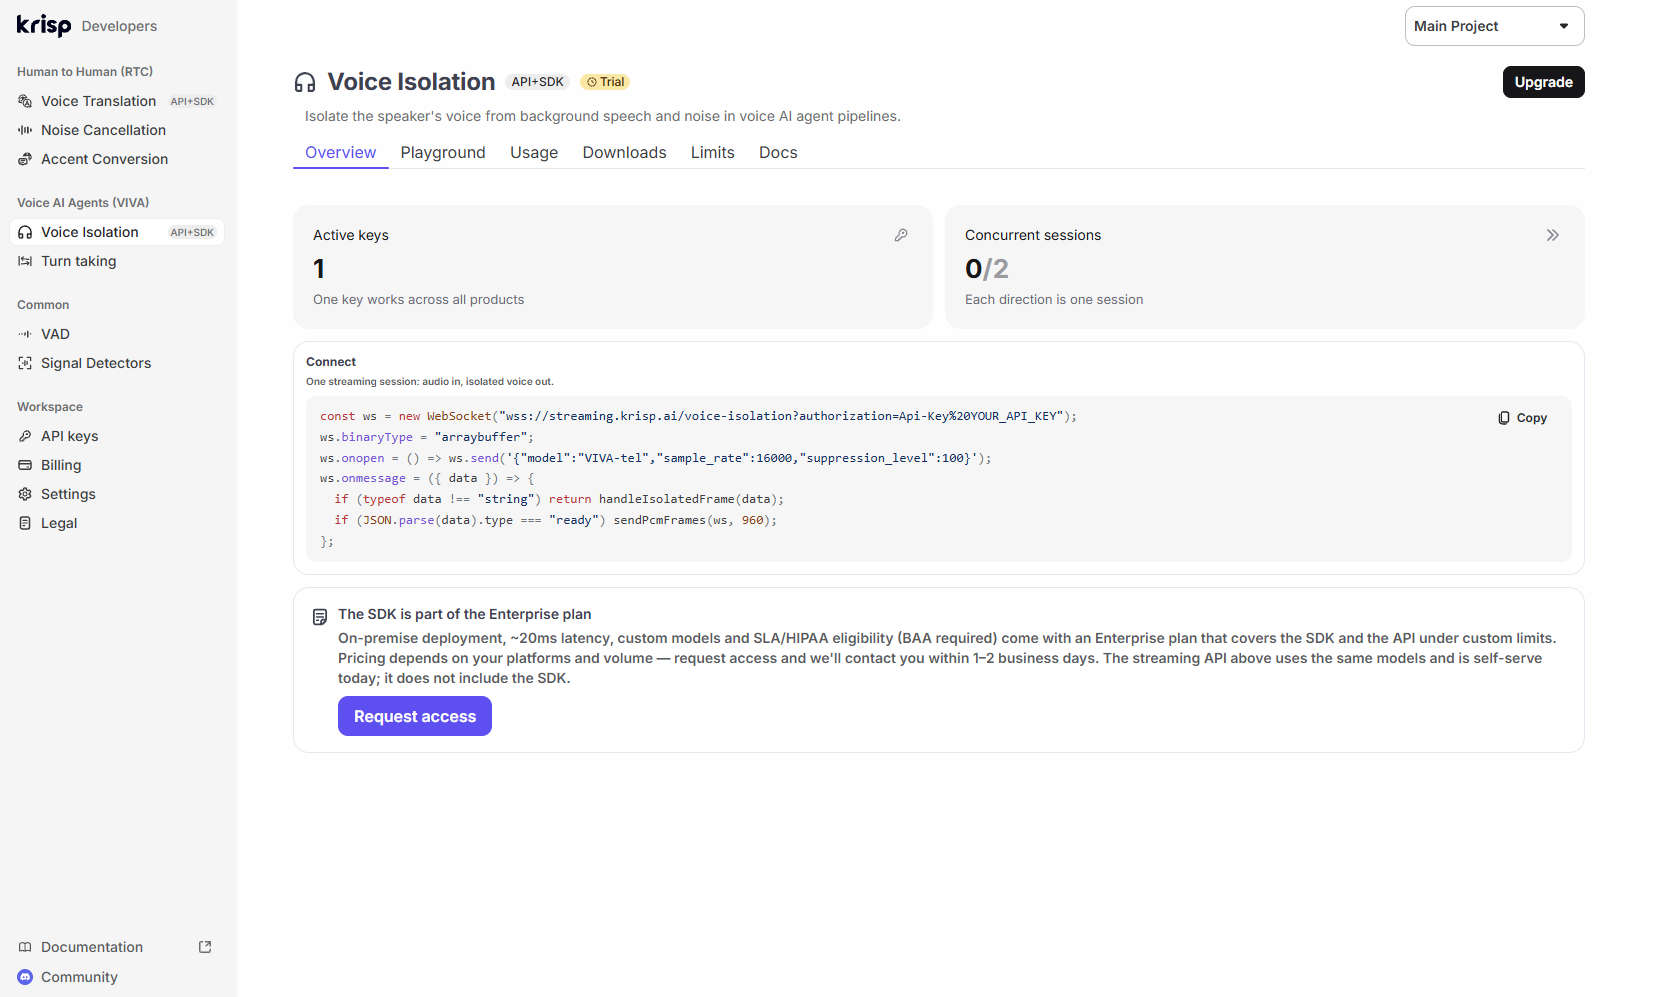
صفحة Voice Isolation في بوابة المطورين ضمن الخطة التجريبية.
مفتاح API الذي أنشأته لهذه المراجعة. يعمل مفتاح واحد عبر جميع منتجات Krisp API، بما في ذلك واجهة Voice Translation API. .
الواجهة تعتمد على WebSocket. يستبدل خادمك الخلفي مفتاح API برمز جلسة قصير الأجل، ويرسل العميل رسالة ترحيب JSON صغيرة، وينتظر إشارة ready، ثم يبث صوتًا بصيغة PCM أحادية القناة بدقة 16 بت ويستقبل الصوت المنقّى إطارًا بإطار:
URL = "wss://streaming.krisp.ai/voice-isolation"async with websockets.connect(URL, additional_headers={"Authorization": f"api-key {session_token}"}) as ws: await ws.send(json.dumps({"model": "VIVA-tel", "sample_rate": 16000, "suppression_level": 100})) hello = json.loads(await ws.recv()) # {"type": "ready", ...} # then send exactly 30 ms of audio per message (960 bytes at 16 kHz) # and write each binary message you receive to your output
هذا قريب من دليل البدء السريع لواجهة API من Krisp، وهو سكربت Python قصير ينظّف ملف WAV. هناك قاعدة واحدة تُوقع الكثيرين في الخطأ: يجب أن تكون كل رسالة صوتية بمقدار 30 مللي ثانية بالضبط. أي شيء آخر يُنهي الجلسة بخطأ invalid_frame_duration، لذا املأ الإطار الأخير بصمت.
لاختبار الأداء، اخترت ثمانية تسجيلات من مجموعة البيانات العامة الخاصة بـ Krisp: ثلاثة تسجيلات من مكتب، وثلاثة من أرضية مركز اتصال، ومكالمتان هاتفيتان من داخل سيارة، بإجمالي حوالي 11 دقيقة. بثت كل تسجيل عبر الواجهة بسرعة الوقت الحقيقي، من آسيا. ثم نُزنت الصوت الخام والمنقّى باستخدام محرك NVIDIA مفتوح المصدر Parakeet TDT 0.6B v2، وهو أحد المحركات المستخدمة في معيار Krisp المرجعي، وقارنت كل مقطع مُصنَّف بالنصوص البشرية المرجعية.
النتائج
جاءت جميع التحسينات تقريبًا من مكان واحد: المقاطع التي كان فيها المتحدث الرئيسي صامتًا واستمر شخص آخر بالكلام. على الصوت الخام، حوّل Parakeet ذلك الكلام الخلفي إلى 331 كلمة في النص. أما بعد تطبيق Voice Isolation، فلم تنتج أي كلمات. كان صوت الخلفية أخفض بمقدار 13 إلى 34 ديسيبل في تلك المقاطع، بينما بقي مستوى المتحدث الرئيسي شبه ثابت (بفارق لا يتجاوز 1 ديسيبل).
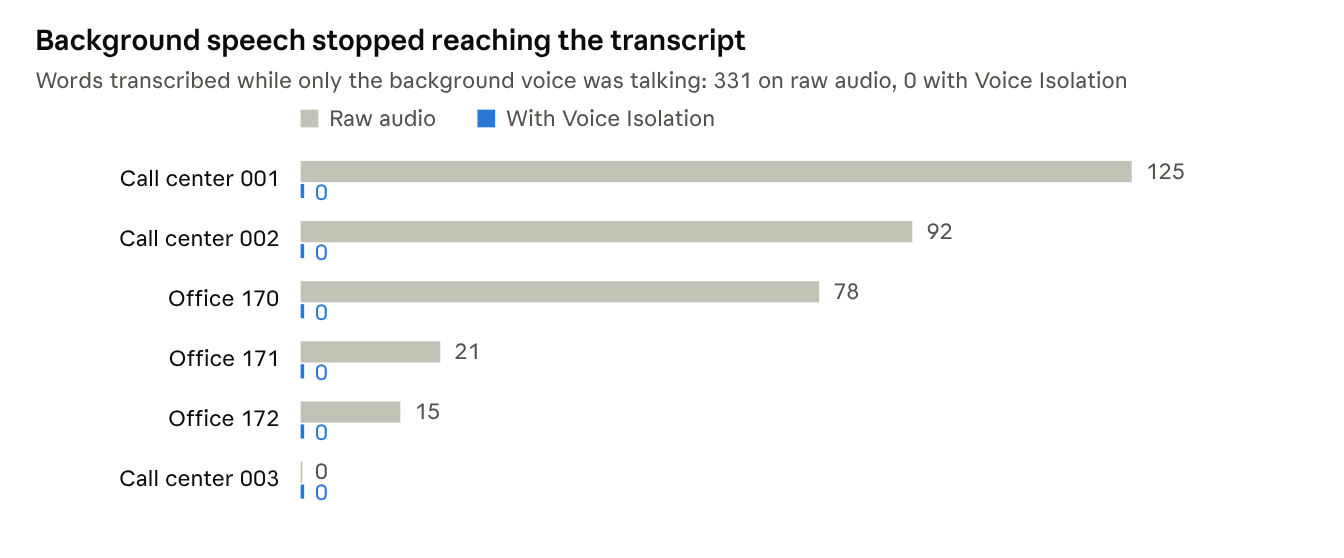
اختباري · واجهة Krisp API (VIVA-tel)، منسوخ نصيًا عبر Parakeet TDT 0.6B v2 · التسجيلات الست التي تحتوي على مقطع يضم صوت الخلفية فقط
يُظهر مثال مركز الاتصال الهاتفي سبب أهمية هذا الأمر. أثناء توقّف الموظف الذي كنت أختبره، كان الموظف على المكتب المجاور منشغلًا بمكالمة أخرى. التقط النص الخام تلك المكالمة كلمة بكلمة:
thank you for calling meridian bank before i begin i will need to confirm your identity for security could you give me your full name your date of birth...
سيتعامل وكيل الصوت مع ذلك على أنه كلام المتصل. أما مع Voice Isolation، فقد عاد المقطع نفسه فارغًا تمامًا.
عندما تحدث الشخصان في آن واحد، كان التغيير طفيفًا: 13.2% على الصوت الخام مقابل 12.5% بعد التنظيف. كان Parakeet يفضّل أصلًا الصوت الأعلى والأقرب في تلك المقاطع. معظم الأخطاء المتبقية هناك سببها تنسيق الأرقام في طريقة تقييمي (أرقام الهواتف، الأسعار، الرموز البريدية)، وهي أخطاء أثّرت على النسختين بالقدر نفسه.
في المكالمتين الهاتفيتين النظيفتين، أضاف ملف واحد خطأً إضافيًا بينما خفّض الآخر خطأين. وهذا يتماشى مع ما توصلت إليه Krisp من أن التكلفة على الصوت النظيف ضئيلة.
زمن الاستجابة والموثوقية من خارج الولايات المتحدة
تعمل الواجهة البرمجية حاليًا في منطقة الولايات المتحدة فقط، وتحذّر وثائق Krisp من أن العملاء في مناطق أخرى سيعانون من زمن استجابة إضافي. من آسيا، تراوح زمن الرحلة ذهابًا وإيابًا للإطار (من الإرسال حتى عودة الصوت المنظّف) بين 260 و520 مللي ثانية حسب الجلسة، واستغرقت عملية إعداد الجلسة عادةً ما بين 1.5 و3 ثوانٍ. السبب هنا هو بُعد الشبكة، لا النموذج نفسه: فـKrisp تشير إلى زمن استجابة خوارزمي يبلغ 15 مللي ثانية. لكن إذا كان وكيلك يخدم مستخدمين بعيدين عن الولايات المتحدة، فستشعر بهذا التأثير، وتشغيل الـSDK على خوادمك الخاصة يتجنّبك ذلك.
انقطعت إحدى جلساتي التسع بعد نحو 70 ثانية بسبب إغلاق غير طبيعي. وأعدت تشغيلها فنجحت. أرجّح أن يكون السبب هو المسار الطويل من آسيا وليس الخدمة ذاتها، لكنه تذكير بضرورة معالجة إعادة الاتصال في بيئة الإنتاج.
حول هذا الاختبار: ثمانية ملفات هي عينة صغيرة وليست معيار قياس مرجعيًا. أعدت أخذ عينات التسجيلات ذات 32 كيلوهرتز إلى 16 كيلوهرتز لتتناسب مع نموذج الاتصال الهاتفي (VIVA-tel)، واستخدمت محرك STT واحدًا، واعتمدت توحيدًا بسيطًا للنص، لذا فإن أرقامي المطلقة غير قابلة للمقارنة بأرقام Krisp. ما تحققت منه هو اتجاه التغيير وحجمه، وقد تطابق ذلك مع ما تُبلغ عنه Krisp.
تجربة المطوّر: API أو SDK
يتوفّر Voice Isolation بطريقتين، وأيهما يمكنك استخدامه يعتمد على خطتك.
واجهة API هي الطريقة الأسهل للبدء: لا حاجة لشحن ملفات نماذج ولا شيء لتشغيله على معالجك. لكن المقايضة هنا هي أن صوتك يُرسَل إلى سحابة Krisp، وأنك تحصل على نموذجين بدلًا من أربعة: VIVA-tel للصوت الهاتفي بتردد 8 أو 16 كيلوهرتز، و VIVA-pro للصوت واسع النطاق بتردد 32 كيلوهرتز. النموذج VIVA-pro غير مدرج بعد في مرجع الـ API، لكنه متوفر في Playground الخاص بالبوابة، وقد قبلته الـ API في اختباري، وقد أكدت Krisp توفره.
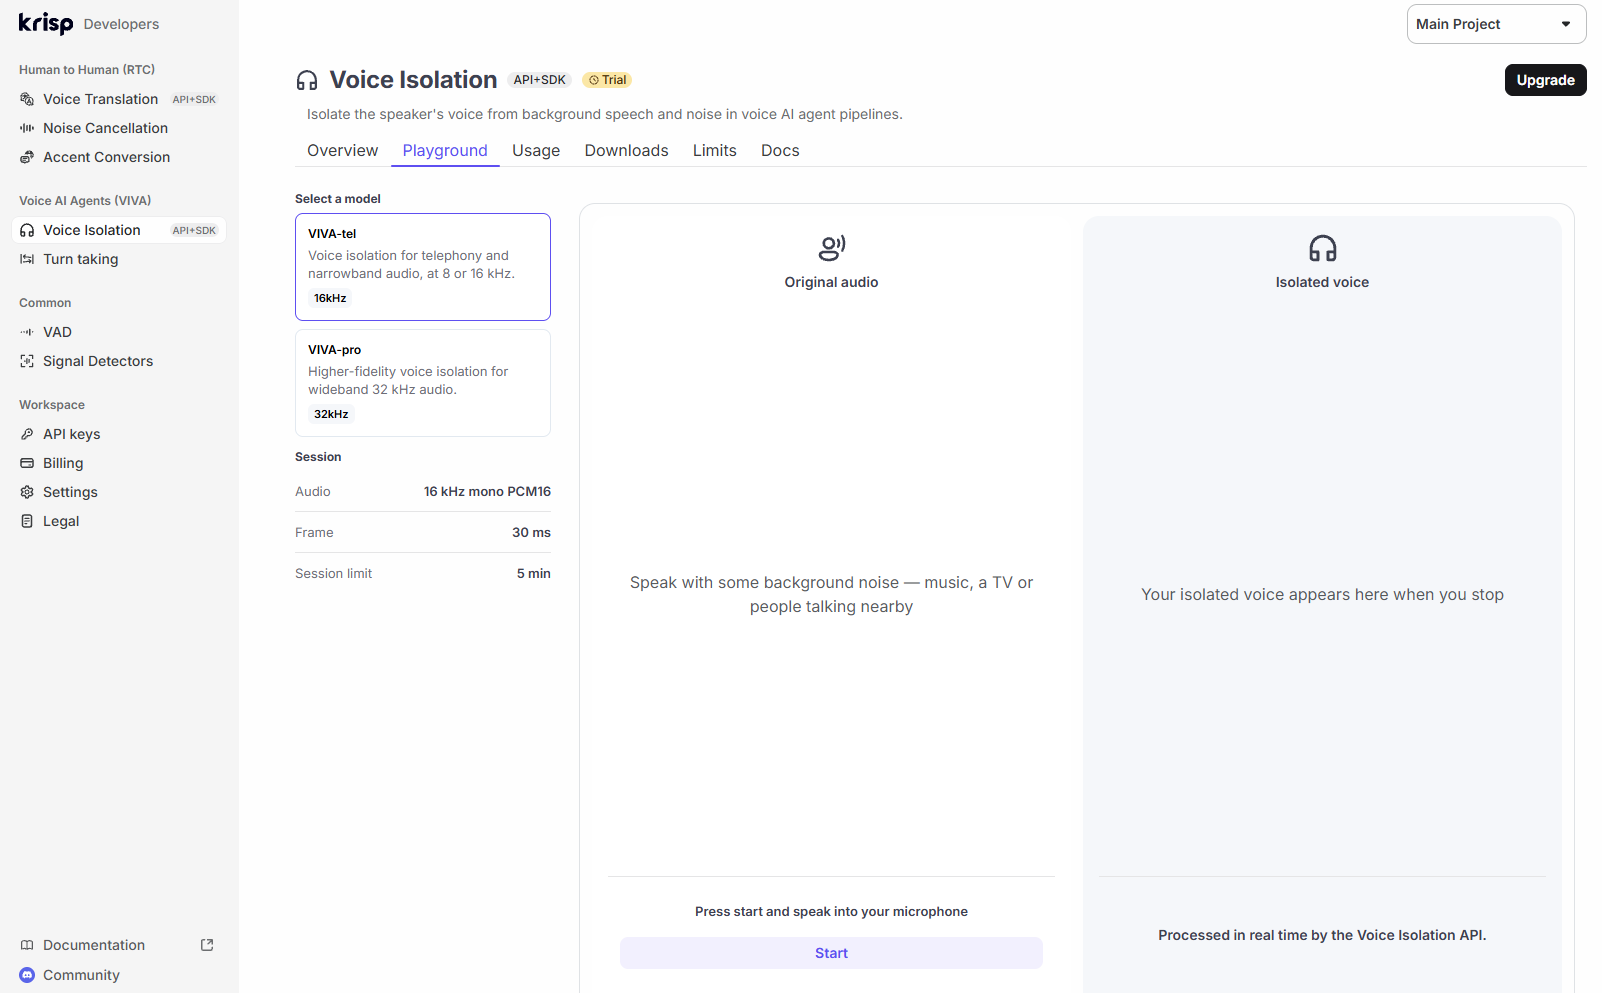
يتيح لك Playground في البوابة تجربة أيٍّ من نموذجي الـ API باستخدام الميكروفون الخاص بك قبل كتابة أي كود.
أما الـ SDK فيبقي الصوت على خوادمك الخاصة ولا يتصل بالإنترنت إلا للتحقق من رخصته. وهنا أيضًا تصبح قصة التكلفة مثيرة للاهتمام. يبيّن منشور Krisp حول المعالجات المركزية أن خيارًا واحدًا في الـ SDK باسم enableLowPrecisionExecution يضاعف تقريبًا عدد المكالمات التي يمكن للخادم تنظيفها على المعالجات التي تدعم FP16. فقد انتقلت نسخة AWS Graviton3 ذات 16 نواة vCPU من 76 مكالمة مباشرة إلى 137، ويستوعب النموذج الخفيف Lite ما يقارب ثلاثة أضعاف عدد التدفقات مقارنةً بالنماذج الكاملة. أما على رقائق Intel Ice Lake الأقدم فلا يكون لهذا الخيار أي تأثير.
التكاملات
- Pipecat توفّر فلترًا جاهزًا. تضيف KrispVivaFilter() كفلتر لإدخال الصوت على الـ transport الخاص بك، ويمكنك إقرانها مع KrispVivaTurn لكشف تبادل الأدوار في الحديث. لاحظ أنها تستخدم الـ SDK، لذا ستحتاج إلى وصول الـ SDK وملفات النماذج، وليس مجرد مفتاح API.
- LiveKit تقدم نماذج Krisp في LiveKit Cloud، بما في ذلك إلغاء صوت الخلفية للوكلاء (noise_cancellation.BVC()). وتفرض LiveKit رسومًا إضافية مقابل نماذج عزل الصوت الخاصة بها.
- مسارات WebRTC والهاتفية يمكنها استخدام الـ SDK مباشرةً، كما تعمل الـ API مع أي شيء يستطيع فتح WebSocket.
الوثائق واضحة ومحدَّثة. نجح الدليل السريع من المحاولة الأولى، ورسائل الخطأ تخبرك بدقة ما الذي حدث خطأً، حتى بما في ذلك حجم الإطار المتوقع والمُستلَم. شكواي الوحيدة هي في التسمية: المنشور يتحدث عن Default وBalanced وLite وHD، بينما تستخدم تنزيلات الـ SDK أسماء ملفات مثل krisp-viva-vi-tel-v2.5.1، وتسمّي الـ API نماذجها VIVA-tel وVIVA-pro، مع وجود الأول فقط في مرجع الـ API. وجود جدول مطابقة في الوثائق سيساعد كثيرًا.
الأسعار
تُحتسب فاتورة الـ API بناءً على ساعات الصوت، وهو رخيص بما يكفي بحيث لا يكون السعر عاملاً حاسمًا في قرار استخدامك له.
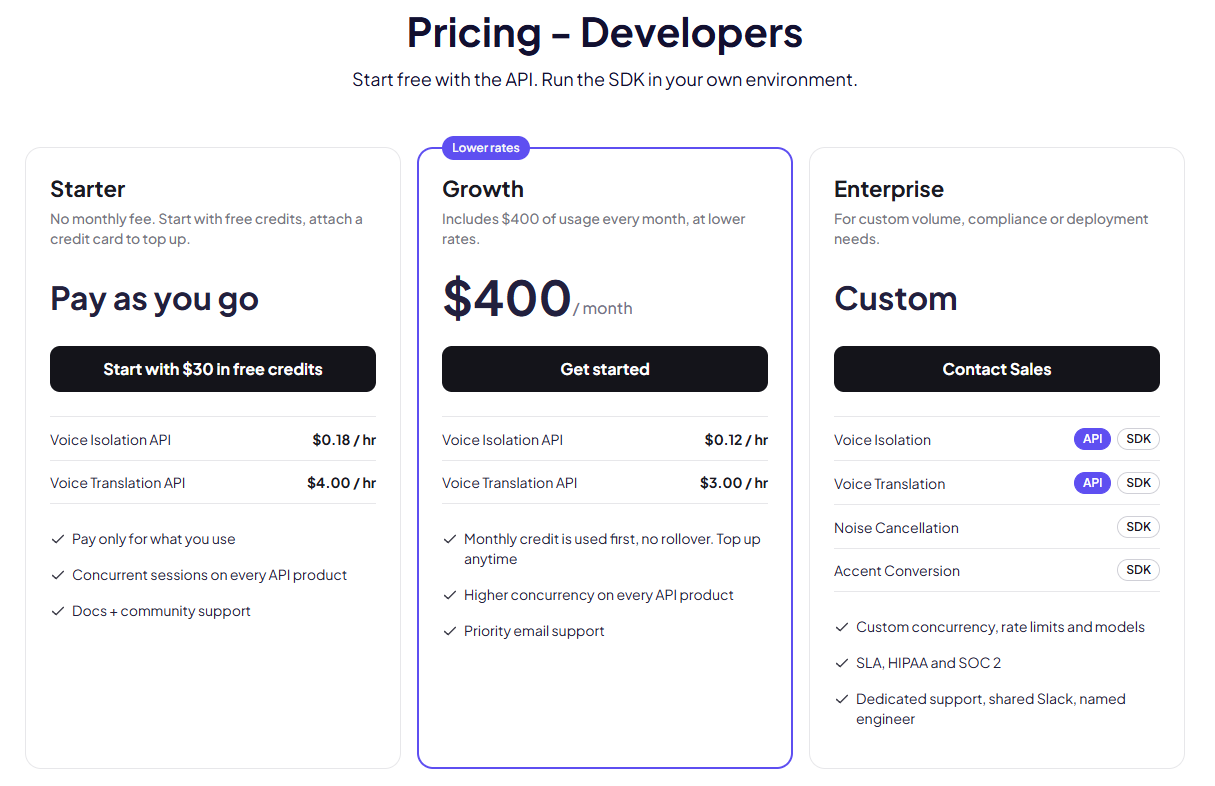
أسعار Krisp للمطورين، نوفمبر 2026.
في خطة Starter ذات الدفع حسب الاستخدام، تبلغ تكلفة واجهة Voice Isolation API حوالي 0.18 دولار لكل ساعة صوت، دون أي رسوم شهرية. والسعر هو نفسه لكلا نموذجي الـ API، أي VIVA-tel وVIVA-pro. أما خطة Growth فتكلّف 400 دولار شهريًا وتشمل رصيد استخدام بقيمة 400 دولار، وتخفض السعر إلى 0.12 دولار للساعة، مع دعم متزامن أعلى ودعم ذي أولوية. أما خطة Enterprise فسعرها مخصص، وهي الخطة الوحيدة التي تتضمن الـ SDK واتفاقية مستوى خدمة (SLA) والامتثال لمعايير HIPAA وSOC 2.
يغطي رصيد البداية البالغ 30 دولارًا حوالي 166 ساعة من الصوت بسعر خطة Starter، وهو ما يكفي تمامًا للاختبار. صلاحية الرصيد 12 شهرًا، ويُحتسب الاستخدام بالدقائق. وللمقارنة، تنظيف مكالمة مدتها 5 دقائق يكلّف حوالي 1.5 سنت على خطة Starter.
الـ SDK متوفر فقط ضمن خطة Enterprise وبسعر متفق عليه، لذا ستحتاج إلى التواصل مع فريق المبيعات إذا أردت تشغيل النماذج على خوادمك الخاصة. الأسعار مأخوذة من صفحة أسعار Krisp، وتم التحقق منها في نوفمبر 2026.
البدائل المتاحة
Krisp ليس الخيار الوحيد لإزالة الأصوات الخلفية، لكن لا توجد حتى الآن أي اختبارات مقارنة مستقلة بين هذه المنتجات. كل جهة تنشر أرقامها الخاصة بناءً على بياناتها، لذا تعامل مع الأرقام أدناه بوصفها ادعاءات من الشركات نفسها.
ما يميز Krisp حقًا هو الأدلة والبراهين. فهي المورد الوحيد هنا الذي يوفر معيار قياس مفتوحًا وقابلًا لإعادة الإنتاج يغطي 11 إعدادًا مختلفًا لـ STT، كما ينشر الحالات التي يخسر فيها. وهي أيضًا الأكثر مرونة في النشر: واجهة برمجة تطبيقات سحابية، أو SDK على الخادم، أو مدمجًا في LiveKit وPipecat.
الخلاصة
تقنية Krisp Voice Isolation هي الحل الذي تلجأ إليه عندما يتعطل أداء وكيل الصوت في المكالمات الحقيقية رغم عمله بشكل ممتاز أثناء الاختبار. فهي تزيل الأصوات التي لا ينبغي للوكيل أن يسمعها، وتعمل مع أي محرك تحويل كلام إلى نص (STT) تستخدمه بالفعل، وتُظهر مقاييس Krisp المعيارية واختباري الخاص الشيء نفسه: كلام الخلفية لم يعد يصل إلى النص المُحوَّل.
الإيجابيات
- تزيل أصوات الخلفية، وليس الضوضاء فقط، وهي المشكلة التي لا يستطيع STT حلّها بمفرده
- تعمل مع أي محرك STT، دون إعدادات لغوية أو تسجيل صوتي مسبق للمتحدث
- تعمل على وحدة المعالجة المركزية (CPU) بتأخير خوارزمي قدره 15 ملّي ثانية
- مقياس معياري مفتوح وقابل لإعادة الإنتاج يشمل حتى الحالات التي تتراجع فيها الأداء
- خدمة API ذاتية مع رصيد مجاني بقيمة 30 دولارًا، وسعر منخفض يتراوح بين 0.12 و0.18 دولار للساعة
- فلتر جاهز لـ Pipecat ودعم لـ LiveKit
السلبيات
- انخفاض طفيف في الدقة على الصوت الهاتفي النظيف، وأداء أقل من الصوت الخام في الغرف ذات الصدى الشديد
- خدمة API متاحة في المنطقة الأمريكية فقط، مما يضيف تأخيرًا ملحوظًا في المناطق الأخرى
- تقدم خدمة API نموذجين فقط مقابل أربعة نماذج في الـ SDK؛ أما الاستخدام داخل المؤسسات فيتطلب SDK للمؤسسات (Enterprise SDK)
لمن هذه الخدمة: الفرق التي تتلقى وكلاؤها مكالمات من مراكز الاتصال أو المكاتب أو المنازل أو السيارات أو أي مكان يتحدث فيه أشخاص آخرون في الجوار. ابدأ بخدمة API لقياس أثرها على تسجيلاتك الخاصة، ثم انتقل إلى الـ SDK إذا احتجت إلى النماذج الإضافية، أو تأخير أقل خارج الولايات المتحدة، أو الإبقاء على الصوت على خوادمك.
من يمكنه الاستغناء عنها: الوكلاء الذين يكون المتصلون معهم شبه دائمًا وحيدين في غرف هادئة، أو الأجهزة بعيدة المدى مثل مكبرات الصوت الذكية، حيث إن نماذج إزالة الأصوات غير مصممة للعمل في هذه البيئات.
يمكنك تجربة واجهة Krisp Voice Isolation API بالأرصدة المجانية وتمرير تسجيلاتك الخاصة عليها خلال بعد ظهيرة واحدة.
الأسئلة الشائعة
هل عزل الصوت هو نفسه إلغاء الضوضاء؟ لا. إلغاء الضوضاء يزيل الأصوات غير الكلامية مثل ضوضاء المرور ولوحات المفاتيح. أما عزل الصوت فيزيل أيضًا أصوات الأشخاص الآخرين، وهي التي يتركها إلغاء الضوضاء كما هي.
هل يعمل Krisp Voice Isolation مع مزود تحويل الكلام إلى نص الخاص بي؟ نعم. فهو يعالج الصوت بنفسه، لذا يعمل أمام أي محرك تحويل كلام إلى نص. اختبرت Krisp المنتج مع 11 تكوينًا، بما في ذلك نماذج Deepgram وAssemblyAI وElevenLabs وSoniox وGoogle وCartesia وNVIDIA. ويمكنه أيضًا العمل أمام نماذج تحويل الكلام إلى كلام. لم تنشر Krisp بعدُ نتائج لهذا الإعداد، لكن لا شيء يمنعك من تجربته.
هل يحل محل اكتشاف تبادل الأدوار في الحوار؟ لا. فهو يعمل قبل VAD واكتشاف تبادل الأدوار ويوفر لهما صوتًا أنظف. توفر Krisp ميزة Turn-Taking كنموذج منفصل ضمن نفس حزمة VIVA SDK.
هل يحتاج المستخدمون إلى تسجيل صوتهم مسبقًا؟ لا. لا يتطلب أي تسجيل مسبق ولا أي تدريب على صوت المستخدم.
كم من زمن التأخير يضيف؟ تشير Krisp إلى زمن تأخير خوارزمي قدره 15 مللي ثانية، وتوضح وثائق الـ SDK أن زمن التأخير المضاف يبلغ حوالي 20 مللي ثانية. مع واجهة API السحابية، يُضاف إلى ذلك زمن الشبكة للوصول إلى منطقة الولايات المتحدة.
هل يعمل على المكالمات الهاتفية؟ نعم. فهو يتعامل مع صوت الهاتفية ذي النطاق الضيق، والترميزات الشائعة مثل G.711 وG.722 وG.729 وOpus، وسماعات الرأس البلوتوث.
وماذا عن المكالمات بين البشر؟ تُتوفر نفس التقنية باسم Background Voice Cancellation (BVC) في حزمة Krisp RTC SDK، التي تعمل على جهاز المستخدم في المتصفحات وتطبيقات سطح المكتب والهواتف المحمولة. أما مراكز الاتصال التي تعتمد على وكلاء بشريين فيحصلون عليه عبر منتج الذكاء الاصطناعي لمراكز الاتصال من Krisp، حيث يمنع أصوات الوكلاء المجاورين من التسرب إلى مكالمات العملاء.
