
وصل Kimi K2.7 Code من Moonshot مع معايير مقارنة بالنموذجين اللذين يدفع معظم المطورين مقابل استخدامهما بالفعل: Claude Opus وGPT-5.5. الخلاصة هي أن النماذج الرائدة المغلقة لا تزال تسجل درجات أعلى في معظم مهام البرمجة، ولكن ليس بالهامش الذي يوحي به سعرها. Kimi هو نموذج مفتوح الوزن يمكنك تنزيله واستضافته ذاتيًا، ويحقق نتائج قريبة جدًا من النماذج التي يمكنك استئجارها فقط.
تضع هذه المقارنة الأرقام جنبًا إلى جنب، وتقارنها بالتكلفة والانفتاح، وتخبرك أيهما تختار لأي مهمة.
ملخص سريع
- جودة البرمجة الخام: يتصدر GPT-5.5 وClaude Opus معظم المجموعات. يتخلف Kimi K2.7 Code ببضع نقاط.
- التكلفة: Kimi أرخص بكثير (0.95 دولار / 4.00 دولارات لكل مليون رمز مميز) ومجاني للاستضافة الذاتية. تكلف النماذج المغلقة أكثر ولا يمكن استضافتها على أجهزتك الخاصة.
- الانفتاح: يشحن Kimi أوزانًا مفتوحة بموجب ترخيص MIT معدل. Opus وGPT-5.5 مغلقان.
- الخلاصة: اختر النموذج الرائد للحصول على أعلى جودة في لقطة واحدة؛ اختر Kimi عندما تكون التكلفة أو الحجم أو التحكم في البيانات أكثر أهمية من النقاط القليلة الأخيرة.
المنافسون في لمحة
| Kimi K2.7 Code | Claude Opus | GPT-5.5 | |
|---|---|---|---|
| النوع | وزن مفتوح (MIT معدل) | مغلق | مغلق |
| الهندسة المعمارية | MoE، 1T إجمالي / 32B نشط | لم يتم الكشف عنها | لم يتم الكشف عنها |
| نافذة السياق | 256 ألف رمز مميز | كبير | كبير |
| استضافة ذاتية | نعم | لا | لا |
| التسعير (لكل مليون رمز مميز) | 0.95 دولار إدخال / 4.00 دولارات إخراج | أعلى، تأجير فقط | أعلى، تأجير فقط |
الفرق الهيكلي هو العنوان الرئيسي. يخبرك Kimi تمامًا بما هو عليه ويسمح لك بتشغيله بنفسك. الاثنان الآخران هما خدمات يمكنك استدعاؤها.
معايير البرمجة
هذه هي النتائج المبلغ عنها من قبل Moonshot. تعامل معها على أنها إطار البائع، نظرًا لأن العديد من المجموعات مملوكة لـ Moonshot نفسها، لكن النمط ثابت ويستحق القراءة.
| المعيار | Kimi K2.7 Code | GPT-5.5 | Claude Opus |
|---|---|---|---|
| Kimi Code Bench v2 | 62.0 | 69.0 | 67.4 |
| Program Bench | 53.6 | 69.1 | 63.8 |
| MLS Bench Lite | 35.1 | 35.5 | 42.8 |
يحتل GPT-5.5 المرتبة الأولى في أول اثنين؛ ويتصدر Claude Opus في MLS Bench Lite ويظل قريبًا في كل مكان. يجلس Kimi في مرتبة أدنى قليلاً في كل منها. الفجوة حقيقية ولكنها صغيرة في Kimi Code Bench v2، وأوسع في Program Bench. إذا كان عملك يشبه هذا المعيار الثاني، فإن النموذج الرائد يستحق سعره.
معايير الوكالة واستخدام الأدوات
تعتمد وكلاء البرمجة على استدعاءات الأدوات، وليس فقط على توليد الكود. هنا تضيق الصورة.
| المعيار | Kimi K2.7 Code | GPT-5.5 | Claude Opus |
|---|---|---|---|
| Kimi Claw 24/7 | 46.9 | 52.8 | 50.4 |
| MCP Atlas | 76.0 | 79.4 | 81.3 |
| MCP Mark Verified | 81.1 | 92.9 | 76.4 |
في MCP Mark Verified، يتفوق Kimi بالفعل على Claude Opus، على الرغم من أن GPT-5.5 يتقدم بفارق كبير. في MCP Atlas، تتراوح الثلاثة ضمن حوالي خمس نقاط. لأحمال عمل الوكلاء، Kimi أقرب إلى المجموعة مما تشير إليه درجات البرمجة الخام، وهو أمر مهم لأن هذا هو بالضبط المكان الذي تتراكم فيه تكاليف الرموز المميزة.
التكلفة هي حيث يفوز Kimi
تقيس المعايير الجودة. لكنها لا تقيس الفاتورة. يكلف Kimi K2.7 Code 0.95 دولار لكل مليون رمز إدخال و4.00 دولارات لكل مليون رمز إخراج، مع تكلفة 0.19 دولار لكل مليون لمرات التخزين المؤقت. تكلف النماذج الرائدة المغلقة أكثر بكثير لكل رمز مميز، ولا يمكنك الهروب من ذلك باستضافتها؛ لا يوجد تنزيل.
هناك عاملان يزيدان من التوفير:
- الأوزان المفتوحة تعني خيارًا بدون رموز مميزة. استضف ذاتيًا على أجهزتك الخاصة وتختفي تكلفة الرمز المميز تمامًا. يمكنك استبدالها بوقت وحدة معالجة الرسوميات (GPU).
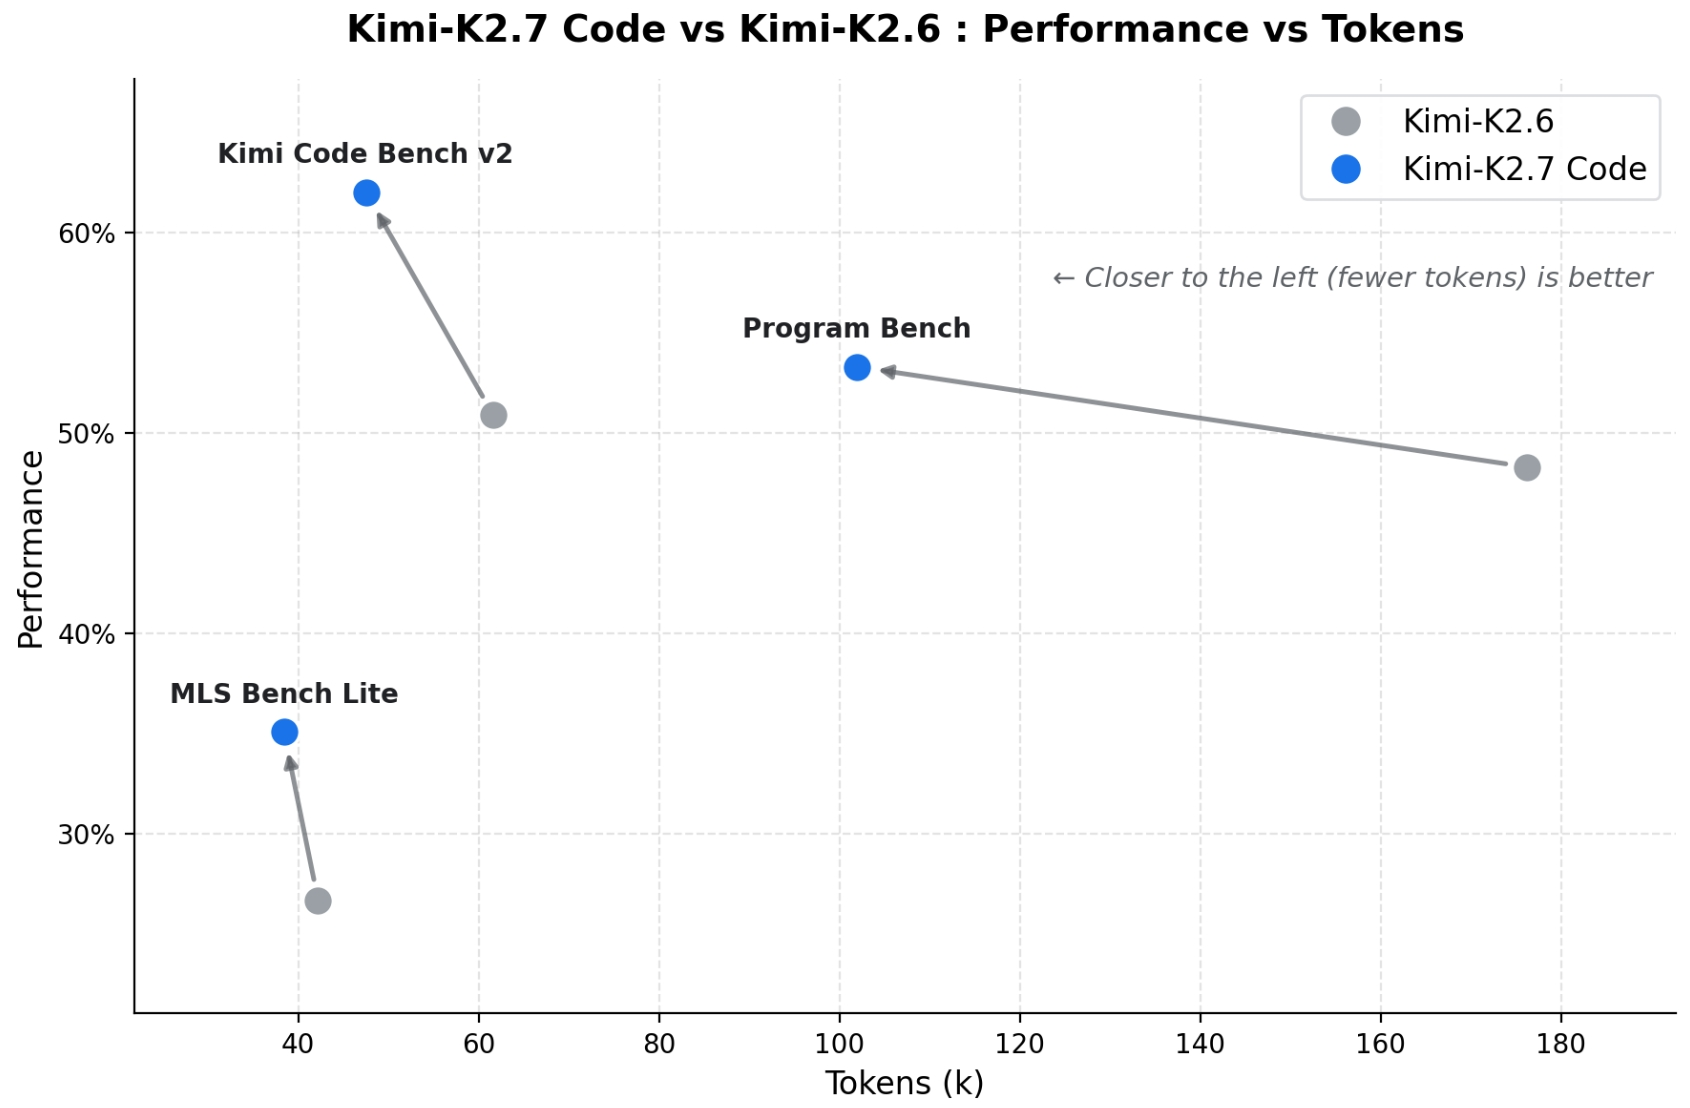
- استدلال أكثر كفاءة. يستخدم K2.7 Code حوالي 30% رموز تفكير أقل من K2.6 لنفس العمل، لذلك تكلف كل خطوة وكيل أقل. يتعمق دليلنا حول تقليل تكاليف رموز الوكيل في سبب تراكم ذلك.
بالنسبة لوكيل يقوم بمئات استدعاءات الأدوات لكل مهمة، فإن النموذج الذي يكون جيدًا بنسبة 90% بجزء صغير من السعر غالبًا ما يفوز بالقيمة الإجمالية.
السياق والانفتاح
تتعامل النماذج الثلاثة مع السياق الطويل بشكل جيد؛ نافذة Kimi هي 256 ألف رمز مميز، وهو ما يكفي لخدمة كاملة بالإضافة إلى اختباراتها في موجه واحد. الفارق الأكبر هو الترخيص. تسمح لك أوزان MIT المعدلة الخاصة بـ Kimi بضبط النموذج وتدقيقه وتشغيله بمعزل عن الشبكة. بالنسبة للفرق التي لديها قواعد امتثال أو إقامة بيانات، هذا ليس أمرًا مستحسنًا؛ إنه العامل الحاسم، والنماذج المغلقة ببساطة ليست خيارًا.
متى تختار كلاً منها
اختر GPT-5.5 أو Claude Opus إذا:
- تحتاج إلى أعلى جودة برمجة في لقطة واحدة وتبرر بعض نقاط المعيار التكلفة.
- لا بأس لديك باستئجار خدمة مغلقة مع اتفاقية مستوى خدمة مُدارة.
- تبدو أصعب مهامك مثل Program Bench، حيث تكون الفجوة أوسع.
اختر Kimi K2.7 Code إذا:
- تقوم بتشغيل أحمال عمل وكلاء عالية الحجم حيث تحدد تكلفة الرمز المميز الجدوى.
- يجب أن تبقى البيانات على البنية التحتية الخاصة بك.
- تريد ضبط النموذج أو تدقيقه.
- تقوم بتحسين القيمة الإجمالية، وليس صدارة لوحة المتصدرين.
لمجال أوسع، تغطي مقارنتنا بين MiniMax M3 وDeepSeek V4 وQwen 3.7 المنافسين الآخرين ذوي الأوزان المفتوحة، وتتعمق DeepSeek V4 vs Claude Opus للبرمجة في مقارنة أخرى بين النماذج المفتوحة والمغلقة. إذا كنت تقارن الوكلاء بدلاً من النماذج، فراجع Claude Code vs OpenAI Codex.
جرب المقارنة بنفسك
المعايير هي نقطة بداية، وليست حكمًا نهائيًا على قاعدة التعليمات البرمجية الخاصة بك. الاختبار الصادق هو تشغيل النماذج الثلاثة على مهامك الخاصة وقراءة النتائج. يمنحك واجهة سطر الأوامر (CLI) الخاصة بـ Kimi Code الوكيل مجانًا للبدء، ويمكنك استدعاء واجهة برمجة التطبيقات (API) لكل نموذج مباشرة لمقارنة المخرجات الأولية.
عندما تفعل ذلك، اختبر نقاط النهاية في Apidog: أرسل نفس الموجه لكل نموذج، واحفظ الاستدعاءات جنبًا إلى جنب، وقارن جودة الاستجابة، ووقت الاستجابة، واستخدام الرموز المميزة في مكان واحد. قم بتنزيل Apidog لإجراء المقارنة.
الأسئلة الشائعة
هل Kimi K2.7 Code أفضل من Claude Opus أو GPT-5.5؟ في معايير البرمجة المبلغ عنها من قبل Moonshot، لا؛ تسجل النماذج المغلقة درجات أعلى في معظم المجموعات. ميزة Kimi هي الأوزان المفتوحة والتكلفة الأقل بكثير مع البقاء ضمن بضع نقاط.
كم هو Kimi أرخص؟ يكلف 0.95 دولار لكل مليون رمز إدخال و4.00 دولارات لكل مليون إخراج، ومجاني للاستضافة الذاتية. تكلف النماذج الرائدة المغلقة أكثر لكل رمز مميز ولا يمكن استضافتها ذاتيًا.
هل يمكنني تشغيل Kimi K2.7 Code بنفسي؟ نعم. الأوزان مفتوحة بموجب ترخيص MIT معدل؛ قم بخدمتها باستخدام vLLM أو SGLang أو KTransformers.
أيهما أفضل لوكلاء البرمجة؟ بالنسبة للجودة الخام، يتصدر GPT-5.5. بالنسبة للوكلاء ذوي الحجم الكبير والفعالين من حيث التكلفة، Kimi هو الخيار الأفضل من حيث القيمة، وهو قريب في معايير الوكالة.
هل هذه المعايير محايدة؟ العديد من المجموعات مملوكة لـ Moonshot نفسها، لذا اقرأها على أنها إطار البائع. الفجوة الثابتة إلى النموذج الرائد هي الإشارة المفيدة، وليست الأرقام الدقيقة.
الملخص
لا يتفوق Kimi K2.7 Code على Claude Opus أو GPT-5.5 في معظم معايير البرمجة، ولا تدعي Moonshot ذلك. يسجل بضع نقاط أقل بينما يكلف أقل بكثير ويشحن أوزانًا مفتوحة يمكنك تشغيلها بنفسك. للحصول على أعلى جودة ممكنة، لا يزال النموذج الرائد المغلق يفوز. بالنسبة للوكلاء ذوي الحجم الكبير، والنشر الخاص، أو أي شخص يوازن القيمة الإجمالية على صدارة الترتيب، Kimi هو الخيار الأذكى. قم بتشغيل النماذج الثلاثة على التعليمات البرمجية الخاصة بك، وقارن المخرجات في Apidog، ودع عبء عملك يقرر.