
GLM-5.2 هو أحد أقوى نماذج الأوزان المفتوحة التي يمكنك تشغيلها حاليًا، وتعني رخصة MIT المفتوحة أن "المجاني" متاح بالفعل. لكن المشكلة هي أن "المجاني" و"السهل" ليسا الشيء نفسه لنموذج مزيج من الخبراء بحجم ~753 مليار معلمة. يرشدك هذا الدليل عبر المسارات الحقيقية، بدءًا من الاستضافة الذاتية المجانية تمامًا وصولًا إلى أرصدة التجربة شبه المجانية وأرخص مستوى مدفوع، مع ملاحظات صريحة حول الأجهزة والقيود.
إذا كنت تريد النسخة المختصرة: إذا كان لديك العتاد (أو وحدة معالجة رسومات مستأجرة رخيصة)، فاستضف الأوزان المفتوحة ذاتيًا. إذا لم يكن لديك، اعتمد على أرصدة التجربة من z.ai أو أرخص مستوى في خطة GLM Coding Plan. لا يوجد مسار OpenRouter مجاني لـ glm-5.2، لذا لا تبحث عنه.
شجرة القرار السريعة
اختر صفك وانتقل إلى هذا القسم.
| وضعك | أفضل مسار | التكلفة الحقيقية |
|---|---|---|
| تمتلك جهاز GPU قوي (أو يمكنك استئجار واحد) | استضافة ذاتية للأوزان المفتوحة (Ollama / vLLM) | 0 دولار للأوزان؛ كهرباء أو إيجار GPU |
| تريد إعدادًا صفرًا وبدون بطاقة | أرصدة تجريبية مجانية من z.ai / طبقة ذات حد أقصى للمعدل | مجاني حتى نفاد الأرصدة (تحقق من العرض الحالي) |
| تريد أرخص مسار مدفوع موثوق به | خطة GLM Coding Plan Lite، أو تسعير واجهة برمجة التطبيقات للمدخلات المخزنة مؤقتًا | ~3-6 دولارات/شهر (تحقق) أو سنتات لكل مكالمة |
| تريد الدفع حسب الاستخدام بدون التزام | واجهة برمجة تطبيقات OpenRouter | 1.40 دولار / مليون رمز إدخال، 4.40 دولار / مليون رمز إخراج |
القاعدة الذهبية: مجاني تمامًا يعني استضافة ذاتية. شبه مجاني يعني أرصدة تجريبية أو خطة Lite.
المسار 1: الاستضافة الذاتية لأوزان MIT المفتوحة (مجاني تمامًا)
يأتي GLM-5.2 بموجب رخصة MIT بدون قيود إقليمية، لذا يمكنك تنزيل الأوزان وتشغيلها على أجهزتك الخاصة دون دفع لأحد. تتواجد الأوزان على Hugging Face في zai-org/GLM-5.2.
الجزء الصادق: هذا نموذج MoE بـ ~753 مليار معلمة في BF16. حتى لو تم تنشيط جزء صغير فقط من هذه المعلمات لكل رمز، فإن مجموعة الأوزان الكاملة يجب أن تبقى في الذاكرة. في BF16، هذا يتجاوز التيرابايت من الأوزان الخام. لن تقوم بتشغيل هذا على جهاز كمبيوتر محمول. معظم الأشخاص الذين يستضيفون بأنفسهم يقومون بأحد أمرين:
- تشغيل بناء مكمم (4 بت أو ما شابه) لتقليص استهلاك الذاكرة، مع قبول تضحية بسيطة في الجودة.
- استئجار مثيل متعدد وحدات معالجة الرسومات (GPU) بالساعة من مزود سحابي وإيقافه عند الانتهاء.
لذا "مجاني" هنا يعني خالٍ من تكلفة الترخيص. لا يزال يتعين عليك الدفع مقابل الأجهزة، الكهرباء، أو إيجار وحدة معالجة الرسومات. بالنسبة لمعظم الأفراد، فإن بناءً مكممًا على محطة عمل ذات VRAM عالية أو جلسة إيجار قصيرة هو المسار الواقعي.
تشغيل GLM-5.2 باستخدام Ollama
Ollama هو المشغل المحلي الأكثر ودية. يتوفر GLM-5.2 في مكتبة Ollama، والعملية تتطلب أمرين:
# Pull the model (expect a very large download)
ollama pull glm-5.2:cloud
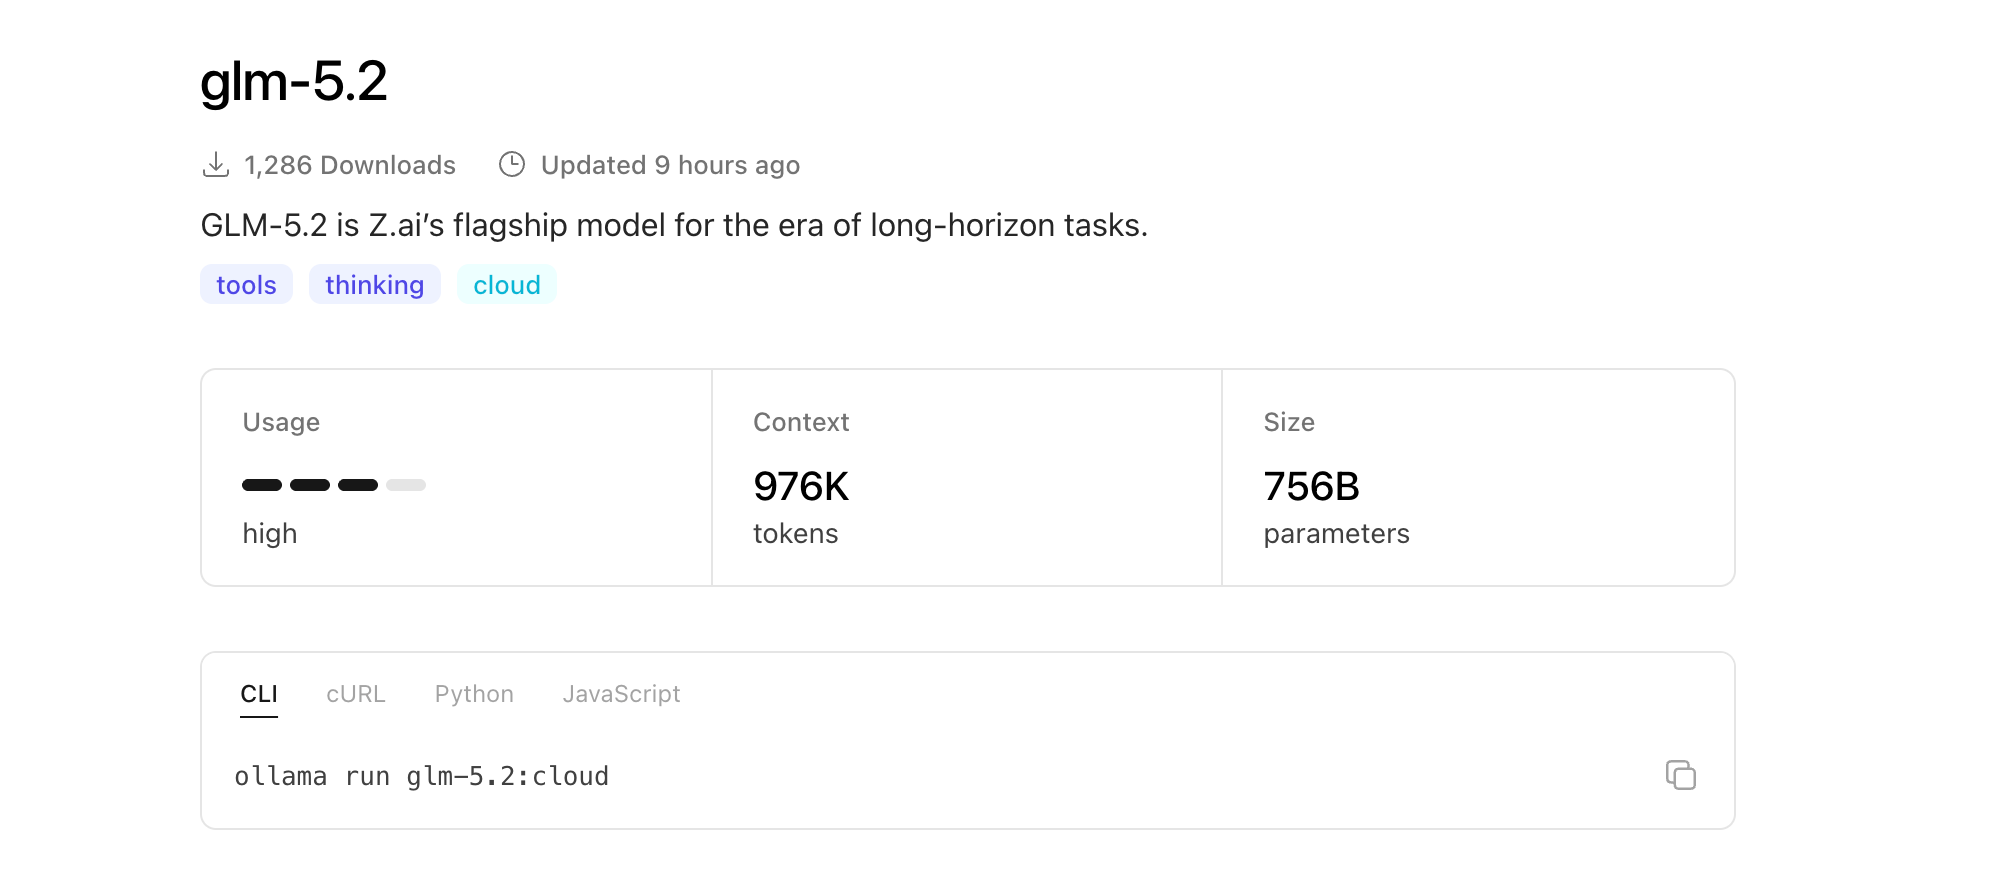
يستخدم Ollama افتراضيًا نسخة مكممة، وهو ما يجعل نموذجًا بهذا الحجم قابلاً للتفكير فيه على أجهزة استهلاكية. يمكنك أيضًا الوصول إليه عبر نقطة نهاية Ollama المحلية المتوافقة مع OpenAI:
curl http://localhost:11434/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.2",
    "messages": [{"role": "user", "content": "Write a Python function to parse an RFC 3339 timestamp."}]
  }'
راقب ذاكرة الوصول العشوائي (RAM) وذاكرة الفيديو (VRAM) الخاصة بك. إذا امتلأ النموذج على القرص، فإن عملية التوليد تتباطأ بشكل كبير. البناء المكمم بالإضافة إلى ذاكرة موحدة كافية أو تقسيم متعدد وحدات معالجة الرسومات هو الفارق بين ما يمكن استخدامه وما لا يمكن استخدامه.
إذا كنت تريد الدليل التفصيلي المحلي، فإن الأنماط تنتقل بشكل شبه مطابق من الجيل السابق. راجع تشغيل GLM-5 محليًا مجانًا و GLM-5 مجانًا باستخدام Ollama للإعداد الكامل، خيارات التكميم، واستكشاف الأخطاء وإصلاحها. استبدل وسم النموذج إلى glm-5.2 وستكون سير العمل هي نفسها.
تشغيل GLM-5.2 باستخدام vLLM
لتحقيق الإنتاجية العالية وخدمة طلبات متعددة، vLLM هو الخيار المناسب للإنتاج. إنه يتعامل مع توازي الموترات عبر وحدات معالجة الرسومات (GPUs)، وهي الطريقة التي تناسب بها نموذج MoE بحجم 753 مليار معلمة.
pip install vllm

python -m vllm.entrypoints.openai.api_server \
  --model zai-org/GLM-5.2 \
  --tensor-parallel-size 8 \
  --max-model-len 131072
الخيار --tensor-parallel-size 8 يفترض وجود ثمانية وحدات معالجة رسومات. يعتمد العدد الدقيق على بطاقاتك وما إذا كنت تقوم بتحميل نقطة تفتيش مكممة. تعرض vLLM خادمًا متوافقًا مع OpenAI، لذا فإن أي عميل يتحدث تنسيق إكمال الدردشة يعمل بدون تغييرات. سياق 1M رمز (1,048,576 رمزًا) هو القدرة الرئيسية، ولكن الاحتفاظ بذاكرة تخزين مؤقتة (KV cache) بمليون رمز يكلف الكثير من الذاكرة، لذا اضبط --max-model-len على ما تحتاجه بالفعل.
المسار 2: أرصدة التجربة المجانية من z.ai والطبقة محدودة المعدل
إذا كانت الاستضافة الذاتية بعيدة المنال، فإن المسار الأقل تكلفة التالي هو منصة z.ai الخاصة. تحصل الحسابات الجديدة عادةً على أرصدة تجريبية مجانية وعادة ما تكون هناك طبقة مجانية محدودة المعدل للتجريب الخفيف (اعتبارًا من يونيو 2026، تحقق من العرض الحالي على z.ai حيث تتغير شروط التجربة غالبًا).
هذه هي أسرع طريقة لتجربة النموذج الحقيقي بدون أي إعداد. تقوم بإنشاء حساب، الحصول على مفتاح API، واستدعاء نقطة النهاية المتوافقة مع OpenAI:
curl https://api.z.ai/api/paas/v4/chat/completions \
  -H "Authorization: Bearer $ZAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.2",
    "messages": [{"role": "user", "content": "Explain IndexShare sparse attention in two sentences."}],
    "thinking": {"type": "enabled"},
    "reasoning_effort": "max"
  }'
بعض التفاصيل الخاصة بـ GLM-5.2 التي تستحق المعرفة أثناء استخدامك لتلك الأرصدة:
- تقوم
thinkingبتبديل التفكير (الاستدلال) بين التشغيل والإيقاف. للبرمجة، توصي z.ai بمستوى جهد التفكير الأقصى (Max) عبرreasoning_effort: "max". هناك مستويان للجهد، عالٍ وأقصى. - طول الإخراج موثق بحد أقصى 128 ألف وفقًا لوثائق z.ai، ولكن تعامل مع ذلك كرقم للتحقق منه مباشرة بدلاً من كونه ضمانًا صارمًا، حيث لا تدرجه المصادر الثانوية دائمًا.
تنتهي أرصدة التجربة. عندما يحدث ذلك، إما أن تنتقل إلى خطة مدفوعة أو تعود إلى الاستضافة الذاتية. توجد تفاصيل المعلمات الكاملة في دليل z.ai GLM-5.2.
المسار 3: أرخص المستويات المدفوعة (شبه مجانية)
عند نفاد الأرصدة المجانية، هناك مساران يحافظان على تكاليفك قريبة من الصفر.
خطة GLM Coding Plan Lite
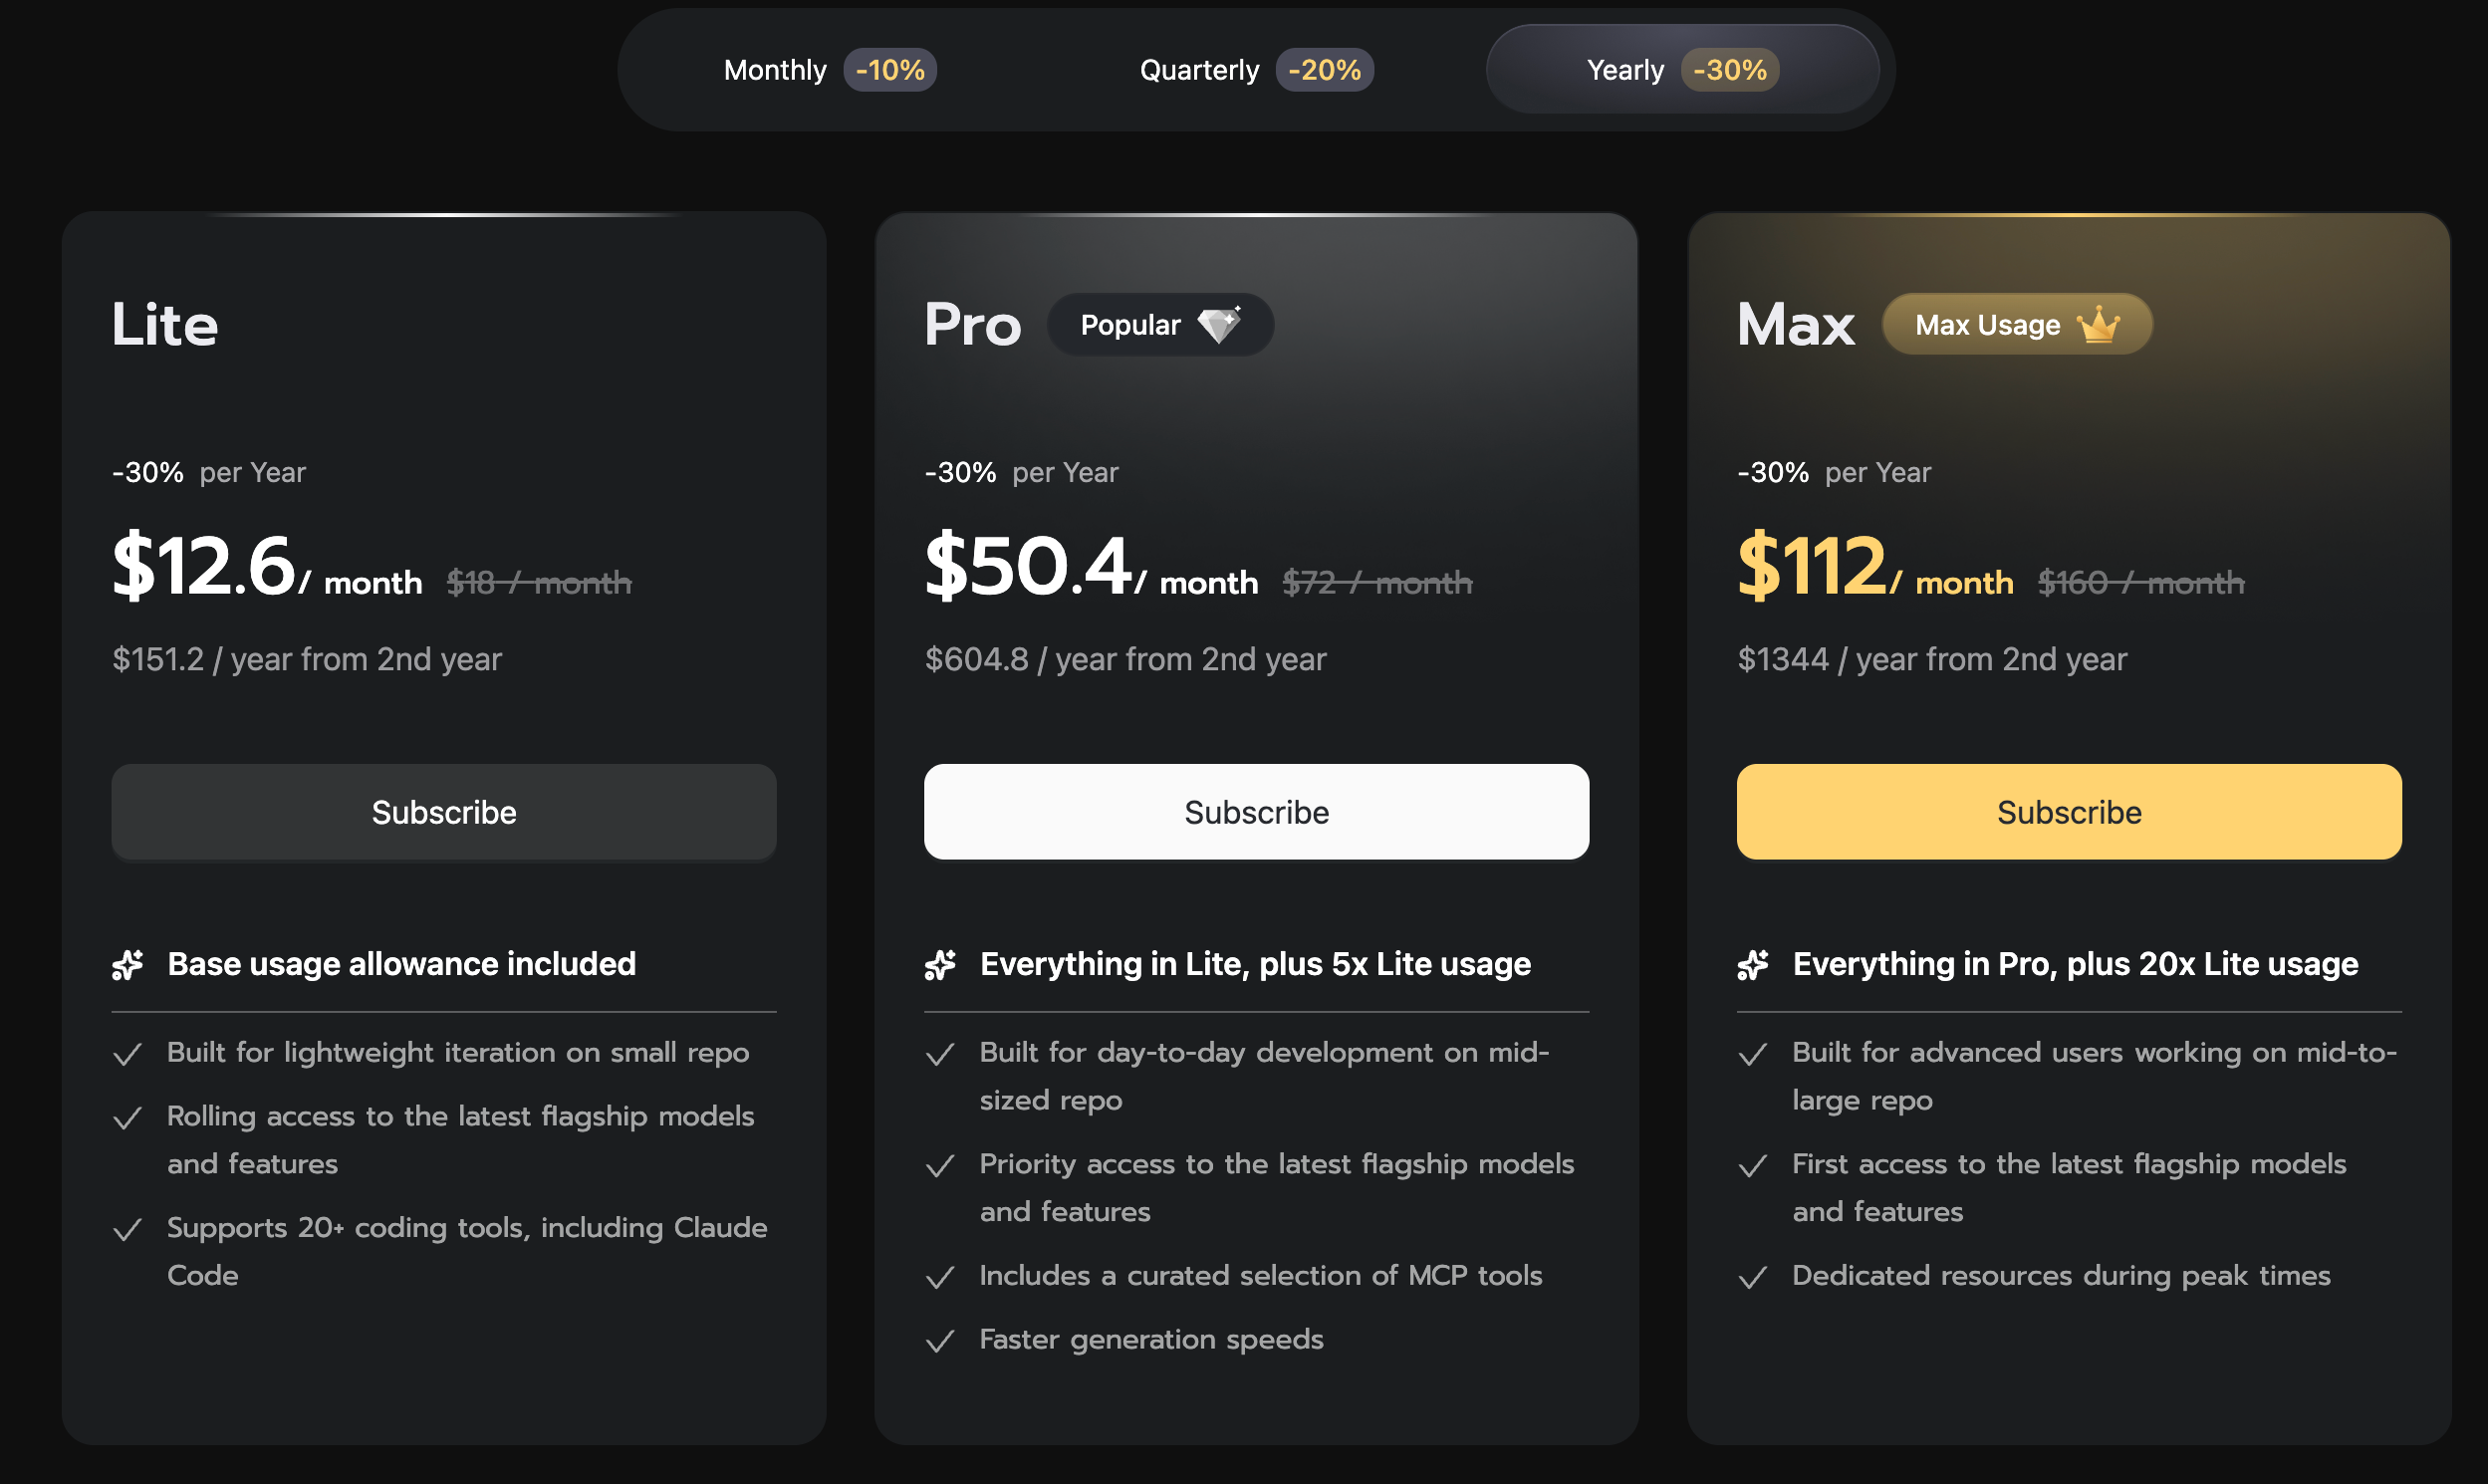
إذا كان استخدامك الرئيسي هو البرمجة، فإن خطة GLM Coding Plan هي الخيار الأمثل للقيمة. تبلغ تكلفة طبقة Lite الابتدائية حوالي 12 دولارًا شهريًا (اعتبارًا من يونيو 2026، تحقق من التسعيرة الحالية على z.ai حيث تتعارض المستويات المنشورة عبر المصادر). مقابل ذلك، تحصل على إمكانية الوصول إلى البرمجة بسعر شهري ثابت بدلاً من الرموز المقيسة، مما يجعل الاستخدام اليومي المكثف قابلاً للتنبؤ به.
تفتح خطة البرمجة أيضًا المسار المتوافق مع Anthropic، بحيث يمكنك توجيه Claude Code أو Cline أو Cursor نحو GLM-5.2. عنوان URL الأساسي للبرمجة هو https://api.z.ai/api/coding/paas/v4 (تظهر بعض المصادر open.z.ai/api/paas/v4، لذا تحقق مباشرة). بيئة Claude Code العاملة تبدو كالتالي:
export ANTHROPIC_BASE_URL="https://api.z.ai/api/coding/paas/v4"
export ANTHROPIC_API_KEY="your-glm-coding-plan-key"
export ANTHROPIC_DEFAULT_SONNET_MODEL="glm-5.2[1m]"
export ANTHROPIC_DEFAULT_OPUS_MODEL="glm-5.2[1m]"
export CLAUDE_CODE_AUTO_COMPACT_WINDOW=1000000
export API_TIMEOUT_MS=3000000
اللاحقة [1m] تحدد المتغير ذو السياق 1M. اضبط API_TIMEOUT_MS بقيمة عالية، وإلا فإن Claude Code ستنهي المكالمات الطويلة ذات السياق الكبير قبل أن تكتمل. للدليل المفصل لأدوات الوكيل، راجع GLM-5.2 مع Claude Code و Cline و Cursor ودليل الجيل السابق GLM-5.1 مع Claude Code.
تسعير المدخلات المخزنة مؤقتًا والدفع حسب الاستخدام
للوصول إلى واجهة برمجة التطبيقات (API) بدون اشتراك، تبلغ تكلفة واجهة برمجة التطبيقات العامة القياسية 1.40 دولار لكل مليون رمز إدخال و 4.40 دولار لكل مليون رمز إخراج، كما أكد OpenRouter. تنطبق نفس التسعيرة سواء قمت بالاتصال بـ z.ai مباشرة أو عبر OpenRouter كدفع حسب الاستخدام.
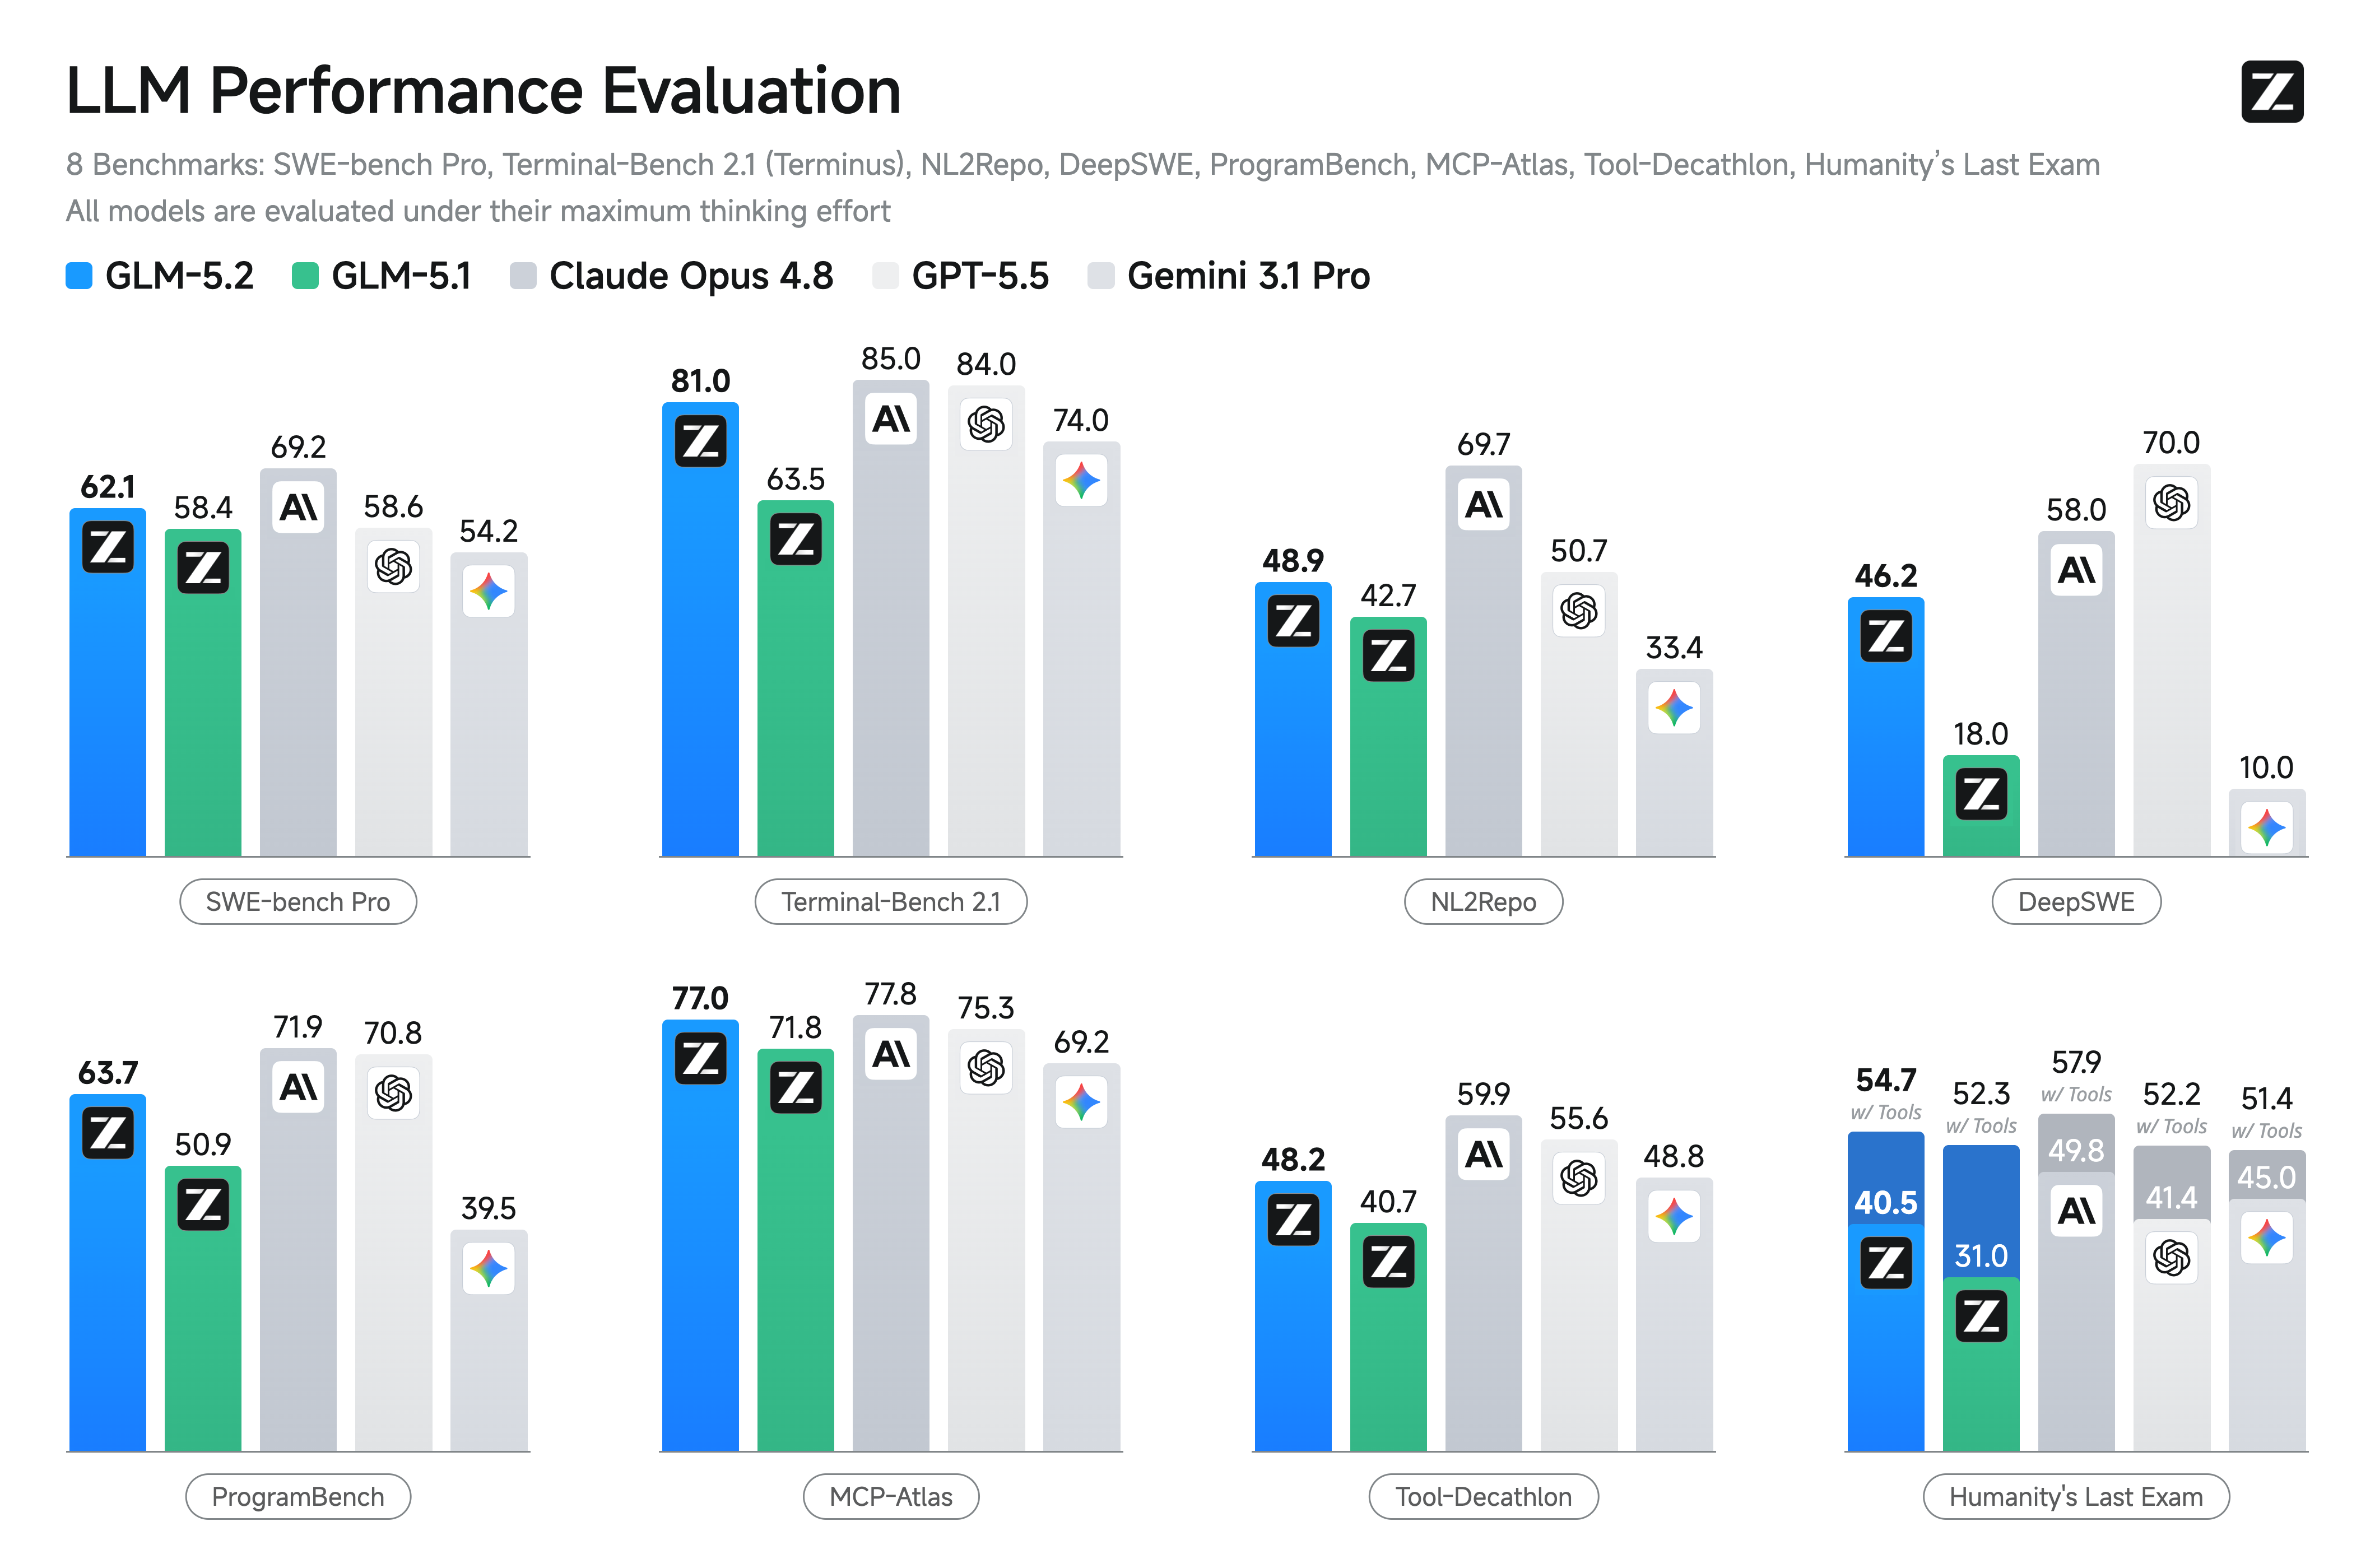
الخدعة شبه المجانية هنا هي المدخلات المخزنة مؤقتًا. بتكلفة حوالي 0.26 دولار لكل مليون رمز (وفقًا لـ VentureBeat، يُنسب إلى المصدر)، تقلل المدخلات المخزنة مؤقتًا تكلفة السياق المتكرر، مثل موجه نظام طويل أو قاعدة تعليمات برمجية ثابتة تستعلم عنها مرارًا وتكرارًا. إذا كانت مهام عملك تعيد استخدام نفس البادئة، فإنك تدفع السعر الكامل مرة واحدة وجزءًا منه بعد ذلك. بالنسبة للبرمجة ذات الأفق الطويل، تشير VentureBeat إلى أن GLM-5.2 "يتفوق على GPT-5.5 في البرمجة ذات الأفق الطويل بحوالي سدس التكلفة"، وهذا هو الجدل الاقتصادي في جملة واحدة.
مرة أخرى، بوضوح: لا توجد طبقة OpenRouter مجانية لـ glm-5.2. OpenRouter رخيص، وليس مجانيًا. إذا ادعى دليل خلاف ذلك، فهو خاطئ.
مجاني مقابل شبه مجاني: مقارنة صريحة
| المسار | التكلفة الأولية | التكلفة المستمرة | جهد الإعداد | الأفضل لـ |
|---|---|---|---|---|
| استضافة ذاتية (Ollama/vLLM) | الأجهزة أو الإيجار | الكهرباء / ساعات استخدام GPU | عالي | الخصوصية، عدم القياس، تحكم كامل |
| أرصدة تجريبية من z.ai | لا شيء | مجاني حتى انتهاء الأرصدة | منخفض | التجربة الأولى، اختبارات سريعة |
| خطة GLM Coding Plan Lite | ~3-6 دولارات/شهر (تحقق) | شهري ثابت | منخفض | البرمجة اليومية في Claude Code/Cline/Cursor |
| واجهة برمجة التطبيقات + مدخلات مخزنة مؤقتًا | لا شيء | 1.40 دولار/4.40 دولار لكل مليون؛ ~0.26 دولار للمخزن مؤقتًا | منخفض | التطبيقات، أعباء العمل ذات السياق المتكرر |
نمط مفيد: تحقق من فكرتك باستخدام أرصدة التجربة، ثم قرر. إذا كنت ستشغلها يوميًا وكانت برمجة، فاحصل على خطة Lite. إذا كنت بحاجة إلى الخصوصية أو تريد التخلص تمامًا من الفوترة لكل رمز، فاستثمر في الاستضافة الذاتية. إذا كنت تبني منتجًا بسياق قابل لإعادة الاستخدام، فإن واجهة برمجة التطبيقات مع التخزين المؤقت هي أرخص أساس موثوق به.
اختبر نقطة نهاية GLM-5.2 المجانية باستخدام Apidog
مهما كانت طريقة تشغيلك لـ GLM-5.2، سواء مجانية أو مدفوعة، سترغب في التأكد من أن نقطة النهاية تعمل بالفعل قبل توصيلها بتطبيقك. سواء كان خادم Ollama محليًا، أو مثيل vLLM، أو واجهة برمجة تطبيقات z.ai السحابية، فإن الاستجابة هي حمولة إكمال دردشة متدفقة تحتاج إلى فحصها.
Apidog هي منصة شاملة لواجهة برمجة التطبيقات (API) لهذا الغرض بالضبط. يمكنك إرسال طلب إلى نقطة نهاية GLM-5.2 الخاصة بك، ومشاهدة الأحداث المرسلة من الخادم المتدفقة وهي تُعرض في الوقت الفعلي، وحفظ الطلب كحالة قابلة لإعادة الاستخدام، ومحاكاة الاستجابة حتى يتمكن الواجهة الأمامية (frontend) لتطبيقك من البناء عليها قبل حتى أن يكون النموذج مباشرًا. وجهه إلى http://localhost:11434 لـ Ollama أو إلى عنوان URL الأساسي لـ z.ai للخدمة السحابية، وقم بتعيين رأس Authorization الخاص بك، وسيكون لديك أداة اختبار قابلة للتكرار في دقيقة واحدة. نزّل Apidog واحتفظ به بجانب أي مسار مجاني تختاره.
الأسئلة الشائعة
هل GLM-5.2 مجاني للاستخدام حقًا؟ الأوزان مجانية بموجب رخصة MIT، لذا فإن الاستضافة الذاتية لا تكلف شيئًا في الترخيص. لا يزال يتعين عليك الدفع مقابل الأجهزة أو إيجار وحدة معالجة الرسومات. واجهة برمجة التطبيقات المستضافة مدفوعة، على الرغم من أن z.ai عادة ما تقدم أرصدة تجريبية وطبقة محدودة المعدل للبدء (تحقق من العرض الحالي).
هل يمكنني تشغيل GLM-5.2 مجانًا باستخدام Ollama على جهاز كمبيوتر محمول عادي؟ واقعيًا، لا. إنه نموذج MoE بحجم ~753 مليار معلمة، وحتى البناء المكمم يحتاج إلى ذاكرة كبيرة. Ollama يجعل الأوامر سهلة، لكن متطلبات الأجهزة عالية. محطة عمل ذات VRAM عالية، جهاز Mac بذاكرة موحدة كبيرة، أو وحدة معالجة رسومات مستأجرة هو ما تحتاجه. راجع الاستكشاف المحلي العميق لمعرفة متطلبات الحجم.
هل توجد طبقة OpenRouter مجانية لـ GLM-5.2؟ لا. يقدم OpenRouter نموذج GLM-5.2 بالدفع حسب الاستخدام بسعر 1.40 دولار للإدخال و 4.40 دولار للإخراج لكل مليون رمز. إنه رخيص، وليس مجانيًا. لا تثق بأي مصدر يدعي وجود مسار OpenRouter مجاني.
ما هي أرخص طريقة مدفوعة لاستخدام GLM-5.2 للبرمجة؟ طبقة GLM Coding Plan Lite، بحوالي 3-6 دولارات شهريًا اعتبارًا من يونيو 2026 (تحقق من z.ai). توفر وصولاً ثابت السعر للبرمجة وتفتح نقطة النهاية المتوافقة مع Anthropic لـ Claude Code و Cline و Cursor.
كيف يقارن GLM-5.2 بـ GPT-5.5 من حيث التكلفة؟ وفقًا لـ VentureBeat، يتفوق GLM-5.2 على GPT-5.5 في العديد من معايير البرمجة ذات الأفق الطويل بحوالي سدس التكلفة. للحصول على الأرقام الكاملة، راجع تفاصيل معايير GLM-5.2 و المقارنة المباشرة.
إلى أين تذهب بعد ذلك
يعتمد المسار الأقل تكلفة كليًا على أجهزتك وعدد مرات تشغيلك لها. الاستضافة الذاتية تفوز بالخصوصية وعدم القياس إذا تمكنت من تجاوز عائق الذاكرة. أرصدة التجربة وخطة Lite تفوزان بالراحة. واجهة برمجة التطبيقات مع المدخلات المخزنة مؤقتًا تفوز للتطبيقات التي تعيد استخدام السياق.
إذا كنت لا تزال تقرر ما إذا كان GLM-5.2 هو النموذج المناسب على الإطلاق، فابدأ بما هو GLM-5.2 و كيف يقارن بـ GLM-5.1. عندما تكون مستعدًا للبناء عليه، فإن دليل واجهة برمجة تطبيقات GLM-5.2 و تفاصيل التسعير تغطي الباقي، ويتولى Apidog الاختبار في هذه الأثناء.