
لاستخدام Firecrawl Local، ثبّته بالأمر cargo install firecrawl-local، ثم شغّل firecrawl-local init لتسجيله كخادم MCP في Claude Code وCursor، وبعدها أعد تشغيل الأداين. سيتمكن وكيلك الآن من استخراج صفحات المواقع والزحف فيها ورسم خرائطها على جهازك. أما من ناحية البرمجة، فشغّل firecrawl-local serve ووجّه أي Firecrawl SDK إلى http://localhost:3002.
يوضح هذا الدليل كيفية استخدام Firecrawl Local خطوة بخطوة، مع المخرجات الفعلية من تجربتنا في 19 نوفمبر 2026 (Firecrawl Local 0.1.0 على جهاز Mac بمعمارية arm64)، إضافة إلى الموجّهات التي تعطيها لوكيلك وطريقة تتيح له اختبار واجهة API المحلية باستخدام Apidog CLI.
ما تحتاجه قبل أن تبدأ
Firecrawl Local عبارة عن ملف ثنائي واحد مكتوب بلغة Rust من مستودع Firecrawl. قبل تثبيته، تأكد من توفر ما يلي:
- Rust ومترجم C. احصل على Rust من rustup.rs. على macOS شغّل
xcode-select --install؛ وعلى Debian أو Ubuntu ثبّتbuild-essential. - Node.js 22 أو أحدث إذا كنت تريد خادم MCP. فهو يشغّل حزمة npm
firecrawl-mcpعبرnpx. - Chrome أو Chromium (اختياري). يستخدم Firecrawl Local المتصفح المثبّت لديك بالفعل للصفحات التي تحتاج إلى JavaScript. أما الصفحات الثابتة فتعمل دونه.
- Claude Code أو Cursor أو أي عميل MCP آخر. يتعرّف
initأيضًا على Claude Desktop وWindsurf وGemini CLI وCodex.
إذا كنت جديدًا على Firecrawl نفسه، فابدأ بدليلنا دليل استخراج بيانات الويب باستخدام Firecrawl ثم عُد إلى هنا.
الخطوة 1: تثبيت Firecrawl Local
ثبّت الحزمة (crate) من crates.io وتأكد من الإصدار:
cargo install firecrawl-local
firecrawl-local --version
# firecrawl-local 0.1.0
يقوم Cargo بتجميعه من المصدر. على جهاز Mac لدينا استغرق بناء الإصدار 6 دقائق و54 ثانية، ووُضع الملف الثنائي في ~/.cargo/bin/firecrawl-local. تأكد من أن هذا المجلد ضمن PATH لديك، أو دوّن المسار الكامل: ستحتاجه لإعداد MCP يدويًا.
الخطوة 2: تشغيل أول عملية استخراج من الطرفية
قبل ربط أي شيء بوكيل، تحقق من أن الجلب يعمل:
FIRECRAWL_CLOUD=off firecrawl-local scrape https://example.com --markdown
طبع النص الرئيسي للصفحة بصيغة markdown في 1.2 ثانية. احذف --markdown لتحصل على نفس JSON الذي تعيده واجهة Firecrawl API. يحدد --format markdown,links الصيغ؛ والخيارات المحلية هي markdown وhtml وrawHtml وlinks.
بعد ذلك، عملية زحف تكتب ملف markdown واحدًا لكل صفحة:
FIRECRAWL_CLOUD=off firecrawl-local crawl https://docs.firecrawl.dev --limit 20 --out ./pages
جلب هذا 20 صفحة من وثائق Firecrawl في 4.4 ثانية، وحفظ ملفات بأسماء مثل 0005-docs.firecrawl.dev_advanced-scraping-guide.md. إليك خيارات الزحف المفيدة من firecrawl-local crawl --help:
| الخيار | الوظيفة |
|---|---|
-l, --limit |
الحد الأقصى للصفحات (الافتراضي 100) |
--max-depth |
عدد مستويات الروابط التي يتم تتبعها |
--include, --exclude |
تعبير نمطي (regex) للمسارات المراد إبقاؤها أو تخطيها، قابل للتكرار |
--entire-domain |
تتبع الروابط خارج مسار البداية |
-c, --concurrency |
عدد الصفحات التي تُجلب في وقت واحد |
--ignore-robots |
تخطي robots.txt (يُقرأ افتراضيًا) |
يعيد firecrawl-local map https://firecrawl.dev كل عنوان URL يجده من ملفات sitemap وصفحة البداية، في سطر JSON واحد.
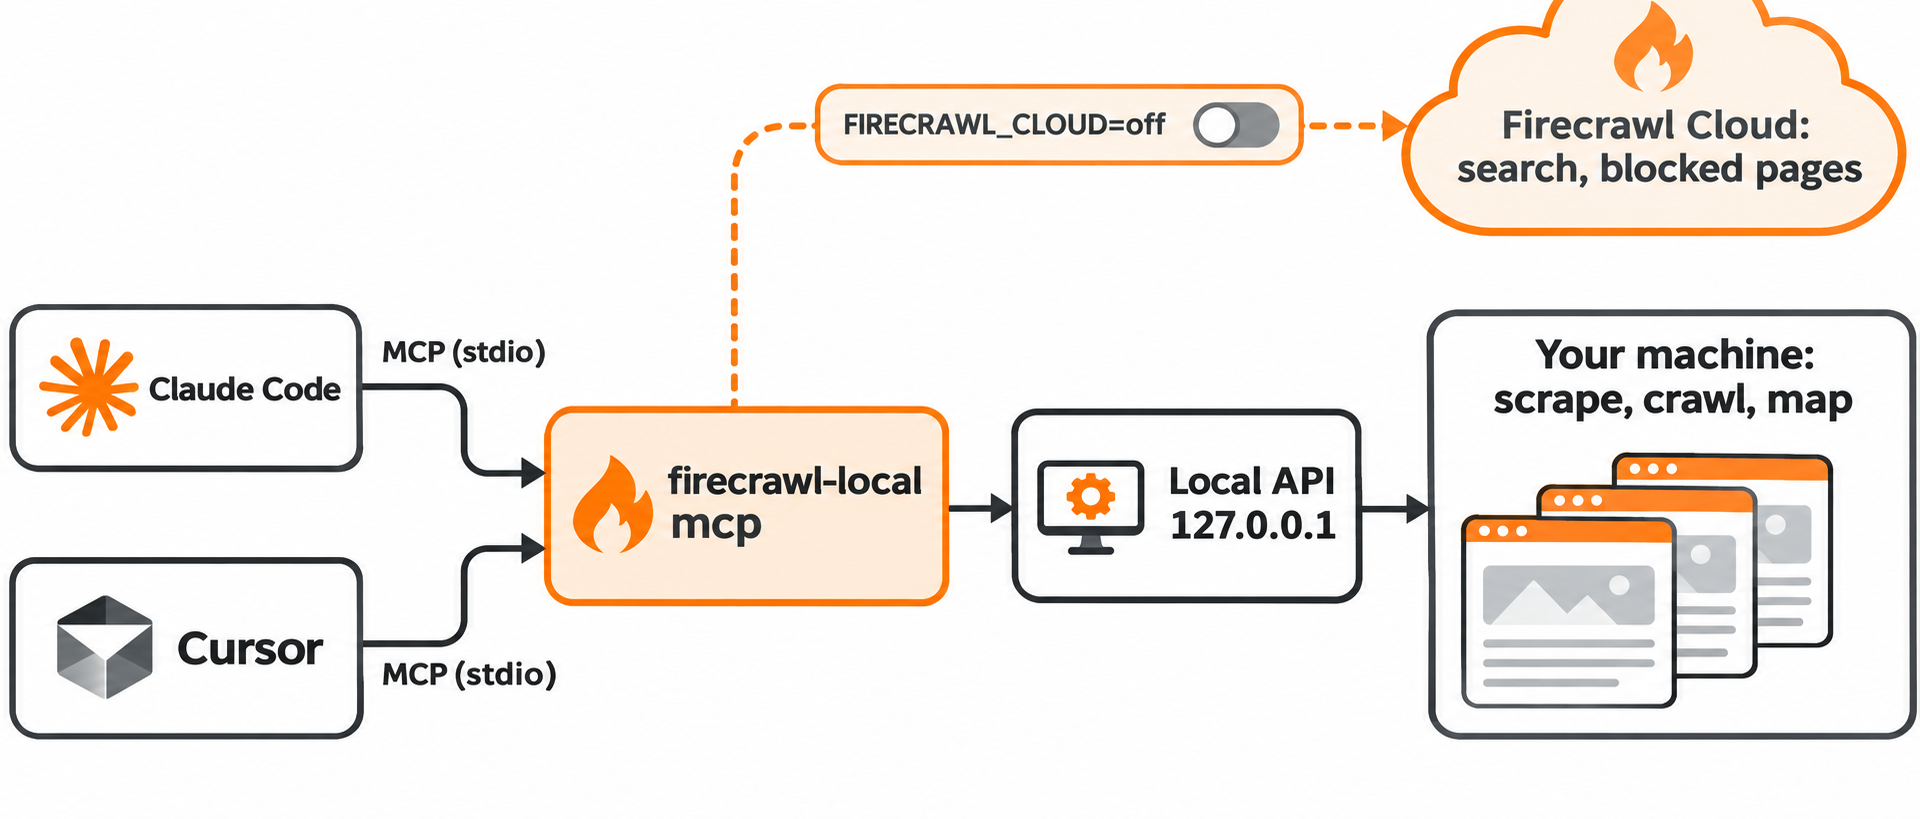
الخطوة 3: إضافة Firecrawl Local إلى Claude Code وCursor باستخدام init
يبحث init عن أدوات الذكاء الاصطناعي على جهازك ويضيف Firecrawl Local إلى إعداد MCP الخاص بكل أداة. عاين النتيجة أولًا:
firecrawl-local init --dry-run
على جهاز Mac لدينا، سرد كل أداة سيتعامل معها:
Firecrawl MCP server:
  Claude Code: would be added in ~/.claude.json
  Claude desktop: would be added in ~/Library/Application Support/Claude/claude_desktop_config.json
  Cursor: would be added in ~/.cursor/mcp.json
  Gemini CLI: would be added in ~/.gemini/settings.json
  Codex: would be added in ~/.codex/config.toml
تطبع المعاينة (dry run) أيضًا ما سيُرسل إلى Firecrawl Cloud: استعلامات البحث، وعنوان URL لصفحة حجبت جهازك، واستدعاءات Alexandria بعد تسجيل الدخول، ومعرّف تثبيت عشوائي إضافة إلى اسم أداة الذكاء الاصطناعي لديك. أما الصفحات التي تُحمّل محليًا بشكل جيد فلا تُرسل أبدًا.
لإعداد الأداتين اللتين يغطيهما هذا الدليل فقط، كرر --agent:
firecrawl-local init --agent claude-code --agent cursor
الأسماء الصالحة هي claude-code وclaude-desktop وcursor وwindsurf وgemini وcodex. ينسخ init كل ملف إعدادات احتياطيًا قبل الكتابة فيه. أعد تشغيل Claude Code وCursor بعد ذلك ليحمّلا الخادم الجديد.
إعداد Firecrawl Local في Claude Code يدويًا
إذا كنت تفضّل ألا تدع أداة تعدّل إعداداتك، فأضف خادم stdio بنفسك باستخدام أمر MCP في Claude Code:
claude mcp add firecrawl -e FIRECRAWL_CLOUD=off -- ~/.cargo/bin/firecrawl-local mcp --public-only
شغّل /mcp داخل Claude Code للتأكد من اتصال الخادم.
إعداد Firecrawl Local في Cursor يدويًا
يقرأ Cursor خوادم MCP من ~/.cursor/mcp.json (عام) أو .cursor/mcp.json (لمشروع واحد). استخدم المسار الكامل إلى الملف الثنائي:
{
  "mcpServers": {
    "firecrawl": {
      "command": "/Users/you/.cargo/bin/firecrawl-local",
      "args": ["mcp", "--public-only"],
      "env": { "FIRECRAWL_CLOUD": "off" }
    }
  }
}
يجعل --public-only الخادم يرفض عناوين localhost وشبكات العنوان الخاص. أبقِه مفعّلًا عندما يقرأ وكيلك صفحات لا تثق بها: وإلا فقد توجّه تعليمات مخفية في صفحة ما الوكيل نحو عنوان URL داخلي.
الخطوة 4: الموجّهات التي تعطيها لوكيلك
يشغّل firecrawl-local mcp واجهة API المحلية على منفذ loopback، ويشغّل حزمة firecrawl-mcp مقابلها. يرى وكيلك أدوات Firecrawl MCP القياسية؛ وتعمل عمليات الاستخراج والزحف ورسم الخرائط والاستخراج الدفعي على جهازك. إذا سبق أن استخدمت خادم Firecrawl MCP المستضاف، فأسماء الأدوات هي نفسها.
موجّهات تناسب الأدوات المحلية جيدًا:
Map https://docs.example.com, then crawl only the /api/ pages (limit 40)
and write a summary of every endpoint into docs/vendor-api.md.
Scrape the changelog at https://example.com/changelog as markdown and list
every breaking change from the last three releases.
Batch scrape these five pricing pages and build a comparison table of
plan names and limits. Quote only what the pages say.
تجنّب الموجّهات التي تحتاج إلى البحث: فمع FIRECRAWL_CLOUD=off لن تؤدي أداة البحث أي وظيفة. لإعداد بحث محلي بالكامل، راجع دليلنا البحث على الويب مفتوح المصدر لـ Claude.
الخطوة 5: تشغيل واجهة Firecrawl Local API وتوجيه SDK إليها
للسكربتات وخطوط المعالجة، شغّل خادم API:
FIRECRAWL_CLOUD=off firecrawl-local serve
يستمع على 127.0.0.1:3002. ويستجيب فحص الحالة فورًا:
curl -s localhost:3002/health
# {"status":"ok","engine":"firecrawl-local","version":"0.1.0"}
تعيد عملية الاستخراج بنية v2 المألوفة، مع علامتين محليتين بداخلها: "engine": "local-fetch" و"source": "local"، إضافة إلى creditsUsed: 0.
curl -s localhost:3002/v2/scrape -H 'content-type: application/json' \
  -d '{"url":"https://example.com","formats":["markdown","links"]}'
وجّه حزم Firecrawl SDK إليها دون مفتاح API. Python:
from firecrawl import Firecrawl

app = Firecrawl(api_url="http://localhost:3002")
print(app.scrape("https://example.com").markdown)
Node:
import { Firecrawl } from "firecrawl";

const app = new Firecrawl({ apiUrl: "http://localhost:3002" });
const doc = await app.scrape("https://example.com");
console.log(doc.markdown);
يقترح init اختصارًا أيضًا: اضبط FIRECRAWL_API_URL=http://127.0.0.1:3002 وسيعمل كود Firecrawl الموجود لديك محليًا. تشارك Firecrawl CLI تسجيل الدخول المحفوظ مع Firecrawl Local، لذا يعمل أمر login في أي من الأداين لكليهما.
عمليات الزحف غير متزامنة. أعاد POST /v2/crawl معرّف مهمة فورًا، وبعد بضع ثوانٍ أبلغ GET /v2/crawl/{id} عن status: completed وtotal: 10 وcreditsUsed: 0 وexpiresInSeconds: 3587. تعيش المهام في الذاكرة، وتنتهي صلاحيتها بعد ساعة من بدئها، وتختفي عند إيقاف serve، لذا احفظ النتائج بمجرد اكتمال الزحف.
استقرت عملية الخادم عند نحو 10 ميغابايت من الذاكرة المقيمة في وضع الخمول، و43 ميغابايت مباشرة بعد الزحف إلى 10 صفحات، وفق قياس باستخدام ps. تدّعي منشورات إطلاق Firecrawl أنها أسرع بـ37 مرة وتستهلك ذاكرة أقل بـ230 مرة من Firecrawl المستضاف ذاتيًا؛ لكن README لا ينشر منهجية القياس، لذا تعامل مع هذه الأرقام على أنها أرقام Firecrawl.
إبقاء Firecrawl Local محليًا بالكامل باستخدام FIRECRAWL_CLOUD
افتراضيًا (مع auto)، تُرسل ثلاثة أشياء إلى Firecrawl Cloud: البحث، والصفحات التي تحجب جهازك، ومزوّدو بيانات Alexandria (الذين يحتاجون إلى حساب مجاني عبر firecrawl-local login). تتحكم FIRECRAWL_CLOUD في عملية التسليم:
| القيمة | التأثير |
|---|---|
auto (الافتراضي) |
يعمل البحث والرجوع إلى الصفحات المحجوبة وAlexandria جميعًا |
search |
البحث وحده يُرسل إلى Firecrawl Cloud |
off |
لا شيء يُرسل إلى Firecrawl Cloud |
تُعامل أي قيمة غير معروفة كما لو كانت off. وعند إيقاف السحابة، تستجيب POST /v2/search بـ"code":"CLOUD_ONLY" مع رسالة تطلب منك ضبط FIRECRAWL_API_KEY أو FIRECRAWL_CLOUD=auto. وتحمل أي صفحة جلبتها السحابة لك "source": "firecrawl-cloud"، لذا يمكنك دائمًا معرفة مصدر النتيجة.
يرفض serve الأهداف المحلية (localhost) والخاصة ما لم تمرر --allow-private، كما أن ربط --host بغير loopback يتطلب --token. تُحجب بيانات السحابة الوصفية وعناوين link-local في كل الأوضاع.
دع وكيل البرمجة لديك يختبر واجهة Firecrawl Local API باستخدام Apidog CLI
نقطة نهاية الزحف هي الأكثر عرضة لإفساد خط المعالجة: فهي غير متزامنة، وتنتهي صلاحية المهمة، ويؤدي إيقاف الخادم إلى فقدانها. بدلًا من الاستقصاء يدويًا، دع وكيل البرمجة لديك يبني اختبارًا ويشغّله باستخدام Apidog CLI.
أعدّه مرة واحدة:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
ثم أعطِ Claude Code أو Cursor موجّهًا واحدًا:
firecrawl-local serve is running on http://localhost:3002. In Apidog project <id>,
import an OpenAPI file for POST /v2/scrape, POST /v2/crawl and GET /v2/crawl/{id},
create an environment for that base URL, and build a test scenario that starts a
crawl of https://docs.firecrawl.dev with limit 10, saves the returned id, polls
GET /v2/crawl/{id} until status is "completed", and asserts total equals completed
and every page has non-empty markdown. Run it and summarize any failures.
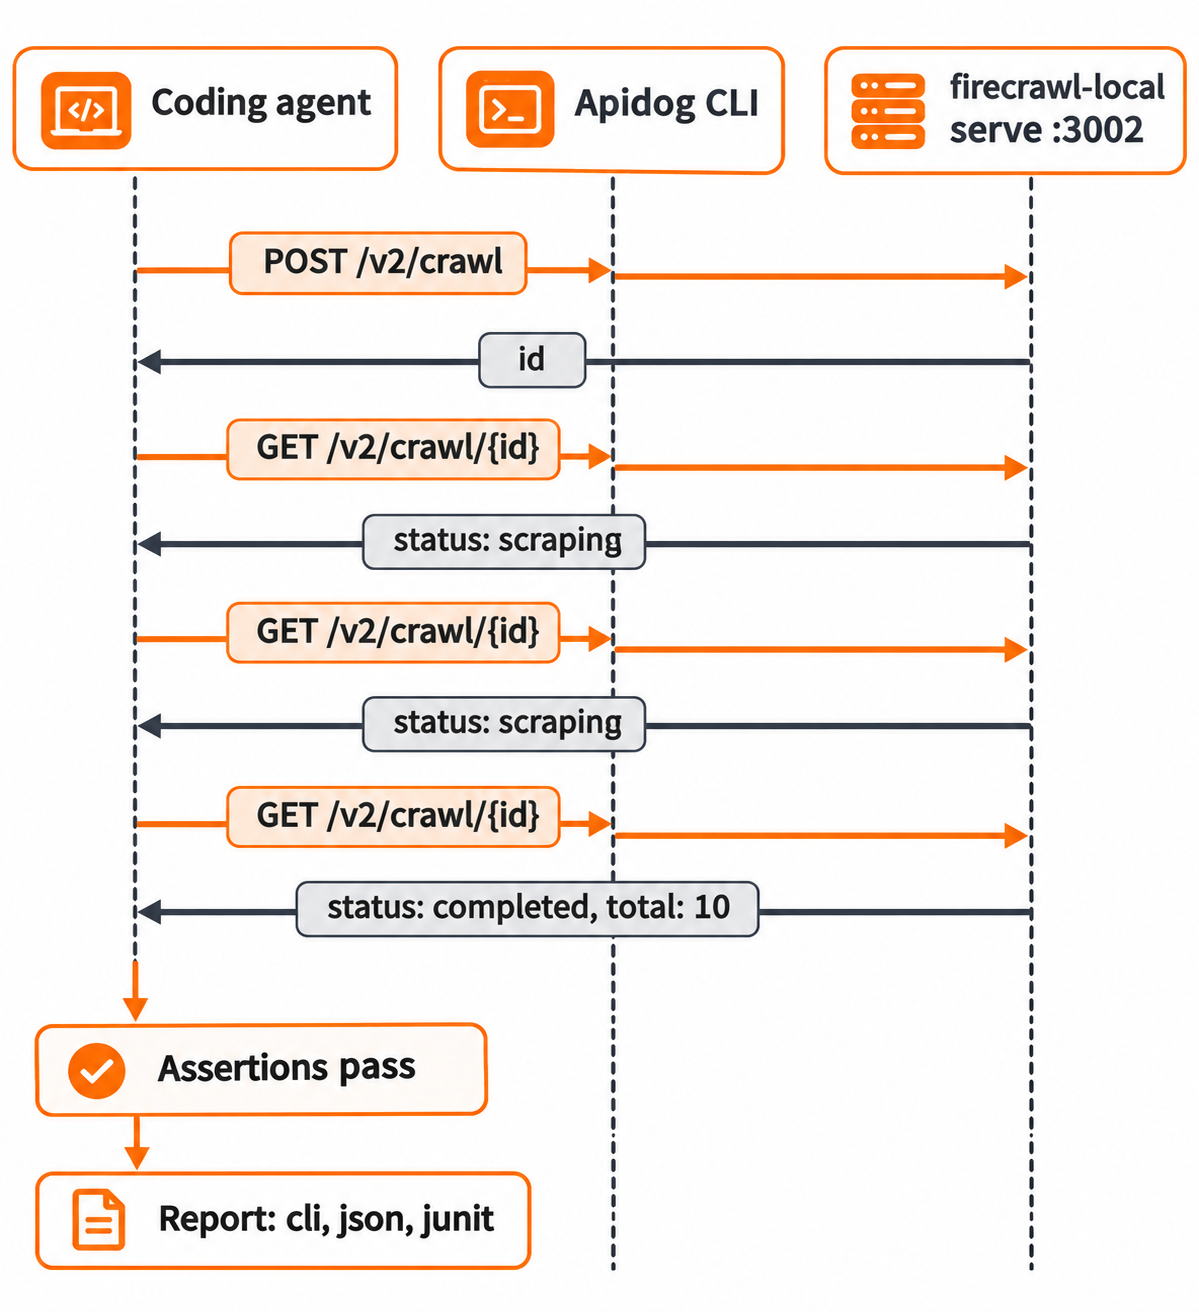
يقرأ الوكيل مخطط كل حمولة (payload)، ويتحقق منه، ويشغّل أوامر مثل هذه، وكلها مأخوذة من apidog <cmd> --help في CLI 2.2.12:
apidog import --project <id> --format openapi --file ./firecrawl-local-v2.yaml
apidog environment create firecrawl-local --project <id> --base-url http://localhost:3002
apidog cli-schema get test-scenario-create
apidog cli-schema validate test-scenario-create --file scenario.json
apidog test-scenario create --project <id> --file ./scenario.json
apidog run -t <scenarioId> --project <id> -e <envId> -r cli,json
يرسل Apidog CLI الطلبات من جهازك، لذا يمكن الوصول إلى localhost:3002. بدّل إلى -r junit لإدراج التشغيل نفسه في CI؛ ويغطي دليلانا Apidog CLI في Claude Code وApidog CLI في Cursor الجانب الخاص بالوكيل. وتغطي خطة Apidog المجانية فرقًا يصل عدد أعضائها إلى 4 مستخدمين.
استكشاف أخطاء Firecrawl Local وإصلاحها
| العَرَض | الإصلاح |
|---|---|
404 مع NOT_FOUND على /v1/scrape |
لا تُقدّم إلا v2؛ بدّل عميلك إلى /v2/... |
CLOUD_ONLY على /v2/search |
متوقع مع FIRECRAWL_CLOUD=off؛ استخدم auto أو search |
| الوكيل لا يسرد أدوات Firecrawl | أعد تشغيل الأداة بعد init؛ وتحقق من Node.js 22+ |
| صفحة JavaScript تعود بمحتوى ضئيل | ثبّت Chrome، أو اضبط --browser always |
صيغة json أو summary مفقودة |
غير مدعومة محليًا؛ وستحصل على تحذير بدلًا منها |
| معرّف الزحف غير موجود | انتهت صلاحية المهمة بعد ساعة أو أُعيد تشغيل serve |
الأسئلة الشائعة
هل Firecrawl Local مجاني؟ لا ترسل عمليات الاستخراج والزحف ورسم الخرائط المحلية أي شيء إلى Firecrawl، واستهلكت 0 من الأرصدة في اختباراتنا. الكود بترخيص AGPL-3.0؛ وحزم SDK بترخيص MIT. أما البحث وAlexandria فيمرّان عبر Firecrawl Cloud.
هل أحتاج إلى مفتاح API لاستخدام Firecrawl Local؟ لا، ليس للمسارات المحلية. تحتاج إلى مفتاح فقط، عبر firecrawl-local login أو FIRECRAWL_API_KEY، لمزوّدي بيانات Alexandria.
هل يعمل Firecrawl Local مع Windsurf وCodex وGemini CLI؟ نعم. يتعرّف init على windsurf وcodex وgemini بالإضافة إلى Claude Code وClaude Desktop وCursor.
هل يمكن لكود Firecrawl الموجود لدي أن يعمل معه دون تغيير؟ بالنسبة إلى scrape وmap وcrawl وbatch scrape في v2، نعم: غيّر عنوان URL الخاص بـAPI إلى http://localhost:3002. أما مسارات v0 وv1 فلا تُقدّم، وتُتجاهل actions الخاصة بالمتصفح.
هل يحترم Firecrawl Local ملف robots.txt؟ نعم. يقرأ robots.txt عند الزحف ويعرّف عن نفسه في User-Agent، لذا يمكن لأصحاب المواقع مخاطبته باسم FirecrawlLocal. ويعطّل --ignore-robots ذلك؛ استخدمه فقط على مواقع تملكها.