
غادر DeepSeek V4 Pro مرحلة المعاينة في 12 أغسطس 2026. يعمل إصدار التوفر العام (GA)، الذي يحمل الختم 0813، الآن كنقطة نهاية لواجهة برمجة التطبيقات deepseek-v4-pro، ويأتي بأرقام تبدو وكأنها أخطاء مطبعية: نافذة سياق بحجم 1 مليون رمز، و384 ألف رمز كحد أقصى للإخراج، وتسعير إدخال ينخفض إلى 0.003625 دولار لكل مليون رمز عند إصابات ذاكرة التخزين المؤقت. وكما ذكرت Unite.AI، فإن النموذج الذي قضى أربعة أشهر في المعاينة أصبح الآن النموذج الرائد لـ DeepSeek.
تخبرك تغطية الإطلاق بما تم شحنه، وليس كيفية استدعائه. يغطي هذا الدليل الجزء العملي: أول طلب باستخدام حزمة OpenAI SDK، وأوضاع التفكير وحقل reasoning_content، والبث المتدفق، واستدعاء الأدوات، والحسابات الرياضية لتخزين الموجه مؤقتًا التي تحدد ما إذا كانت نافذة السياق بحجم 1 مليون رمز ميسورة التكلفة أم مدمرة. إذا كنت تريد قصة الخلفية المعمارية أولاً، فاقرأ ما هو DeepSeek V4 ثم عد.
ملخص
- DeepSeek-V4-Pro-0813 هو لقطة التوفر العام (GA) التي تدعم نقطة النهاية
deepseek-v4-proاعتبارًا من 12 أغسطس 2026، وهو الإصدار المستهدف في الإنتاج. - واجهة برمجة التطبيقات متوافقة مع OpenAI: وجه حزمة
openaiSDK إلىhttps://api.deepseek.com، ثم اضبطmodel="deepseek-v4-pro"، وانتهى الأمر. كما يعمل تنسيق رسائل Anthropic وواجهة برمجة تطبيقات الاستجابات الخاصة بـ DeepSeek أيضًا. - نافذة سياق بحجم 1 مليون رمز، و384 ألف رمز كحد أقصى للإخراج، وثلاثة أوضاع تفكير (
non-think،think high،think max) تُرجع حقلreasoning_contentجنبًا إلى جنب مع الإجابة. - التسعير: 0.435 دولار/مليون إدخال (فقد في ذاكرة التخزين المؤقت)، 0.003625 دولار/مليون إدخال (إصابة ذاكرة التخزين المؤقت، أرخص بـ 120 مرة)، 0.87 دولار/مليون إخراج. التخزين المؤقت تلقائي لبادئات الموجه المتكررة.
- حذرت DeepSeek في 6 أغسطس من زيادة "كبيرة" قادمة في أسعار واجهة برمجة التطبيقات. لا توجد أرقام أو تاريخ حتى الآن، لذا ضع ميزانية مع هامش.
- اختبر نقطة النهاية، وافحص تدفق SSE، واحتفظ ببيئات Pro/Flash جنبًا إلى جنب في Apidog قبل ربطها بأي شيء حقيقي.
ما يغيره إصدار التوفر العام 0813 للمطورين
افتتحت المعاينة في أبريل 2026، وتم شحن الإصدار الأصغر V4 Flash في يوليو، وفي 12 أغسطس تخرج نموذج Pro إلى التوفر العام كإصدار 0813، متبعًا اتفاقية الطابع الزمني المعتادة لـ DeepSeek (بنفس الطريقة التي حددت بها v3-0324 لقطة V3).
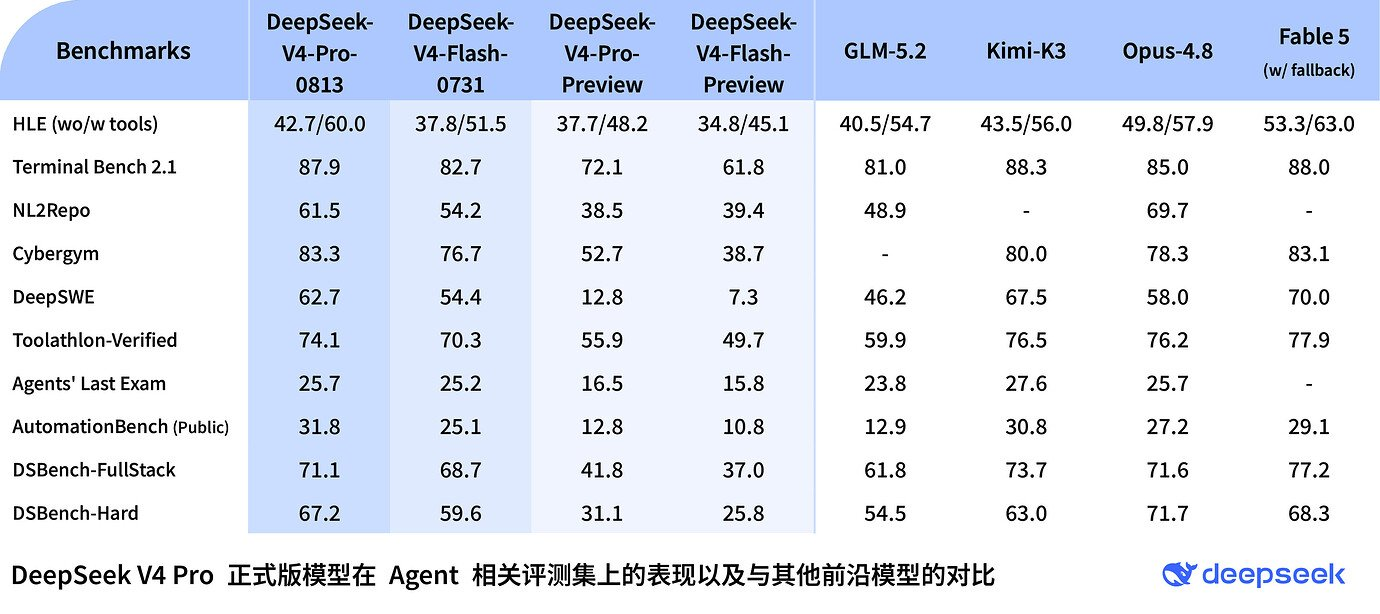
تتغير ثلاثة أمور مع التوفر العام:
- اللقطة مستقرة. يمكن أن تتغير نماذج المعاينة تحت قدميك، مما يبطل التقييمات وضبط الموجه بصمت. الإصدار 0813 هو هدف ثابت حتى تعلن DeepSeek عن لقطة جديدة.
- نقطة النهاية هي الاسم المستعار للإنتاج. على واجهة برمجة التطبيقات الرسمية، تستدعي
deepseek-v4-proوتحصل على الإصدار 0813؛ لتثبيت اللقطة صراحةً، يسردها OpenRouter باسمdeepseek/deepseek-v4-pro-0813. - السطح الكامل للميزات متاح. تعمل أوضاع التفكير، واستدعاء الوظائف، والمخرجات المهيكلة، وتخزين الموجه مؤقتًا، وواجهة برمجة التطبيقات متعددة التنسيقات (OpenAI، Anthropic، Responses) جميعها مباشرةً على نقطة نهاية التوفر العام.
تحت الغطاء، V4 Pro هو نموذج مزيج الخبراء بإجمالي 1.6 تريليون معلمة و49 مليار معلمة نشطة لكل رمز. القصة الهندسية الرئيسية هي الكفاءة: مخططين للانتباه، "الانتباه المتفرق المضغوط" (Compressed Sparse Attention) و"الانتباه المضغوط بشدة" (Heavily Compressed Attention)، يخفضان حساب الاستدلال لرمز واحد إلى 27% من V3.2 وذاكرة التخزين المؤقت KV إلى 10%. هذا التخفيض في ذاكرة التخزين المؤقت KV هو ما يجعل نافذة السياق بحجم 1 مليون رمز قابلة للخدمة بهذه الأسعار بدلاً من كونها ميزة تجريبية.
DeepSeek V4 Pro 0813: المواصفات في لمحة
| المواصفات | DeepSeek V4 Pro 0813 |
|---|---|
| الإصدار | التوفر العام في 12 أغسطس 2026 (لقطة 0813) |
| المعمارية | مزيج الخبراء، 1.6 تريليون معلمة إجمالية، 49 مليار معلمة نشطة لكل رمز |
| الانتباه | الانتباه المتفرق المضغوط + الانتباه المضغوط بشدة |
| تكلفة الاستدلال مقابل V3.2 | 27% من حساب الرمز الواحد، 10% من ذاكرة التخزين المؤقت KV |
| نافذة السياق | 1,000,000 رمز |
| الحد الأقصى للإخراج | 384 ألف رمز |
| أوضاع التفكير | non-think، think high، think max |
| سعر الإدخال | 0.435 دولار/مليون رمز (فقد في ذاكرة التخزين المؤقت)، 0.003625 دولار/مليون (إصابة ذاكرة التخزين المؤقت) |
| سعر الإخراج | 0.87 دولار/مليون رمز |
| تنسيقات API | OpenAI Chat Completions، Anthropic Messages، DeepSeek Responses |
| معرف النموذج | deepseek-v4-pro |
| النموذج الشقيق الأصغر | deepseek-v4-flash (284 مليار إجمالي / 13 مليار نشط)، 0.14 دولار/مليون إدخال، 0.28 دولار/مليون إخراج |
بالنسبة للقدرات، تسرد بطاقة نموذج DeepSeek الخاصة بها SWE-bench Verified بنسبة 80.6%، وTerminal Bench 2.0 بنسبة 67.9%، وGPQA Diamond بنسبة 90.1%، وLiveCodeBench بنسبة 93.5% لـ V4-Pro-Max، وهو تكوين التفكير الأقصى. هذه أرقام بائعين مُبلغ عنها ذاتيًا لم تتحقق منها أي جهة خارجية بعد، لذا قم بإجراء تقييماتك الخاصة بالمهام قبل ترحيل أي شيء مهم.
احصل على مفتاح API وقم بأول طلب لك
يستغرق الإعداد حوالي خمس دقائق:
- أنشئ حسابًا على منصة DeepSeek (platform.deepseek.com) وأضف رصيدًا، واجهة برمجة التطبيقات مدفوعة مسبقًا.
- افتح مفاتيح API، أنشئ مفتاحًا، وانسخه على الفور (يُعرض مرة واحدة).
- قم بتصديره كمتغير بيئة بدلاً من لصقه في الكود:
export DEEPSEEK_API_KEY="sk-..."
تتحدث واجهة برمجة التطبيقات بروتوكول OpenAI Chat Completions، لذا فإن حزمة openai القياسية هي العميل. يعمل كلا العنوانين https://api.deepseek.com وhttps://api.deepseek.com/v1 كعناوين URL أساسية؛ /v1 هو توافق بروتوكول، وليس إصدار نموذج.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["DEEPSEEK_API_KEY"],
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-v4-pro",
    messages=[
        {"role": "system", "content": "You are a concise technical assistant."},
        {"role": "user", "content": "Explain idempotency in REST APIs in two sentences."},
    ],
)

print(response.choices[0].message.content)
print(response.usage)
اطبع response.usage من اليوم الأول. مع نموذج بهذا الرخص عند إصابات ذاكرة التخزين المؤقت وبهذا الغلاء عند فقد ذاكرة التخزين المؤقت بحجم 1 مليون رمز، فإن محاسبة الرموز هي الفرق بين خطأ تقريب وفاتورة حقيقية.
نفس الطلب عبر HTTP الخام، مفيد لاختبارات الدخان ولاستيراده في أدوات API:
curl https://api.deepseek.com/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $DEEPSEEK_API_KEY" \
  -d '{
    "model": "deepseek-v4-pro",
    "messages": [
      {"role": "user", "content": "List three ways to version a REST API."}
    ]
  }'
يوجد المرجع الكامل للمعلمات في الوثائق الرسمية لـ DeepSeek، بما في ذلك نقطة النهاية المتوافقة مع Anthropic (يمكن استخدامها من حزمة Anthropic SDK وClaude Code دون إعادة كتابة أي شيء) وواجهة برمجة تطبيقات الاستجابات الخاصة بـ DeepSeek.
العمل مع أوضاع التفكير الثلاثة
تكشف V4 Pro عن التفكير كعجلة قابلة للضبط بدلاً من نموذج منفصل. نقطة نهاية واحدة، ثلاثة أوضاع:
non-think: يجيب النموذج مباشرة. الأسرع والأرخص، ومناسب للاستخراج والتصنيف والتنسيق والملخصات.think high: يفكر النموذج قبل الإجابة ويعيد هذا التفكير في حقلreasoning_content. الافتراضي للترميز وتصحيح الأخطاء والتحليل متعدد الخطوات.think max: أقصى ميزانية تفكير، وهو التكوين الذي يقف وراء أرقام معيار V4-Pro-Max. احتفظ به للمشكلات الصعبة حقًا.
تتوافق الأوضاع مع المعامل القياسي reasoning_effort، لذا لا توجد حاجة إلى أي إعدادات خاصة بالبائع:
response = client.chat.completions.create(
    model="deepseek-v4-pro",
    reasoning_effort="high", # "none" | "high" | "max"
    messages=[
        {"role": "user", "content": "Our API returns 502s under load but only behind the CDN. Walk through likely causes in order of probability."},
    ],
)

message = response.choices[0].message
print("--- Reasoning ---")
print(message.reasoning_content)
print("--- Answer ---")
print(message.content)
ملاحظتان عمليتان. أولاً، لا ترجع أبدًا reasoning_content إلى سجل المحادثة؛ أرسل فقط content المنعطفات السابقة. ثانيًا، تُحاسب رموز التفكير كرموز إخراج بسعر 0.87 دولار/مليون، لذا يكلف وضع think max أموالًا حقيقية وزمن انتقال حقيقي. طابق الوضع مع المهمة بدلاً من التعيين الافتراضي للحد الأقصى.
الاستجابات المتدفقة
مع إخراج بحد أقصى 384 ألف رمز وأوضاع تفكير يمكن أن تستدل مطولًا، فإن الطلبات غير المتدفقة تؤدي إلى تجربة مستخدم سيئة. اضبط stream=True وتعامل مع كلا نوعي الدلتا؛ في أوضاع التفكير، تصل أجزاء reasoning_content أولاً، ثم الإجابة:
stream = client.chat.completions.create(
    model="deepseek-v4-pro",
    reasoning_effort="high",
    stream=True,
    messages=[
        {"role": "user", "content": "Design a rate limiter for a public API. Compare token bucket and sliding window."},
    ],
)

for chunk in stream:
    if not chunk.choices:
        continue # final chunk may carry usage data only
    delta = chunk.choices[0].delta
    if getattr(delta, "reasoning_content", None):
        print(delta.reasoning_content, end="", flush=True) # thinking phase
    elif delta.content:
        print(delta.content, end="", flush=True) # answer phase
نمط واجهة مستخدم معقول: عرض مرحلة التفكير مطوية كمؤشر "تفكير"، ثم التبديل إلى العرض العادي عندما تبدأ دلتا content. تحت الغطاء، هذا هو أحداث الخادم القياسية؛ يغطي دليلنا حول تدفق استجابات API باستخدام SSE الآليات.
استدعاء الأدوات والمخرجات المهيكلة
يدعم V4 Pro استدعاء الوظائف على غرار OpenAI، مما يعني أن حلقات الوكلاء الموجودة تعمل دون تعديل. حدد الأدوات، اقرأ tool_calls، نفذ، أضف النتائج، كرر:
tools = [{
    "type": "function",
    "function": {
        "name": "get_endpoint_status",
        "description": "Check the health of an internal API endpoint",
        "parameters": {
            "type": "object",
            "properties": {
                "endpoint": {"type": "string", "description": "Path, e.g. /v1/orders"}
            },
            "required": ["endpoint"],
        },
    },
}]

response = client.chat.completions.create(
    model="deepseek-v4-pro",
    messages=[{"role": "user", "content": "Is /v1/orders healthy right now?"}],
    tools=tools,
)

print(response.choices[0].message.tool_calls)
تعمل المخرجات المهيكلة من خلال المعامل القياسي response_format عندما تحتاج إلى JSON مضمون التحليل. يستحق الشرح الكامل لحلقات الأدوات متعددة الخطوات مقالًا خاصًا به؛ تغطي الوثائق الرسمية تفاصيل شكل الرسالة.
اقتصاديات التخزين المؤقت للموجهات: الرقم الذي يغير معماريتك
هذه هي المواصفة التي تستحق اهتمامًا أكبر من المعايير. يخزن DeepSeek بادئات الموجه مؤقتًا تلقائيًا، بدون رؤوس التحكم في ذاكرة التخزين المؤقت، ولا تكوين TTL، وتُحاسب البادئات المتكررة بسعر 0.003625 دولار/مليون بدلاً من 0.435 دولار/مليون. هذا خصم 120 ضعفًا للمدخلات التي رأتها واجهة برمجة التطبيقات بالفعل.
احسب الأرقام على عبء عمل واقعي. لنقل أنك تبني وكيل برمجة يحتفظ بسياق مستودع بحجم 200 ألف رمز ويجري 50 استدعاءً في جلسة واحدة:
- بدون تخزين مؤقت: 50 استدعاءً × 200 ألف رمز × 0.435 دولار/مليون ≈ 4.35 دولار تكاليف إدخال.
- مع التخزين المؤقت التلقائي: فقد واحد في ذاكرة التخزين المؤقت (0.087 دولار) + 49 إصابة في ذاكرة التخزين المؤقت (≈ 0.0007 دولار لكل منها) ≈ 0.12 دولار.
نفس الجلسة، أرخص بنحو 35 مرة، وكل ما يتطلبه الأمر هو هيكل الموجه: المحتوى الثابت أولاً (موجه النظام، الوثائق، سياق المستودع)، المحتوى المتغير أخيرًا (أحدث رسالة للمستخدم، الطوابع الزمنية، معرفات الطلبات). أي تغيير مبكر في الموجه يبطل البادئة المخزنة مؤقتًا من تلك النقطة فصاعدًا، لذا فإن طابعًا زمنيًا في موجه النظام الخاص بك يحول بصمت كل استدعاء إلى فقد في ذاكرة التخزين المؤقت بالسعر الكامل.
هذا أيضًا يعيد صياغة نافذة السياق بحجم 1 مليون رمز: ملؤها يكلف 0.435 دولار عند الفقد، ولكن كبادئة جلسة مستقرة فإنها تُقرأ بحوالي ثلث سنت لكل استدعاء. للنظرية العامة، انظر ما هو التخزين المؤقت للموجهات.
اختبار deepseek-v4-pro في Apidog
قبل أن يقترب V4 Pro من كود الإنتاج بأي شكل، ضعه تحت مصحح أخطاء مناسب. نظرًا لأن واجهة برمجة تطبيقات DeepSeek متوافقة مع OpenAI، فإن Apidog يتعرف عليها دون أي معالجة خاصة:
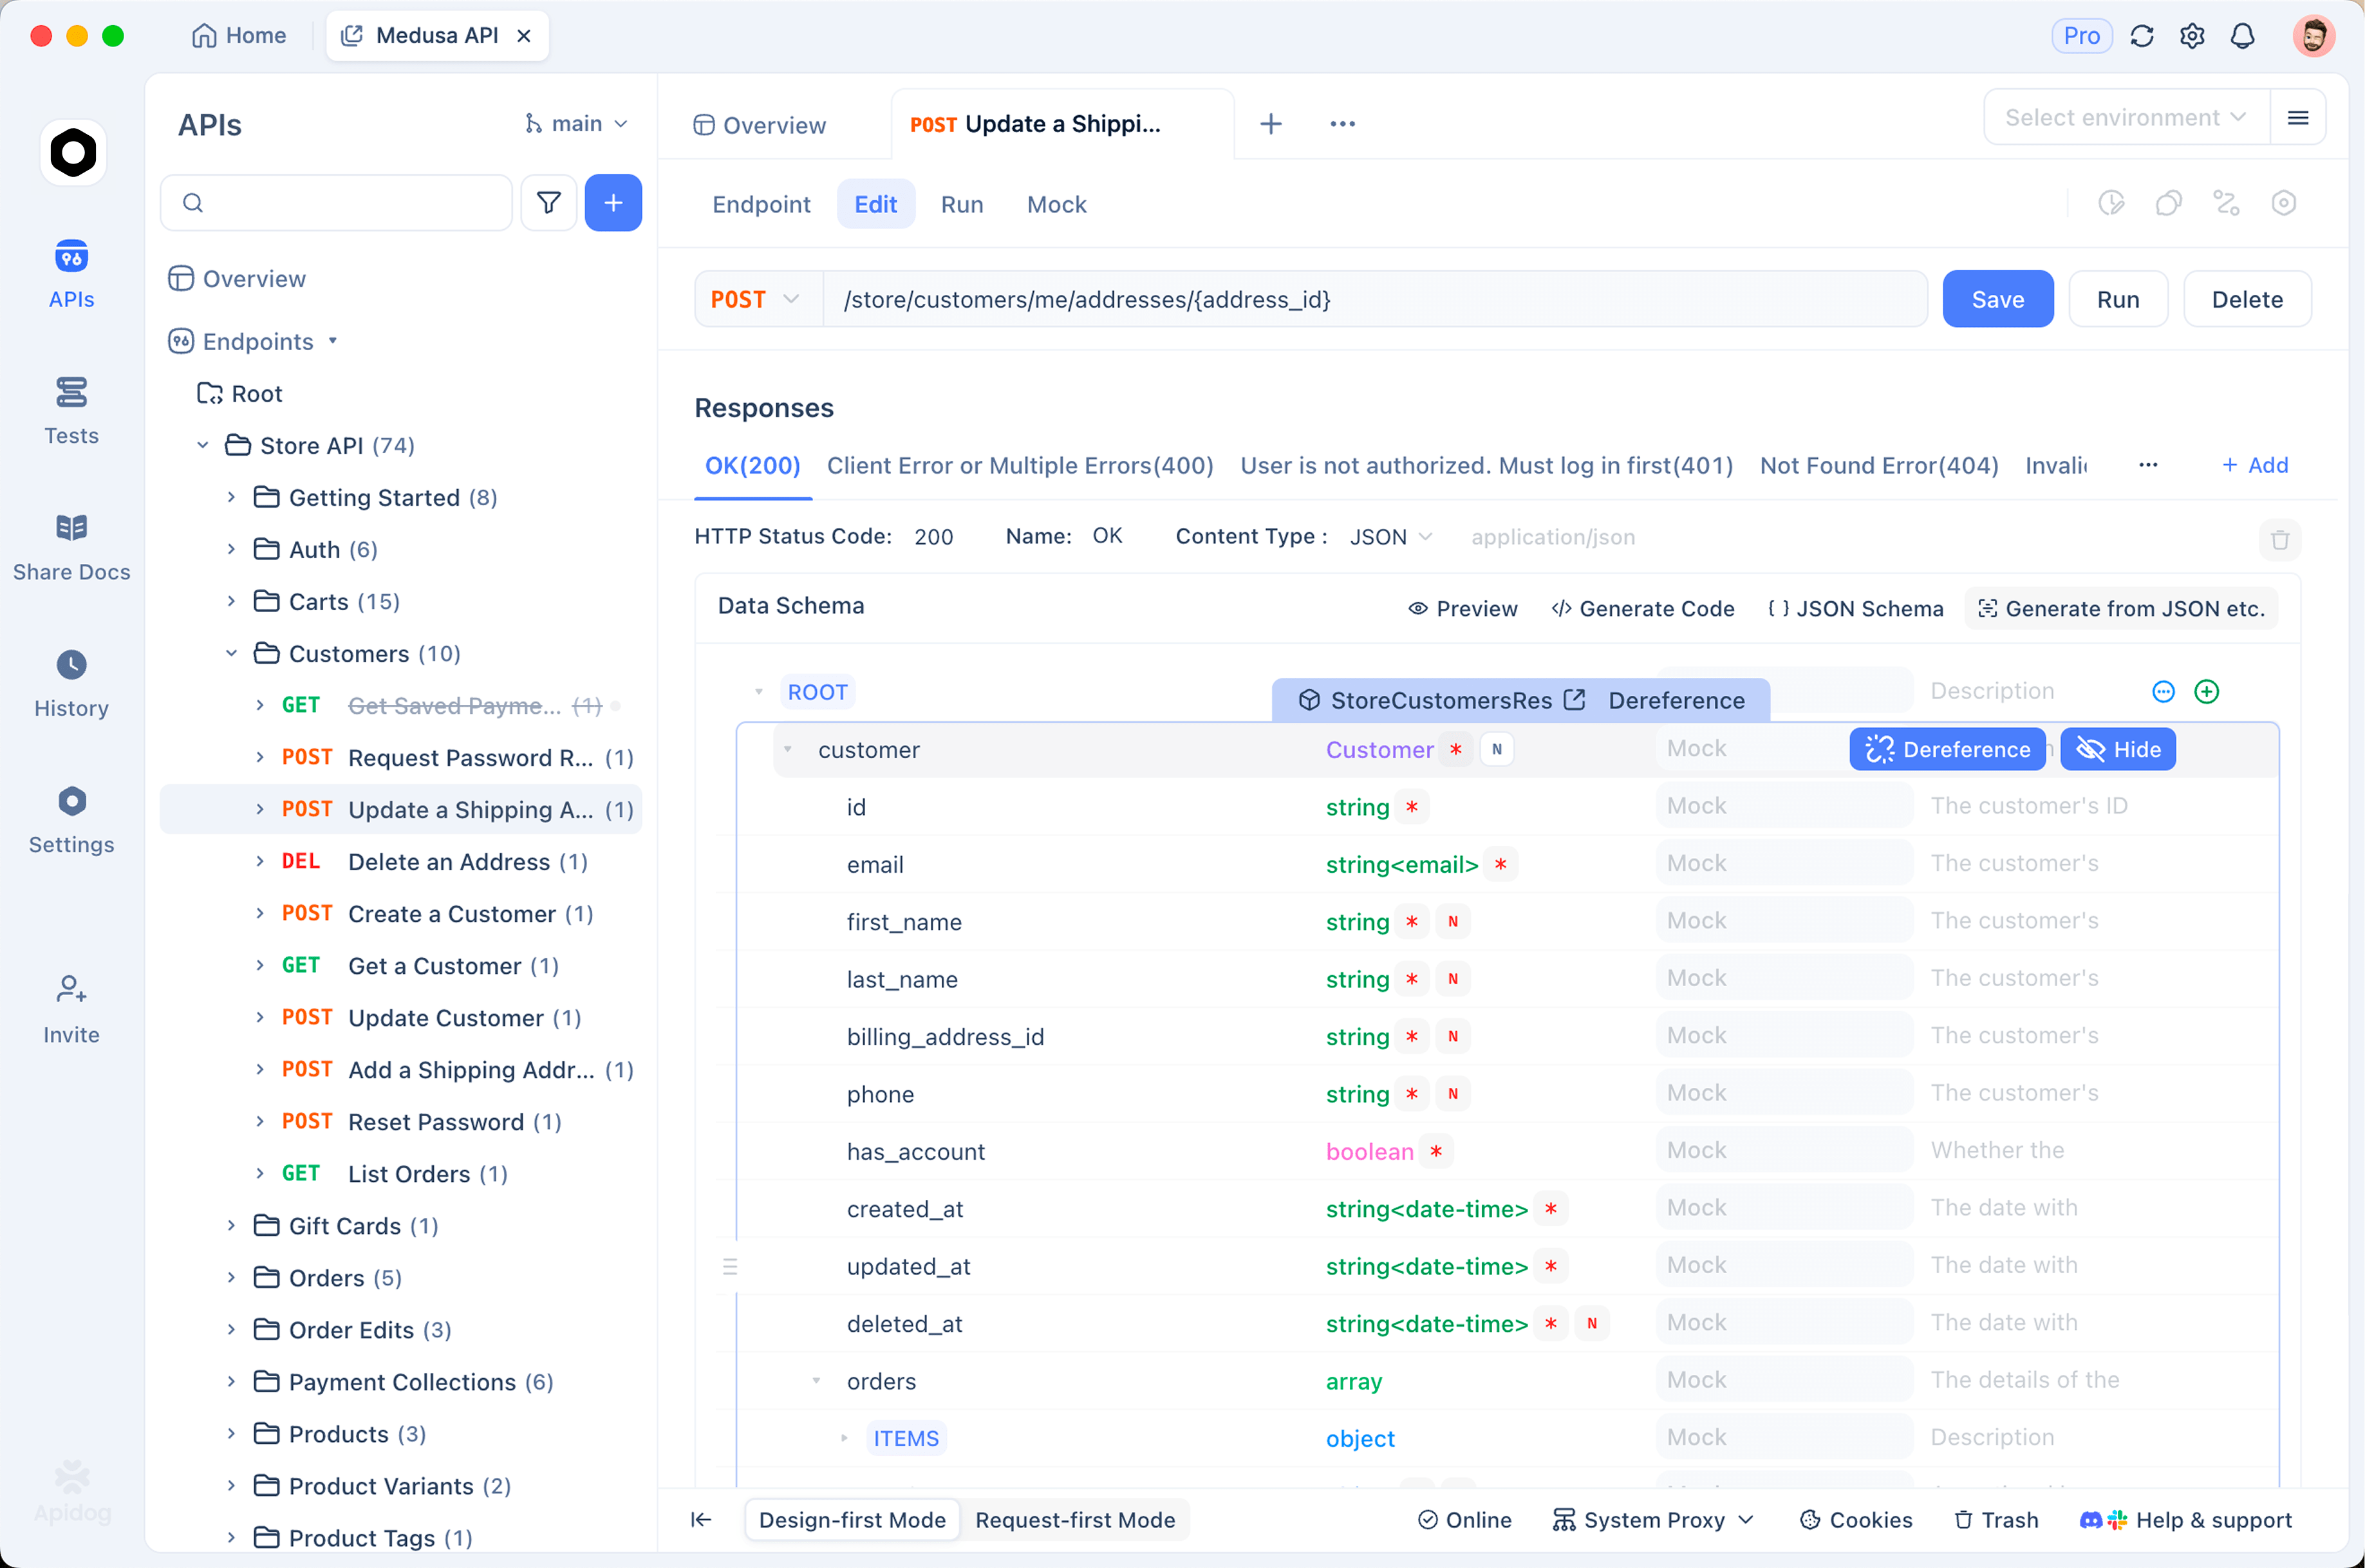
- استورد نقطة النهاية. الصق أمر curl من السابق في Apidog وسيصبح طلبًا قابلاً للتعديل، مع تحليل الرؤوس والمصادقة والنص تلقائيًا.
- قم بإعداد بيئات لـ Pro و Flash. قم بتخزين
base_urlومفتاح API الخاص بك كمتغيرات بيئة، واجعل اسم النموذج متغيرًا أيضًا. يصبح التبديل بينdeepseek-v4-proوdeepseek-v4-flashتغييرًا بيئيًا بنقرة واحدة، مما يجعل سؤال "هل يستحق Pro ثلاثة أضعاف سعر Flash على هذا الموجه؟" سؤالًا تجريبيًا بدلاً من جدال. - افحص تدفق SSE. أرسل طلبًا بـ
"stream": trueويعرض Apidog تدفق الأحداث كخط زمني مباشر بدلاً من جدار من سطورdata:الخام، مع دمج الفروقات حتى تتمكن من مشاهدة وصولreasoning_contentقبل الإجابة. عندما يبدو استدعاءthink-maxبطيئًا، يعرض لك هذا العرض أين ذهب الوقت بالضبط. - احفظ الجلسة كمجموعة. عندما تشحن DeepSeek اللقطة التالية، أعد تشغيل نفس الطلبات وقارن السلوك قبل الترقية، وهو نفس سير العمل الذي تستخدمه الفرق لنقاط النهاية المتوافقة مع OpenAI بشكل عام.
يعرض عارض الاستجابة أيضًا كتلة usage في كل طلب، وهي أسرع طريقة للتحقق من نسبة إصابة ذاكرة التخزين المؤقت أثناء ضبط هيكل الموجه.
التسعير اليوم، والزيادة القادمة
الأسعار المعلنة الحالية لنقطتي نهاية V4:
| النموذج | الإدخال (فقد) | الإدخال (إصابة ذاكرة التخزين المؤقت) | الإخراج |
|---|---|---|---|
deepseek-v4-pro |
0.435 دولار/مليون | 0.003625 دولار/مليون | 0.87 دولار/مليون |
deepseek-v4-flash |
0.14 دولار/مليون | 0.28 دولار/مليون |
حتى بأسعار Pro، هذا يقلل أسعار النماذج الغربية الرائدة بهامش كبير. ولكن خطط حول تحذير واحد: في 6 أغسطس 2026، قبل ستة أيام من التوفر العام، حذرت DeepSeek من أن زيادة "كبيرة" في أسعار واجهة برمجة التطبيقات قادمة، لا أرقام، لا تاريخ سريان.
تحوطات عملية بينما الرقم غير معروف:
- قس تكلفتك الحقيقية لكل مهمة الآن، باستخدام بيانات
usageمن أعباء العمل الفعلية، حتى تتمكن من تصميم أي زيادة معلنة في دقائق بدلاً من التخمين. - زد من إصابات ذاكرة التخزين المؤقت. إذا طبقت الزيادة بشكل متناسب، فإن المعمارية التي تعتمد على البادئات بشكل كبير تحتفظ بمعظم ميزتها.
- احتفظ بـ V4 Flash كبديل توجيه. بسعر 0.14 دولار/0.28 دولار مع 13 مليار معلمة نشطة، يتعامل مع المهام البسيطة ذات الحجم الكبير بحيث يتم حجز Pro للطلبات التي تحتاجها.
لتحليل أعمق لهيكل تسعير V4 وكيف يقارن بين المزودين، انظر دليلنا تسعير DeepSeek V4 API.
الأسئلة الشائعة
هل سيعمل كود OpenAI SDK الحالي الخاص بي دون تغيير؟
تقريبًا. غيّر base_url إلى https://api.deepseek.com، استبدل مفتاح API، واضبط model="deepseek-v4-pro". تتبع Chat Completions، والتدفق، والأدوات، والمخرجات المهيكلة أشكال OpenAI. يمكن للفرق التي تستخدم Anthropic SDK استخدام نقطة نهاية DeepSeek Anthropic Messages بدلاً من ذلك.
متى يجب أن أستخدم V4 Flash بدلاً من V4 Pro؟
Flash (284 مليار إجمالي، 13 مليار نشط) هو نموذج الحجم: التصنيف، الاستخراج، الدردشة البسيطة، أي شيء حساس لزمن الاستجابة ولا يحتاج إلى تفكير عميق. يستحق Pro سعره بثلاثة أضعاف للإخراج في الترميز الذكي، وتحليل السياق الطويل، وأعباء عمل وضع التفكير. وجه حسب المهمة، لا حسب الولاء.
هل يمكنني استخدام V4 Pro 0813 في Cursor؟
نعم، يقبل Cursor نقاط نهاية مخصصة متوافقة مع OpenAI، لذا يعمل إصدار التوفر العام كنموذج مخصص. نستعرض الإعداد الدقيق في كيفية استخدام DeepSeek V4 Pro مع Cursor.
الخلاصة
اليوم الأول مع نموذج التوفر العام هو الوقت المناسب لبناء الذاكرة العضلية: المفتاح، الطلب الأول، أوضاع التفكير، التدفق، وتخطيط موجه واعي بالتخزين المؤقت. يكافئ V4 Pro هذه العادة الأخيرة أكثر من أي نموذج سبقه، حيث يجعل خصم ذاكرة التخزين المؤقت البالغ 120 ضعفًا هيكل الموجه قرارًا معماريًا. اربط الأمثلة المذكورة أعلاه، راقب أرقام usage، واحتفظ بمجموعة Apidog محفوظة حتى تتمكن من إعادة التحقق من السلوك عندما يتم إصدار اللقطة التالية أو تغيير السعر المعلن.